Ref2VA VSA: нода разреженного внимания для H3 reference-to-video
Нода ComfyUI переносит VSA-гейт FastH3 на MiniMax H3 Ref2VA: референсные токены остаются плотными, а видеотайлы отсекаются ради быстрого 4-шагового видео с персонажем.
Почему Ref2VA остался на плотном расписании
VSA (разреженное внимание для видео) кластеризует видеотокены в 3D пространственно-временные тайлы и отсекает большинство из них в каждом блоке: именно так чекпойнты FastH3 снижают стоимость каждого прямого прохода transformer. Reference-to-video ломает эту раскладку: Ref2VA добавляет в начало динамические мультимодальные сегменты, латенты референсного изображения, латенты референсного аудио и токены промпта перед сгенерированной видеопоследовательностью.
Наивное разбиение на тайлы помещает токены разных модальностей в один тайл, что портит маски условий и ломает идентичность персонажа. Из-за этого генерация H3 на основе референсов продолжала работать по плотному пути внимания, тогда как text-to-video перешёл на разреженные ядра.
Патч внимания с двумя уровнями
Ref2VA VSA решает эту проблему с помощью специально спроектированной раскладки внимания, а не нового чекпойнта:
- Плотный префикс-исключение: геометрический маппер выделяет текстовые токены, токены референсного изображения и референсного аудио в чистые по сегментам тайлы, которые не подпадают под top-k отсечение. Референсные токены остаются полностью плотными, поэтому соответствие идентичности не приносится в жертву скорости.
- Разреженность только для видео: top-k отсечение применяется строго к key-тайлам сгенерированного видео.
- Пересадка гейта: 50 обученных проекционных матриц
to_gate_compressиз чекпойнта FastH3 VSA прикрепляются к блокам H3 модели Ref2VA, после чего по пропатченной модели запускается то же ядро Sol/VSA с tile-64.
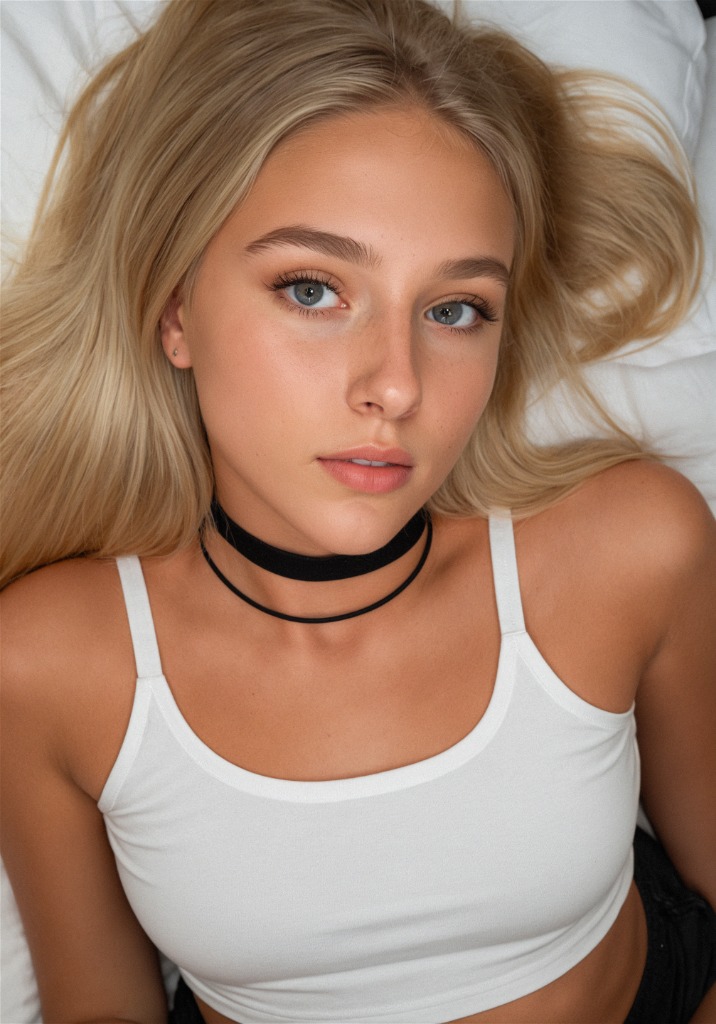
Референсное изображение, использованное для сравнительных запусков автора.
Автор опубликовал сравнения с одинаковым seed на одной машине, с одним промптом и одним референсным изображением при 1344x768. В обоих столбцах используется один и тот же референс персонажа:
 |  |
|---|---|
| Ref2VA VSA: 4 шага, 75% разреженности видео, ~2.2x быстрее | Video Delta Net (VDN-H3): 8 шагов |
По сравнению с плотным нативным расписанием H3 репозиторий сообщает об ускорении примерно в 9 раз, и примерно в 2.2 раза относительно пути Video Delta Net, при 4 шагах против 8.
Подключение в рабочий процесс
Результат 4-шагового Ref2VA VSA от автора при 1344x768.
Нода патча ставится между загрузчиком модели и цепочкой выборки:
UNETLoader (Ref2VA INT8)
   -> LoraLoaderModelOnly (turbo 4-step LoRA, strength 1.0)
   -> Ref2VAVSAGatePatch (fasth3_vsa_gate.safetensors, sparsity 0.75)
   -> MiniMaxH3SigmaShift (shift_video 12, shift_audio 3)
   -> BasicScheduler (steps 4) + BasicGuider -> SamplerCustomAdvanced (euler)
Нода поставляется в категории FastH3/VSA и принимает модель, файл гейта safetensors из models/loras/ и значение sparsity. 4-шаговый рецепт из README использует разреженность 0.75 с scheduler simple; в описании самой ноды предлагается начинать с от 0.50 до 0.70 и сравнивать с тем же плотным seed, прежде чем поднимать значение выше. В той же категории есть также FastH3 VSA-H3 Patch (tile64), оригинальный патч для text-to-video, так что оба пути могут использовать одну установку.
Рабочий процесс
В репозитории также есть ref2va_vsa_4step_with_preview.json для более лёгкого прохода предпросмотра в UI и ref2va_vsa_4step_api.json для формата API, а также tools/extract_vsa_gate.py для пересборки fasth3_vsa_gate.safetensors из чекпойнта FastH3 VSA, если он у вас уже есть локально.
Доступность
Ref2VA VSA является пользовательской нодой под лицензией Apache-2.0. Клонируйте Kablex/ComfyUI-Ref2VA-VSA в ComfyUI/custom_nodes, перезапустите и ищите ноды в категории FastH3/VSA. Требуется недавняя версия ComfyUI с поддержкой H3 и comfy-kitchen с примитивами CUDA Sol-Attention, поскольку само разреженное ядро поставляется из этого пакета.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.