SelfLift: прогрессивная выборка по разрешению в ComfyUI
comfyui-SelfLift выполняет ранний денойзинг при низком разрешении и завершает работу на полном: ускорение без обучения для Z-Image, FLUX.2-Klein и MiniMax H3 с коррекцией TST.
Как SelfLift делит расписание
Малошаговые модели, такие как Z-Image-Turbo и FLUX.2-Klein, сжимают временную ось, из-за чего пространственная стоимость каждого оставшегося прямого прохода становится доминирующим слагаемым. Выборка с прогрессивным разрешением снижает эту стоимость, выполняя денойзинг сначала при низком разрешении. Проблема, которую выявляет статья SelfLift (arXiv:2609.02036), состоит в том, что простое поднятие латента с расчётом на то, что несколько оставшихся шагов поглотят несоответствие, оставляет заметные артефакты.
Вместо этого SelfLift извлекает сигнал коррекции из самой модели: после поднятия часть мест с высоким риском корректируется в сторону pixel-VAE-якоря, а переход устроен так, чтобы низкоразрешённый префикс оставался допустимой частью той же траектории. В статье указаны следующие начальные точки: 6 из 8 шагов при низком разрешении для Z-Image-Turbo и 3 из 4 для FLUX.2-Klein.
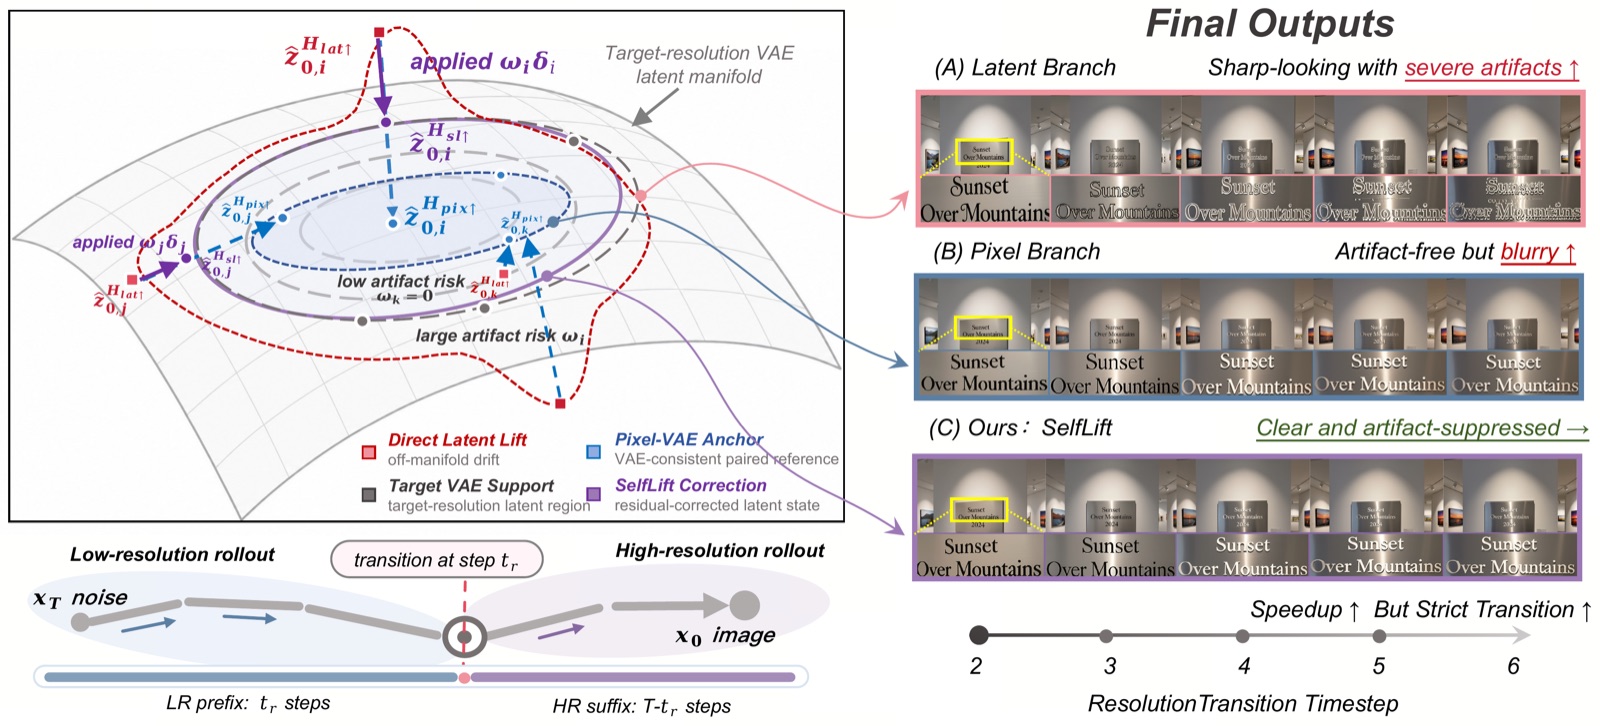
Тизер-иллюстрация SelfLift со страницы проекта.
Три узла в одном пакете
| Узел | Класс | Что делает |
|---|---|---|
| SelfLift Progressive Sampler (Image) | SelfLiftImageSampler | Прогрессивная выборка по разрешению для rectified-flow моделей изображений с использованием собственного VAE модели |
| SelfLift Progressive Sampler (MiniMax H3) | SelfLiftH3Sampler | Экспериментальная аудио-видео адаптация той же идеи для H3 |
| H3 Temporal State Transport (TST) | SelfLiftH3TST | Патч MODEL к MODEL, который исправляет временной дисбаланс в видео H3 |
Семплеры подключаются к стандартной схеме семплеров ComfyUI: они принимают входы sampler и sigmas, как SamplerCustom, поэтому вы подключаете KSamplerSelect со значением euler и собственный scheduler модели. Другие семплеры намеренно отклоняются.
Основные параметры: transition_step (сколько шагов остаётся при низком разрешении), lowres_scale (по умолчанию 0.5), rho (доля мест с высоким риском, притягиваемых к якорю VAE; 0 отключает эту коррекцию), w_min / w_max для силы коррекции, интерполяция при поднятии (nearest или bilinear) и необязательный model_hires, позволяющий на этапе высокого разрешения использовать другой checkpoint или набор LoRA. Переход не добавляет дополнительных вычислений денойзера: расписание из N шагов остаётся ровно N, плюс один цикл «Декодировать VAE, увеличить разрешение, повторно закодировать», если rho не равно 0.
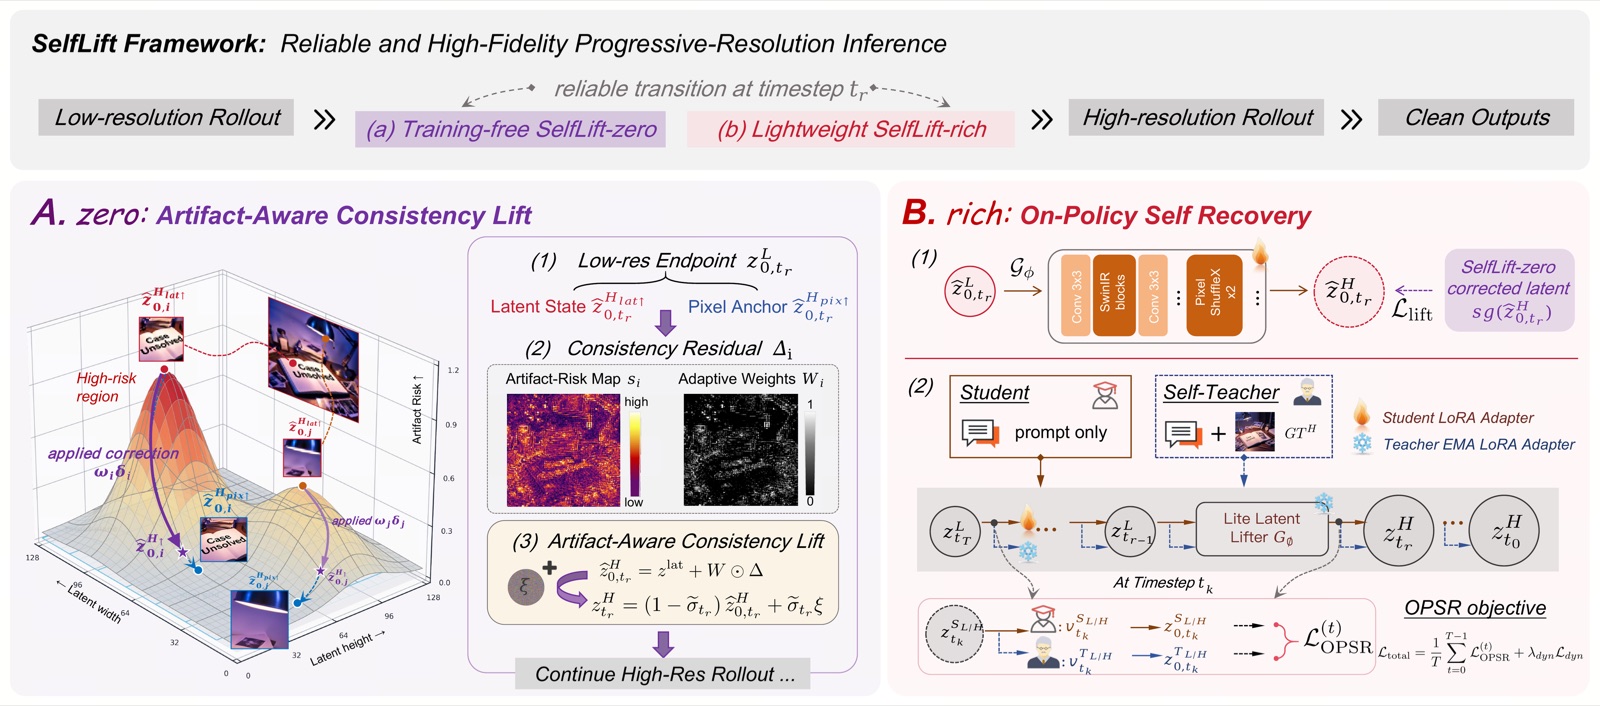
Обзор SelfLift: низкоразрешённый префикс, поднятие латента и этап высокого разрешения с якорной коррекцией.
Путь через MiniMax H3
Семплер H3 явно помечен автором как экспериментальный и не подтверждён статьёй. Он предлагает два варианта поднятия:
- Внешний апскейлер (по умолчанию): установленный H3 latent-апскейлер с
rho, равным 0; обученное поднятие, работающее только с латентом. Совместим с весами H3 latent upscaler, которые отмечены в README; узел подхватывает файлh3изmodels/latent_upscale_models/. - SelfLift-zero:
upscaler_modelне задан, аrhoбольше 0. Проверенная автором начальная точка для H3:rho 0.6приw_minиw_max, равных 1; к этому пришли после запуска с одним seed, показавшего, что настройка из статьи для изображений оставляла артефакты на пути прямого поднятия в H3.
Экспериментальная опция highres_tiling разбивает фазу высокого разрешения на 1-8 пространственных тайлов. Она сохраняет только аудио первого тайла, не имеет внимания между тайлами и не поддерживает ControlNet, поэтому это компромисс по памяти, а не рычаг качества.
Temporal State Transport
TST: вторая статья, перенесённая здесь (arXiv:2609.08505). Она измеряет знаковое спектральное напряжение оператора внимания на уровне кадров и корректирует только несбалансированные головы, обостряя чрезмерно перемешанные и смягчая фрагментированные, причём коррекция сильнее в более глубоких слоях и на более ранних шагах. Метод работает с любым стандартным семплером, не только с семплером SelfLift, и, по словам автора, добавляет примерно 1-2 % накладных расходов по времени выполнения.
На практике он нацелен на сбои, которые пользователи чаще всего замечают в выводе H3: мерцание или морфинг деталей, таких как текст на экране и логотипы, дрейф идентичности людей и одежды, а также физически неправдоподобное движение. tau управляет силой, и 0.2 это рекомендуемое значение; 0.5 заметно слишком сильно. Метод не может придумать детали, которых нет в модели, применяется только к моделям H3 и пропускается, когда включён highres_tiling. Опция логирования выводит одну строку диагностики на каждый прямой проход модели, включая долю исправленных голов; по измерениям автора, она совпадает с точным оператором внимания для 89-100 % голов.
Доступность
Клонируйте facok/comfyui-SelfLift в ComfyUI/custom_nodes и перезапустите; все узлы появятся в категории selflift. Пакет имеет документацию на английском и китайском языках, включая таблицу диагностических пресетов для настройки пути поднятия в H3.
Комментарии
Войдите через GitHub, чтобы участвовать в обсуждении.