MiniMax-H3-Image dans ComfyUI : 2 étapes avec un LoRA pDMD
Un LoRA pDMD en 2 étapes fait passer MiniMax-H3-Image de 6 à 2 étapes en 16 MP natif : de 25,1 s à 17,4 s par image, avec des flux de travail ComfyUI prêts à l'emploi.
 |  |
|---|---|
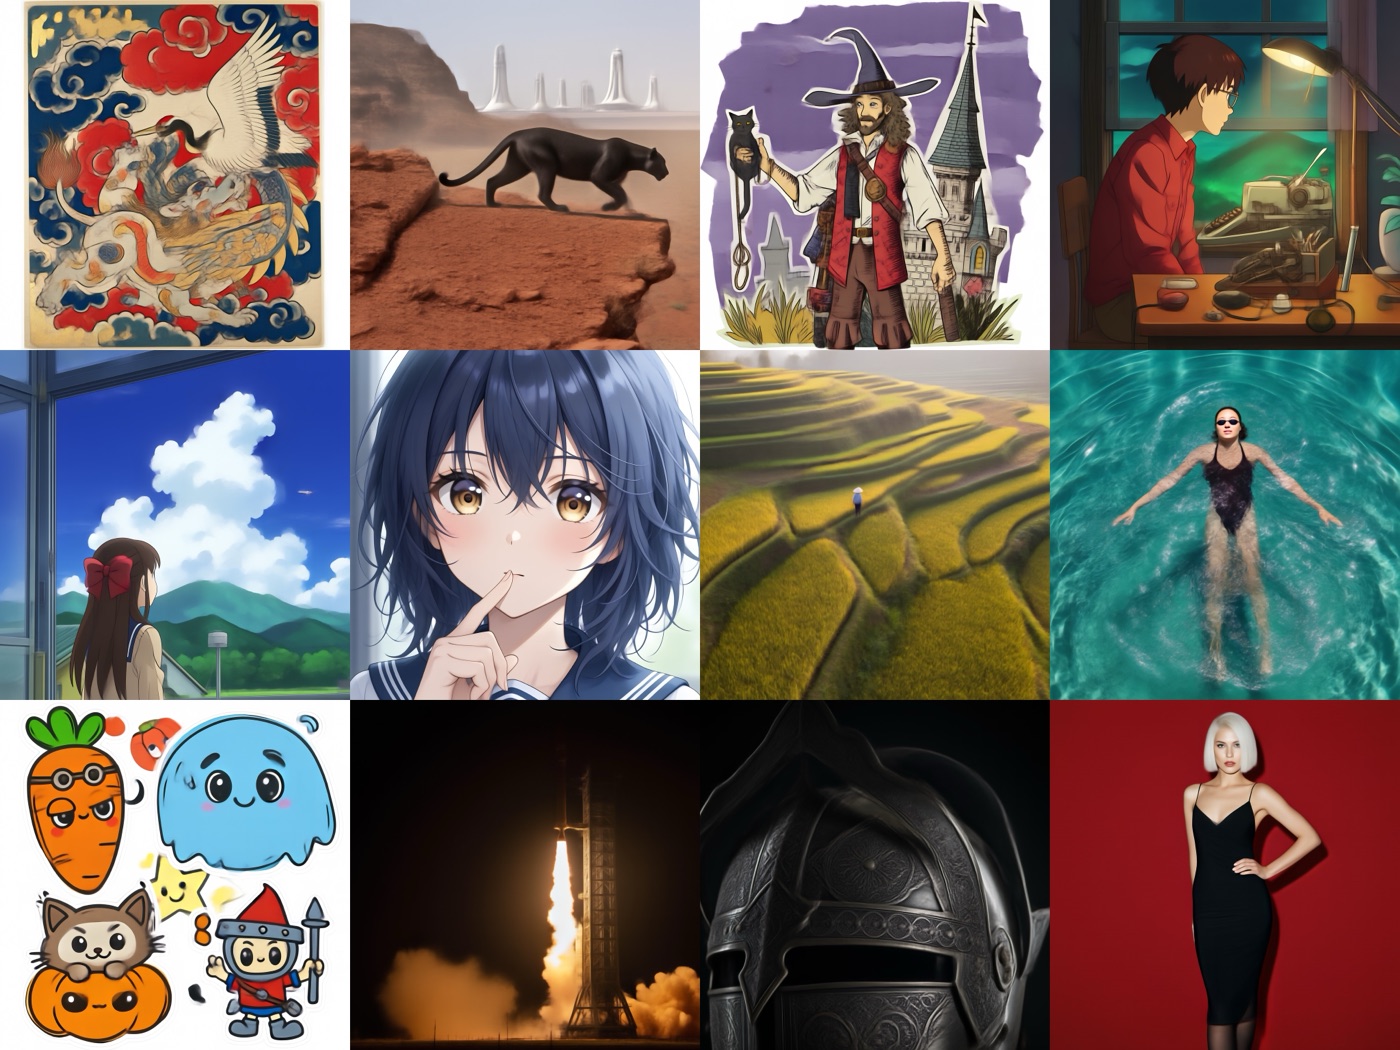
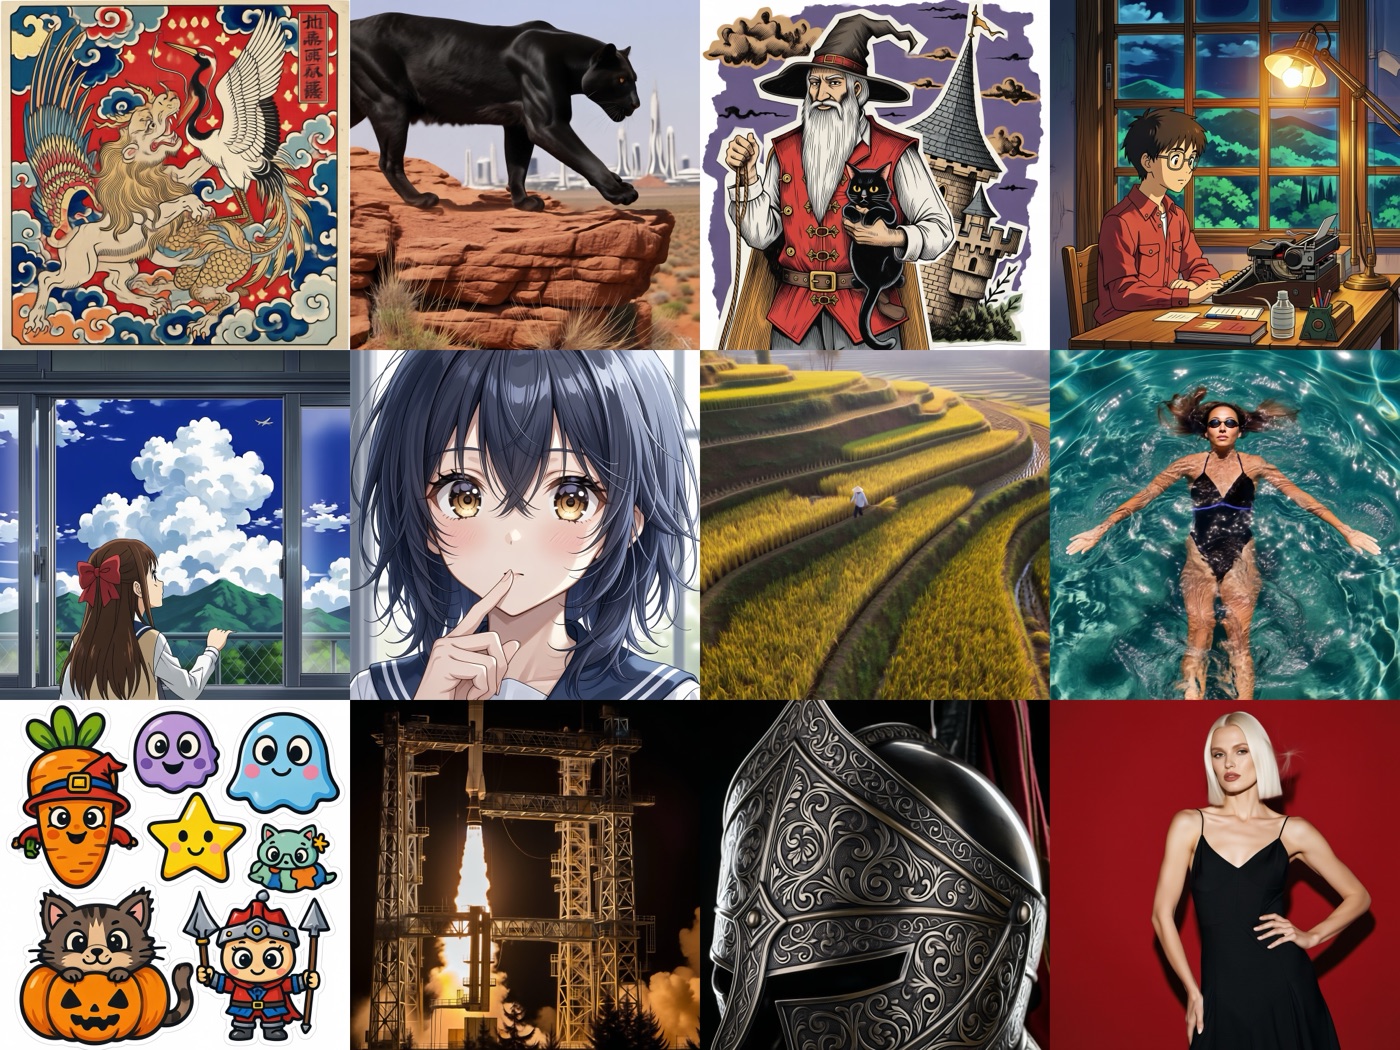
| Checkpoint standard, 2 étapes | Avec le LoRA pDMD, 2 étapes |
Douze prompts, 4096x4096, deux étapes, flow shift 12, graine 3. Le modèle standard ne peut pas descendre sous sa planification fixe de 6 étapes, donc à 2 étapes il est encore au milieu du débruitage.
Lancer le tout
Deux façons de le charger, même graphe.
- Un seul fichier : téléchargez le
minimax_h3_image_pdmd_2step_bf16.safetensorsde 40 Go dansComfyUI/models/diffusion_models/, plus un encodeur de texte Qwen3-VL-32B et le VAE d'image depuis Comfy-Org/MiniMax-H3-Image. Le LoRA est déjà fusionné : aucun nœud LoRA et aucune force à définir. - Base plus LoRA : conservez votre checkpoint Comfy-Org actuel et ajoutez le
minimax_h3_pdmd_2nfe_comfyui.safetensorsde 2 Go dansComfyUI/models/loras/, avec LoraLoaderModelOnly à une force de 1.0 entre Load Diffusion Model et MiniMaxH3SigmaShift. C'est la seule voie pour les repacksint8_convrotetw4a8, car les poids pré-fusionnés ne peuvent pas être construits sur des tenseurs rotés ou quantifiés.
Ensuite, échantillonnez en 2 étapes, euler, planificateur simple, denoise 1.0, shift_video 12, sans CFG. Le latent provient de EmptyHunyuanLatentVideo car le latent d'image H3 ne contient qu'une seule trame.
Ce que la vitesse apporte
| Configuration | 4096x4096, un H200 |
|---|---|
| Standard, 6 étapes | ~25,1 s |
| LoRA pDMD, 2 étapes | ~17,4 s |
| 2 étapes plus passe de raffinement IC | ~50 s |
Par image, le gain est d'environ 1,4x, pas 3x : 2 étapes au lieu de 6, mais chaque étape en 16 MP fait tourner le même transformer de 33B. Le vrai bénéfice est la vitesse d'itération sur le Space de démo, qui rend 2048x2048 en environ 4,6 s avec sa passe de détail, contre environ 7 s pour le Space officiel en 6 étapes à la même taille.
Deux étapes suffisent pour la plupart des prompts. Les prompts graphiques peuvent inventer du pseudo-texte et la composition peut dériver du résultat standard ; 3 étapes est le juste milieu sûr, et 4 étapes est le plus proche de la sortie en 6 étapes. Idem pour les retouches.
Passe de détail
Brouillon à demi-taille en 2 étapes, agrandissement en pixels avec lanczos, encodage VAE, puis un second échantillonnage à 3 étapes avec denoise = sigma_0. Le sigma de départ est le paramètre à ajuster : 0,4 à 0,55 affine le rendu tout en conservant le brouillon, 0,7 ajoute plus de détail mais peut créer du grain sur les zones plates et faire dériver les visages. Pour les retouches, restez à 0,55 ou en dessous.
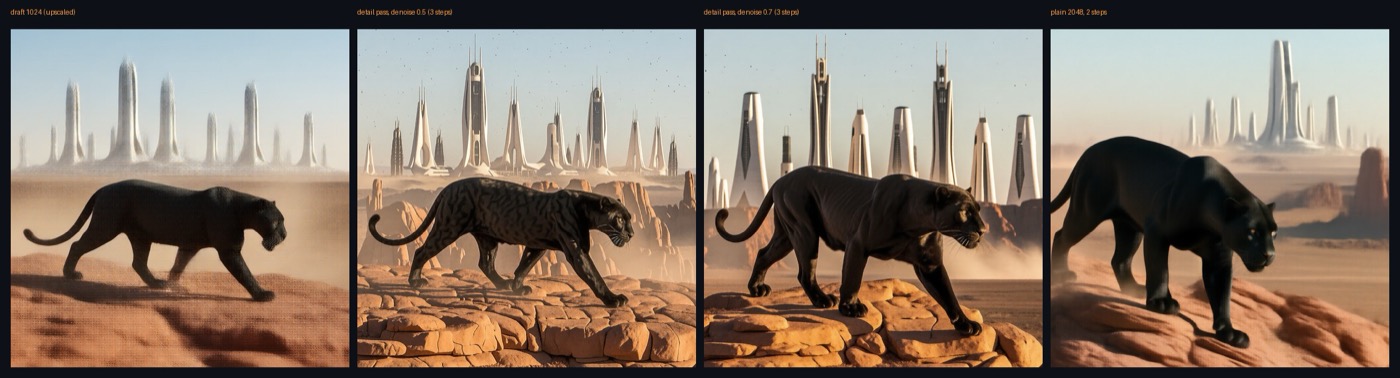
Brouillon à demi-taille (gauche), la passe à 0,5 et 0,7 (milieu), rendu plein format en 2 étapes (droite). La passe ajoute 1 à 2 s à 4 MP.
Aperçus en temps réel
Parce qu'une trame en 2 étapes coûte peu, le Space de démo rend environ 1 MP pendant que vous tapez, soit environ 0,9 s par trame sur sa build FP8, et affine le résultat quand vous faites une pause. C'est ce que le LoRA débloque : la planification standard reste bloquée à 6 étapes.
Édition de prompt en direct sur une source Mona Lisa, une trame en 2 étapes par segment.
Disponibilité
- LoRA, flux de travail et grilles : akhaliq/minimax-h3-image-pdmd-2step
- Space de démo : akhaliq/minimax-h3-image-2step
- Modèle de base : MiniMaxAI/MiniMax-H3-Image, repack ComfyUI dans Comfy-Org/MiniMax-H3-Image
- LoRA en amont : pdmd2026/pdmd_2NFE_lora, méthode dans arXiv 2609.35768
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.