SnapRef : adaptateur de référence à cache KV pour Anima
SnapRef v1a conserve un personnage Anima depuis une image de référence en mettant en cache les clés et valeurs d'attention, à 8,9 s par image. Nœuds ComfyUI et poids FP8 inclus.
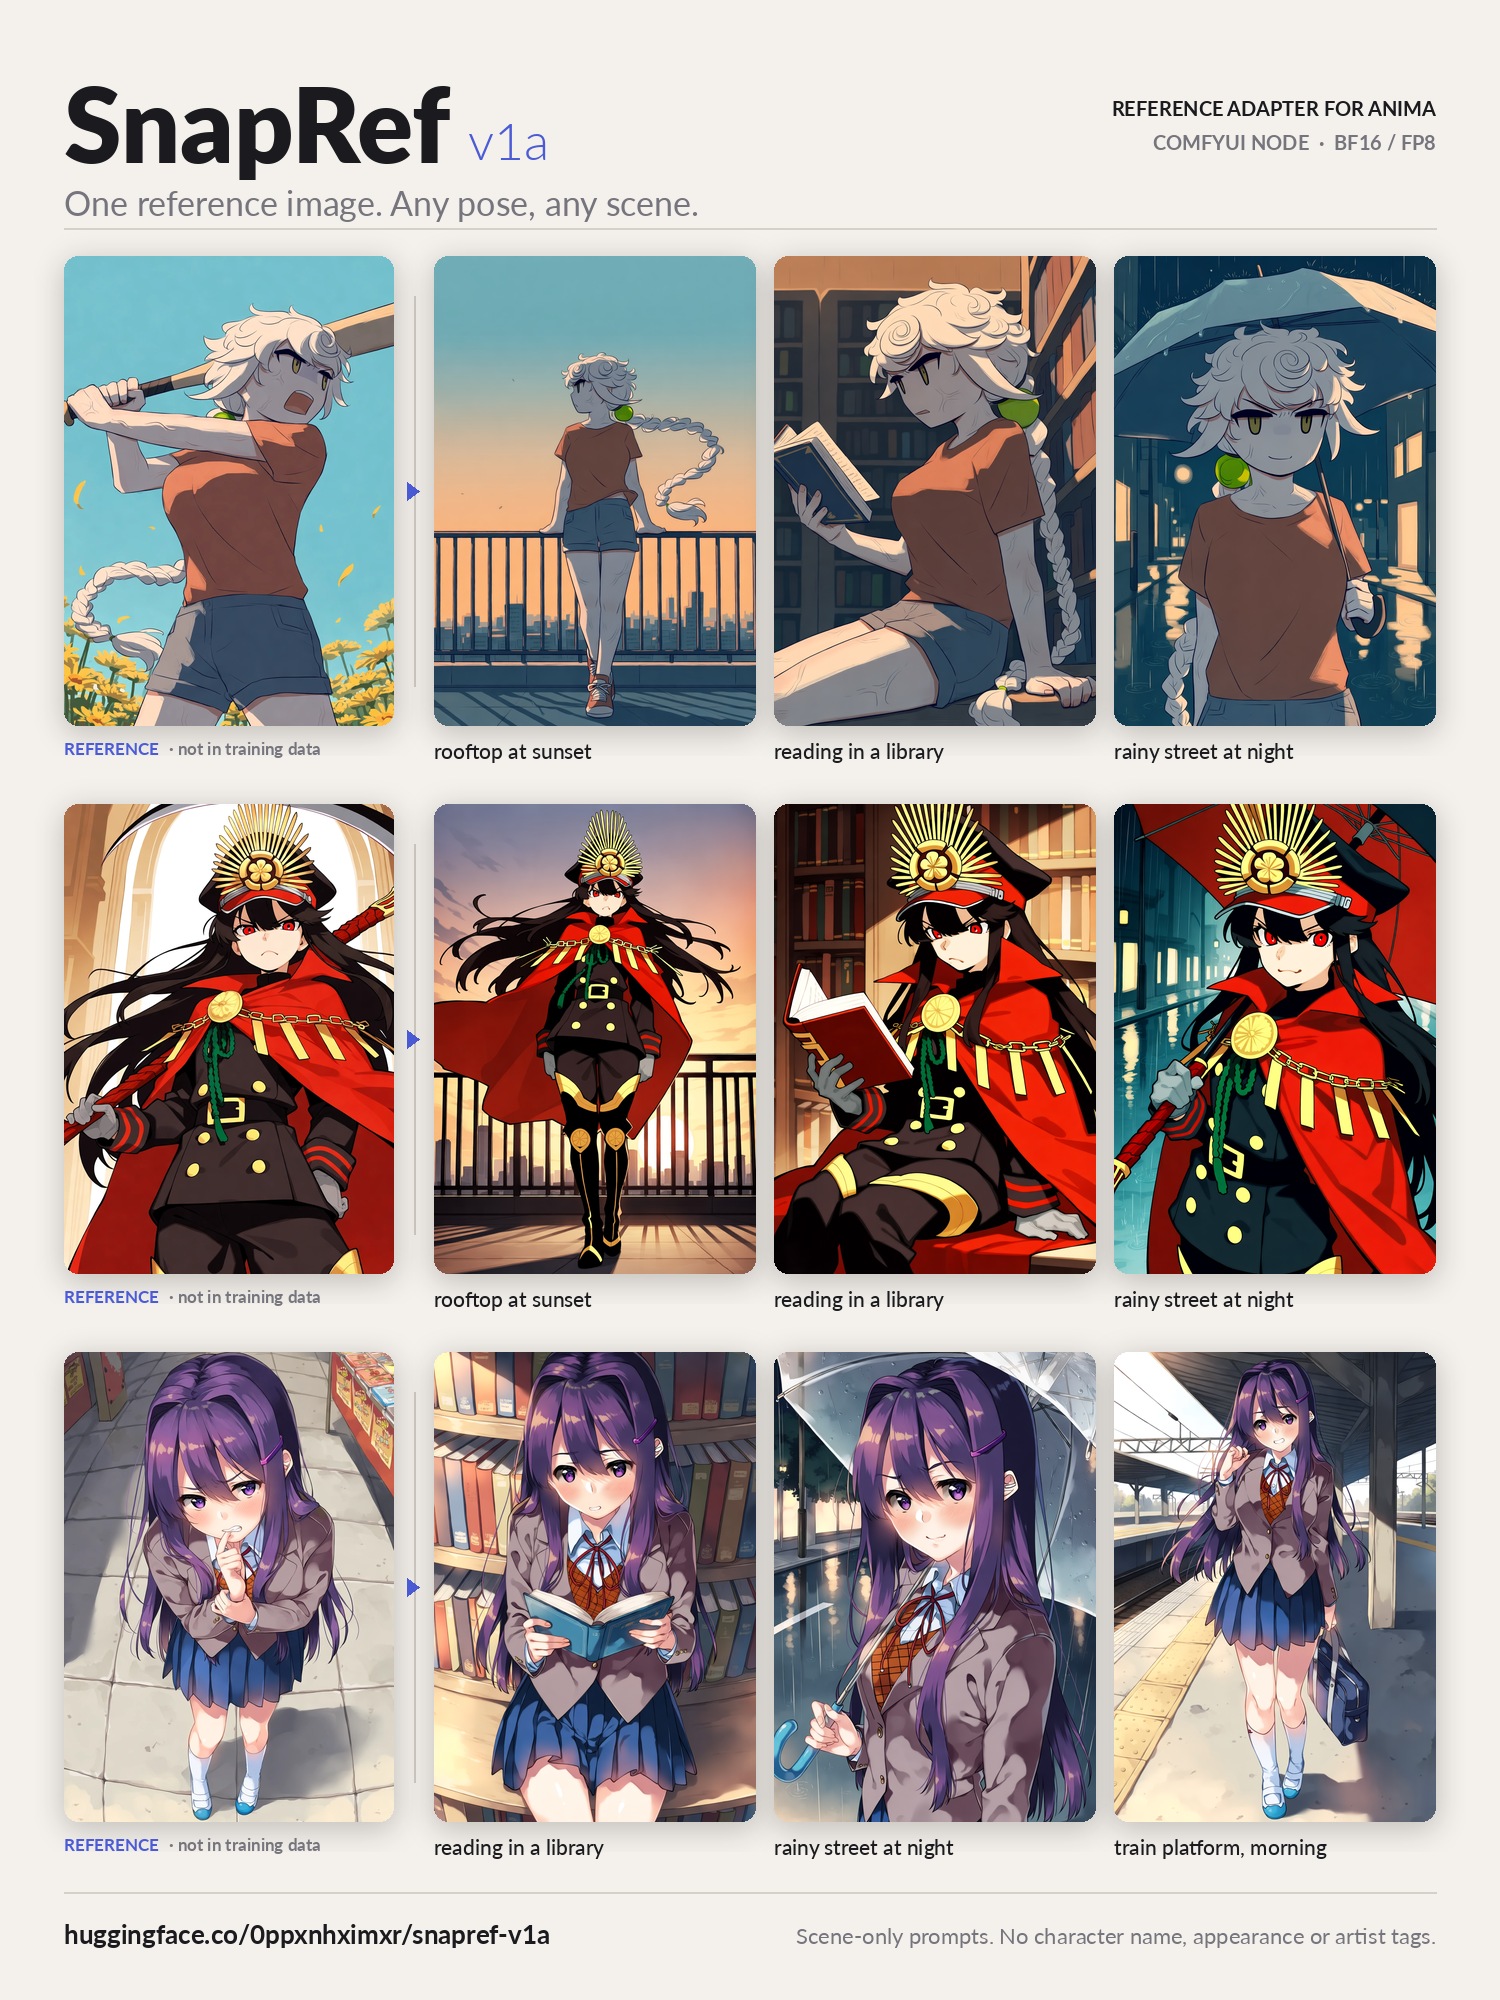
Une image de référence, un prompt qui ne nomme que la scène.
Anima est un modèle piloté par tags : un personnage est donc normalement reproduit en détaillant cheveux, yeux et tenue dans le prompt, et uniquement pour les personnages que le modèle connaît déjà. Un adaptateur de référence déplace ce travail vers l'image : le texte gère la pose, le cadrage et le lieu, la référence gère qui est dessiné.
L'idée n'est pas nouvelle sur Anima. Anima Reference Adapter l'a fait le 27 octobre en ajoutant la référence comme seconde frame latente décalée, pour que le prior de type vidéo ne puisse pas la poursuivre comme un plan. SnapRef emprunte une autre voie : il fait passer la référence dans le modèle une seule fois, met en cache ce que produit chaque calque, puis relit ce cache à chaque étape d'échantillonnage.
Comment la référence est mise en cache
Le fichier de l'adaptateur contient deux branches LoRA regroupées sous une seule clé, anima_ref_kv/1 : une branche de référence de rang 128 sur l'auto-attention, l'attention croisée et les deux couches MLP des 28 blocs, et une branche de rang 64 sur l'auto-attention côté cible. Cela représente 190,8 M de paramètres, soit 382 Mo en bf16.
La référence est encodée une seule fois et conservée sous forme d'un ensemble fixe de tokens, avec sa propre position dans l'espace de coordonnées du modèle, afin que celui-ci la lise pour l'apparence plutôt que d'en copier la disposition. Pendant l'échantillonnage, chaque calque assiste à ses propres tokens plus la référence mise en cache. Le LoRA côté cible reste actif à chaque passe avant de la cible, et par défaut seule la branche CFG positive lit la référence ; ref_guidance l'envoie dans les deux branches. Comme la référence n'est pas réencodée à chaque étape, la carte du modèle estime le surcoût à environ 15 % par rapport à une génération sans référence.
Deux modes sont exposés : cs copie le personnage et le style ensemble, char ne copie que le personnage pour que les tags d'artiste puissent définir le style. Un chemin ref_guidance distinct pousse plus fort vers la référence, à environ 1,4× le temps, avec un rescale APG ou CFG pour éviter la sursaturation des couleurs, la même correction dont l'adaptateur antérieur avait besoin.
Ce qu'il coûte face aux autres approches
Le référentiel fournit comparison_summary.json, un tableau de temps mesuré sur un même cas sur une A100 en 832×1216, 28 étapes, chaque adaptateur avec ses propres valeurs par défaut :
| Approche | Secondes par image |
|---|---|
| SnapRef v1a | 8,95 |
| ElectronGirl v2 | 14,36 |
| Role-Ref-KV | 12,53 |
| Anima Base, sans référence | 7,72 |
Sur l'identité, la carte du modèle indique que, pour des personnages exclus de l'entraînement, l'adaptateur prédit mieux la cible avec la bonne référence qu'avec une mauvaise : un écart d'identité de 0,0041 sur la perte de débruitage sur données tenues à l'écart, les chiffres par cas se trouvant dans heldout_loss.json.
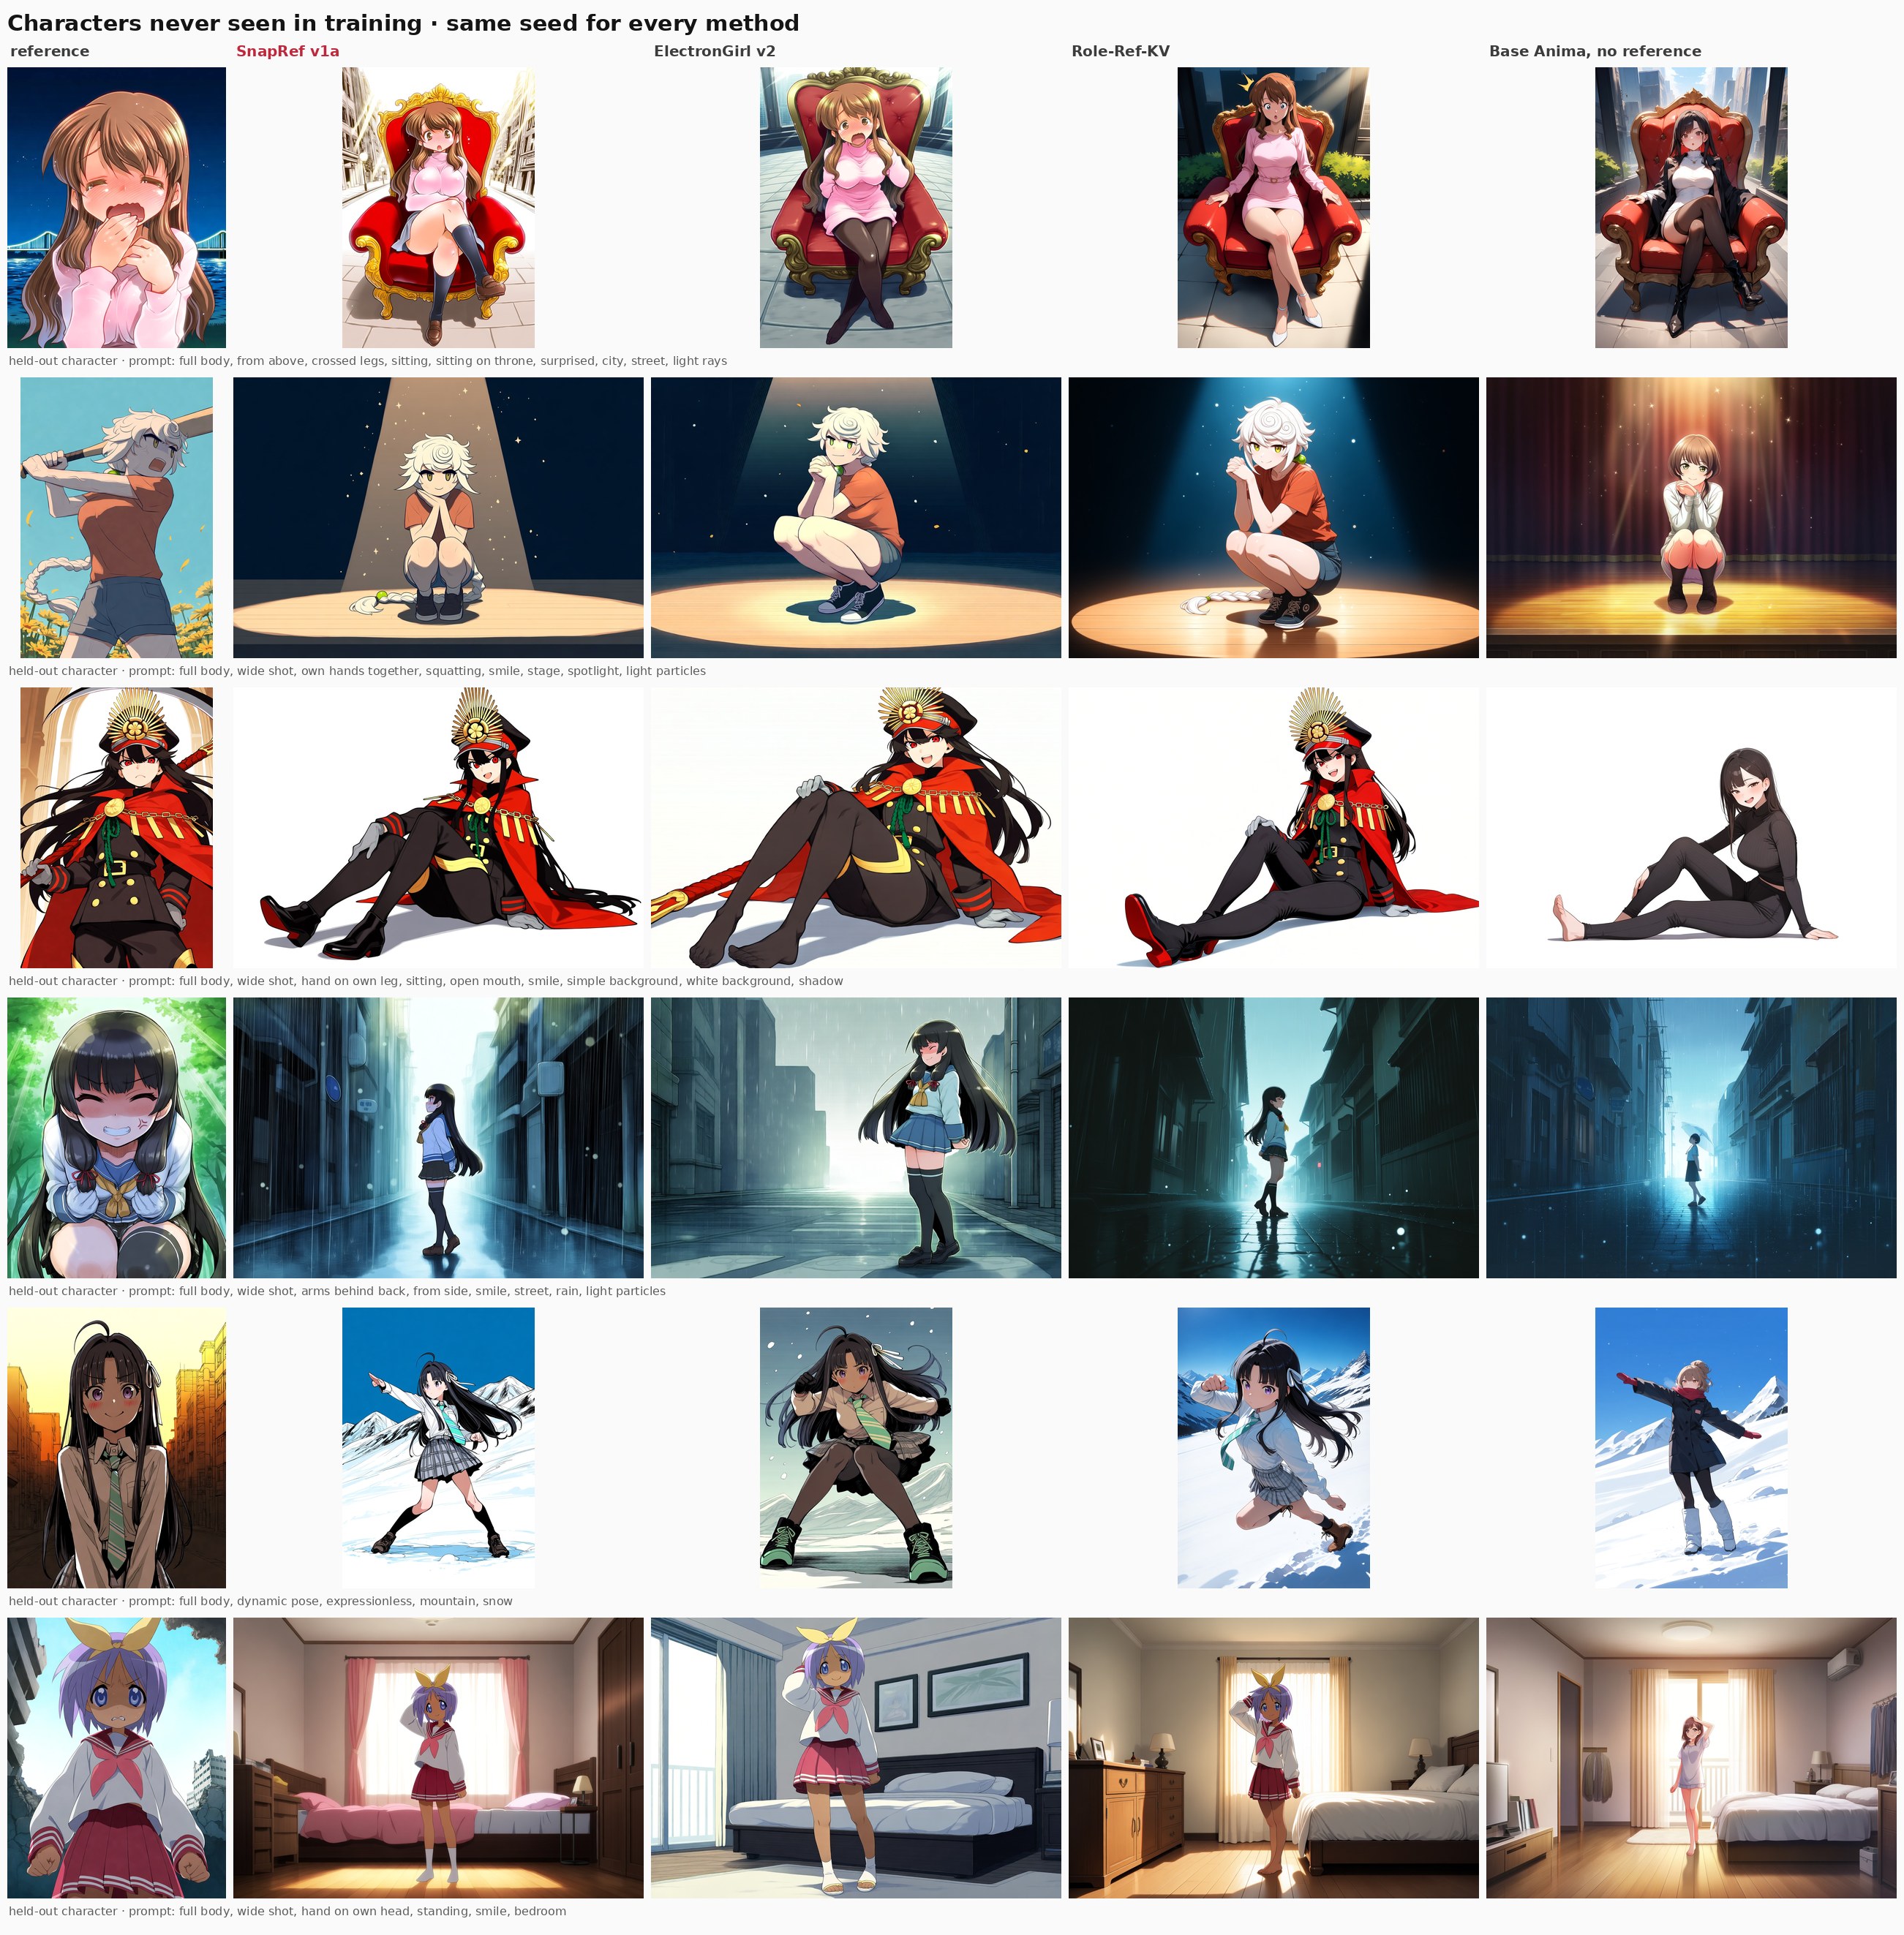
Personnages absents de l'entraînement. Le prompt ne nomme que la scène ; cheveux, yeux et tenue viennent de la référence.
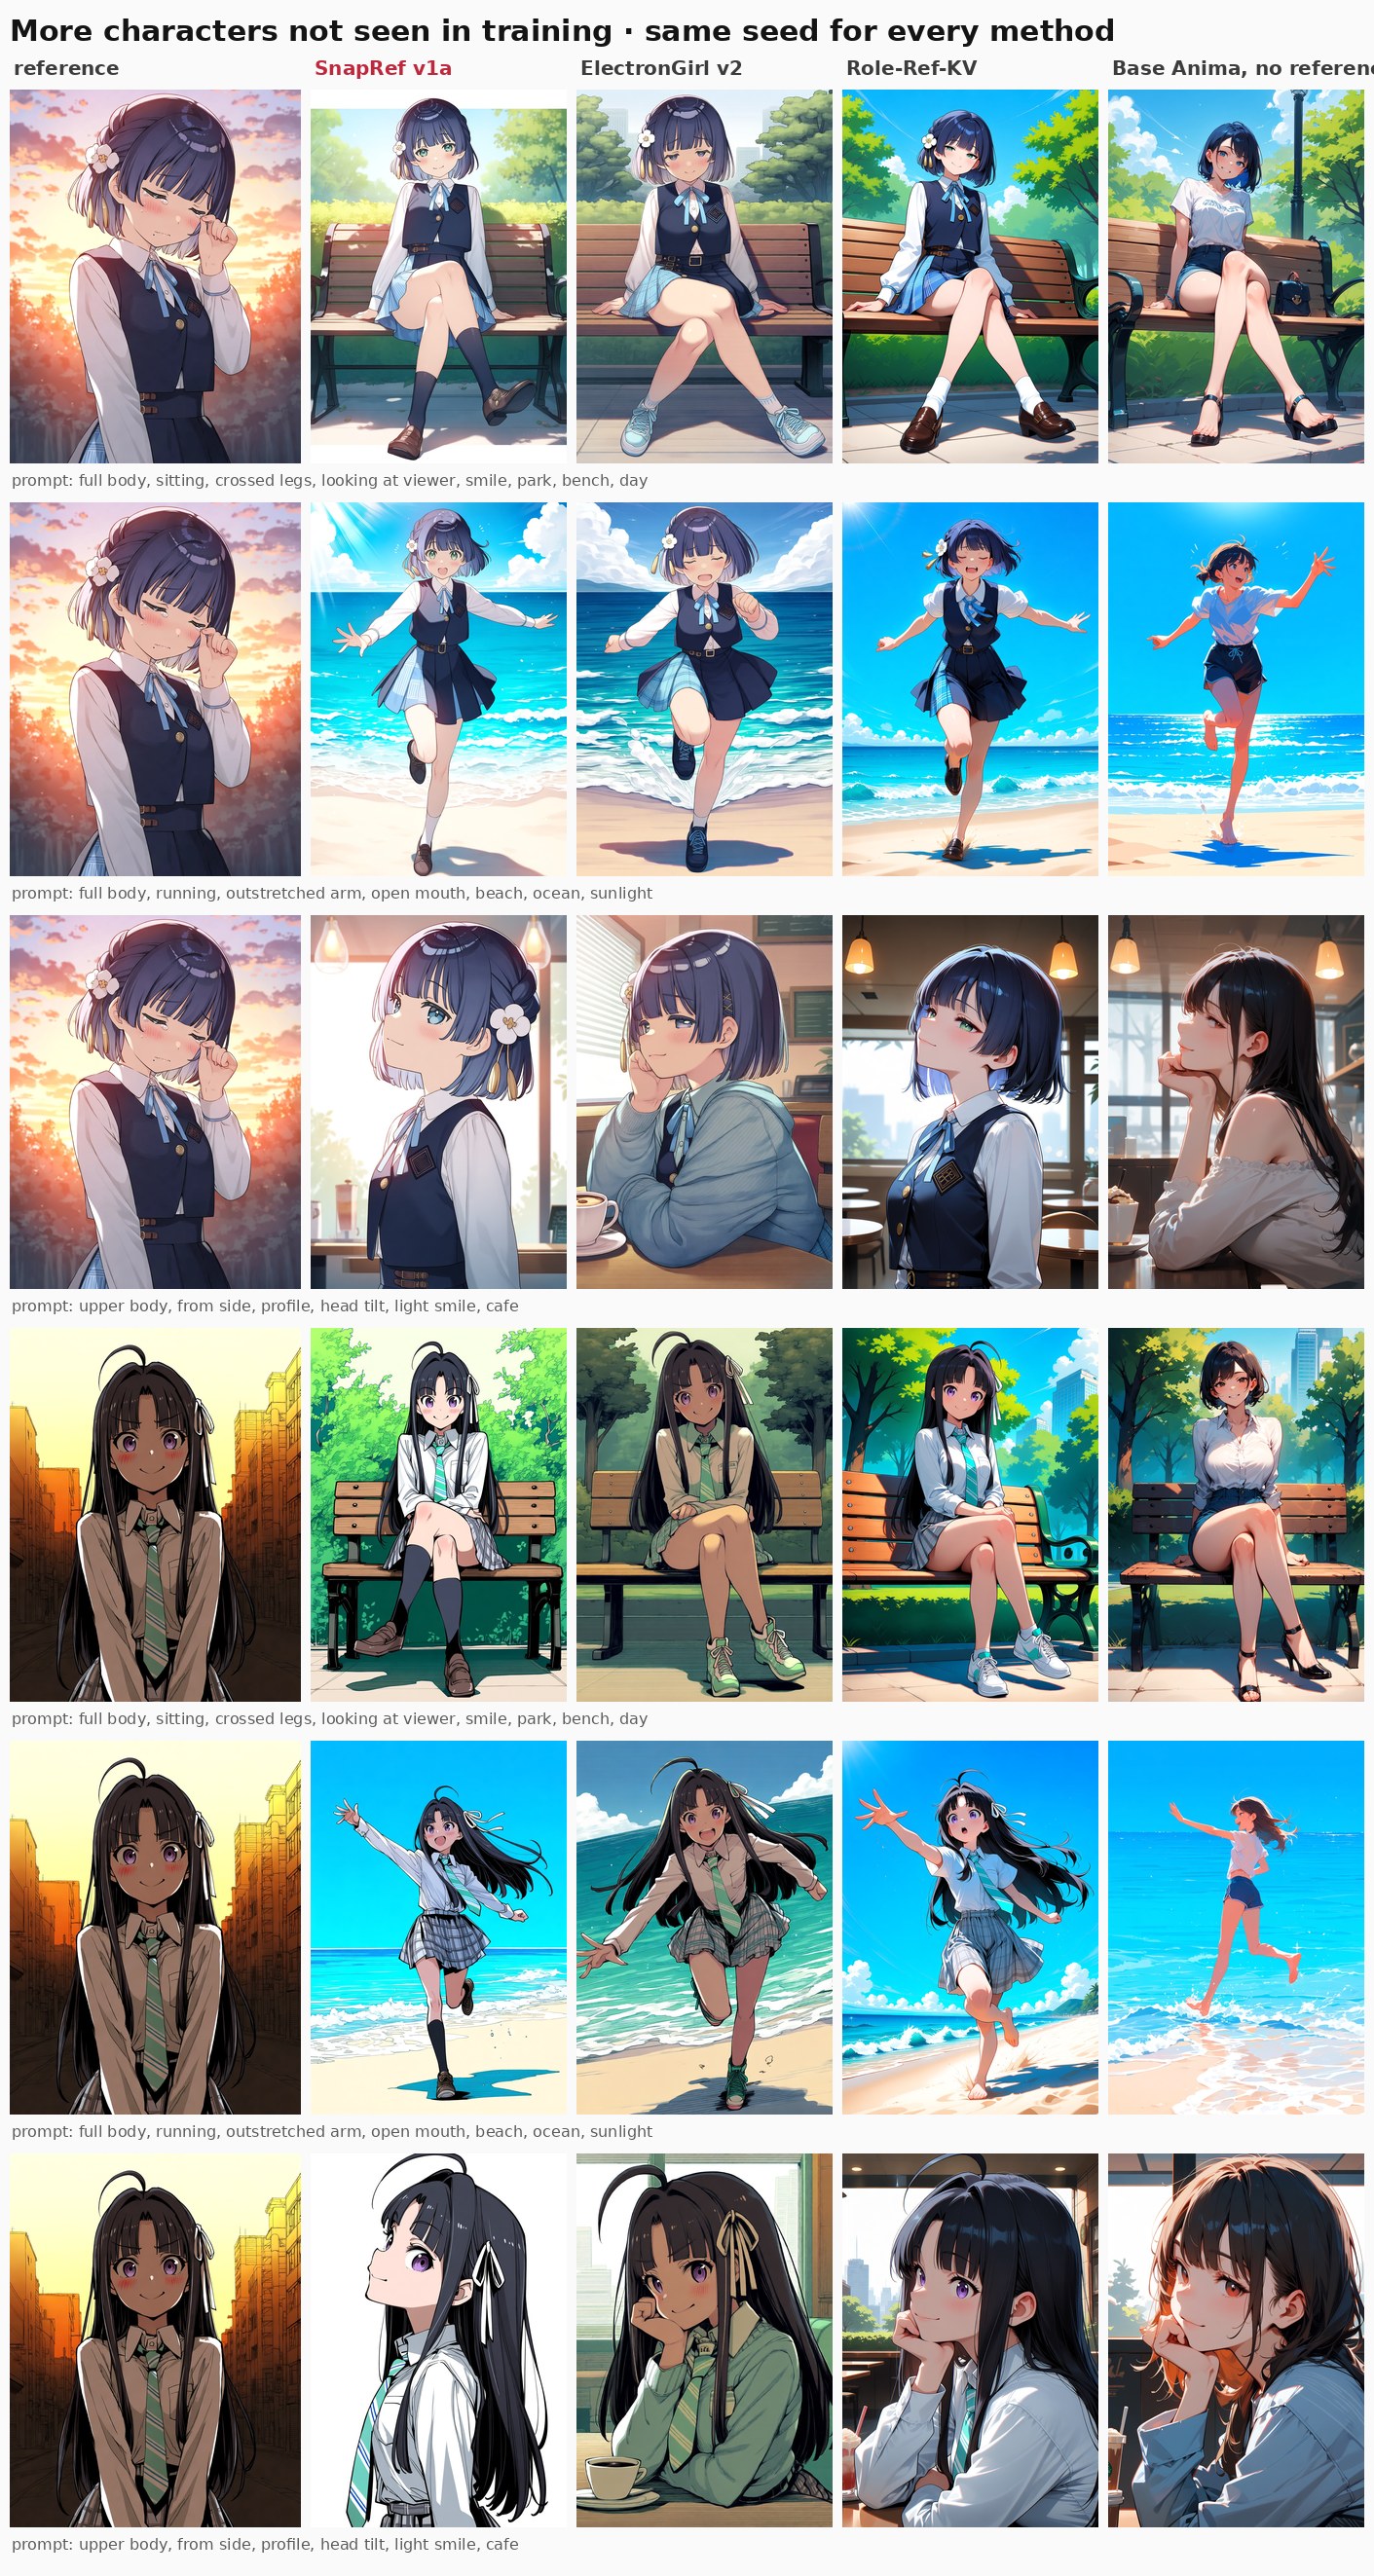
Des références extérieures au jeu d'entraînement, passées dans l'adaptateur.
Les données d'entraînement ont été générées par Anima lui-même : 58 300 images pour 2 367 personnages, chaque personnage dessiné dans une série de scènes et de poses dans un seul style d'artiste, puis un entraînement d'environ 120 heures de GPU H100. Un second checkpoint, SnapRef v1b, double le rang du LoRA, suit le prompt de plus près et conserve à peu près aussi bien le personnage.
Le côté ComfyUI
Le pack de nœuds se trouve dans le référentiel sous comfyui/snapref/ ; copiez-le dans custom_nodes/, déposez l'adaptateur dans models/loras/, et chargez-le avec le nœud SnapRef plutôt qu'avec un chargeur LoRA, car les deux branches ne forment pas un LoRA ordinaire. Le nœud simple prend une ou deux images, un mode, la force et la fidélité ; le nœud avancé expose tout le reste, y compris ref_in_uncond, ref_megapixels et ref_caption.
Cinq flux de travail sont inclus : un seul personnage, deux personnages, plusieurs références d'un même personnage, une comparaison côte à côte avec d'autres adaptateurs, et le flux minimal ci-dessous. Pour deux personnages, les instructions indiquent d'assembler les deux références avec le nœud Image Stitch de base et de décrire dans le prompt qui est à gauche et à droite. L'échantillonnage RECOMMANDÉ est euler ou er_sde avec simple, 28 à 30 étapes et CFG 4,5.
L'adaptateur FP8 pèse 195 Mo au lieu de 382 Mo et donnerait pratiquement les mêmes images, y compris sur la base Anima FP8. Le nœud a été mis à jour le 31 octobre pour conserver l'encodage de la référence en fp32 : avec un checkpoint fp16, --fp16-unet, ou --fast avec accumulation fp16, la version antérieure produisait des NaN et une image noire.
Là où ça casse
La carte du modèle énumère les modes de défaillance plutôt que de les cacher. Les détails très fins comme les boucles d'oreilles, les motifs délicats et les cicatrices peuvent être simplifiés, une référence à peau sombre peut ressortir plus claire, et certains prompts de plein pied en extérieur transforment le bas du cadre en un sol blanc uni, sauf si le sol est nommé. Une scène peut supplanter la tenue de la référence : un prompt de plage renvoie un maillot de bain ; augmenter la strength ou nommer la tenue la maintient. Avec deux personnages, des attributs que les références ne montrent pas clairement, des yeux fermés par exemple, peuvent être mélangés entre eux.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.