Anima Reference Adapter : une image, une nouvelle scène dans ComfyUI
Anima Reference Adapter garde le personnage et son style depuis une seule image, le prompt fixant pose et décor. LoRA de rang 32 et trois nœuds ComfyUI.
Les modèles d'anime pilotés par tags ne dessinent le personnage demandé que si le prompt énumère chaque trait, et uniquement pour les personnages que le modèle connaît déjà. Un adaptateur de référence retire cette tâche au texte : on le pointe vers une seule image, et le prompt est libre de décrire la pose, le cadrage et le lieu.
La plupart des conditionnements de référence empruntés aux modèles vidéo ne font pas ce compromis. ComfyUI-Cosmos-Reference ajoute un latent de référence comme image supplémentaire du clip, ce qui fonctionne bien pour l'édition mais copie aussi la pose et la disposition de la référence, car le prior vidéo lit cette image comme le plan précédent. Anima Reference Adapter demande l'inverse : conserver qui est dessiné et comment, abandonner où et dans quelle pose.
Comment la référence est attachée
Anima repose sur le Cosmos-Predict2 MiniTrainDIT : 28 blocs, largeur 2048, 16 têtes, patchs spatiaux 2×2 sur un latent VAE Wan 2.1 à 16 canaux, avec un encodeur de texte Qwen3-0.6B et du flow matching à shift 3. Cela lui donne des embeddings de position rotatifs 3D sur (t, h, w), qui constituent le levier utilisé par l'adaptateur.
L'image de référence est adaptée en letterbox à la résolution de sortie, encodée une fois par le VAE, puis ajoutée comme seconde image latente. Trois changements la distinguent d'une référence de type vidéo classique :
- Image de référence propre. L'image de référence est injectée au timestep 0, l'image cible à σ. Rien n'est bruité du côté référence.
- RoPE décalé. Les coordonnées de hauteur de l'image de référence sont décalées au-delà de la grille cible (d'une hauteur cible, plus un léger jitter pendant l'entraînement), de sorte qu'aucune correspondance pixel à pixel ne subsiste et que le modèle ne peut pas prolonger la référence comme un plan.
- Un lecteur entraîné. Un LoRA de rang 32 avec α = 32 sur l'auto-attention, la cross-attention et les deux couches MLP de chaque bloc (280 modules, 45,9 M de paramètres) apprend à lire cette image déplacée. Il est appliqué via des crochets forward, et uniquement pendant les appels au modèle qui transportent une référence, de sorte qu'un modèle de base chargé peut toujours exécuter une passe sans référence.
Le guidance est lui aussi scindé. Avec la référence dans les deux branches CFG, seul le texte est amplifié ; le guider utilise plutôt des échelles distinctes pour le texte et la référence, de sorte que ref_guidance peut déplacer le résultat vers la référence sans toucher au cfg. Un guidance de référence élevé sature, donc le nœud applique en plus soit le guidance adaptatif projeté, soit le rescale CFG.
Ce que montrent les personnages non vus à l'entraînement
Les données d'entraînement sont synthétiques et produites par Anima lui-même : 600 groupes d'un personnage dans un style, six rendus chacun avec un cadrage, une caméra, une pose, une expression, un arrière-plan et un éclairage échantillonnés indépendamment, soit 3 600 images couvrant 300 personnages et 427 artistes, sur un seul RTX PRO 6000 Max-Q en 4,25 heures. Douze personnages ont été entièrement tenus à l'écart ; les 576 groupes restants ont produit 17 280 paires référence-cible ordonnées, dont 70 % retiraient tous les tags d'apparence et de tenue du prompt cible.
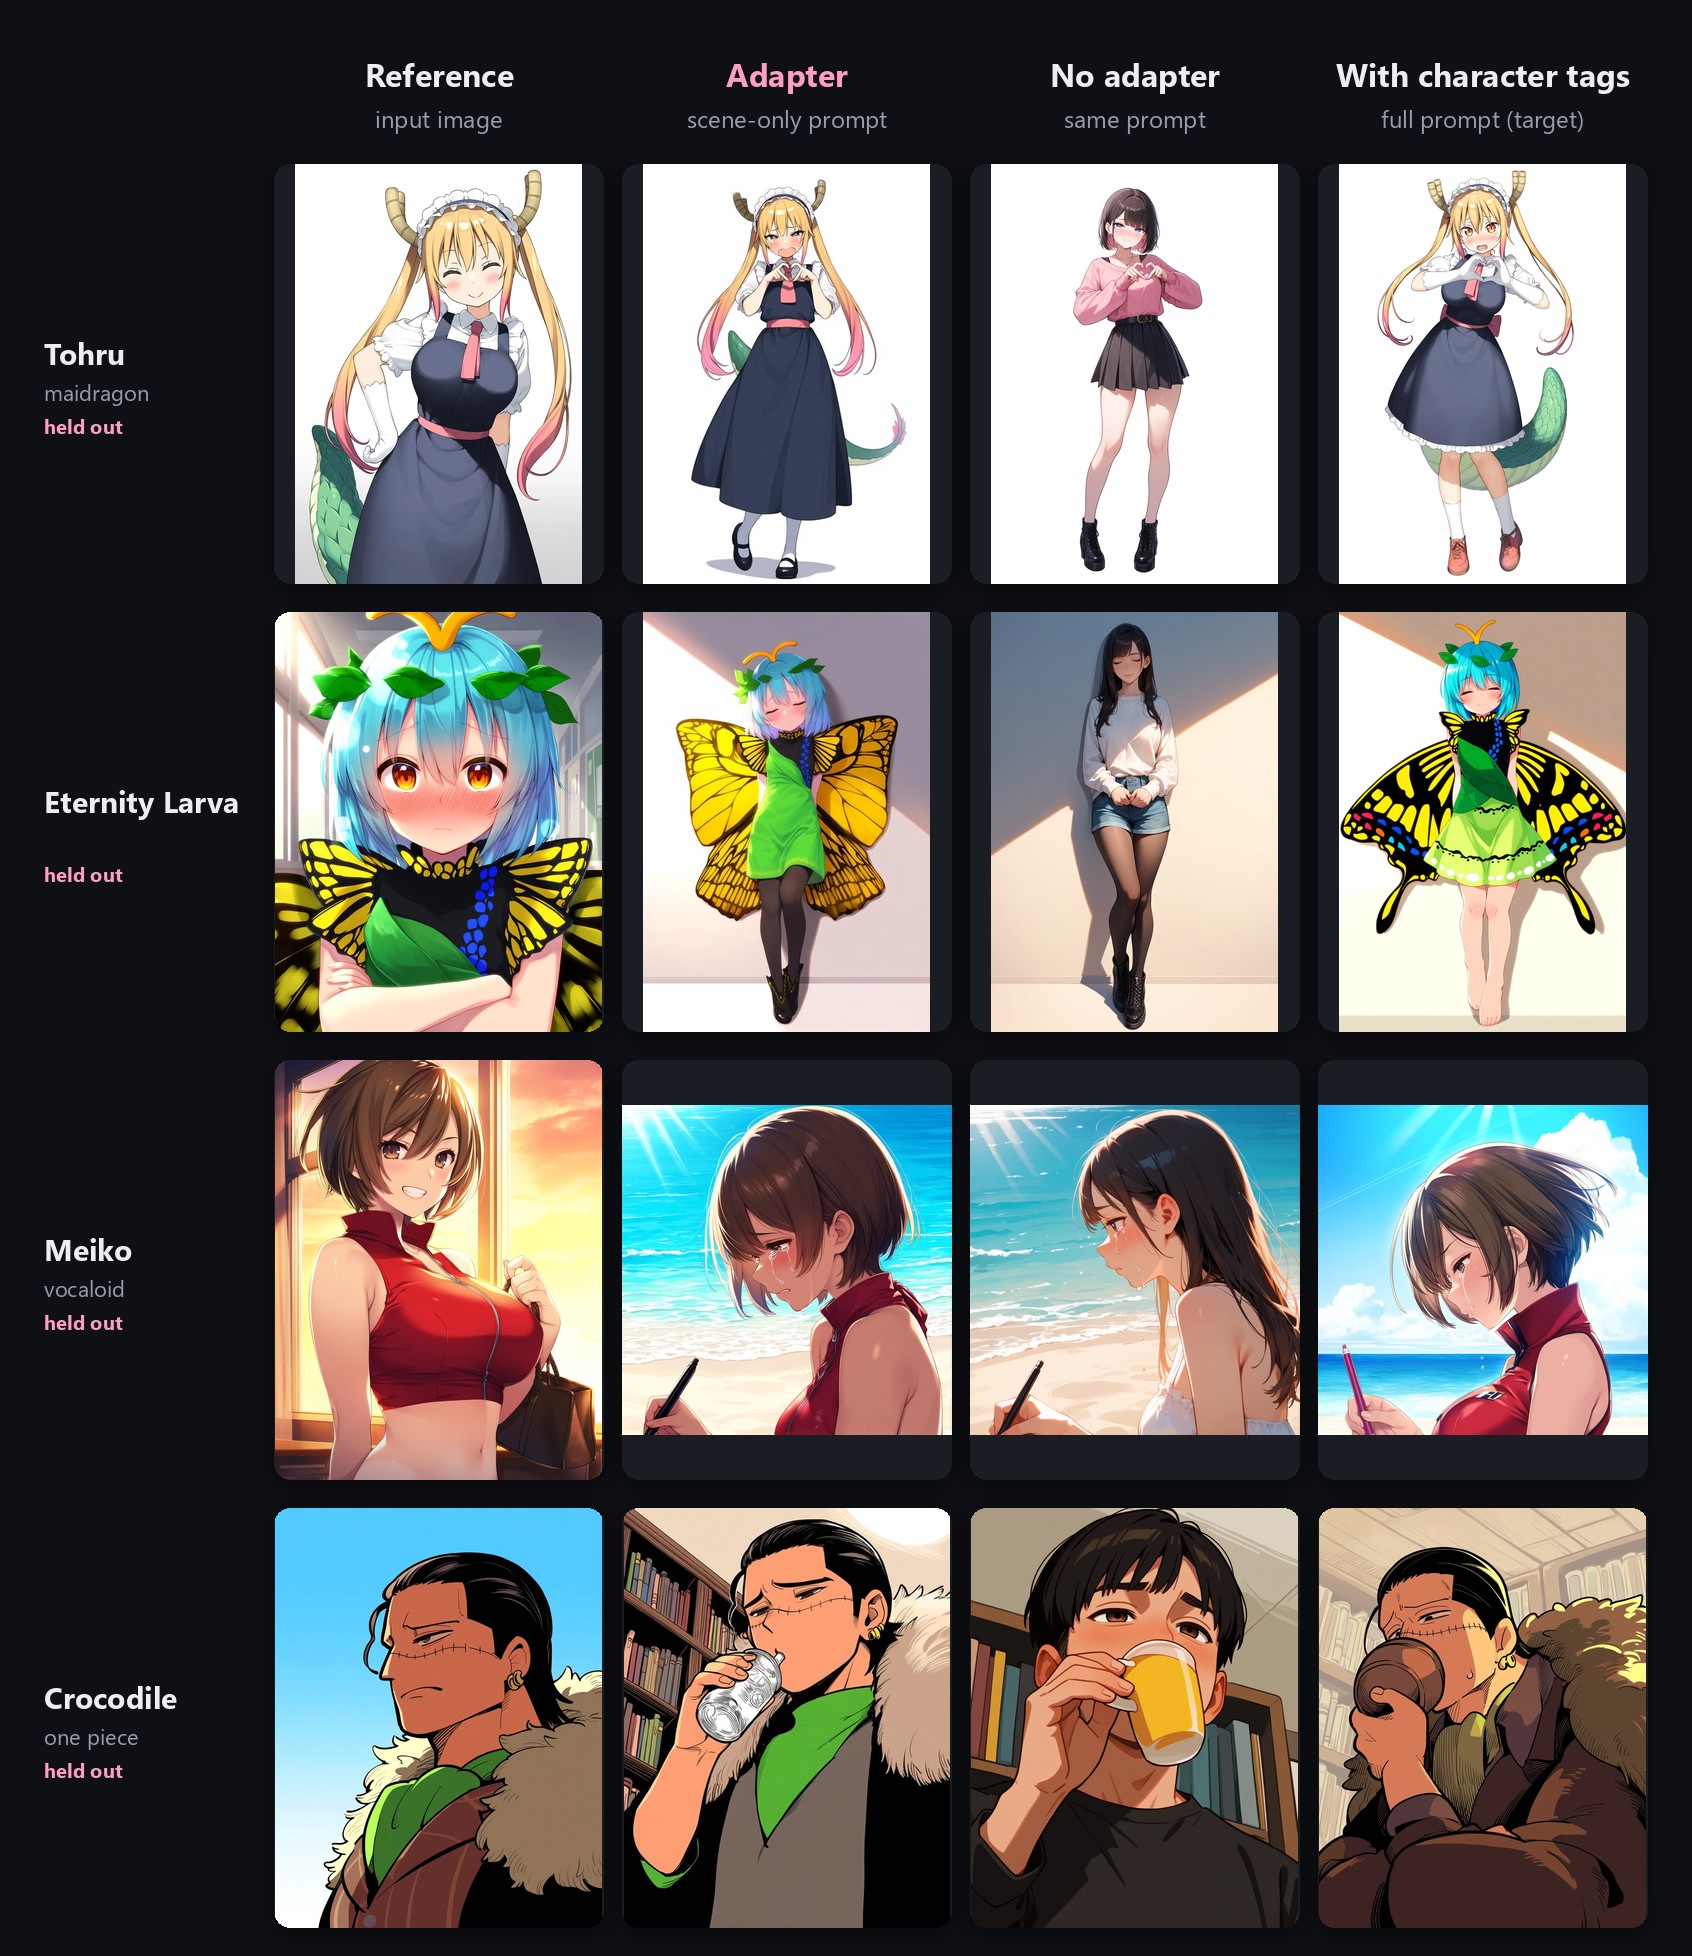
Personnages tenus à l'écart, jamais vus à l'entraînement. Chaque ligne : la référence ; l'adaptateur avec un prompt décrivant uniquement la scène ; le même prompt sans l'adaptateur ; et le modèle de base à qui l'on demande le personnage par son nom avec tous ses tags d'apparence.
Sur les 18 cas d'évaluation, l'adaptateur reproduit la couleur et le style des cheveux, la couleur des yeux, la tenue et les accessoires caractéristiques comme des cornes et une queue, un halo, des ailes de papillon ou une coiffe de maid, tandis que le même prompt décrivant uniquement la scène, sur le modèle de base nu, renvoie un personnage générique. La pose, le cadrage et l'arrière-plan suivaient le prompt dans tous les cas, sans aucune copie de pose observée.
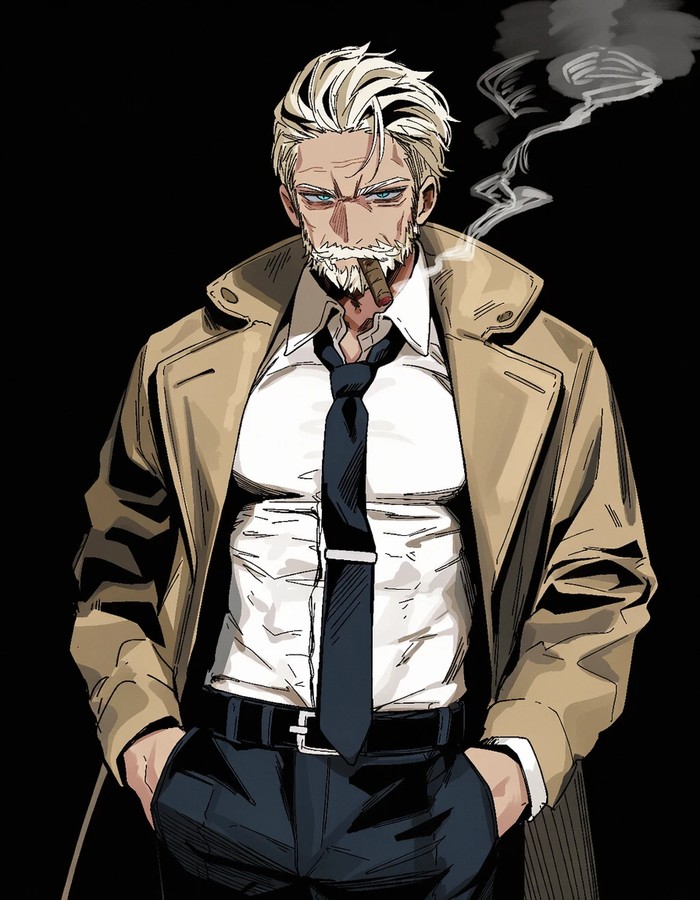
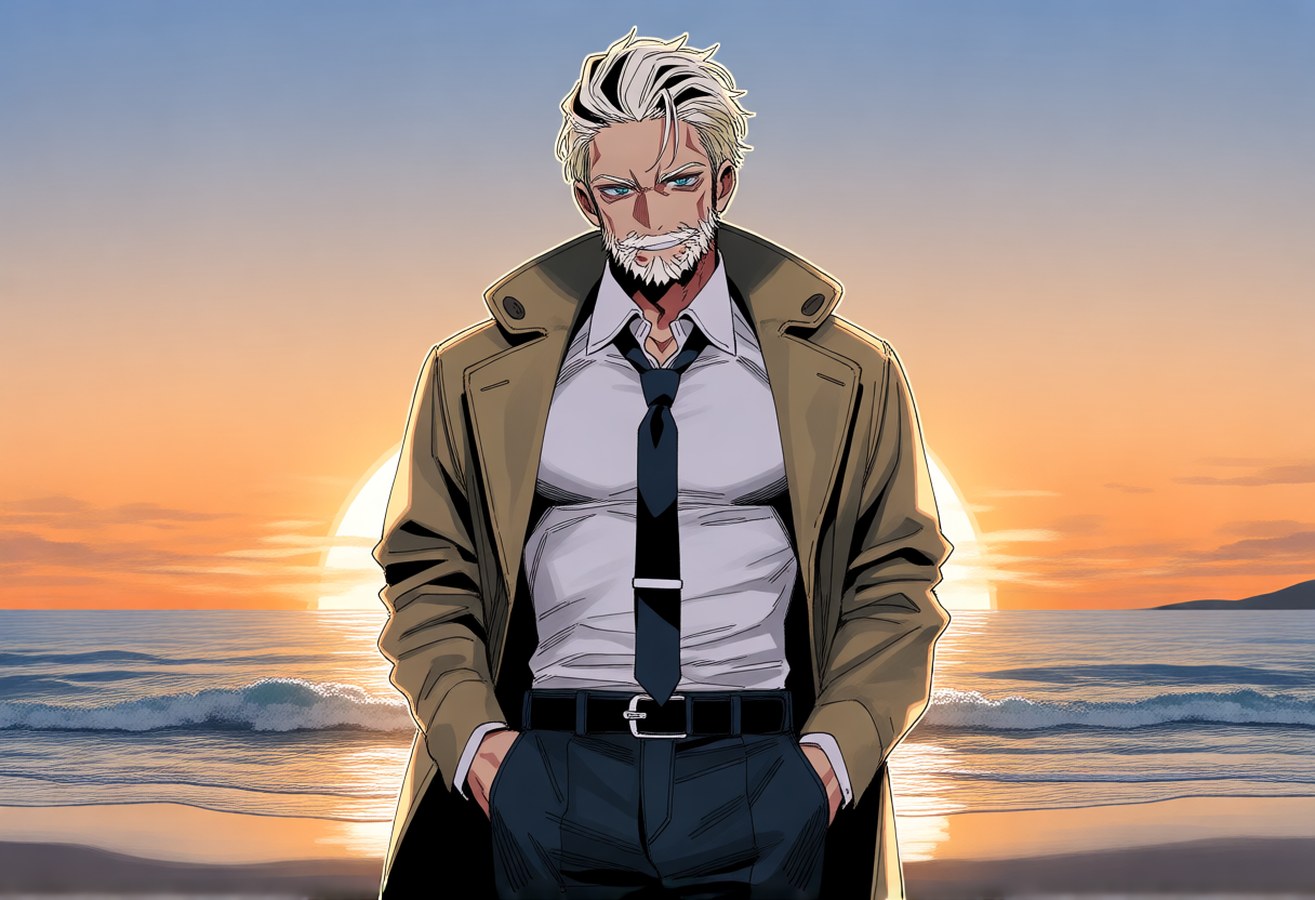
Deux références ordinaires montrent la même séparation en dehors du jeu tenu à l'écart :
 |  |
|---|---|
| Référence A, la seule image donnée à l'adaptateur | cowboy shot, looking at viewer, smile, beach, ocean, sunset |
Le prompt ne contient aucun nom de personnage, tag d'artiste ou tag d'apparence. Les paramètres recommandés sont Euler à 28 à 30 étapes avec simple, un CFG texte de 4,5, un guidance de référence de 4,5 à 6 avec APG, et un calcul en bf16, car Anima déborde en fp16.
Le style est la moitié la plus faible
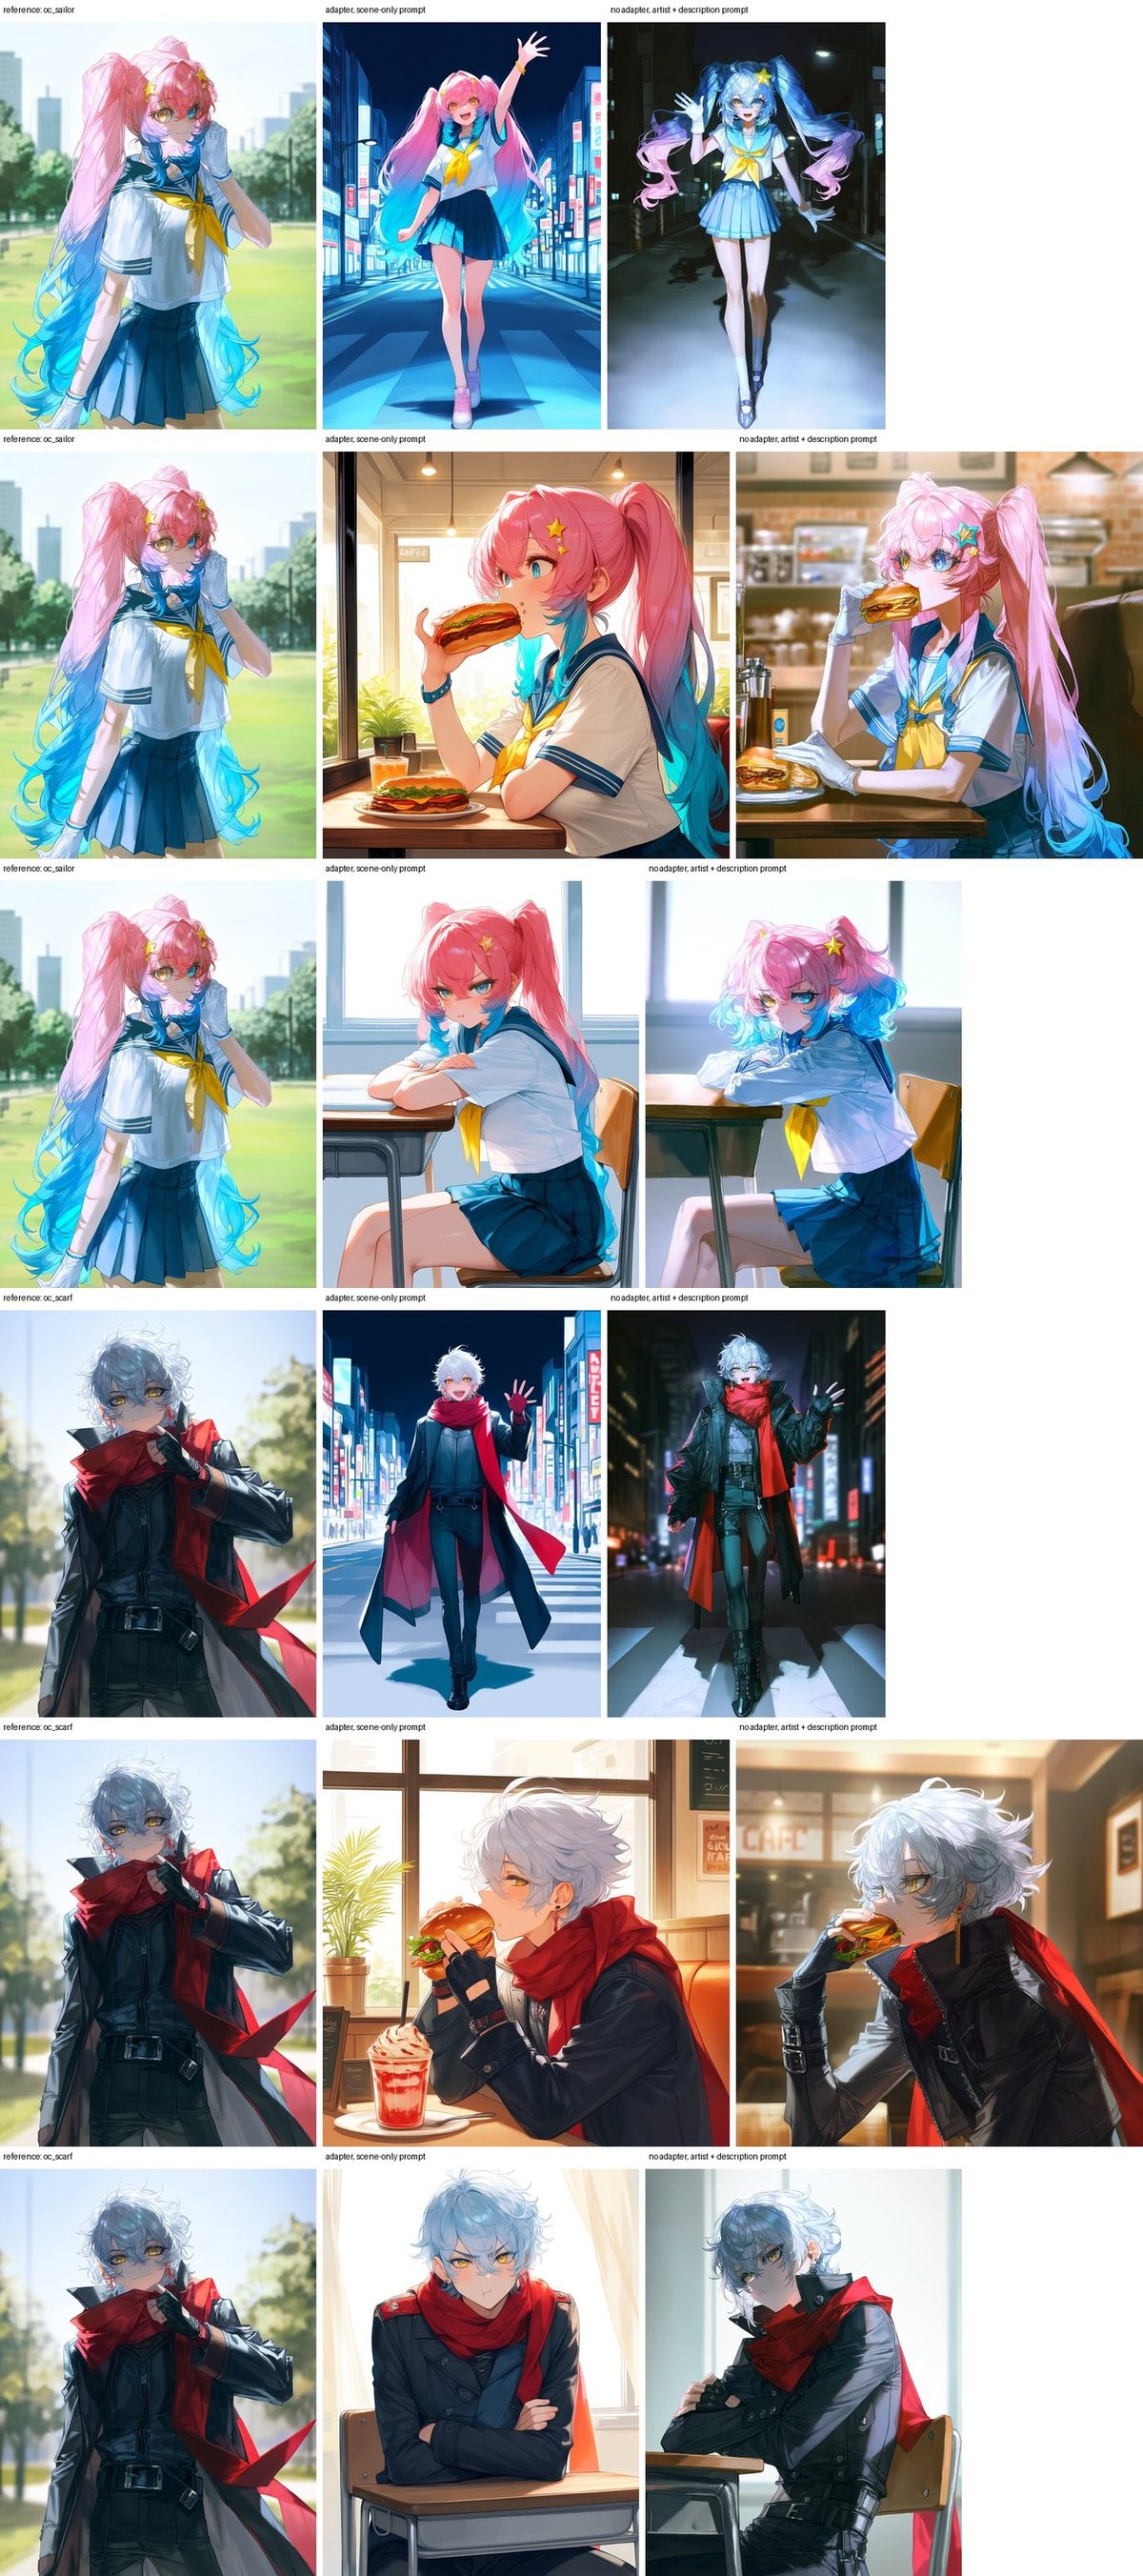
Personnages originaux dessinés par le modèle de base avec un tag d'artiste jamais apparu à l'entraînement. Chaque ligne : la référence ; l'adaptateur avec un prompt décrivant uniquement la scène ; le modèle de base avec les tags d'artiste et de description.
Le design du personnage se transfère bien : twintails dégradés, ornements en forme d'étoile dans les cheveux, un foulard, des cheveux argentés avec une écharpe rouge et des gants. Le rendu pictural de l'artiste, l'éclairage doux et la palette désaturée ne passent pas à un guidance de référence de 1, et les sorties retombent sur l'aspect Anima par défaut, plus net.
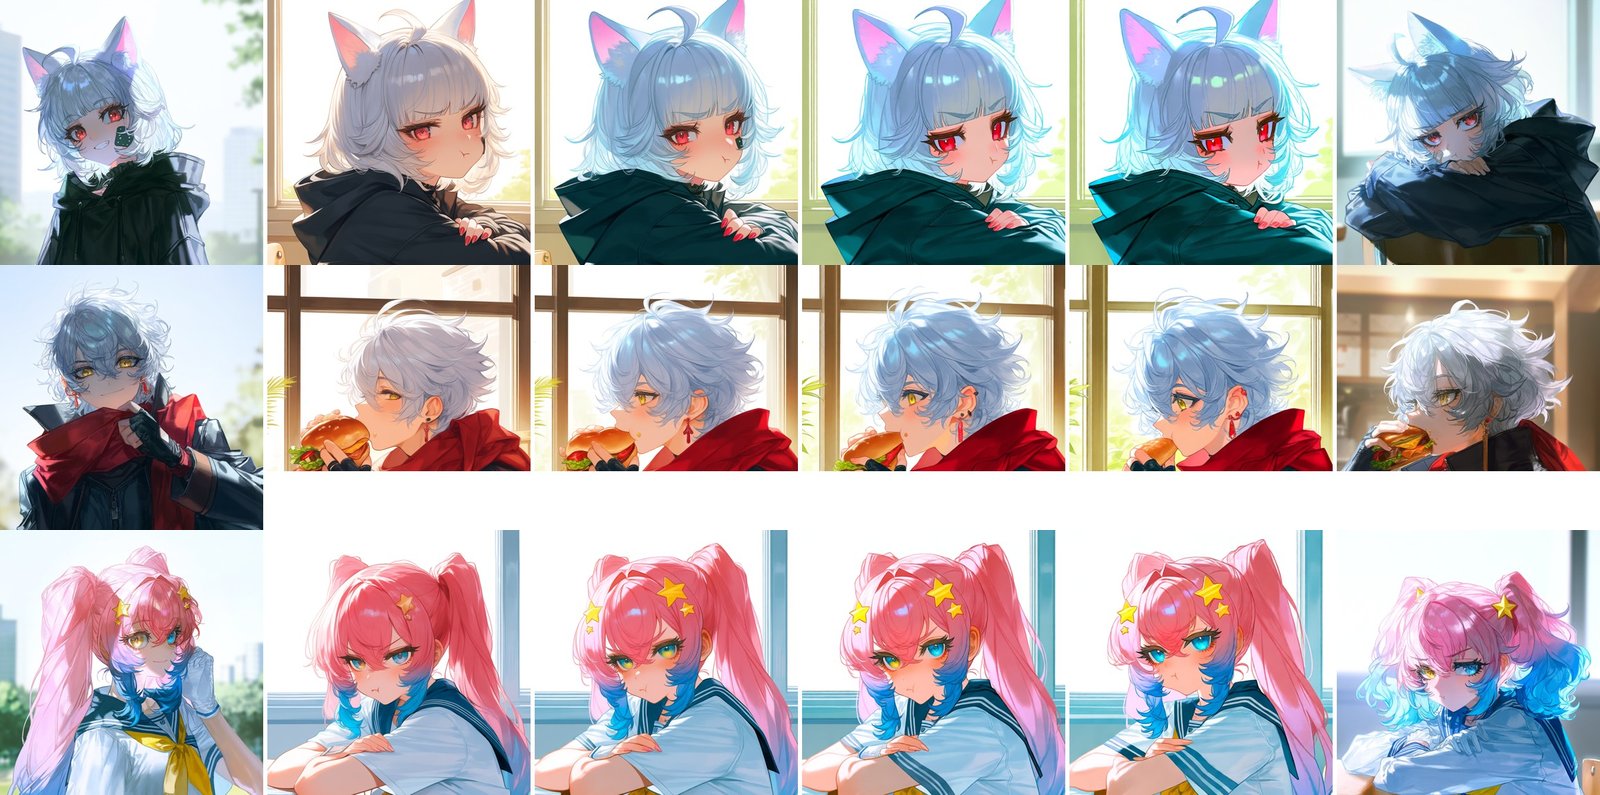
Recadrages à un guidance de référence de 1, 2,5, 4,5 et 6 à côté de la référence, avec le modèle de base et tous les tags à droite.
Augmenter le guidance de référence fait revenir la texture et les reflets des cheveux, le rendu des yeux, la palette froide et les petits accessoires comme un bandage ou une hétérochromie que le guidance 1 fait disparaître. Au-delà d'environ 4,5, les couleurs saturent et la dérive existante est amplifiée, ce à quoi sert la correction APG ou rescale. Le rendu pictural n'apparaît toujours pas, ce que le rapport attribue au fait que le LoRA en a peu appris plutôt qu'à une sous-amplification. L'auteur génère un ensemble plus large de 2 000 personnages dans trois styles d'artiste et prévoit des références distinctes pour le personnage et pour le style.
Les nœuds
| Nœud | Ce qu'il fait |
|---|---|
| Anima Ref Adapter Loader | Attache le LoRA de l'adaptateur à un MODEL Anima. ref_offset_h reste à 1.0, la valeur d'entraînement. |
| Anima Ref Latent | Ajuste la référence à la taille de sortie avec un rembourrage blanc, l'encode, et renvoie aussi le latent vide pour cette résolution. |
| Anima Ref Guider | Un GUIDER pour SamplerCustomAdvanced avec cfg texte, ref_guidance, correction APG ou rescale, et patches post-CFG comme PAG. |
Le cœur de ComfyUI fournit le reste : UNETLoader pour anima_baseV10.safetensors, CLIPLoader pour l'encodeur Qwen3-0.6B, VAELoader pour le VAE Qwen-Image. Le graphique de base tient en 19 nœuds sur un seul SamplerCustomAdvanced ; le second flux de travail ajoute Anima Safe PAG. Avec ref_guidance à 1, la référence siège dans les deux branches CFG et chaque étape coûte ce que coûte une étape CFG normale ; au-dessus de 1, chaque étape exécute le modèle trois fois, soit environ 1,5× une étape CFG normale. Les flux de travail d'exemple utilisent aussi Patch Sage Attention de ComfyUI-KJNodes, qui peut être contourné.
Limites
Le pilote a été entraîné sur 300 personnages pendant 2 000 étapes en rang 32, et l'auteur énumère ce que cela coûte : l'identité se transfère bien mieux que le style, les styles très picturaux se transfèrent à peine, les petits motifs, cicatrices, boucles d'oreilles et teints de peau inhabituels sont souvent perdus, les grands vêtements peuvent dériver en couleur, et le personnage de référence réapparaît parfois comme un objet dans la scène. Les paires d'entraînement sont toutes des rendus Anima, donc l'adaptateur hérite des biais du modèle de base, et l'évaluation reste qualitative pour l'instant, sans métriques de similarité d'identité ou de style.
Disponibilité
Les poids de l'adaptateur sont sur Hugging Face sous anima_ref_adapter_pilot_r32.safetensors (environ 92 Mo) et se placent dans ComfyUI/models/loras/. Le pack de nœuds s'installe avec git clone https://github.com/ElectronGirl/ComfyUI-Anima-Ref-Adapter.git dans ComfyUI/custom_nodes, et nécessite Anima base v1.0 avec son encodeur de texte Qwen3-0.6B et son VAE Qwen-Image. L'adaptateur a été entraîné sur le modèle de base, donc le LoRA Anima turbo peut toujours être chargé en amont du loader de l'adaptateur, avec ses étapes et son CFG habituels.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.