Contrôle couleur/profondeur MOSS-Image dans le cœur de ComfyUI
Un adaptateur communautaire pilote MOSS-Image avec une carte de régions de couleur unie et une carte de profondeur, et le cœur de ComfyUI l'a pris en charge le jour même.
MOSS-Image est le modèle texte-et-mise en page de 5B d'OpenMOSS, livré avec une implémentation dans le cœur de ComfyUI la même semaine. Ses moyens actuels de contrôler la composition sont une mise en page JSON de boîtes et un LoRA d'édition pour les modifications guidées par une référence. Aucun des deux ne répond à une question plus simple : placer cette personne ici, à cette échelle, debout devant ce bureau.
Le nouvel adaptateur y répond avec deux cartes plutôt qu'avec une image. La couleur encode la position de chaque région, la profondeur encode la distance de chaque surface, et la génération part toujours d'un bruit pur. Rien n'est copié depuis une image de référence, de sorte que l'arrière-plan provient du prompt plutôt que du rendu à partir duquel les cartes ont été tracées.
Deux cartes comme conditionnement
La fiche définit les entrées de manière restrictive, et c'est ce qui la rend utilisable :
- Carte de couleur : une image RGB à la taille de sortie où chaque objet ou région reçoit une couleur unie. Les couleurs sont des identifiants de région, pas des couleurs avec lesquelles peindre, et le noir signifie non spécifié.
- Carte de profondeur : en niveaux de gris à la taille de sortie, le proche étant en blanc.
- L'une ou l'autre carte peut être omise. L'adaptateur a été entraîné avec un dropout de contrôle de 35 % couleur seule, 35 % profondeur seule, 20 % les deux, 10 % aucune, de sorte que les exécutions avec une seule carte restent dans la distribution d'entraînement.
Chaque scène est créée à partir d'un éditeur de mannequins three.js, qui exporte ensemble un rendu ombré, une passe de couleur et une passe de profondeur :
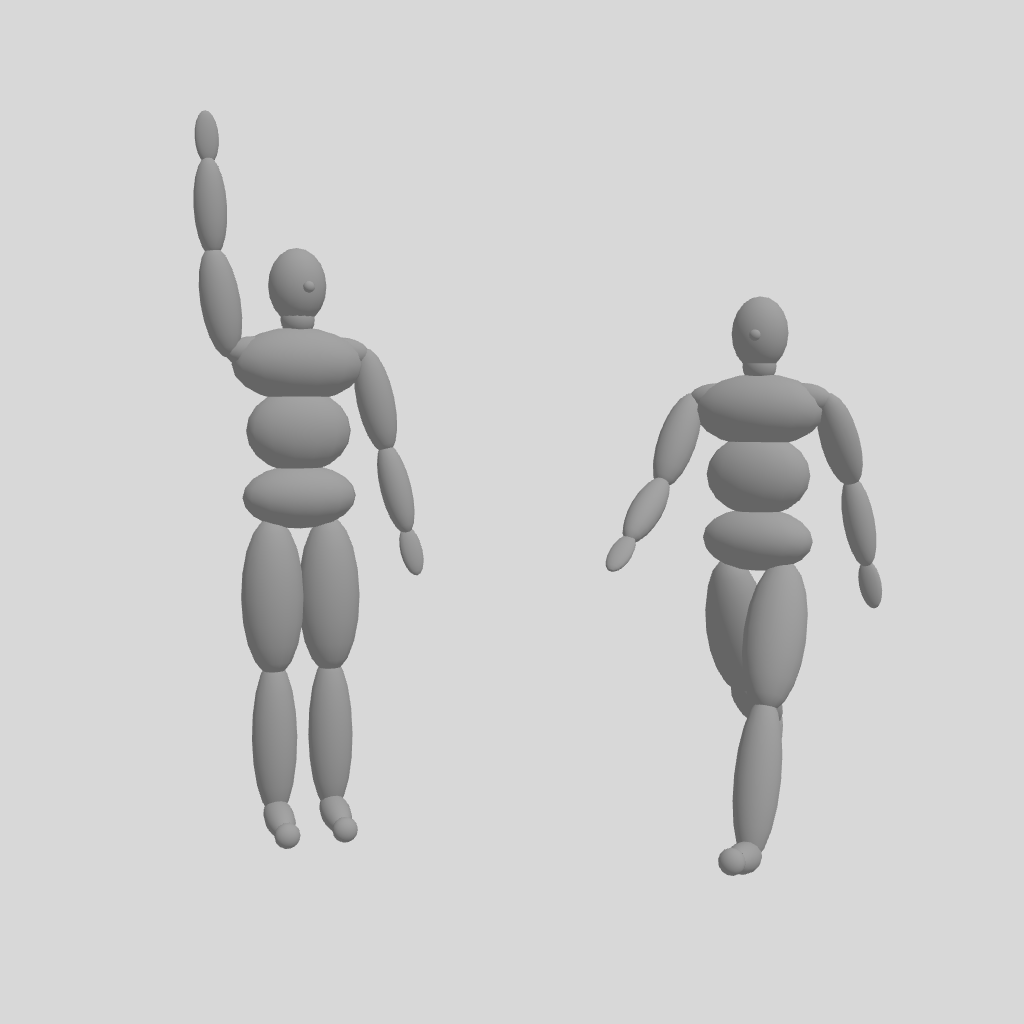 | 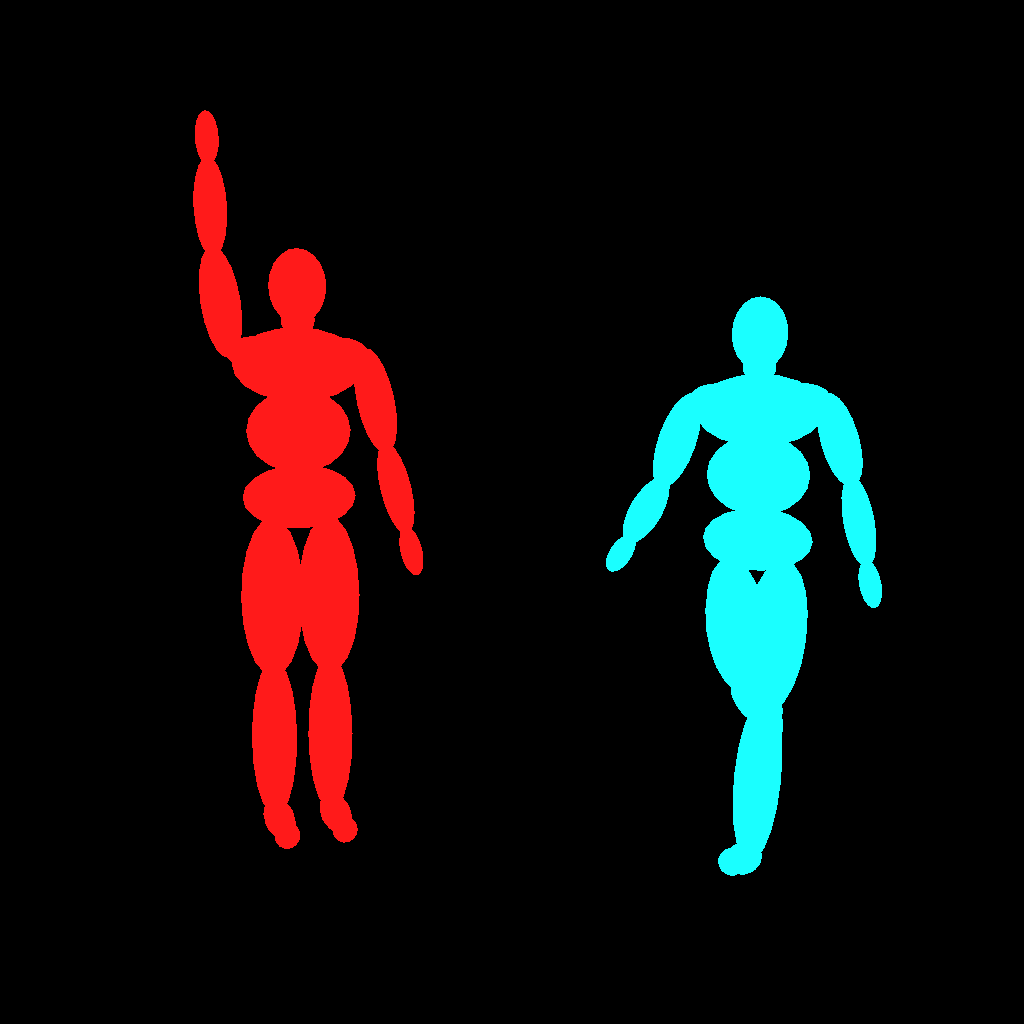 | 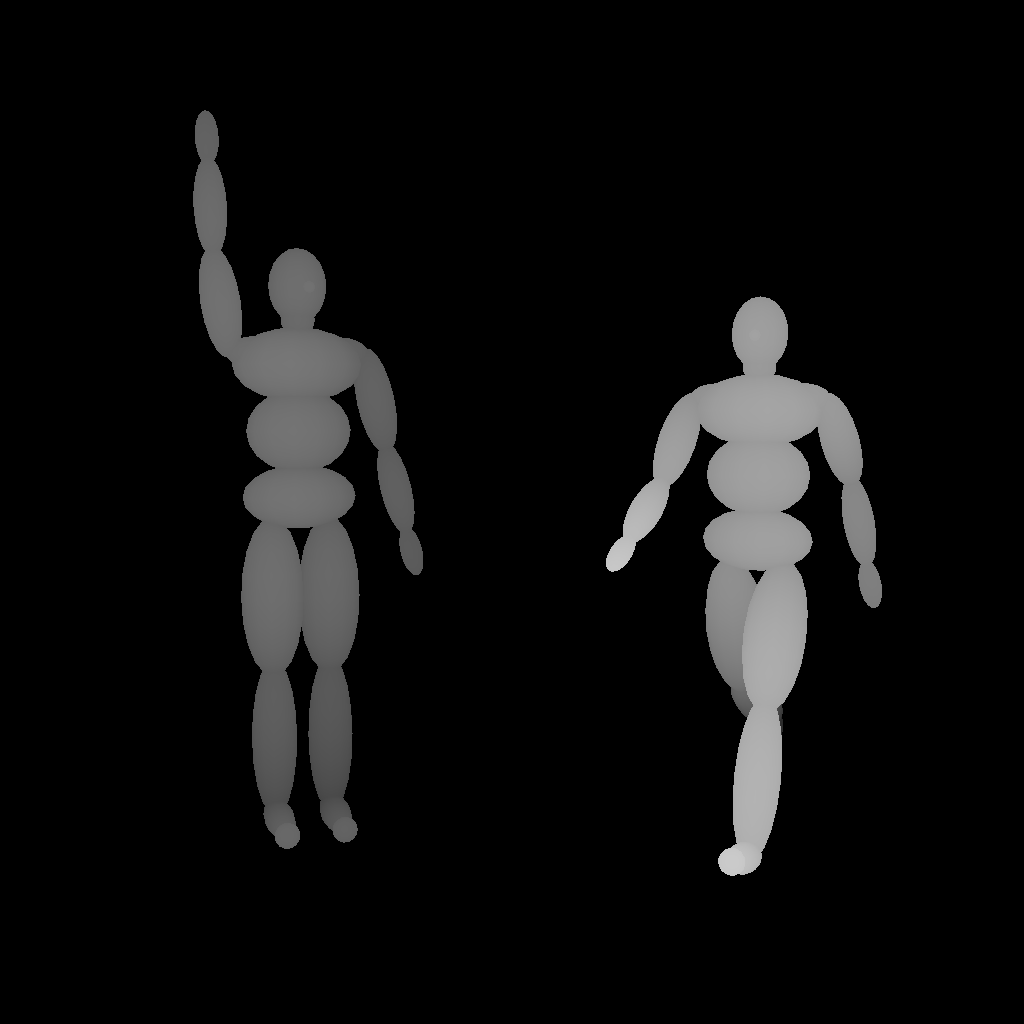 |
|---|---|---|
| Rendu source | Carte de régions de couleur | Carte de profondeur, le proche est en blanc |
La comparaison qui compte est celle avec l'image-to-image. Alimenter une passe img2img avec un rendu 3D conserve la mise en page, mais conserve aussi l'arrière-plan uni et les surfaces grises du rendu. Avec l'adaptateur, le placement, l'échelle et la pose suivent les cartes tandis que le matériau et l'éclairage sont générés, ce qui explique pourquoi les scènes publiées sont des mannequins 3D plutôt que des photographies.
À quoi ressemble la sortie
La figure principale de la fiche est une grille de la même scène de mannequin à deux personnes, avec le contrôle maintenu sur toute l'exécution ou désactivé en cours de route.
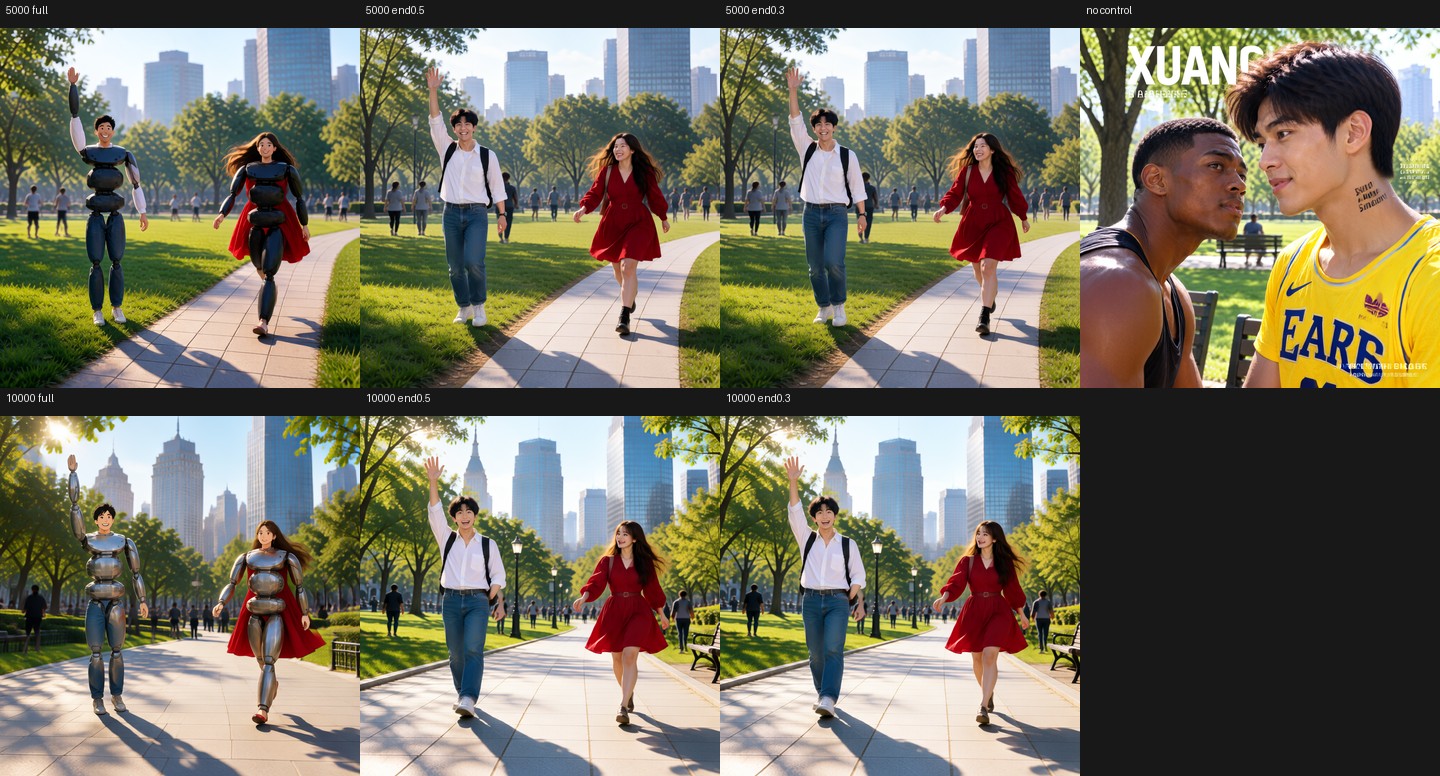
Publié avec l'adaptateur : rangée du haut à 5 000 étapes, rangée du bas à 10 000, comparant le contrôle maintenu jusqu'à la fin, l'arrêt à 0,5, l'arrêt à 0,3 et le modèle de base sans contrôle. Maintenu jusqu'à la fin, la surface du mannequin transparaît ; l'arrêt à 0,5 place de vraies personnes là où les cartes l'indiquent.
Cette grille est aussi l'énoncé honnête de la principale faiblesse de l'adaptateur. Le contrôle sur toute l'exécution reproduit le mannequin, car les cartes de profondeur d'entraînement provenaient de vraies photos et rien dans les cartes ne dit « arrête d'être en bois ». Arrêter le contrôle à la moitié des étapes conserve la mise en page et laisse les étapes restantes résoudre la peau, les vêtements et l'arrière-plan.
Le même adaptateur avec les cartes seules et sans prompts par région produit l'autre mode de défaillance documenté par la fiche : avec une carte de couleur de style manga, la mise en page des cases dérive et le texte se dégrade aux checkpoints plus avancés.
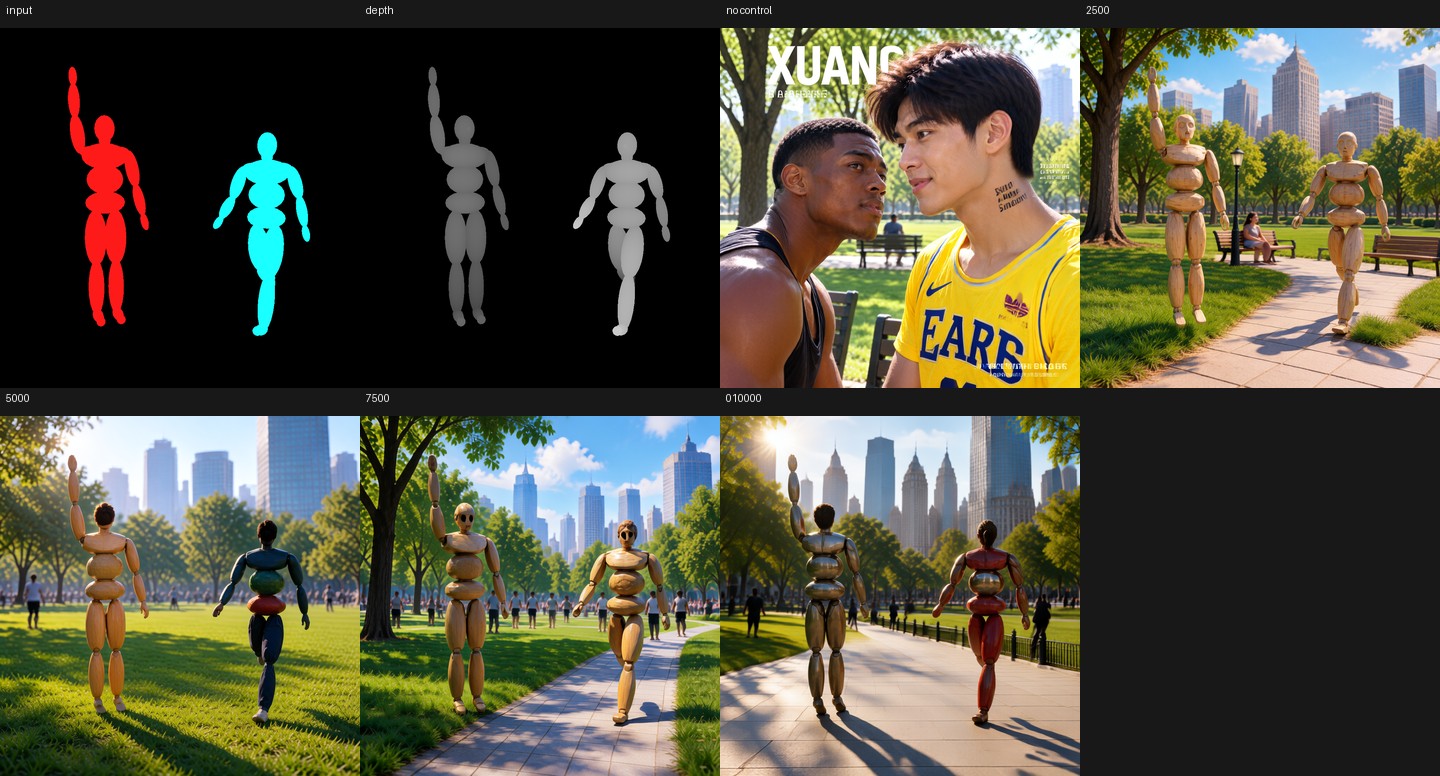
La scène à deux personnes utilisant les cartes sans prompts par région. Source : darask0/MOSS-Image-color-depth-control
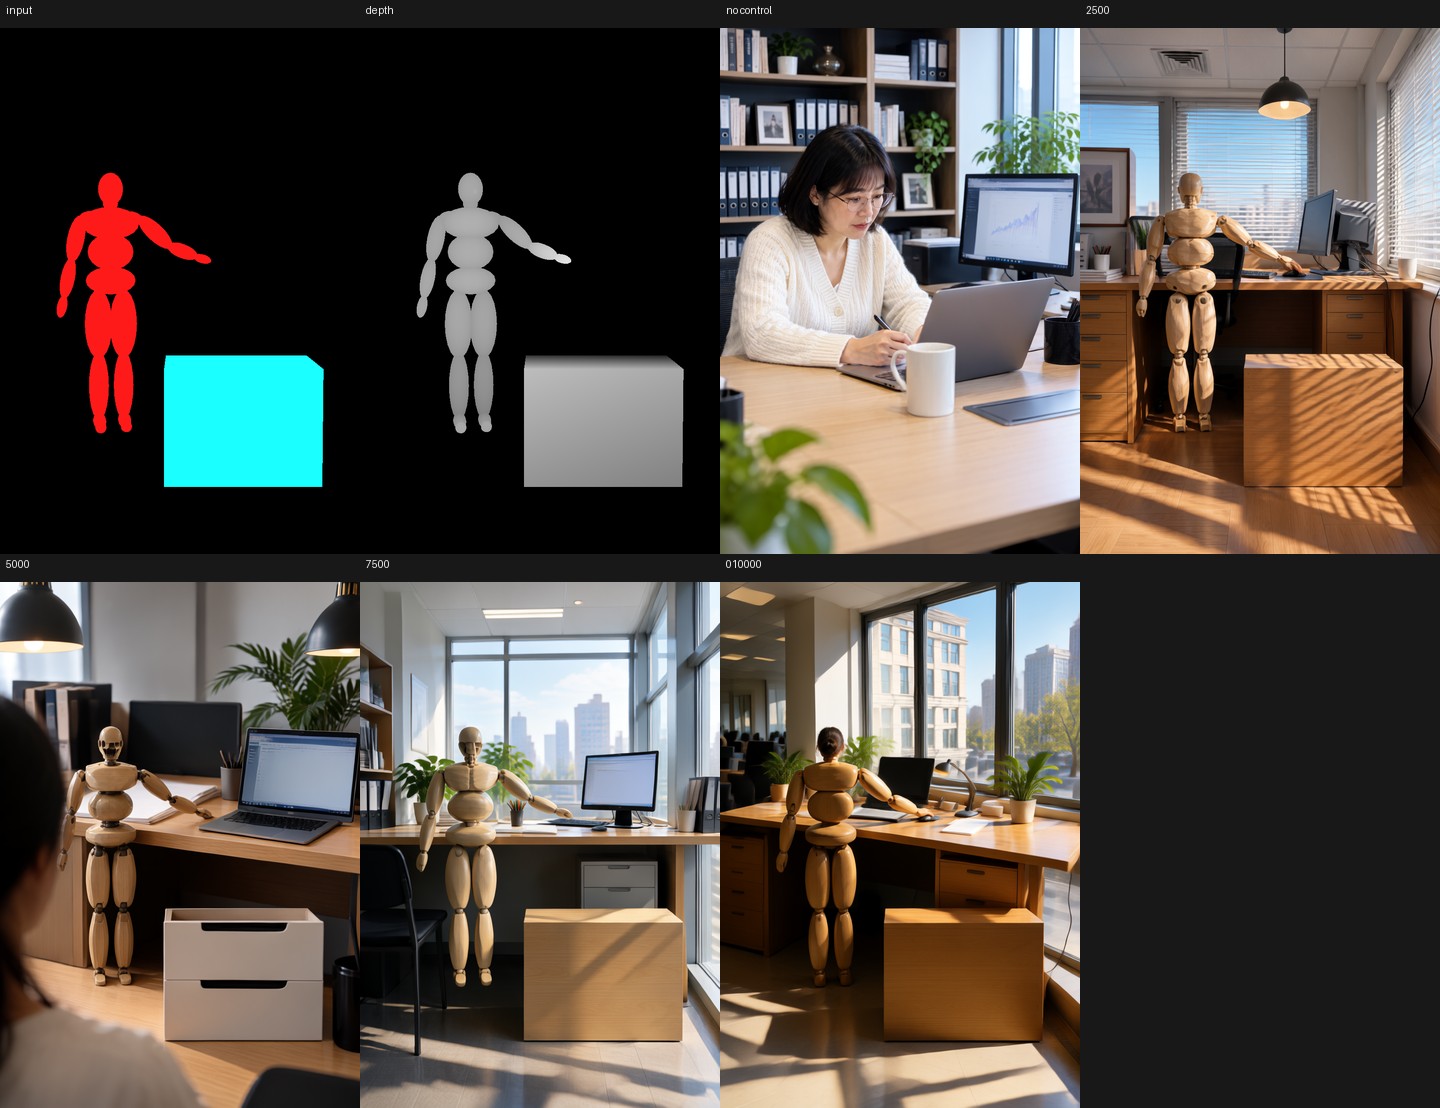
La deuxième scène publiée, une personne à un bureau, de nouveau avec les cartes seules.
Le chemin dans le cœur de ComfyUI
La PR #17206 de Kijai, fusionnée le 19 octobre à 22:15 UTC, ajoute un nœud : MOSS-Image Color/Depth Control (MOSSImageControl), expérimental, sous model/conditioning/moss_image. Il prend le conditionnement positif et négatif, le VAE, un color_map facultatif, un depth_map facultatif, ainsi que strength, start_percent et end_percent, et renvoie les deux flux de conditionnement.
Le graphe est celui ordinaire de MOSS-Image avec deux ajouts. L'adaptateur se charge via le chargeur LoRA standard sur le modèle de diffusion, et le nœud de contrôle se place entre l'encodage texte et l'échantillonneur. start_percent et end_percent sont l'équivalent dans le cœur des color_end et depth_end de la fiche, de sorte que les valeurs documentées de 0,5 pour les entrées synthétiques et de 1,0 pour les cartes tracées à partir de vraies images se traduisent directement en valeurs de nœud.
Le mécanisme mérite d'être connu, car il explique le format de fichier. L'adaptateur élargit l'entrée video_embedder du modèle de 128 à 384 canaux : le latent VAE FLUX.2 bruité dans le premier tiers, le latent de la carte de couleur dans le deuxième, le latent de la carte de profondeur dans le troisième. La PR a ajouté un concat_cond à la classe de modèle MOSS-Image qui suréchantillonne ce que le nœud transmet, l'ajoute au bruit et substitue un latent nul lorsqu'une carte est manquante, car une entrée nulle correspond exactement à « aucun contrôle » pour un embedder linéaire. Elle a aussi ajouté une conversion dans lora_convert.py qui transforme les clés video_embedder élargies en patchs de remplacement plutôt qu'en ajouts, puisque l'embedder est remplacé plutôt que légèrement ajusté.
Les prompts par région restent un chemin séparé, antérieur à cette PR : MOSS-Image Layout Prompt construit le JSON de mise en page à partir de boîtes créées par Create Bounding Boxes, avec la légende de chaque boîte comme prompt. La fiche de l'adaptateur recommande d'associer les cartes de contrôle à ces prompts par région, et les exemples publiés ont été échantillonnés de cette manière.
Le support a été fusionné après le tag v0.42.1, donc une installation publiée nécessite une build plus récente que ce tag.
Paramètres issus de la fiche
| Paramètre | Valeur | Raison |
|---|---|---|
| Checkpoint de l'adaptateur | moss-control.safetensors | 10 000 étapes, celui recommandé |
strength | 1,0 | force d'entraînement ; 0,0 équivaut à aucune carte |
end_percent (cartes de mannequin 3D) | 0,5 | le contrôle pilote la mise en page et la pose, puis se relâche |
end_percent (cartes issues de vraies photos) | 1,0 | garder le contrôle pendant toute l'exécution |
| Prompts par région | un par couleur | sans eux, une carte en forme de mannequin est dessinée comme un mannequin |
Les checkpoints antérieurs constituent des alternatives à la fraction de fin : 2 500 étapes suit la carte moins étroitement et ressemble moins au mannequin, 7 500 et 10 000 la suivent davantage. Tous les quatre sont dans le référentiel.
Pour la vitesse, l'adaptateur rapid-moss en 4 étapes du même auteur, issu de darask0/MOSS-Image_4-step_adapter_lora, que le site a couvert le 17 octobre, est l'association documentée : la fiche rapporte environ 1,8 s par image 1024² sur une RTX PRO 6000 avec celui-ci.
Comment il a été entraîné
L'inspection de l'en-tête safetensors donne 526 tenseurs : des paires LoRA de rang 64, alpha 64 sur q, k, v, o, ffn_up_gate et ffn_down des 42 couches DiT (252 paires), cinq projections par bloc sur deux blocs d'embedder texte (10 paires), et le poids et le biais video_embedder de remplacement.
L'entraînement a été effectué sur le transformer MOSS-Image Base, gelé en FP8, avec l'embedder élargi à 384 entrées et ses colonnes de contrôle initialisées à zéro. Les données sont 10 000 images Krea 2 Turbo en résolution de classe 1024 sur cinq ratios d'aspect, avec leurs légendes ; les cartes de couleur proviennent de Mask2Former Swin-L sur la segmentation panoptique COCO, les cartes de profondeur de Depth Anything V2 Large. L'optimisation est AdamW à 1e-4 avec un taux d'apprentissage 10x sur les colonnes de contrôle de l'embedder, un batch de 1, 10 000 étapes à 0,8 s par étape sur une RTX PRO 6000, la distribution de pas de temps logit-normale de MOSS, et 10 % de légendes vides. La configuration et le script d'entraînement sont fournis avec les poids.
Limites à connaître
La fiche est inhabituellement directe sur ce qui ne fonctionne pas :
- Aspect mannequin. Le contrôle sur toute l'exécution d'un rendu 3D reproduit la surface en bois ou en métal du rendu, car la profondeur d'entraînement provenait de photographies.
- La précision de la pose est plus grossière que la carte. Les doigts et les visages sont générés, pas projetés.
- Le contrôle seul ne suffit pas pour les mises en page. Sur une carte de couleur manga, il perd la structure des cases et brouille le texte à partir de 7 500 étapes.
- La combinaison est limitée dans le runtime Hayate de l'auteur. La fiche indique que l'adaptateur n'est pas combinable avec img2img ni l'inpainting dans celui-ci, l'un ou l'autre.
- Le prior de style est photographique. Les données d'entraînement étaient des sorties de Krea 2 Turbo.
- Aucun benchmark. Évalué sur une poignée de scènes et deux graines, selon la fiche.
L'adaptateur n'est pas non plus une version officielle d'OpenMOSS : les poids, le code d'entraînement et le runtime de référence viennent d'un seul auteur, tandis que le support dans le cœur est la partie examinée par les mainteneurs de ComfyUI.
Disponibilité
- Adaptateur : darask0/MOSS-Image-color-depth-control, quatre checkpoints, environ 30 likes une semaine après le téléversement.
- Cœur de ComfyUI : PR #17206, fusionnée le 19 octobre 2026, après la version v0.42.1.
- Association pour la vitesse : darask0/MOSS-Image_4-step_adapter_lora.
- Modèles de base : MOSS-Image-Base et MOSS-Image-SFT, avec des poids ComfyUI en fichier unique dans Comfy-Org/MOSS-Image.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.