MOSS-Image Edit HQ v5 débarque avec deux formats LoRA ComfyUI
Un LoRA communautaire d'édition pour MOSS-Image atteint la v5 : masked loss, budget de référence de 256 tokens et deux formats ComfyUI, plus des grilles d'éval et un Space de démo.
MOSS-Image est le modèle texte-et-layout 5B d'OpenMOSS, couvert lors de sa sortie, qui a acquis l'édition par instruction deux semaines plus tard grâce à un adaptateur communautaire de rang 64. Cet adaptateur était chinoll/Moss-Image-Edit, et la question qu'il laissait ouverte était de savoir quelle part du comportement d'édition provient de ce seul jeu d'entraînement. MOSS-Image-Edit-HQ y répond en reconstruisant la capacité à partir d'autres données et en se mesurant à l'original.
Ce que la v5 change réellement
Le référentiel est un journal de cinq bras d'entraînement, pas une seule version. Chaque bras a continué à partir du checkpoint précédent, et chacun est conservé sur disque avec ses échantillons, de sorte que les différences sont inspectables plutôt qu'affirmées.
| Bras | Données et changements | Résultat |
|---|---|---|
| v1 | warm-start plus depuis zéro, données multi-références, 1024px | a échoué à la porte d'éval, chinoll conservait mieux l'identité |
| v2 | lignes chirurgicales OmniEdit, lr 1e-5, 300 étapes | remplacé par la v3 |
| v3 | lignes chirurgicales ConceptEdit-12M filtrées à 6 000, 700 étapes | remplacé par la v4 |
| v4 | données de retrait, de visage et d'environnement, 4 644 lignes, masked loss avec inverted_mask_prior | remplacé par la v5 |
| v5 | 5 644 lignes avec légendes de scène complètes, masques pixel-diff, masked loss, budget de référence de 256 tokens, 1 200 étapes | checkpoint en cours |
Le changement de la v5 qui compte le plus est le budget de référence. Le MOSS-Image de base donne 144 tokens à l'image de référence ; ce bras le porte à 256, ce à quoi on attribue le gain en identité et en détail fin. Le reste de la v5 est un travail sur les données : des masques pixel-diff pour que les régions non éditées restent proches de la source, et des légendes de scène complètes assemblées à partir des métadonnées ConceptEdit afin que l'instruction décrive toute l'image plutôt que seulement l'édition.
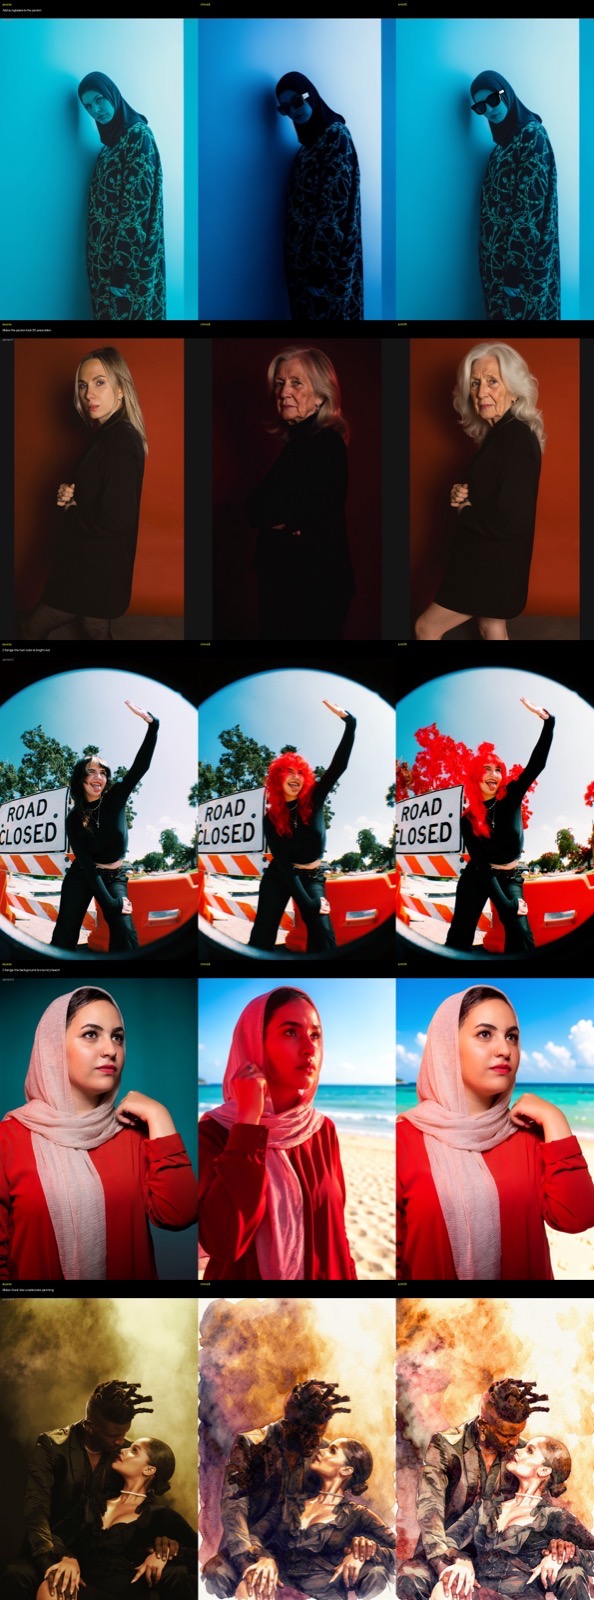
Chaque ligne part de l'image source et se poursuit avec la sortie v5. Source : akhaliq/MOSS-Image-Edit-HQ
Les checkpoints pèsent 495 Mo chacun au format peft, le final plus les étapes 250, 500, 750 et 1000. L'entraînement a tourné sur ai-toolkit au commit 14f8f95, un GPU par bras, avec l'encodeur de texte gelé et le gradient checkpointing requis en 1024px. Les données d'entraînement sont publiées aussi : 6 000 lignes ConceptEdit-12M filtrées sous forme de shards TAR, et les configs des bras se trouvent dans le référentiel.
Deux chemins ComfyUI, deux dispositions LoRA
La raison pour laquelle cette version demande un peu de lecture est que les mêmes poids sont livrés dans deux dispositions qui se chargent via des mécanismes ComfyUI différents.
La route native utilise weights/armV5/armV5.safetensors comme un LoRA ordinaire : placez-le dans models/loras/, ajoutez un loader LoRA après Charger Modèle Diffusion, et encodez avec le nœud expérimental Encodage de texte MOSS-Image Edit avec edit_format réglé sur ai-toolkit. Les références sont réduites à 384x384 maximum avant que l'encodeur de texte ne les voie.
La route plugin utilise armV5-moss-edit-lora.safetensors, qui va dans models/model_patches/ et se charge via Chenkin-x/ComfyUI-Moss-Image-Edit, le même pack de nœuds que celui utilisé par l'adaptateur antérieur. Ce pack requiert ComfyUI 0.42.3 ou plus récent.
Le chemin natif n'est disponible que dans une build master actuelle. PR #17296 de Kijai a été fusionnée le 22 octobre et a ajouté le nœud d'édition, mais la version taguée la plus récente, v0.42.5 du 23 octobre, livre encore l'ancien comfy_extras/nodes_moss_image.py sans lui, donc une installation publiée doit passer à une nightly pour utiliser edit_format = ai-toolkit. Les deux flux de travail sont livrés avec les noms de fichiers et les paramètres déjà remplis, pour une référence et pour jusqu'à quatre.
| Paramètre | Valeur |
|---|---|
| Sampler | Euler, flow matching |
| Shift | 5.0 |
| Étapes | 50 (qualité), 8 avec la pile de vitesse DMD |
| CFG | 3.0, monter à 3.5 ou 4.0 pour des éditions faibles |
| Couche SLG | 22 |
| Taille de référence | résolution source dans l'encodeur, 384x384 max |
| Sortie | jusqu'à 1024px |
La disposition ai-toolkit n'est pas la même que la disposition Moss-Image-Edit utilisée par l'adaptateur antérieur, et la fiche modèle est explicite à ce sujet : l'adaptateur de chinoll utilise des clés q, k et v séparées alors qu'ai-toolkit les fusionne, donc initialiser l'un à partir de l'autre nécessite une fusion bloc-diagonale de rang 192 exacte. Le référentiel fournit le convertisseur et rapporte 336 tenseurs sur 336 correspondants après conversion.
Où c'est plus rapide, et où ça ne l'est pas
Empiler le LoRA d'édition avec le LoRA de vitesse DMD en 8 étapes réduit l'échantillonnage à 8 étapes et CFG 1 pour des éditions environ six fois plus rapides. Le verdict de la fiche elle-même est que la passe en 50 étapes l'emporte encore : à 8 étapes, les ajouts d'objets s'affaiblissent et le confinement des couleurs se dégrade, donc le chemin rapide est réservé aux brouillons.
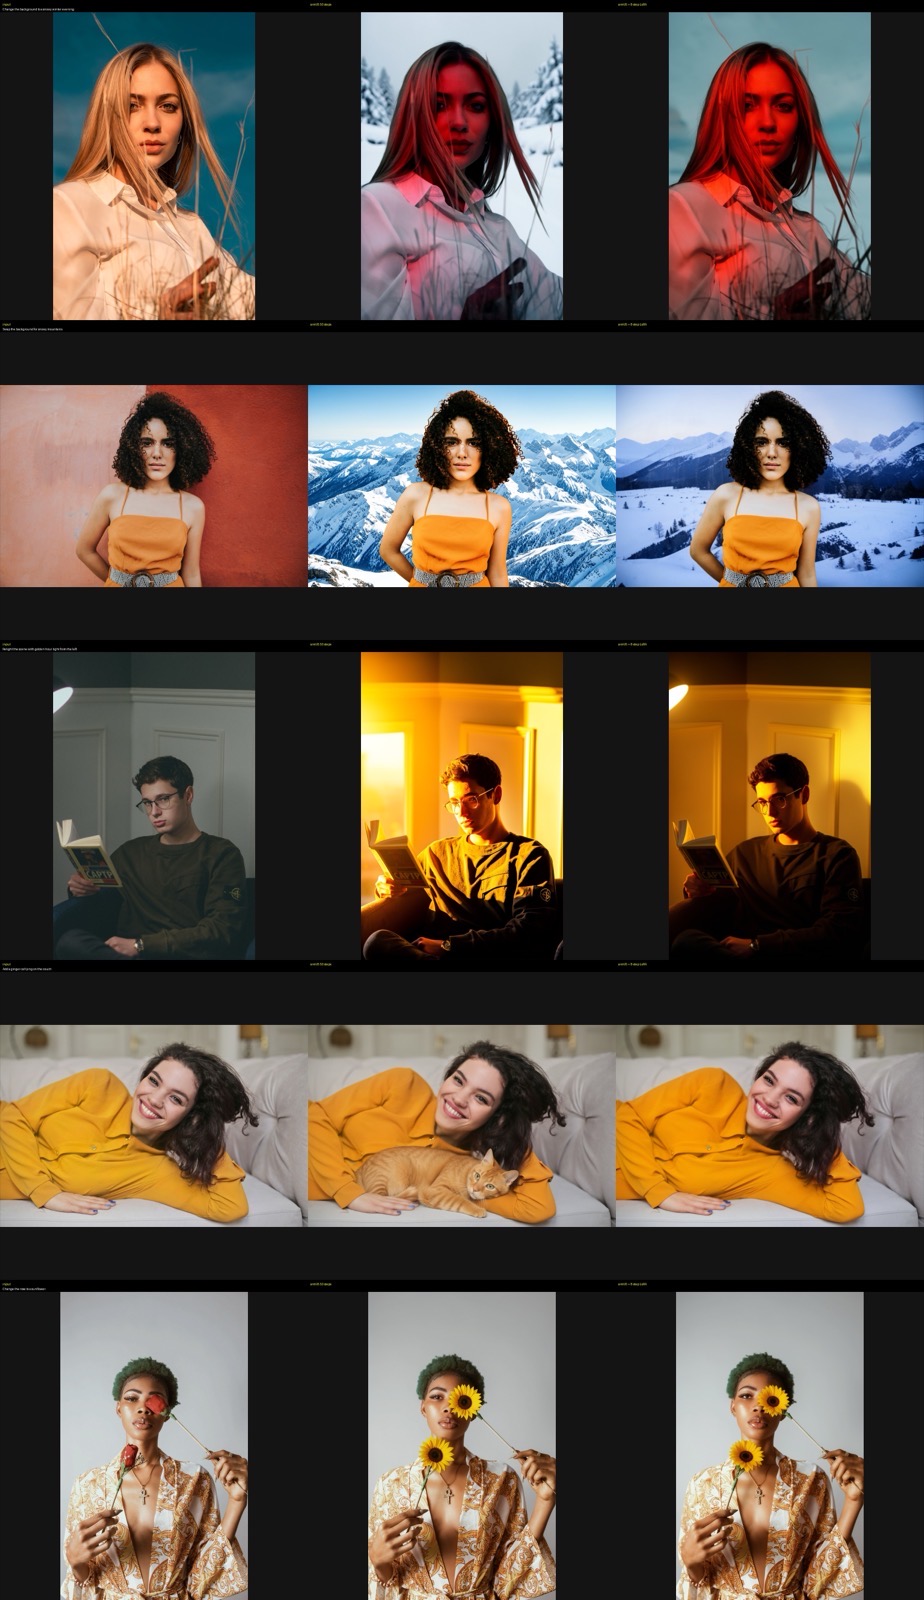
Entrée, puis 50 étapes, puis la pile DMD en 8 étapes. Source : akhaliq/MOSS-Image-Edit-HQ
La démonstration v5, une instruction par édition, rendue avec les paramètres de la démo : 50 étapes et CFG 3.
La même honnêteté s'applique aux comparaisons. La cible déclarée du projet est de battre chinoll/Moss-Image-Edit en qualité, et le bras v1 a ouvertement échoué à cette porte sur la préservation de l'identité avant que les bras suivants ne passent à la masked loss. Les grilles publiées comparent la v5 à l'adaptateur antérieur et à Krea 2, mais ce sont les propres jeux d'éval de l'auteur et un Space de démo, pas un benchmark tiers.
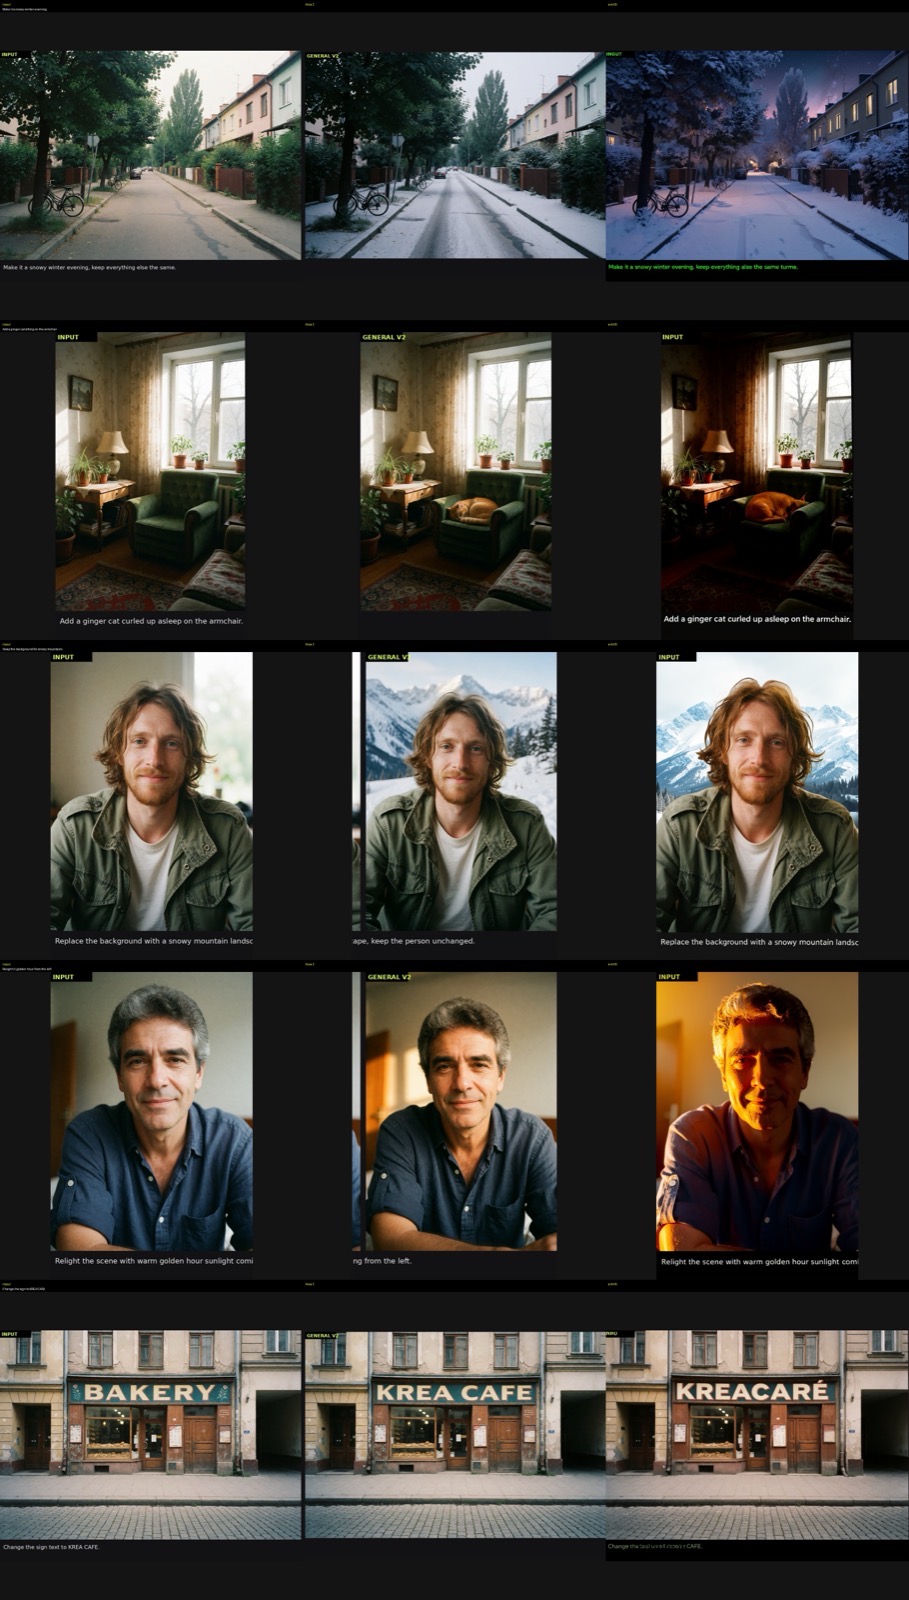
Éditions v5 de prompts de démonstration Krea 2 à côté des rendus de référence Krea 2. Source : akhaliq/MOSS-Image-Edit-HQ
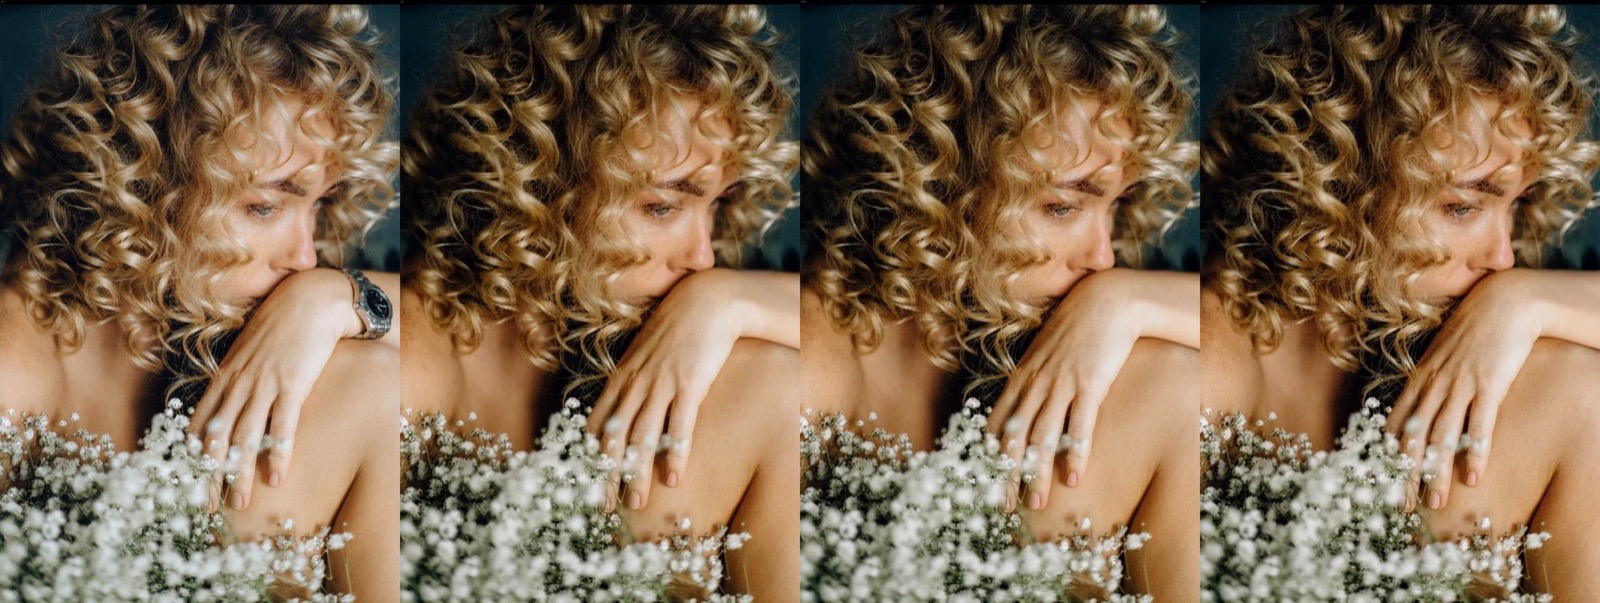
Cas de retrait d'objets issus du référentiel. Source : akhaliq/MOSS-Image-Edit-HQ
Pour la rapidité d'utilisation, la fiche renvoie aussi vers un Space de démo Gradio qui exécute à la fois le mode qualité et le mode 8 étapes, afin de vérifier le compromis avant de télécharger 495 Mo.
Limites à connaître
- VRAM : le pipeline nécessite environ 20 Go en bf16. La fiche répond directement à la question évidente : non, il ne tourne pas sur 6 Go, même avec des builds int8 communautaires du modèle de base.
- Modèle de base : il est entraîné sur MOSS-Image-SFT. La compatibilité avec Base et Kromoss est indiquée comme non vérifiée, et le chemin natif est décrit comme le plus fiable.
- Entraînement mono-référence : l'architecture accepte jusqu'à quatre références, mais l'adaptateur a été entraîné sur des paires d'édition à référence unique. La composition d'une personne ou d'un objet d'une photo dans une autre n'est explicitement pas ce pour quoi il a été entraîné.
- Couleur : un trait connu de la v3 consistant à pousser la saturation au-delà de la source a été signalé par un utilisateur sur la fiche modèle et ciblé par la masked loss de la v4.
- Portée : éditions d'attributs, de retrait, d'éclairage, de visage et de texte. La version ne dit rien sur les changements de pose, ce que demandait le premier commentaire de l'annonce.
Rien de tout cela n'est une version OpenMOSS. Les poids, les données, les grilles d'éval et la démo viennent tous d'un seul auteur, et la fiche le dit clairement.
Disponibilité
- LoRA : akhaliq/MOSS-Image-Edit-HQ, v5 publiée le 25 octobre 2026.
- Flux de travail :
armV5_workflow_single.jsonetarmV5_workflow_multi.json. - Démo : moss-image-edit-hq-demo sur Hugging Face Spaces.
- ComfyUI core : PR #17296, fusionnée le 22 octobre 2026, master et nightly uniquement.
- Pack de nœuds : Chenkin-x/ComfyUI-Moss-Image-Edit, avec ComfyUI 0.42.3 ou plus récent.
- Données d'entraînement et code : moss-image-edit-conceptedit-packed plus le répertoire
training/du référentiel.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.