Le LoRA MOSS-Image Edit ajoute l'édition par instruction à ComfyUI
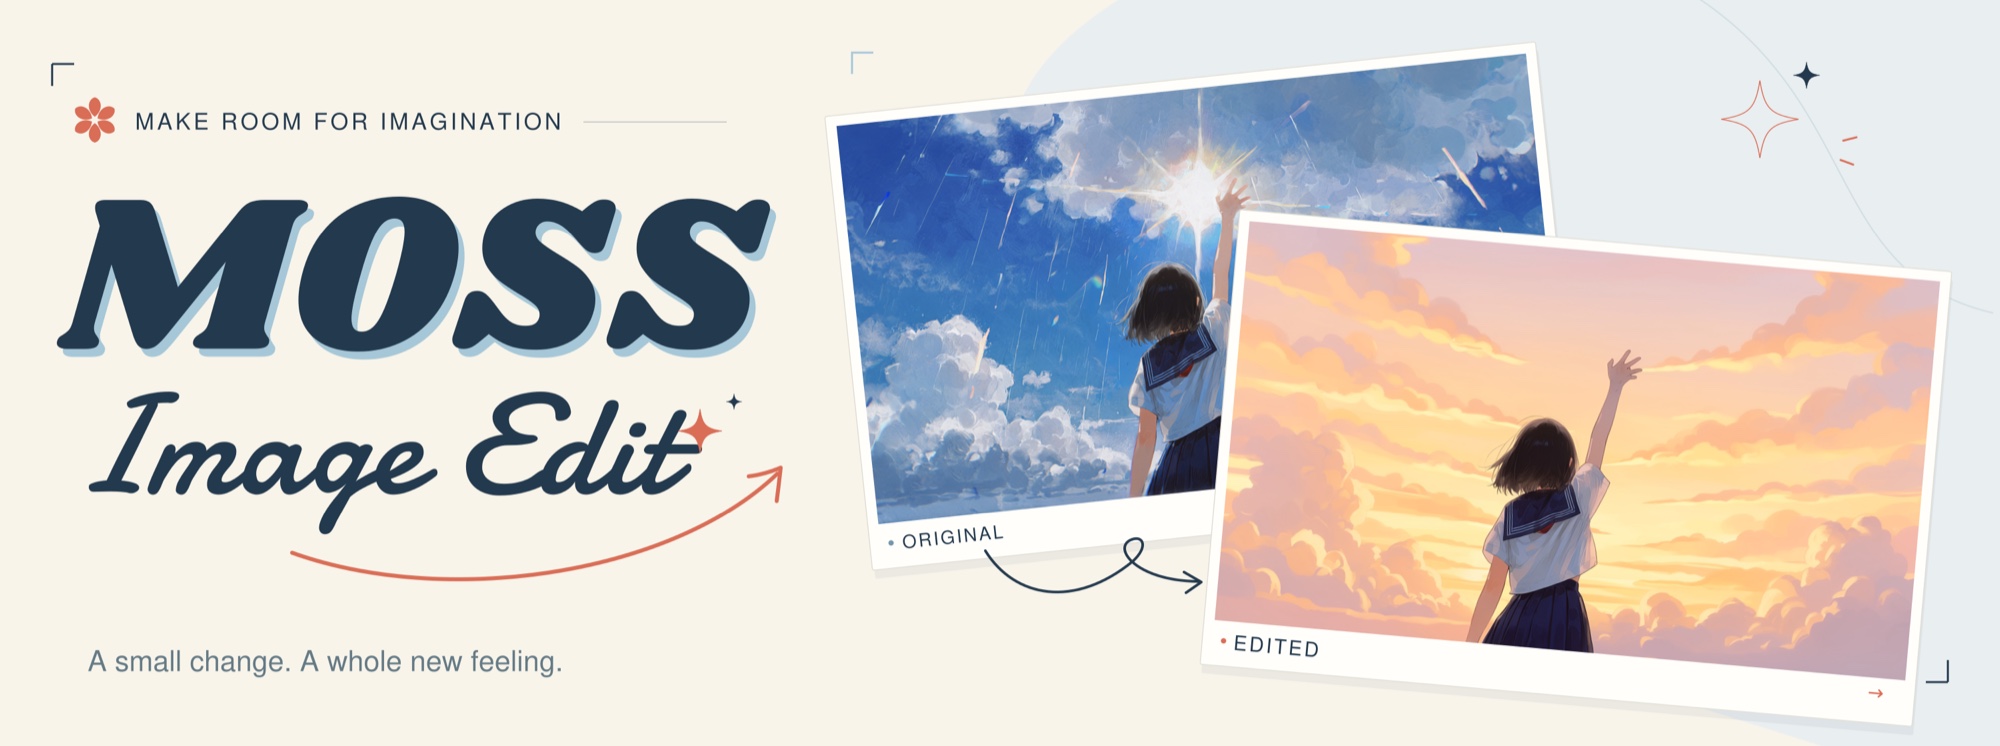
Un LoRA d'édition de rang 64 apporte à MOSS-Image l'édition par instruction avec une à quatre références, et ComfyUI a fusionné le support natif des LoRA d'édition le même jour.
MOSS-Image est le modèle texte et mise en page de 5B d'OpenMOSS que le site a couvert lors de sa sortie : texte lisible, boîtes de mise en page JSON et une implémentation dans le cœur de ComfyUI livrée la même semaine. Ce qui lui manquait, c'était un moyen de prendre une image existante et de la modifier. L'édition passait par des modifications de mise en page ou un adaptateur de contrôle, pas par « donner à cette personne une autre veste ».
Le nouvel adaptateur comble ce manque. Il s'agit d'une publication de la communauté, pas d'OpenMOSS, mais c'est l'implémentation autour de laquelle les mainteneurs de ComfyUI ont câblé le support natif.
Ce que le LoRA change
La fiche du modèle décrit le périmètre sans détour : couleur, tenues, éclairage, saisons et style visuel, pilotés par une instruction textuelle et jusqu'à quatre images de référence. L'instruction indique ce qu'il faut changer ; les références portent ce qui doit rester.
Grille de cas publiée avec le LoRA. Source : chinoll/Moss-Image-Edit
Avec plus d'une référence, chaque image doit être nommée dans l'instruction, car l'adaptateur lui-même n'attribue pas les rôles. Le prompt d'exemple du pack de nœuds est Dress the person in image 1 in the outfit from image 2.
Mécaniquement, l'adaptateur est petit et classique. L'inspection de l'en-tête safetensors donne 504 tenseurs sur les 42 calques du DiT, six projections par calque (q, k, v, o, ffn_up_gate, ffn_down), en rang 64 avec alpha 64. Son adapter_config.json déclare un format moss-edit-lora en version 1 et consigne son contrat d'entraînement sous ref-prefix-only-t0__target-text-original-moss-v1, qui est la disposition que ComfyUI implémente désormais sous le nom Moss-Image-Edit.
Les mêmes poids fonctionnent avec MOSS-Image-Base ou MOSS-Image-SFT ; Base préserve davantage du signal d'entraînement, SFT est le point de départ le plus propre. Les exemples de la fiche de référence ont été entraînés et échantillonnés sur SFT.
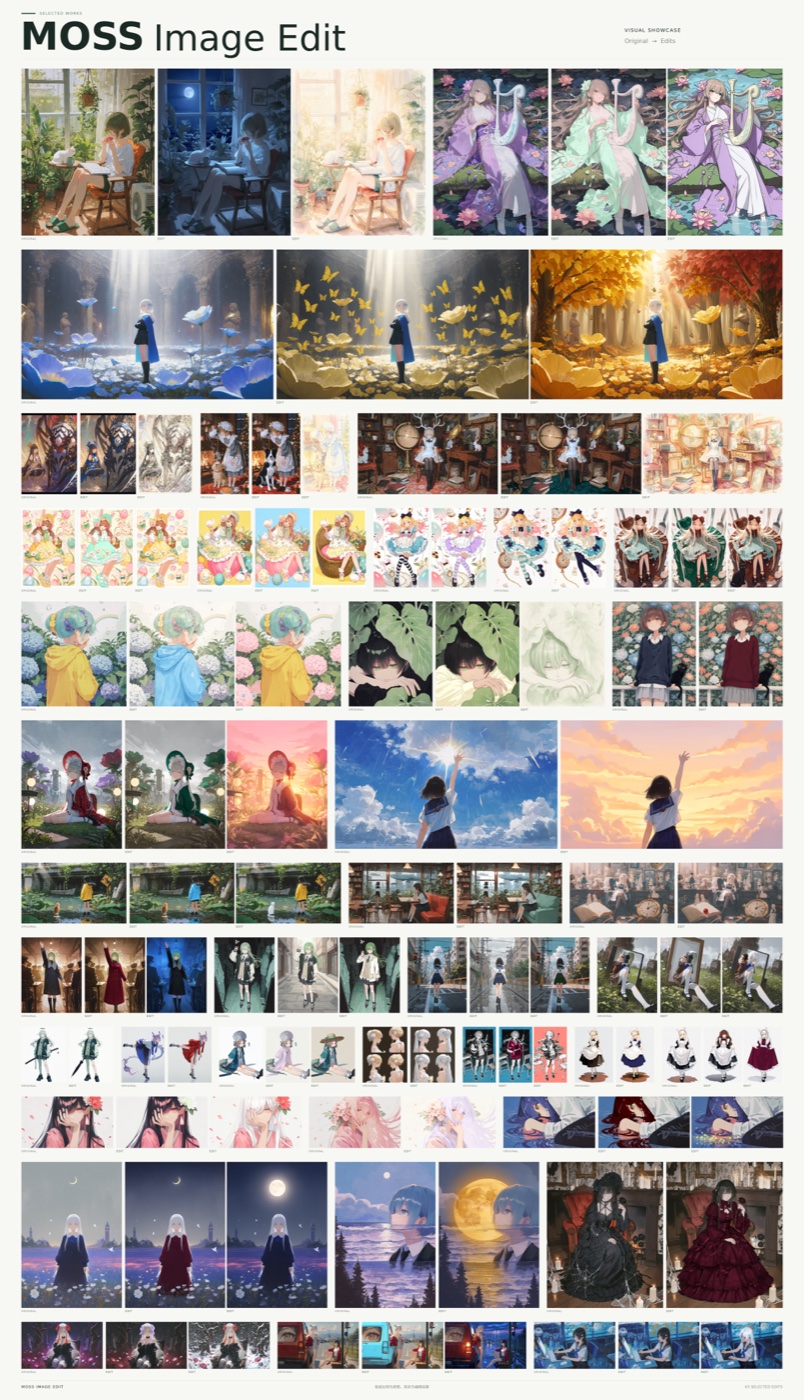
Galerie d'édition du référentiel du projet : chaque groupe commence par l'image source et se poursuit avec ses éditions.
La voie native de ComfyUI
La PR #17296 de Kijai ajoute un nœud Text Encode MOSS-Image Edit, toujours signalé comme expérimental, sous model/conditioning/moss_image. Il prend un clip, un prompt, un vae, un choix edit_format et un ensemble d'images qui s'agrandit automatiquement. Le sélecteur edit_format est la partie intéressante, car il encode le fait que les LoRA d'édition ne sont pas interchangeables :
| Option | Disposition des références | Le text encoder voit les références |
|---|---|---|
ai-toolkit | index_timestep_zero_isolated | Oui, préfixées par Picture N: |
ai-toolkit (kv_cache off) | index_timestep_zero | Oui, et les références s'attachent à l'image générée à chaque étape |
Moss-Image-Edit | index_timestep_zero_text_start | Non |
Pour la disposition Moss-Image-Edit, la tour de vision ne reçoit jamais les images de référence : l'instruction doit donc décrire l'édition à elle seule ; l'apparence provient entièrement des latents de référence injectés dans le DiT. Pour les adaptateurs entraînés avec ai-toolkit, les références sont réduites à 384×384 au maximum et ajoutées en tête du prompt sous forme de tokens Picture N:.
L'adaptateur se charge via le loader LoRA standard, car la PR a ajouté des alias pour le style de clés brut layers.N.proj.q qu'utilisent ces fichiers. La voie native consiste donc en le graphique MOSS-Image ordinaire avec les poids en fichier unique de Comfy-Org/MOSS-Image, plus un loader LoRA et le nouveau nœud d'encodage de texte ; les images de référence se connectent au nœud en tant qu'images, et non via une entrée latent séparée.
La PR signale aussi une correction de vitesse plutôt qu'une fonctionnalité : pour les dispositions isolées, les K/V par bloc des références sont calculés une seule fois dans extra_conds au lieu de l'être à chaque étape, ce qui fait passer une génération en 1024² avec une référence de 1 MP de 826 ms à 457 ms par étape. Le support a été fusionné après le tag v0.42.1, une installation publiée doit donc être mise à jour au-delà de ce tag pour en profiter.
La voie du pack de nœuds
Le même auteur livre un pack de nœuds autonome, Chenkin-x/ComfyUI-Moss-Image-Edit, apparu le 22 octobre et qui ajoute à la fois un loader et un nœud d'édition sous une catégorie MOSS Image Edit. Il exécute sa propre copie du runtime MOSS au lieu des nœuds natifs, et attend un snapshot Diffusers complet plutôt que le repack en fichier unique :
ComfyUI/models/moss_image/
├── MOSS-Image-SFT/          # pipeline_moss_image.py, transformer/, text_encoder/, tokenizer/, vae/, scheduler/
└── Moss-Image-Edit/         # adapter_config.json, adapter_model.safetensors
Le snapshot_dir du loader pointe vers le modèle de base et adapter_dir vers l'adaptateur. Deux flux de travail sont fournis, un pour une seule référence et un pour deux, et pour en atteindre trois ou quatre il faut ajouter des nœuds Load Image sur les entrées reference_3 et reference_4 restées libres. Les valeurs par défaut documentées sont une sortie en 512×512, 30 étapes, CFG 4.0, inference_shift 5.0, et un grand côté de référence de 512 sans recadrage.
| Réglage | Valeur par défaut | Remarque |
|---|---|---|
width / height | 512 / 512 | multiples de 16 |
reference_max_edge | 512 | aligné sur 16, jamais recadré |
steps | 30 | |
cfg | 4.0 | |
inference_shift | 5.0 | distribution temporelle d'échantillonnage |
seed | 42 | fixé par défaut |
Comment les références atteignent le DiT
Les deux voies reposent sur le même procédé. Les images de référence sont encodées par le VAE en tokens latents et ajoutées à la séquence d'images à leur propre index RoPE, au timestep zéro, en ne s'attachant qu'entre elles. Comme ces tokens ne changent jamais au fil de la boucle d'échantillonnage, leurs K/V par bloc peuvent être mis en cache une fois et réutilisés, ce qui permet à un adaptateur de rang 64 sans entraînement du text encoder de maintenir une identité pendant que l'instruction réécrit le reste.
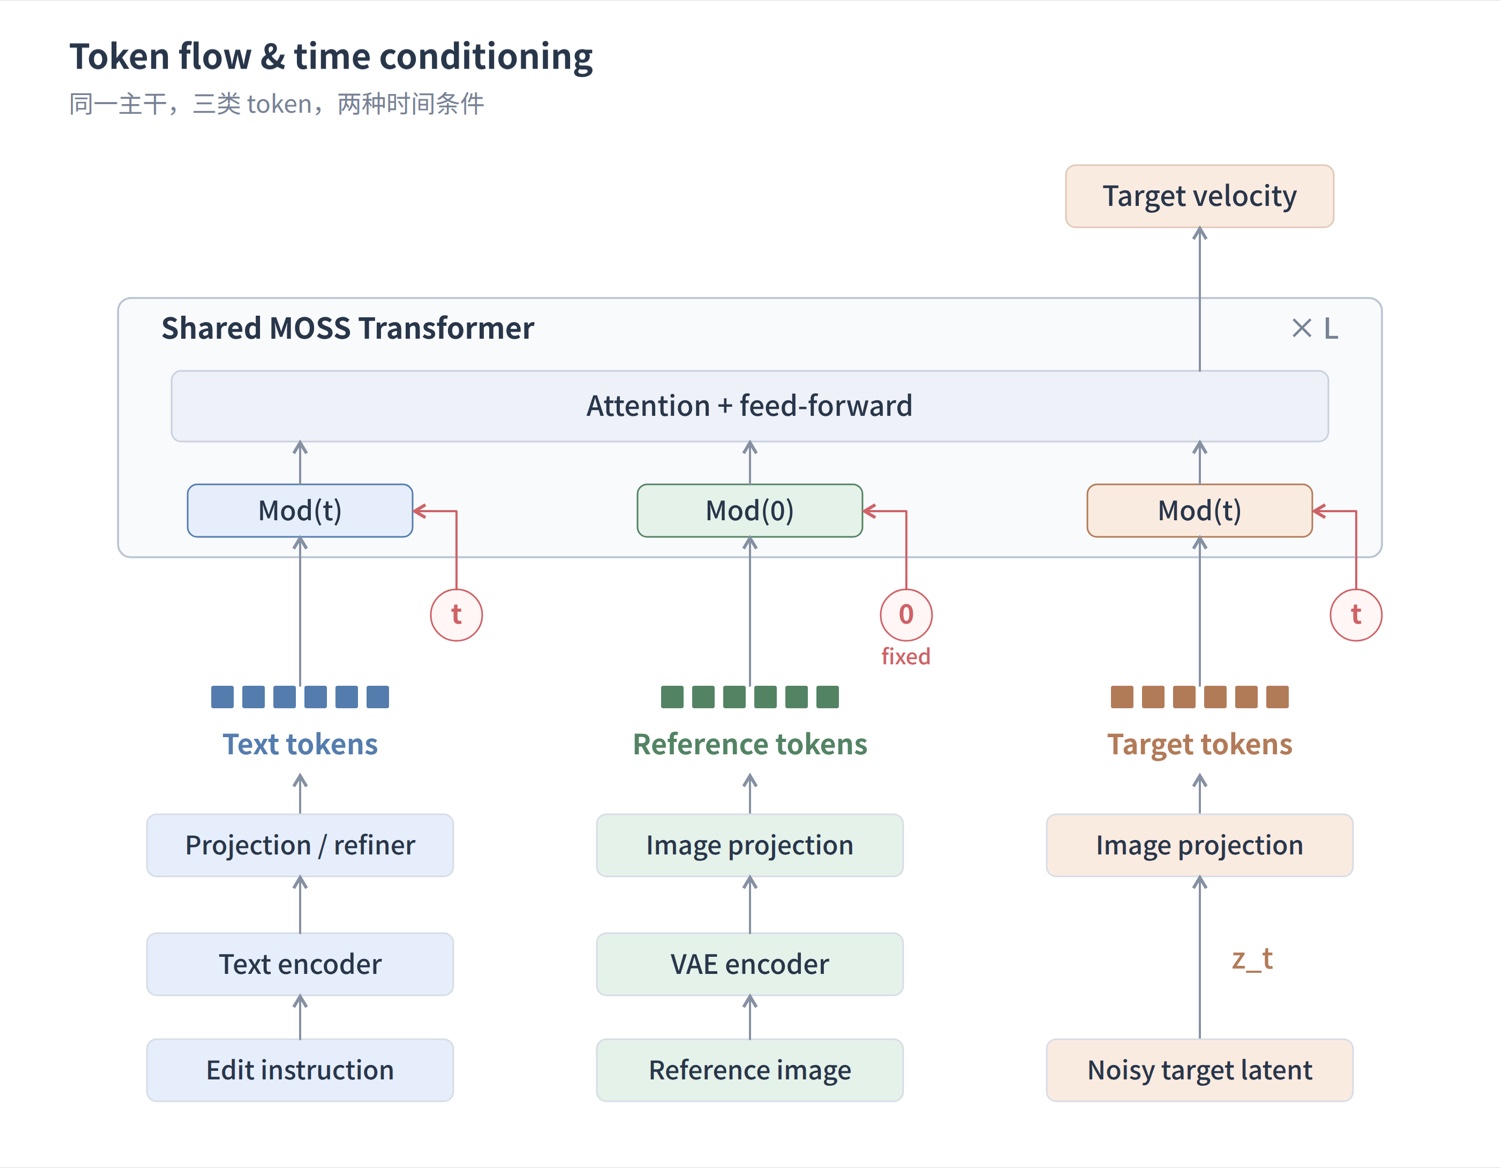
Schéma du cache KV de référence issu du référentiel d'entraînement, montrant les blocs de référence mis en cache à côté des tokens générés.
Le référentiel d'entraînement publie toute la recette, et pas seulement les poids : préparation des données, configurations et script d'inférence. Les données d'entraînement sont des paires NOOB2 plus l'ensemble ConceptEdit-12M, avec des instructions issues de instruction.detailed_en, les images source et éditées encodées ensemble par le VAE, et les deux images redimensionnées pour que le grand côté reste sous max_edge sans recadrage ni remplissage. Le guide lance un torchrun à quatre processus, DeepSpeed Muon sur ZeRO-2 via une fonction adjust_lr_fn modifiée, Flash Attention 4 avec varlen packing, et le text encoder quantifié en int8 pendant l'entraînement. Les échantillons de validation sont écrits à chaque étape aux côtés des triplets généré/source/cible, de sorte que les checkpoints du référentiel peuvent être reproduits ou étendus.
Limites à connaître
Le LoRA est un adaptateur bf16 de 297 Mo, petit face au modèle de base, mais ce n'est pas un éditeur à usage général. Le périmètre publié couvre les éditions d'attributs et de scène : couleur, tenue, éclairage, saison et style, ainsi que les expressions. La fiche ne documente aucune insertion d'objet, ne publie aucun benchmark et ne revendique rien sur la composition de deux sujets dans une même scène. Les éditions multi-références dépendent de l'attribution des rôles par le prompt, comme indiqué plus haut. Ce n'est pas non plus une publication officielle d'OpenMOSS : les poids, le pack de nœuds et le code d'entraînement viennent tous d'un seul auteur, et la PR native est la seule partie relue par les mainteneurs de ComfyUI.
Disponibilité
- LoRA : chinoll/Moss-Image-Edit, environ 21 likes au moment de la rédaction, un jour après le téléversement.
- Cœur de ComfyUI : PR #17296, fusionnée le 22 octobre 2026, après la version v0.42.1.
- Pack de nœuds : Chenkin-x/ComfyUI-Moss-Image-Edit avec des flux de travail mono et multi-référence.
- Code d'entraînement et d'inférence : Chenkin-x/Moss-Image-Edit, incluant
prepare_data.py,configs/train.jsonetinfer.py. - Modèles de base : MOSS-Image-Base et MOSS-Image-SFT, avec les poids ComfyUI en fichier unique dans Comfy-Org/MOSS-Image.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.