KohakuMoss : entraînement LoRA MOSS-Image avec exportation ComfyUI
KohakuMoss 0.1.0 entraîne des LoRA, des LyCORIS ou des finetunes complets sur MOSS-Image-Base et SFT, tourne sur des cartes de 6 Go et exporte des adaptateurs aux clés ComfyUI.
KohakuMoss est un framework de finetuning pour MOSS-Image-Base et MOSS-Image-SFT, publié en version 0.1.0 sur PyPI le 18 octobre 2026. Il est développé par KohakuBlueleaf, l'auteur de LyCORIS, et il comble la partie de la chaîne d'outils MOSS-Image que la sortie du modèle et les adaptateurs few-step de la communauté n'avaient pas couverte : l'entraînement sur vos propres images à la résolution native, puis l'exportation de quelque chose que ComfyUI peut charger sans étape de conversion.
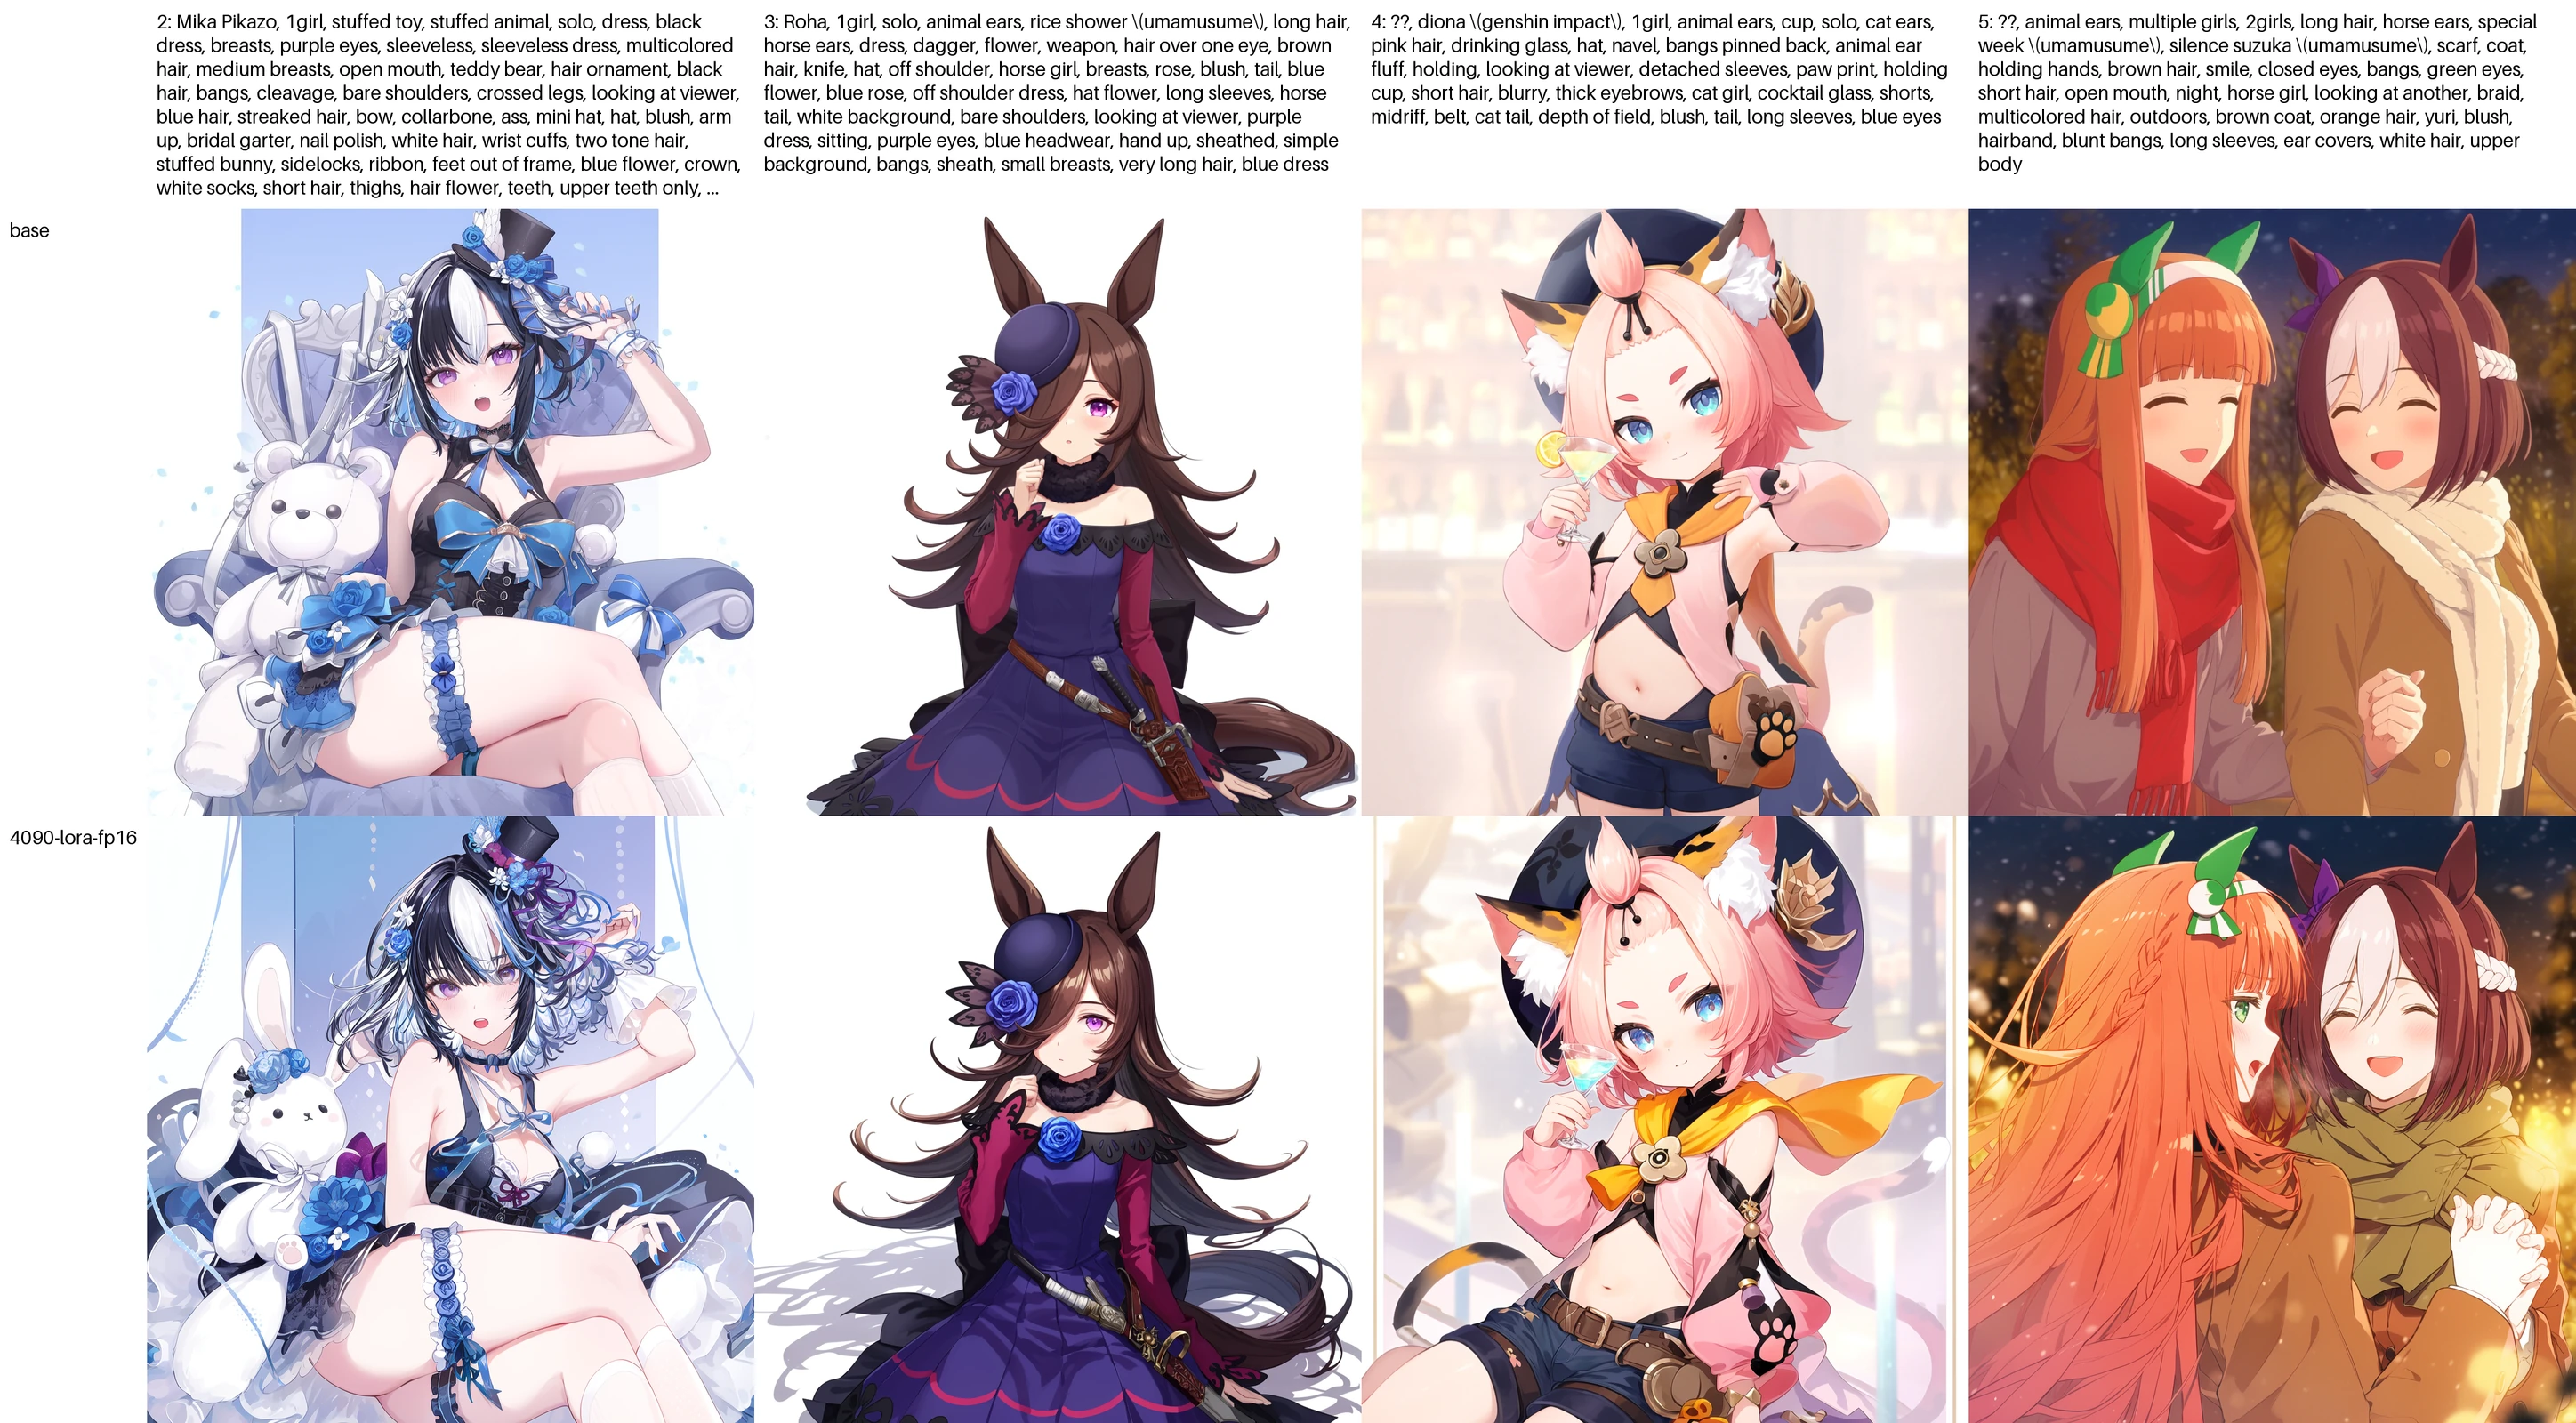
Le manque qu'il comble
MOSS-Image est arrivé le 16 octobre avec deux checkpoints, le contrôle de la mise en page et une prise en charge de ComfyUI dès le jour même, et les LoRA 4-step et 8-step de la communauté ont suivi en une journée. Ce qu'aucun des deux n'a livré, c'est un entraîneur dédié à ce transformer de diffusion 5B et à son encodeur de texte Qwen3.5-9B. Les entraîneurs de diffusion génériques supposent un UNet ou une pile de forme Flux ; MOSS-Image a besoin de sa propre attention packée et de ses propres noms de clés. KohakuMoss fournit les deux : une implémentation indépendante de MOSS-Image, l'ensemble d'adaptateurs LyCORIS, un pipeline de données et les plans de mémoire nécessaires pour les exécuter sur une seule carte.
Adaptateurs et finetune complet
L'entraînement d'adaptateurs couvre LoRA et LoCon, LoHa, LoKr, DoRA, OFT, BOFT, GLoRA, IA3, DyLoRA et T-LoRA, tous via LyCORIS, si bien que ses algorithmes, son format de sauvegarde et ses kernels fusionnés sont repris tels quels. Le dropout, LoRA+, les forwards contournés ou fusionnés et les préréglages de ciblage sont des paramètres plutôt que des scripts séparés.
Le finetune complet est également pris en charge, avec Muon accompagné d'AdamW et d'EMA, d'après le rapport technique de MOSS. Il tient sur une seule carte de 24 Go avec les poids maîtres en mémoire hôte : le compromis se fait donc sur la RAM système plutôt que sur un second GPU.
Fonctionner sur 6 Go
La mémoire est gérée comme un ensemble de calques plutôt que par un simple basculement : checkpointing par blocs, streaming des poids, offload des activations, offload des gradients et états de l'optimiseur sur l'hôte. Quatre profils nommés vont de speed à minimal, kohakumoss-config en choisit un d'après la carte qu'il détecte, et un catalogue de 240 entrées se trouve en dessous pour le réglage manuel. L'entraînement d'adaptateurs atteint les cartes de 8 Go, et la couche 6 Go tient lorsque les caches latents et de texte sont construits hors ligne. Une carte de 24 Go couvre encore le cas du finetune complet.
La précision suit le matériel : bf16 lorsqu'il existe, fp16 sur les cartes plus anciennes avec un correctif de résidu, calcul fp8 et MXFP8 sur sm89 et plus récent à la fois pour le DiT et pour l'encodeur de texte, en entraînement comme en inférence, et quantification de poids uniquement en int8 ou fp8 pour une base gelée.
Des kernels par architecture
Le projet livre ses propres kernels au lieu de dépendre d'une seule pile : TileLang pour sm70 et sm75, Triton pour sm80 et plus récent ainsi que pour Intel Arc, avec torch.compile et le mode eager derrière les deux. L'attention varlen, les opérations par blocs et les couches linéaires fusionnées choisissent chacune un backend selon l'architecture, le dtype et la forme, mesuré une fois sur la carte et stocké dans une table de réglage, de sorte qu'une même installation est réglée différemment sur une V100 et sur une RTX 5090.
L'implémentation du modèle exécute des lots packés de longueur variable : un axe de tokens unique et à plat, l'attention restant confinée à chaque échantillon. Face au code officiel, le projet signale une erreur relative de 4,7e-6 en passe avant fp32 et un LPIPS d'échantillonnage sur 50 étapes de 2,3e-6.
Données et reprise
Les formats d'entrée incluent les dossiers de style kohya, jsonl, parquet, webdataset et les shards natifs, avec un catalogue incrémental mis en cache après le premier scan. Les planificateurs de redimensionnement, de buckets et de recadrage gèrent les images en résolution native, le batching par tokens garde des étapes régulières, et les caches latents et de texte peuvent être construits hors ligne ou remplis pendant l'entraînement. Le plan d'échantillonnage est une fonction pure des données, de la graine et des paramètres, si bien qu'une exécution reprise rejoue le même ordre au lieu de l'approximer.
Le multi-GPU est réservé à Linux : DDP sous chaque profil de mémoire, y compris le streaming des poids, FSDP2, pipeline et un pipeline threadé.
Exporter vers ComfyUI
C'est l'étape d'exportation qui fait de cet outil plus qu'un entraîneur de plus. Une exécution peut produire un fichier LyCORIS, un modèle fusionné, un transformer diffusers ou un adaptateur au format ComfyUI écrit selon la disposition de clés MOSS-Image propre à ComfyUI, y compris le repack pour sa projection q/k/v fusionnée. Ce fichier va dans models/loras et se charge dans un flux de travail ComfyUI normal, si bien qu'un LoRA entraîné ici n'a besoin ni d'un nœud tiers ni d'un notebook de conversion. L'exportation fonctionne aussi sur n'importe quel checkpoint sauvegardé, pas seulement sur l'étape finale.
Vitesse mesurée
Les tableaux de la version indiquent un entraînement à 1 MP sur MOSS-Image-Base avec un LoRA de rang 32 dans le profil balanced. Sur une RTX 5090, l'exécution atteint 1,01 échantillon par seconde sans cache et 1,14 avec les caches latents et de texte ; une RTX 4090 passe de 0,49 à 0,73 et une RTX 3090 de 0,31 à 0,39. Les pics par étape se situent près de 6,6 GiB de mémoire allouée par torch dans la plupart de ces lignes, et les chiffres de la 5090 incluent un encodeur de texte résident de 15,6 GiB, ce qui explique pourquoi sa valeur sans cache est la plus rapide.
L'exemple du README est plus proche d'un véritable premier projet : un LoRA de style rang 8 en fp16 sur une base fp8, 100 étapes à environ 20k tokens par étape, avec le profil agressif ckpt-ring4-actoff et l'encodage par l'encodeur de texte et le VAE en ligne à chaque étape. Sur une seule RTX 4090, il tient entre 12 et 13 Go et produit environ 0,85 image par seconde.
Configuration
Chaque script est un script KohakuEngine : les paramètres sont donc des réglages au niveau du module et une configuration peut empiler des préréglages les uns sur les autres. kohakumoss-config écrit une configuration vérifiée pour le GPU détecté et le jeu de données, kohakumoss-config wizard demande le GPU, l'algorithme, les données et les poids au lieu de prendre des flags, et des recettes fixes comme lora_24g_bf16 peuvent être étendues avec chaque réglage listé.
Disponibilité et licence
Le code de KohakuMoss se trouve sur github.com/KohakuBlueleaf/KohakuMossTrainer et s'installe depuis PyPI sous le nom kohakumoss. Les assistants d'installation détectent le pilote, choisissent l'index torch correspondant puis lancent kohakumoss-doctor, qui signale tout ce qui manque avec la commande qui le corrige. Python 3.10 ou plus récent est requis, avec CUDA 12.6 ou plus récent ou un pilote Intel Arc ; Windows nécessite les Visual Studio Build Tools, et les cartes sm70 et sm75 ont besoin du toolkit CUDA pour nvcc.
La licence est la KohakuMoss License 1.0 : Apache 2.0 plus une clause, à savoir qu'un travail dérivé, paquet, produit ou service construit sur KohakuMoss doit inclure « Kohaku » dans son nom. Les modèles, adaptateurs et images entraînés ou générés avec le framework sont explicitement exclus de cette clause, si bien qu'un LoRA ou un checkpoint produit avec lui peut être nommé et licencié comme son auteur le souhaite.
Pour les checkpoints eux-mêmes, voir la couverture de la sortie de MOSS-Image et les adaptateurs 4-step et 8-step qui ont rendu l'échantillonnage rapide pratique.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.