Le LoRA SFT Destripe de MOSS-Image supprime les rayures dans ComfyUI
Un LoRA de 1,9 Mo supprime les fines rayures verticales colorées que MOSS-Image SFT dessine dans les ciels et fonds unis, et se charge via le LoRA loader standard de ComfyUI.
MOSS-Image SFT dessine un motif régulier de fines rayures verticales colorées sur les zones lisses : ciels, brume, murs unis, fonds de studio. Le 18 octobre, nynxz a publié un LoRA de 1,9 Mo, SFT Destripe, qui les supprime tout en laissant presque tout le reste du modèle SFT intact. Il s'agit d'un correctif de poids, pas d'un réentraînement : aucun nœud personnalisé, aucun nouveau checkpoint, un seul LoraLoaderModelOnly après le modèle que le site a couvert lors de sa sortie.
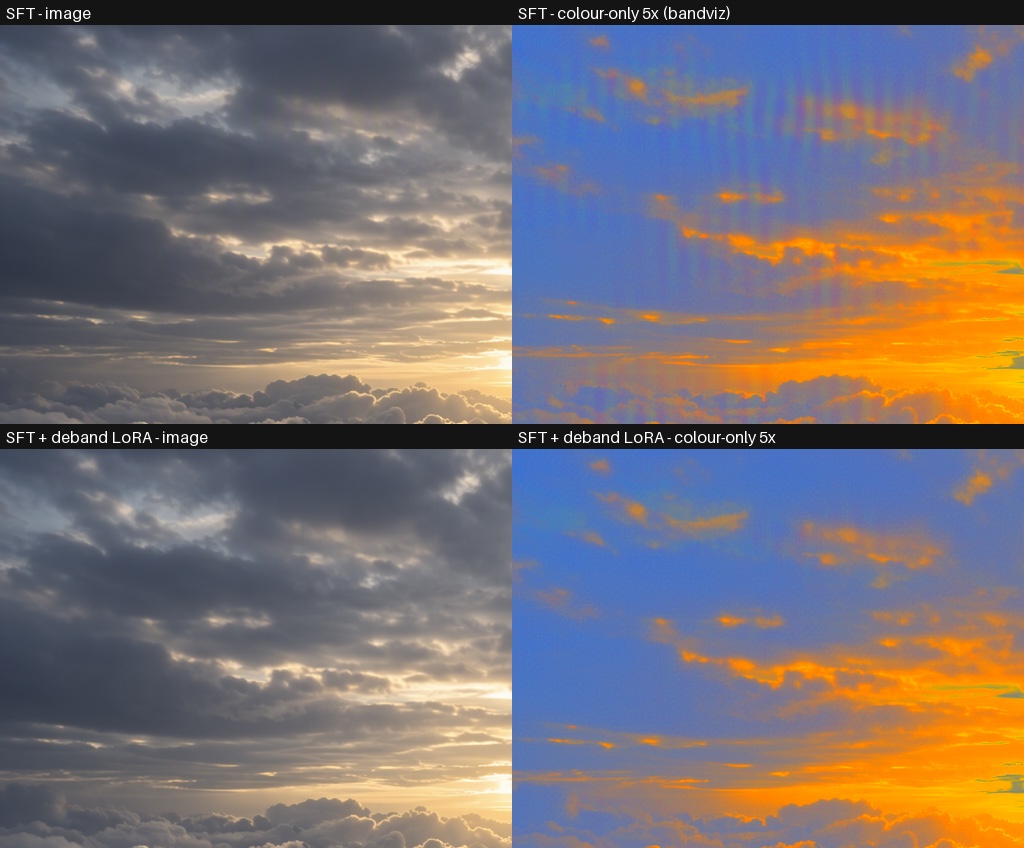
Haut : sortie SFT, brute puis avec la luminosité retirée et la couleur amplifiée 5x. Bas : le même prompt et la même graine avec le LoRA Destripe à une force de 1,5. Les rayures sont un décalage de couleur, pas un décalage de luminosité, ce qui explique pourquoi elles survivent à l'image brute. Source : nynxz/MOSS-Image
Ce que sont ces rayures
L'artefact est facile à manquer à un visionnage normal et impossible à ne plus voir une fois la couleur amplifiée. Il suit une période fixe : environ 16 px à 768 px de large et 21,3 px à 1024 px de large, soit 48 cycles sur la largeur de l'image dans les deux cas. Comme la période évolue avec la largeur, cela ne ressemble pas à du bruit de capteur ni à une couture de tuilage. Cela se comporte comme un motif que le modèle a appris à dessiner.
Les utilisateurs l'ont signalé sur le référentiel SFT dans les jours suivant la sortie : le premier fil de signalement a été ouvert le 16 octobre avec des rendus d'exemple, et les hypothèses qui y figurent allaient d'un VAE incorrect à un artefact de teacher distillé. Aucune n'a été confirmée. Le fil est toujours ouvert et OpenMOSS n'a publié aucune explication.
Comment un LoRA de 1,9 Mo le supprime
Le LoRA est extrait de la différence entre Base et SFT plutôt qu'entraîné. En résumé :
- Pour chacune des 252 couches linéaires de SFT, prenez le delta de poids par rapport à Base et décomposez-le en directions de rang 1 avec une SVD. Chaque direction est une règle « motif d'entrée vers motif de sortie » ajoutée par le fine-tuning.
- Notez chaque direction selon sa contribution à la rayure. La rayure est mesurée comme l'énergie du motif de colonnes à 48 cycles dans la propre prédiction du modèle, sur les premières étapes d'échantillonnage où elle se forme (l'en-tête du fichier indique les étapes 4 à 13 d'une exécution de 25 étapes, ER-SDE, CFG 2,5, 768 px, deux graines). Une passe arrière donne, pour chaque direction, la vitesse à laquelle cette énergie de rayure croît lorsqu'on ajoute la direction.
- Soustraction des 64 directions les mieux notées. Elles se répartissent dans 25 matrices sur les calques 24 à 41, onze d'entre elles dans le
ffn_up_gatedu MLP, le reste dansffn_down, q, k, v et o. Les rangs vont de 1 à 7, ce qui explique la taille de 1,9 Mo du fichier : 945 152 nombres stockés. L'analyse de poids de MATLOWAI estime cela à environ 0,09 pour cent de l'énergie de la modification totale de SFT par rapport à Base.
La notation des directions est ce qui rend le fichier petit sans le rendre grossier. Deux correctifs antérieurs rétablissent des calques entiers sur Base et le paient en dérive ; celui-ci supprime uniquement les directions internes à ces calques qui portent la rayure. Comme vérification causale, appliquer les mêmes directions avec le signe opposé rend les rayures environ 22 fois plus fortes.
L'utiliser dans ComfyUI
Placez moss_sft_destripe_top64_bf16.safetensors dans ComfyUI/models/loras/, chargez MOSS-Image SFT (moss_image_sft_bf16 ou moss_image_sft_int8_convrot depuis Comfy-Org/MOSS-Image), ajoutez LoraLoaderModelOnly, et réglez la force selon la largeur :
- 1,0 à 768 px
- 1,5 à 1024 px
À 1024 px, une force de 1,0 élimine la rayure sur 6 des 12 images de test et laisse une trace légère sur les autres. La force 1,5 la ramène à 1 sur 12, et 2,0 ne fait pas mieux que 1,5 tout en s'éloignant davantage de SFT. Le LoRA est construit à partir des modifications propres à SFT, il n'apporte donc rien d'utile sur Base. Les clés utilisent le préfixe diffusion_model. et le loader standard les mappe directement.
Une mise en garde sur le loader vient du même référentiel : si vous utilisez Load LoRA (Bypass), les adaptateurs q/k/v sont perdus sur les checkpoints fusionnés de Comfy-Org, et ce LoRA touche q, k et v dans quelques calques. Le patching normal fonctionne bien sur les fichiers fusionnés.
Ce que montrent les chiffres de l'auteur
Le test en aveugle utilise quatre prompts comportant de grandes zones lisses (dunes de sable, mur uni, eau libre, portrait sur fond flou) avec trois graines chacun, aucune n'ayant servi à construire le correctif. Le score est la métrique bandviz de MATLOWAI, où une valeur plus basse signifie moins de banding et où environ 16 ou moins est considéré comme propre.
| Modèle | bandviz, 768 px | Rayure encore au pic principal | SSIM par rapport à SFT |
|---|---|---|---|
| SFT | 9,8 | 9 sur 12 | 1,000 |
| SFT + Destripe @ 1.0 | 4,2 | 1 sur 12 | 0,995 |
| Base, pour référence | 4,2 | 5 sur 12 | 0,876 |
À 1024 px, le SFT brut obtient 24,0 avec la rayure comme pic principal sur 11 des 12 images ; le LoRA à 1,5 obtient 5,9 avec 1 sur 12, contre 4,0 pour Base. L'image reste similaire à plus de 99 pour cent à ce que SFT a produit.
C'est sur les aplats de couleur que l'artefact est le plus facile à voir et le plus difficile à supprimer, car une zone unie ne laisse aucune cachette à la rayure :
 |  |
|---|---|
| Fond beige uni, SFT brut | Même prompt et même graine, LoRA à 1,5 |
Les visages sont l'autre extrémité du compromis, la partie d'une image qu'un correctif trop brutal tend à adoucir :
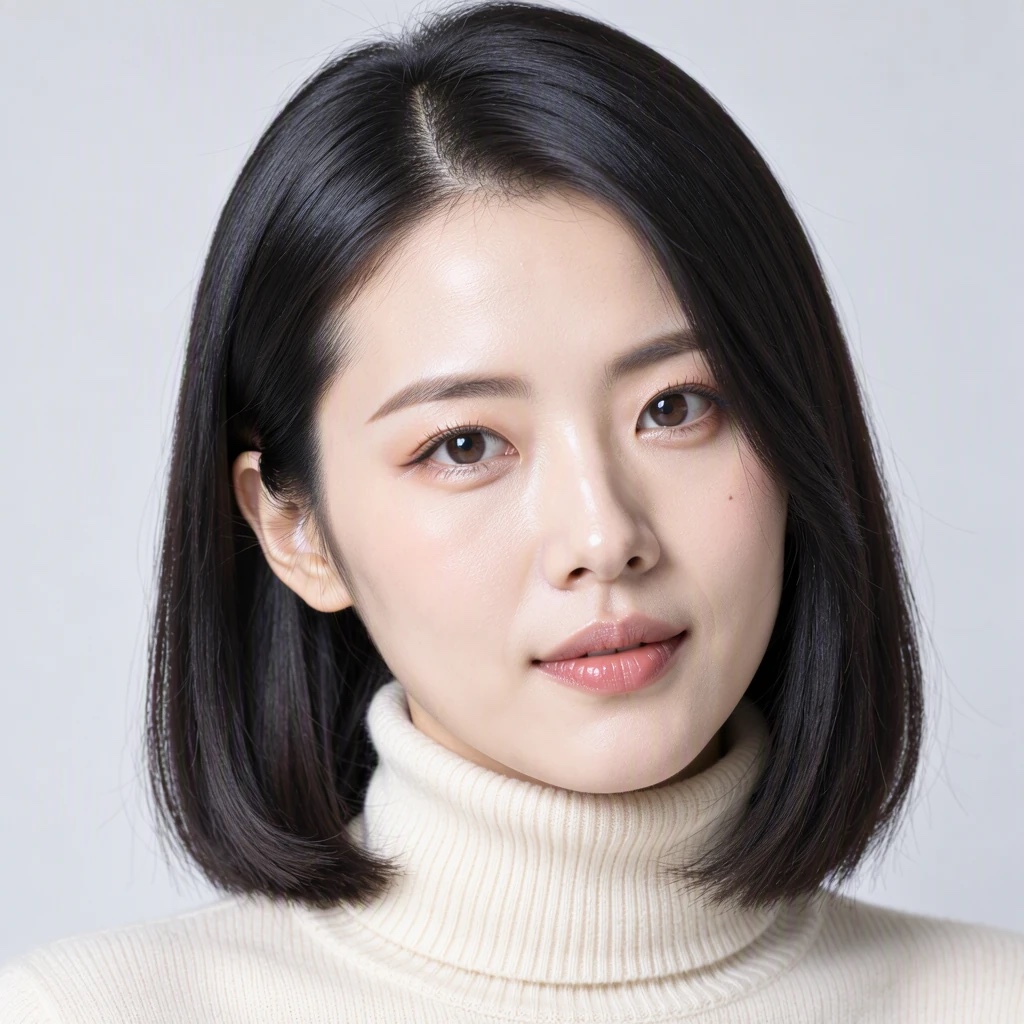 | 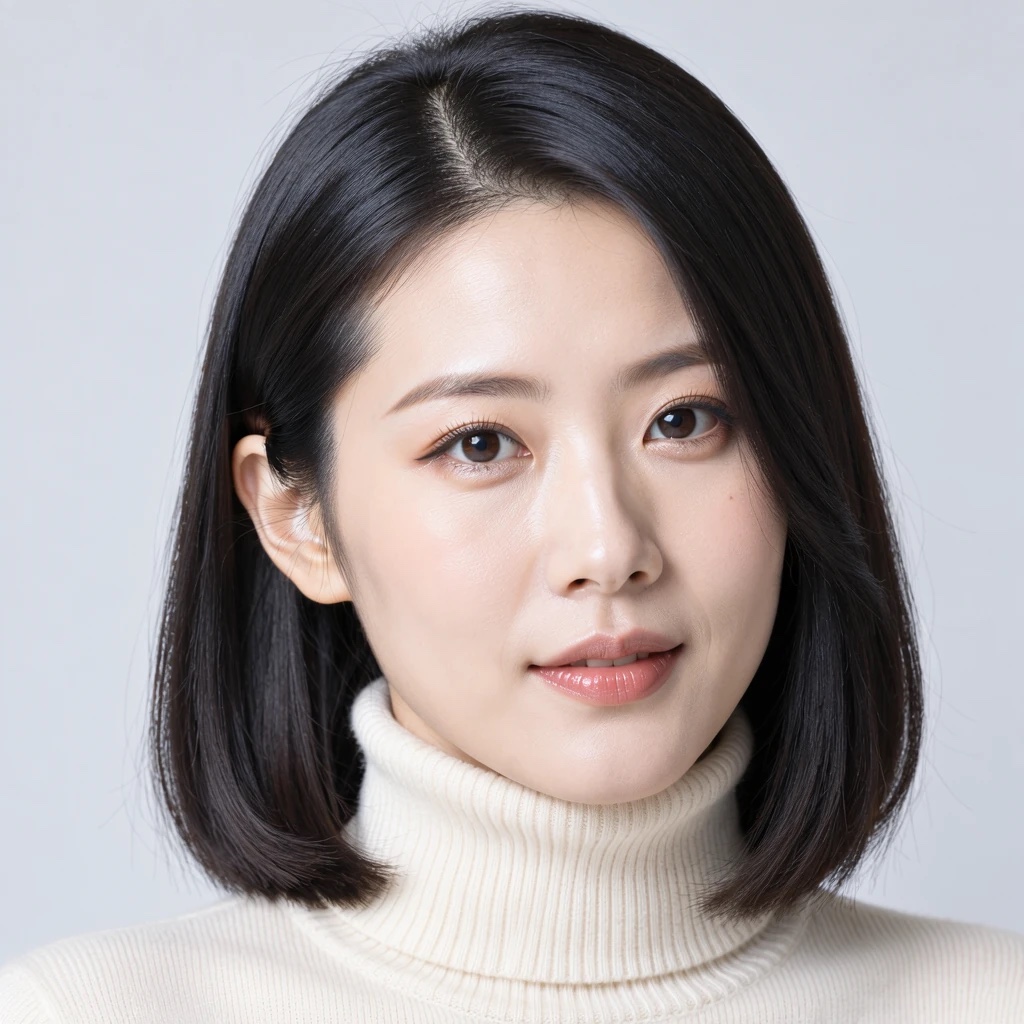 |
|---|---|
| Portrait, SFT brut | Même prompt et même graine, LoRA à 1,5 |
Rendus tiers issus du benchmark de MATLOWAI, qui mesure l'identité avec ArcFace : 0,94 avec les paramètres du preset standard et 0,96 avec les paramètres d'échantillonneur propres au LoRA. Source : MOSS-Image-SFT-DeBand
Vérification par un tiers
La preuve externe la plus solide vient de MATLOWAI, qui avait déjà publié une enquête sur ces mêmes rayures et une série de correctifs par rétablissement de calques avant que ce LoRA n'existe. Ce benchmark inclut désormais le LoRA Destripe en comparaison directe avec les alternatives, et le présente comme l'extrémité douce de la gamme :
| Correctif | Aplats, médiane dB | Pire cas | Similarité des visages |
|---|---|---|---|
| Destripe @ 1.0 | −3,2 | −1,9 | 0,94 |
| Destripe @ 1.5 | −3,9 | −1,8 | 0,94 |
| Destripe @ 1.5, avec ses propres paramètres d'échantillonneur | −4,6 | −3,0 | 0,96 |
| Modèle de base, pour référence | −16,6 | −10,4 | 0,45 |
Le même write-up énonce clairement le compromis : le LoRA ne nettoie qu'en partie les aplats de couleur, autour de −4 dB, donc les rayures deviennent plus faibles mais peuvent rester visibles dans une vue à couleur amplifiée, où les correctifs par rétablissement de calques vont plus loin au prix d'un déplacement de l'image entière. Son README oriente désormais vers ce LoRA les personnes qui veulent la plus petite modification possible, et vers le correctif plus lourd celles qui ont besoin des fonds unis les plus propres.
Limites
- Les mesures couvrent 768 et 1024 px avec ER-SDE, 25 étapes et CFG 2,5. Les autres échantillonneurs, nombres d'étapes et résolutions ne sont pas testés, et le banding varie beaucoup d'une graine à l'autre.
- Le correctif est partiel par conception : 64 directions, notées avec une estimation du premier ordre à une seule résolution. Les images plus larges (1536 px et plus) dessinent une rayure différente et plus ondulée, contre laquelle ce LoRA n'a pas été noté.
- Il n'y a aucune communication officielle d'OpenMOSS. Le write-up de l'auteur sur le référentiel SFT, publié le 19 octobre, demande si le pipeline de données SFT utilisait un scaling de position, du bucketing ou des images redimensionnées, et fournit les scores par direction ; il n'a reçu aucune réponse au moment de la rédaction.
Également dans le référentiel
Le même dépôt fournit des versions q/k/v séparées des deux checkpoints MOSS-Image, chaque couche d'attention ayant ses q, k et v stockés comme tenseurs distincts au lieu d'un seul qkv fusionné. Les poids sont les mêmes nombres dans une disposition différente, 463 tenseurs au lieu de 379. Elles existent pour le travail sur les adaptateurs : des entraîneurs comme AI Toolkit écrivent des calques q, k et v séparés, et sur les fichiers fusionnés ces adaptateurs doivent être mappés sur des tranches. Elles se chargent avec Charger Modèle Diffusion à la place des fichiers Comfy-Org.
Disponibilité
Les deux artefacts sont sur Hugging Face. Le text encoder et le VAE sont inchangés et proviennent de Comfy-Org/MOSS-Image. L'analyse du banding et la métrique bandviz sur laquelle repose la notation sont de MATLOWAI, dans MOSS-Image-SFT-DeBand, avec une comparaison interactive de chaque correctif sur les mêmes prompts et graines.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.