Qwen-Image-2.1 Next-Scene LoRA : storyboards enchaînés
Le LoRA Next-Scene d'akhaliq apprend à Qwen-Image 2.1 à générer le plan suivant à partir d'une seule image et à enchaîner les storyboards via un nœud LoRA ComfyUI.
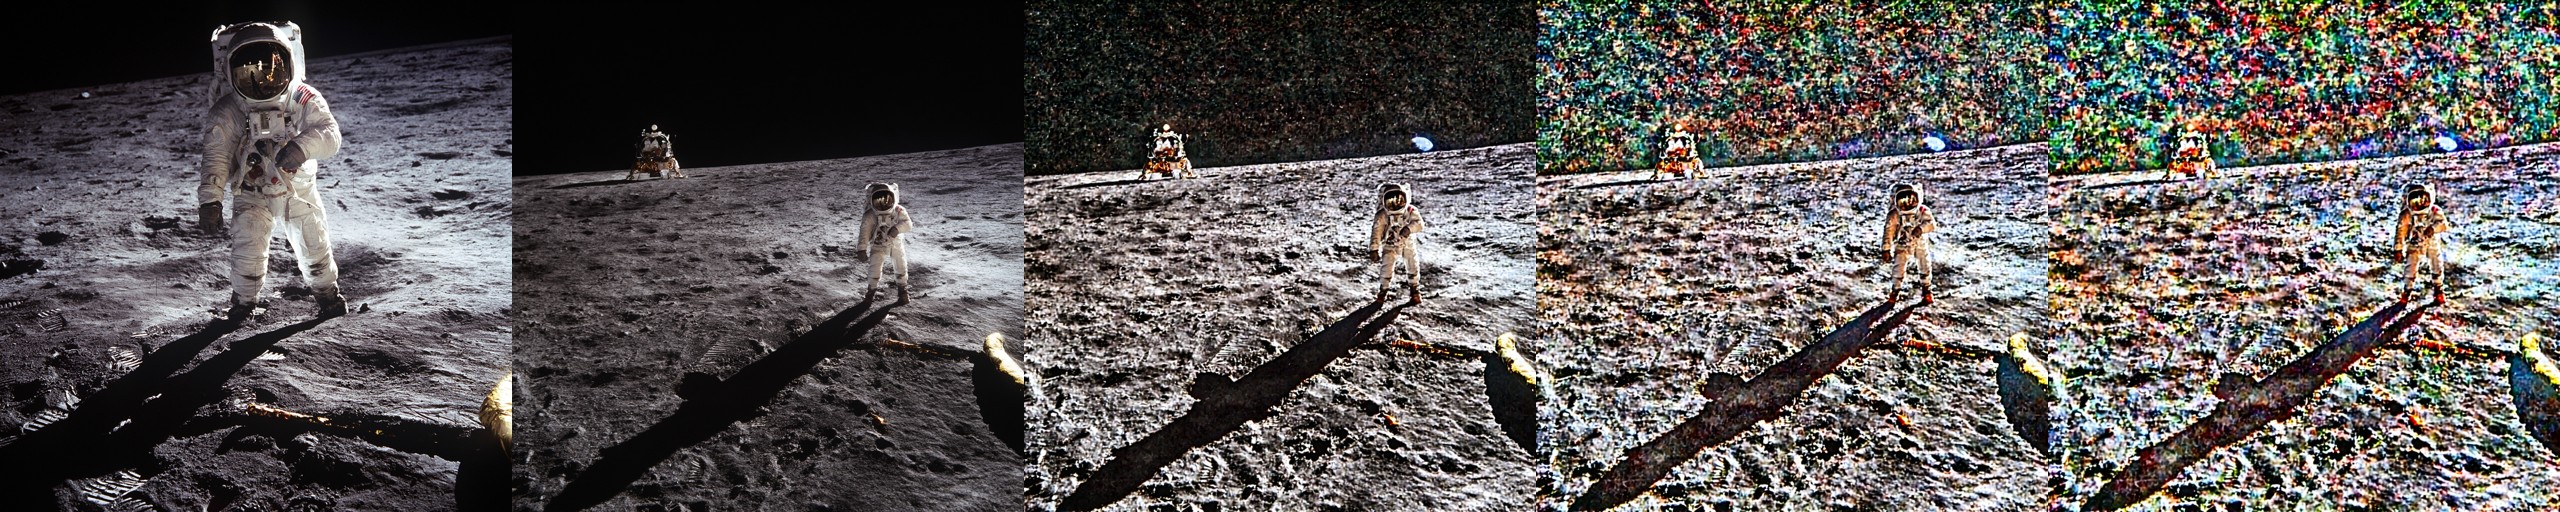
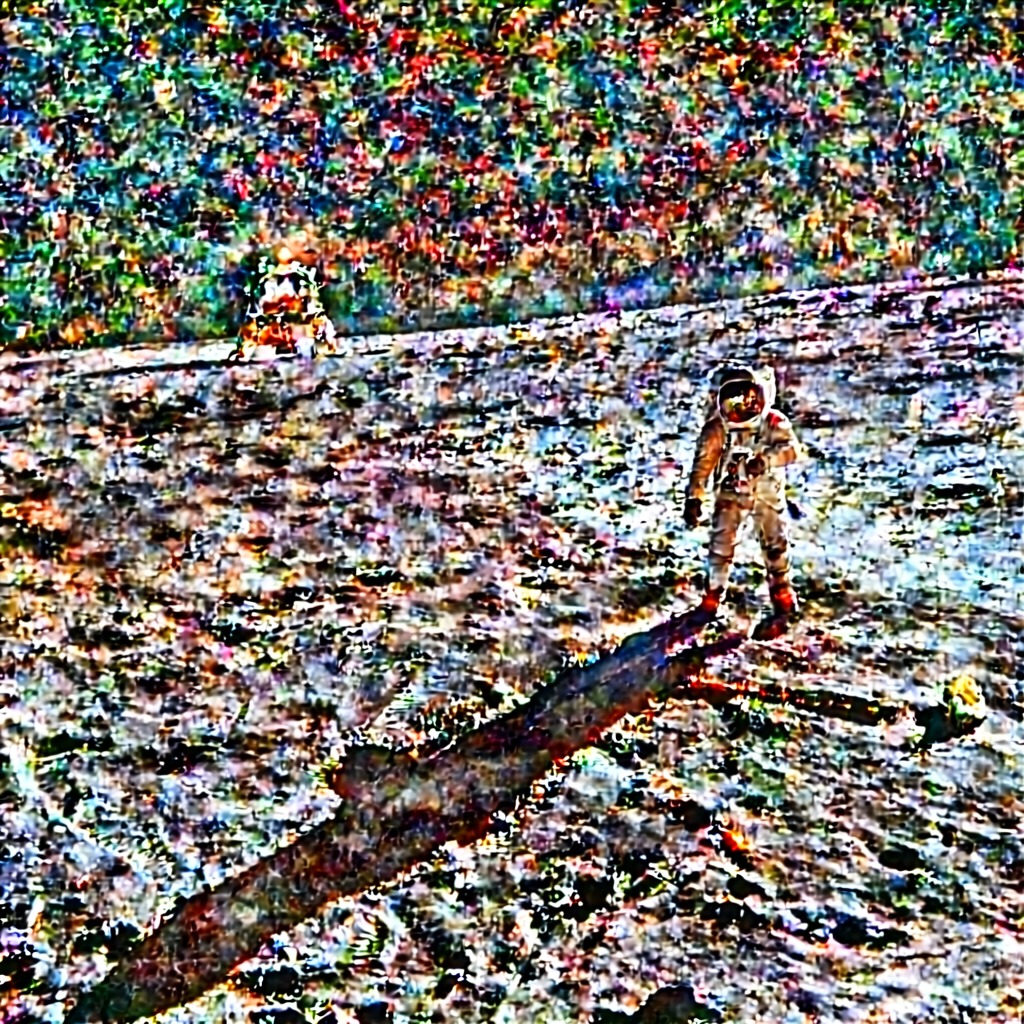
Quatre plans dirigés à partir d'une seule photographie. Chaque image correspond à la sortie précédente réinjectée avec une nouvelle instruction, au checkpoint step-2,500 recommandé et à une strength de 0,7.
Ce qu'il apporte à Qwen-Image 2.1
Le format next-scene provient de lovis93/next-scene-qwen-image-lora-2509, qui a dépassé les 313 000 téléchargements sur le modèle d'édition Qwen-Image 2509. Il s'agit ici du portage vers la base en cours : réentraîné nativement sur Qwen-Image 2.1, où cette capacité n'existe pas encore. Il se combine avec le LoRA Multiple-Angles antérieur d'akhaliq, qui contrôle où se trouve la caméra, tandis que Next-Scene contrôle où l'histoire se dirige ensuite.
Les prompts commencent par Next Scene: et placent en tête l'indication de caméra, par exemple « Next Scene: The camera pulls back to a sweeping aerial view, revealing the fleet behind the cliffs » :
Next Scene: The camera tracks forward and tilts down as rain begins to streak the lens.
Next Scene: Cut to a low-angle shot; sunlight breaks through the clouds behind her.
Next Scene: The camera pans right, revealing the fleet massing behind the ridge.
L'enchaînement, avec une recette mesurée
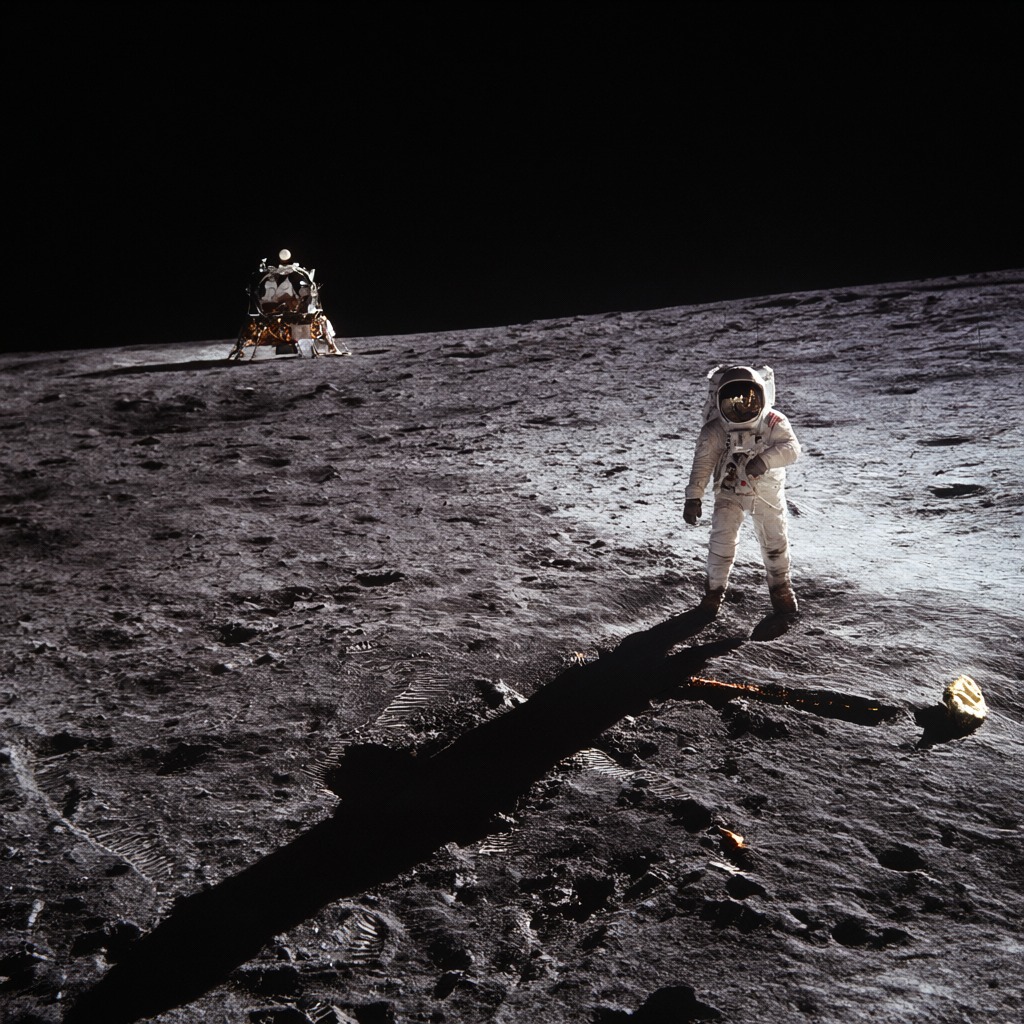
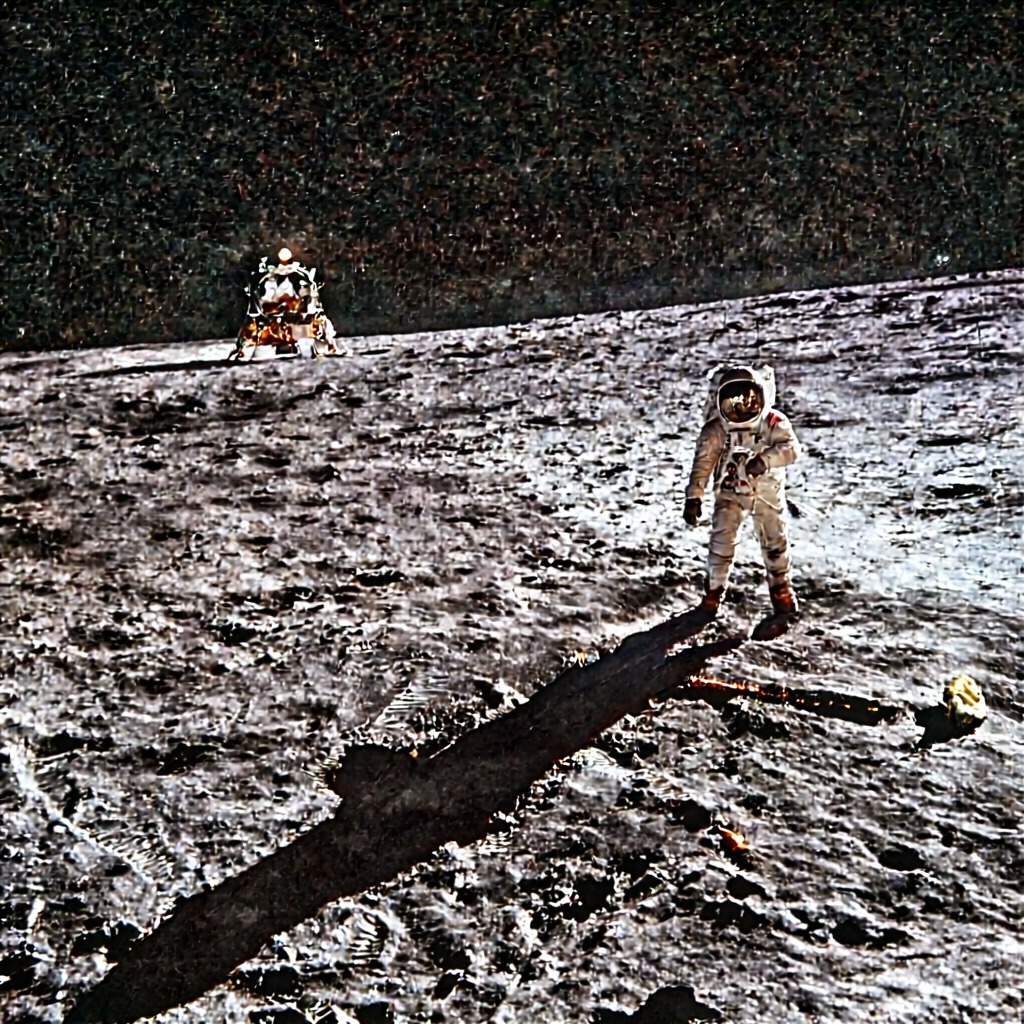
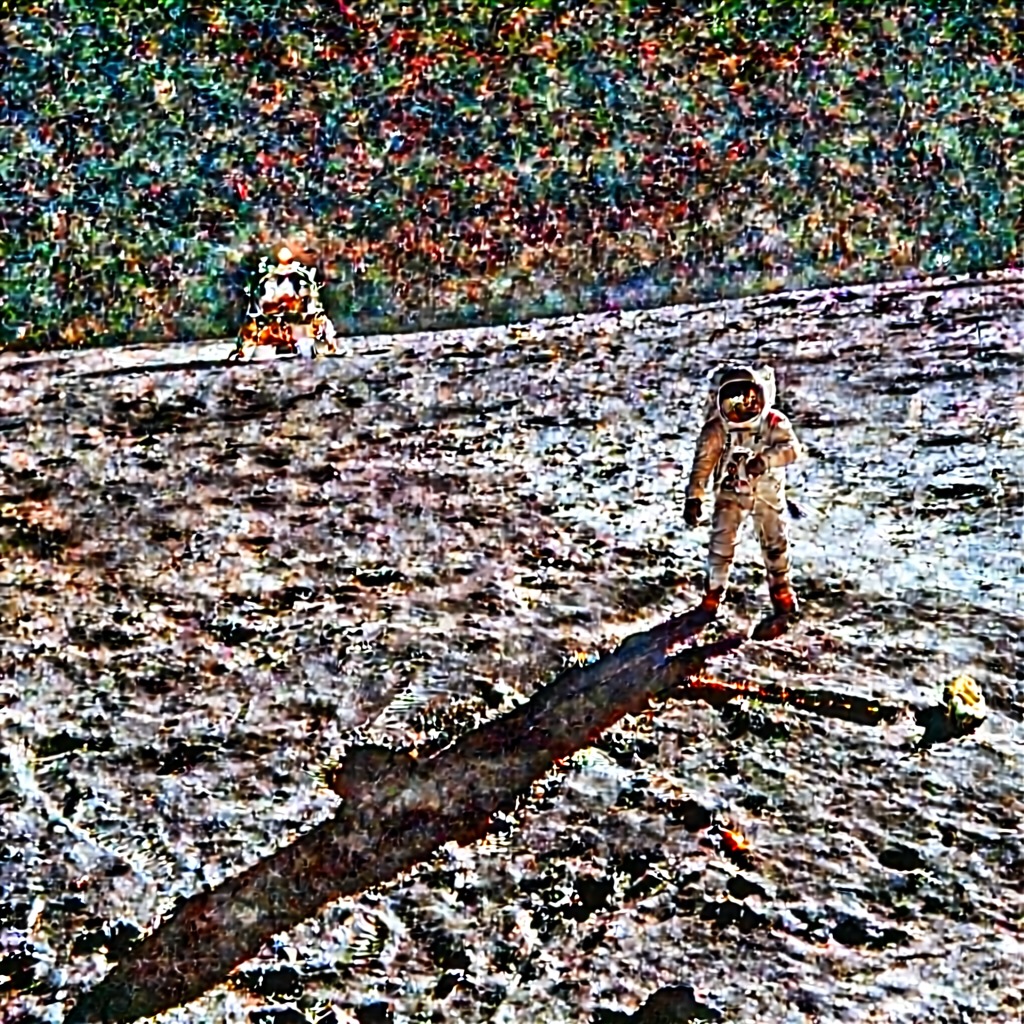
Réinjecter chaque sortie comme entrée suivante est ce qui transforme l'adaptateur en outil de storyboard, mais l'auteur a mesuré un mode de défaillance au lieu de le deviner : un enchaînement naïf à une strength de 0,9 accumule du grain jusqu'à ce qu'il devienne un bruit de couleur visible dès le 3e ou 4e saut. La recette vérifiée pour des chaînes propres est une strength de 0,7 ou moins, plus un flou gaussien de 0,5 pixel sur chaque entrée enchaînée, ce qui rompt la boucle de rétroaction d'amplification du grain. L'exemple à quatre sauts ci-dessus a été rendu exactement de cette manière.
 |  |
|---|---|
| Saut 1 : la caméra recule vers un plan large | Saut 2 : panoramique vers la droite, l'astronaute bondit sur le régolithe |
 |  |
|---|---|
| Saut 3 : coupe sur un plan en contre-plongée tandis que l'astronaute salue | Saut 4 : zoom avant sur la visière dorée, le module lunaire s'y reflétant |
Quel checkpoint utiliser
Le référentiel fournit trois checkpoints convertis ainsi que les sorties d'entraînement brutes :
| Checkpoint | Verdict |
|---|---|
next_scene_step2500.safetensors | Recommandé. Étape finale, converti vers la disposition de clés diffusers. Transformation de scène la plus marquée tout en conservant la composition et l'identité. |
next_scene_step1500.safetensors | Alternative plus douce, plus respectueuse de l'identité. À utiliser si 2 500 pousse trop fort. |
next_scene_step1000.safetensors | Transformation la plus faible, surtout utile pour étudier la courbe d'entraînement. |
checkpoints/qwen21_next_scene_v1_*.safetensors | Format ai-toolkit brut. Les clés MLP utilisent la nomenclature fusionnée d'ai-toolkit, que diffusers ignore silencieusement. Utilisables uniquement via ai-toolkit ou son propre loader. |
L'auteur a également publié un balayage de checkpoints sur un même prompt de tempête aux étapes 1 000, 1 500 et 2 500, avec un témoin sans LoRA. Le modèle de base tente déjà la tempête, car Qwen-Image 2.1 édite bien de lui-même, mais l'étape 2 500 est la cellule qui déploie un front orageux complet sur la vallée tout en conservant l'explorateur, les ruines et la palette intacts.
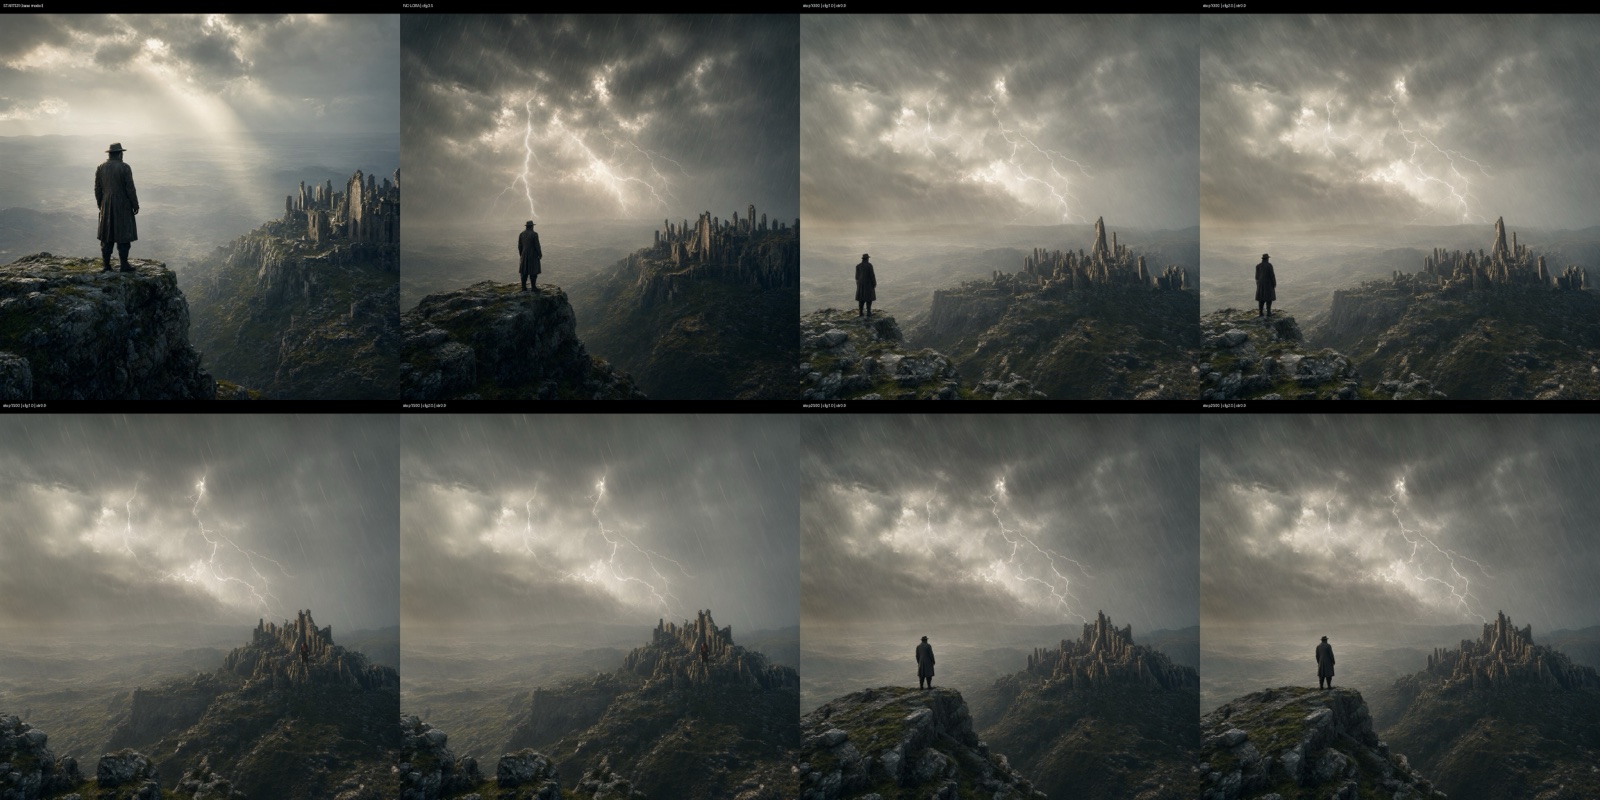
Une même image de départ cinématographique, la même instruction de tempête à chaque checkpoint, plus un témoin sans LoRA.
Comment il a été entraîné
- Base : Qwen-Image 2.1,
arch: qwen_image_2. - Données : 1 144 paires de progression de scène, images consécutives issues des films libres Blender Sintel et Tears of Steel (CC-BY), légendées sous forme d'instructions de type réalisateur « Next Scene: ... » par Qwen3-VL-4B sur chaque paire image suivante. Les paires brutes et l'ensemble légendé sont publiés.
- Entraînement : ostris/ai-toolkit, rang 64 / alpha 64, adamw8bit, taux d'apprentissage 1e-4, timesteps pondérés, caption dropout 0,05, 512 pixels, 2 500 étapes, sur une base quantifiée uint3 en bf16.
Portée et limites
L'adaptateur a été entraîné sur des images de films cinématographiques, un animé et un en prises de vue réelles. Il généralise aux photographies, mais il est plus performant sur les scènes filmiques, les paysages et les plans d'ensemble, et les portraits statiques sont hors périmètre par conception. L'entraînement a été effectué à 512 pixels ; les toiles plus grandes héritent du comportement mais n'ont pas servi à l'entraînement. Les grilles d'échantillons toutes les 250 étapes sont conservées dans checkpoints/samples/, et un tableau de bord Trackio ainsi qu'un Space de démo sont liés depuis la carte du modèle.
Disponibilité dans ComfyUI
Le checkpoint recommandé est déjà converti, il se charge donc dans n'importe quel flux de travail Qwen-Image 2.1 via un nœud LoRA à une strength de 0,7 à 0,9, avec l'image transmise comme entrée d'édition ou de référence. Il n'existe pas de fichier de flux de travail distinct pour l'adaptateur, et ce sont les fichiers next_scene_step*.safetensors à la racine qu'il faut utiliser dans ComfyUI ; les copies dans checkpoints/ sont au format ai-toolkit.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.