Qwen-Image 2.1 Multiple-Angles LoRA : Rephotographier sous tout angle
Le LoRA Multiple-Angles d'Akhaliq ajoute le contrôle de caméra à Qwen-Image 2.1 : une photo, l'un des 72 cadrages d'azimut et d'élévation, et le sujet est rephotographié.
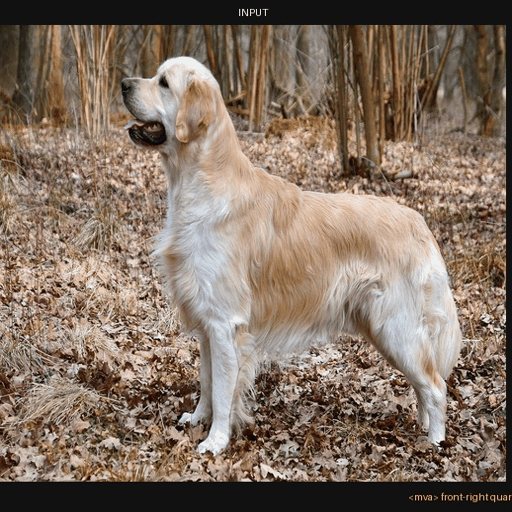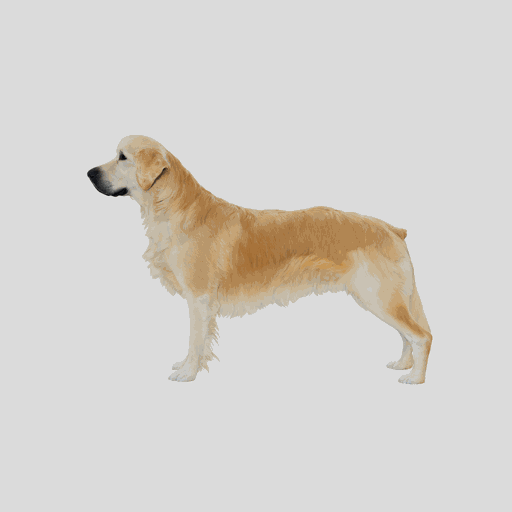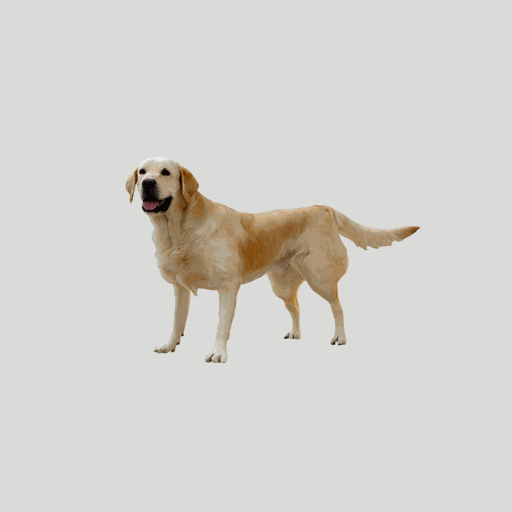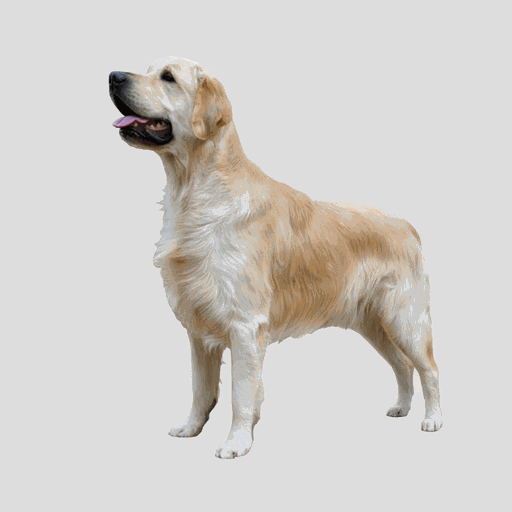
Une orbite d'un golden retriever à hauteur des yeux, les 12 pas d'azimut, produite avec le checkpoint v2 à l'étape 1 500.
Ce qu'apporte l'adaptateur
Qwen-Image 2.1 gère la génération et l'édition dans un seul modèle, mais n'a aucune notion de la position de la caméra. Lui demander de « montrer le dos » laisse généralement le sujet à peu près là où il était. Ce LoRA enseigne à la place le dictionnaire de poses : chaque prompt commence par le déclencheur <mva> suivi d'un azimut et d'une élévation nommés, et le modèle déplace la caméra plutôt que la scène.
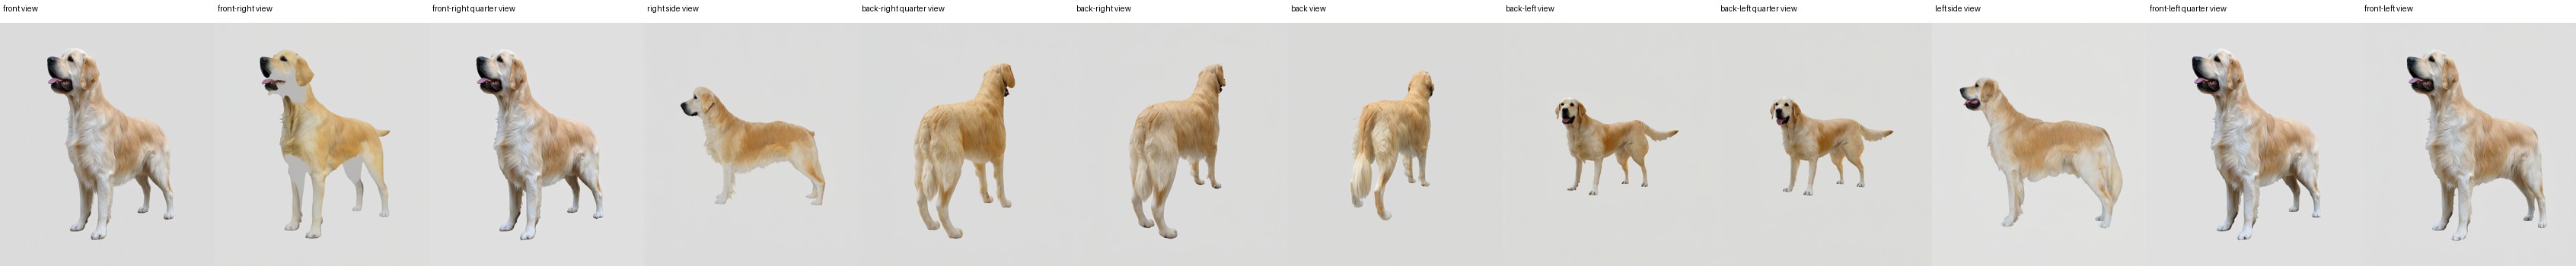
La même orbite sous forme de bande annotée, une image par azimut.
La grammaire est courte :
<mva> {azimuth}, {elevation}[ close-up]- 12 azimuts par pas de 30 degrés, de la vue de face aux deux profils jusqu'à la vue de dos.
- 4 élévations : à hauteur des yeux, en hauteur (30 degrés), en plongée (60 degrés) et vue du dessus (90 degrés).
- Une variante gros plan (
close-up) de chaque combinaison, soit 72 cadrages adressables au total. - Force LoRA recommandée entre
0.8et1.0dans ComfyUI ou diffusers.
Fonctionnement sur de vraies photos
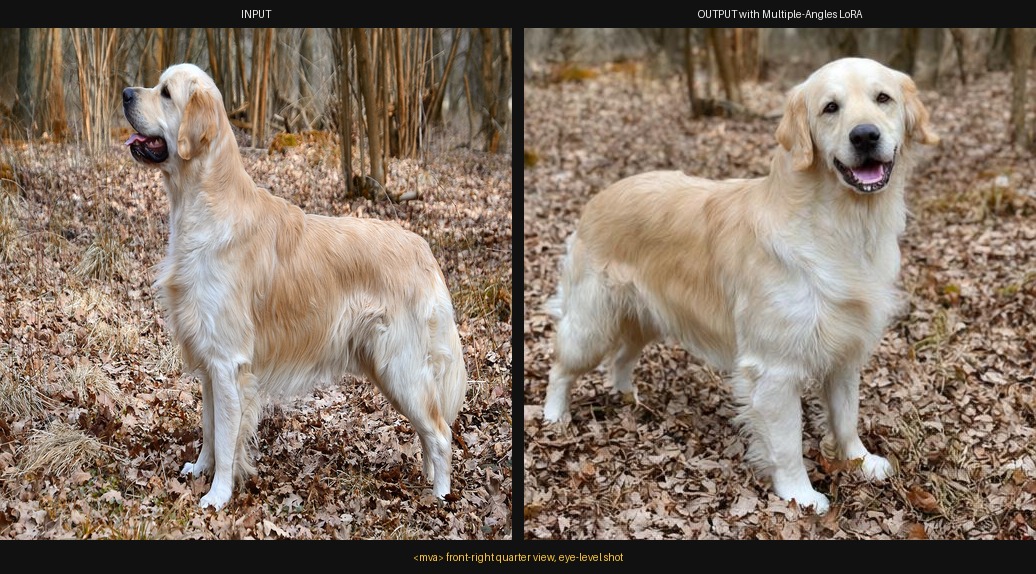
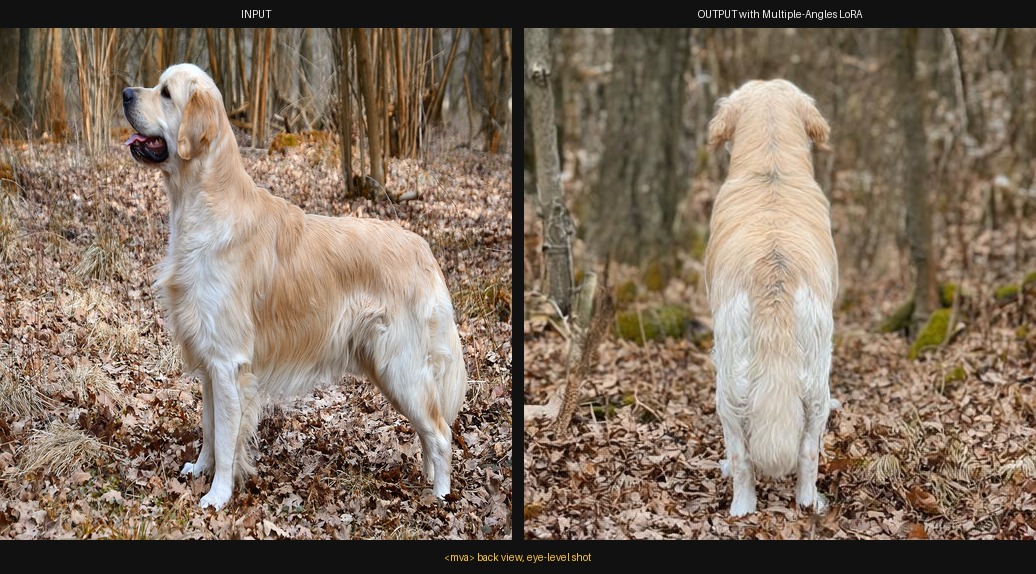
Le jeu d'entraînement est constitué d'objets rendus, mais la carte du modèle documente un test sur un ensemble mis de côté composé de photos ordinaires qu'il n'a jamais vues : un golden retriever, un chat et une pomme issus de Wikimedia Commons. À une force d'environ 1.0, le sujet pivote vers la vue demandée et la scène survit globalement, bien que les détails fins comme la fourrure s'adoucissent sur les sujets éloignés de la distribution d'entraînement.
 |  |
|---|---|
| Vue de trois-quarts face droite, à hauteur des yeux | Vue de dos, à hauteur des yeux |
La règle empirique de la carte : commencez à une force de 1.0 ; si la reprise dérive vers une copie de la photo de référence au lieu de déplacer la caméra, abaissez la force vers 0.8 plutôt que de changer de checkpoint.
Ce que change la v2
La deuxième révision est le téléchargement recommandé. Elle fait passer les paires d'entraînement de 5 028 à 13 328 (un ensemble Dome-Objaverse donnant la priorité aux personnages, plus des personnages riggés filtrés par licence), fait passer le rang de 32 à 64 et remplace la précision de base convrot int8 par du bf16 avec un échantillonnage pondéré des pas de temps.
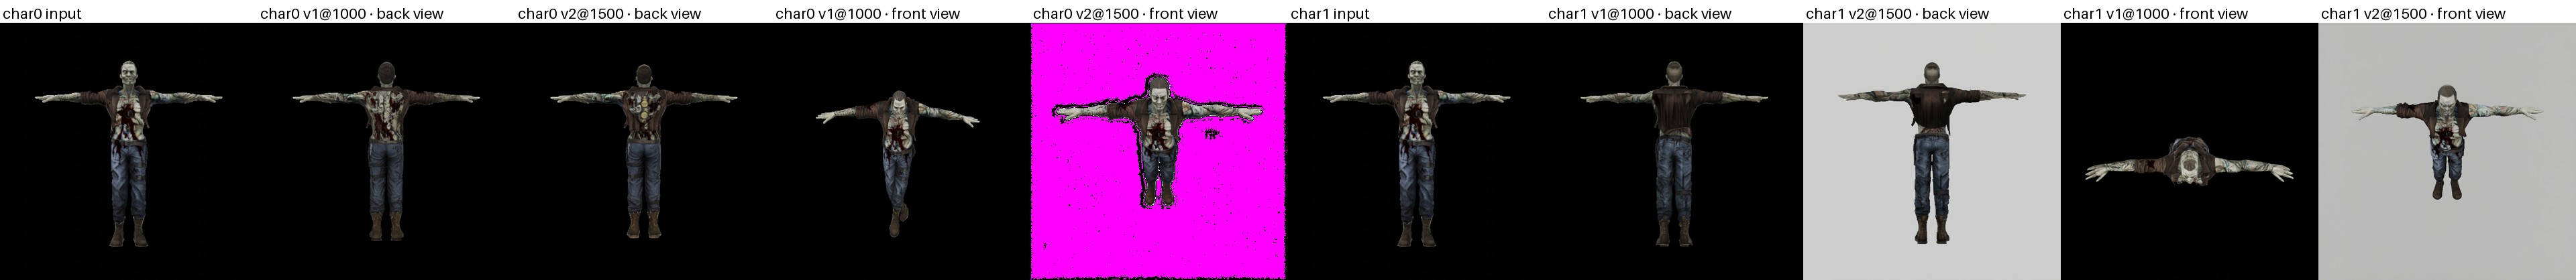
Planche de poses de personnages comparant la v1 à l'étape 1 000 et la v2 à l'étape 1 500.
La grammaire <mva> et le dictionnaire de poses sont identiques d'une version à l'autre, donc un flux de travail conçu pour la v1 continue de fonctionner après avoir remplacé le fichier. La carte recommande l'étape 1 500 de la série v2 (rang 64, précision complète, environ 319 Mo dans checkpoints_v2/) ; les fichiers v1 restent dans checkpoints/, où l'étape 1 000 est le meilleur choix.
L'utiliser dans ComfyUI
L'adaptateur est un simple LoRA, aucun pack de nœuds personnalisé n'est donc nécessaire : placez le .safetensors dans ComfyUI/models/loras/ et chargez-le avec le chargeur LoRA standard, aux côtés du modèle de diffusion Qwen-Image 2.1, de son encodeur de texte et du VAE correspondant. La carte recommande une force de 0.8 à 1.0 ; il n'existe ni échantillonneur ni valeur CFG spécifiques à l'adaptateur, ce sont donc les paramètres du modèle de base qui s'appliquent.
Le benchmark, dit franchement
La carte publie un benchmark de 144 cas mis de côté (24 objets inédits, six poses chacun) évalué par rapport à des rendus de dôme de référence avec la similarité cosinus image-image CLIP, et le rapporte honnêtement : le modèle de base non adapté obtient en réalité un score légèrement supérieur en moyenne (0.857 contre 0.832), car cette métrique mesure surtout la similarité globale des images plutôt que le déplacement de la caméra. Les auteurs notent que le protocole correct est la précision de récupération de pose, qui nécessite encore une passe de rendu supplémentaire, et renvoient les lecteurs aux images A/B à prompt identique comme preuve principale de la capacité elle-même.
Disponibilité
Poids : akhaliq/Qwen-Image-2.1-Multiple-Angles-LoRA
Modèle de base : Qwen/Qwen-Image-2.1
Données d'entraînement (v2) : akhaliq/qwen21-multiple-angles-train-v2
Page de la famille de base : Qwen-Image 2.1
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.