LoRA Pruna Qwen-Image 2.1 en 5 et 8 étapes dans ComfyUI
Les LoRA Pruna-Qwen-Image-2.1 de PrunaAI réduisent la génération et l'édition Qwen-Image 2.1 à 5 ou 8 étapes sans CFG, avec conversions ComfyUI communautaires et sigmas par étape.
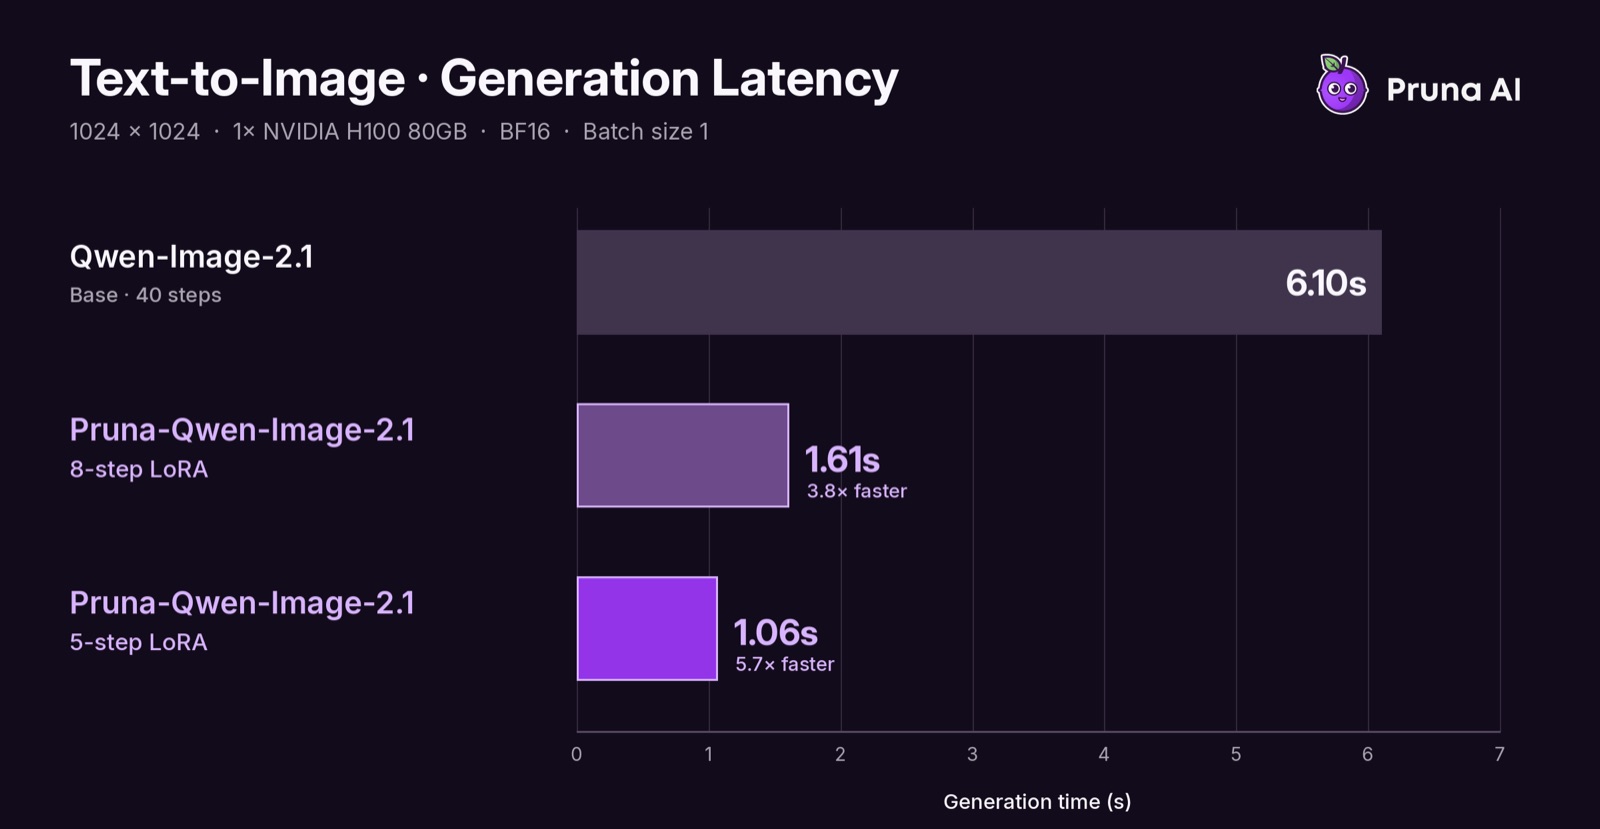
Comparaisons texte-image issues de la carte de modèle officielle.
Deux adaptateurs, deux plannings
Cette publication n'est pas un seul modèle distillé mais deux étudiants entraînés séparément, et PrunaAI vous invite à en choisir un selon que vous privilégiez la qualité ou la vitesse :
| Adaptateur | Étapes | Compromis |
|---|---|---|
p_qwen_image_2.1_8step_v0.1.safetensors | 8 | Qualité supérieure, la valeur par défaut recommandée |
p_qwen_image_2.1_5step_v0.1.safetensors | 5 | Plus rapide, avec des images visiblement moins bonnes |
Chaque adaptateur a été entraîné pour son propre planning sigma, et la carte de modèle demande de n'en charger qu'un seul à la fois. Les plannings sont la partie qui doit être copiée exactement, car les étudiants n'ont pas été entraînés pour un nombre d'étapes qu'un échantillonneur déduit de lui-même :
| Étapes | Sigmas |
|---|---|
| 5 | 1.0, 0.94, 0.857142857, 0.666666667, 0.4 |
| 8 | 1.0, 0.933333333, 0.857142857, 0.769230769, 0.666666667, 0.545454545, 0.4, 0.222222222 |
Les deux sont entraînés avec DMD, fonctionnent à CFG 1.0 avec un prompt négatif vide, et le 0 terminal est ajouté par le scheduler plutôt qu'écrit dans le planning. D'autres nombres d'étapes, plannings ou valeurs de CFG sortent du cadre pour lequel les adaptateurs ont été entraînés.
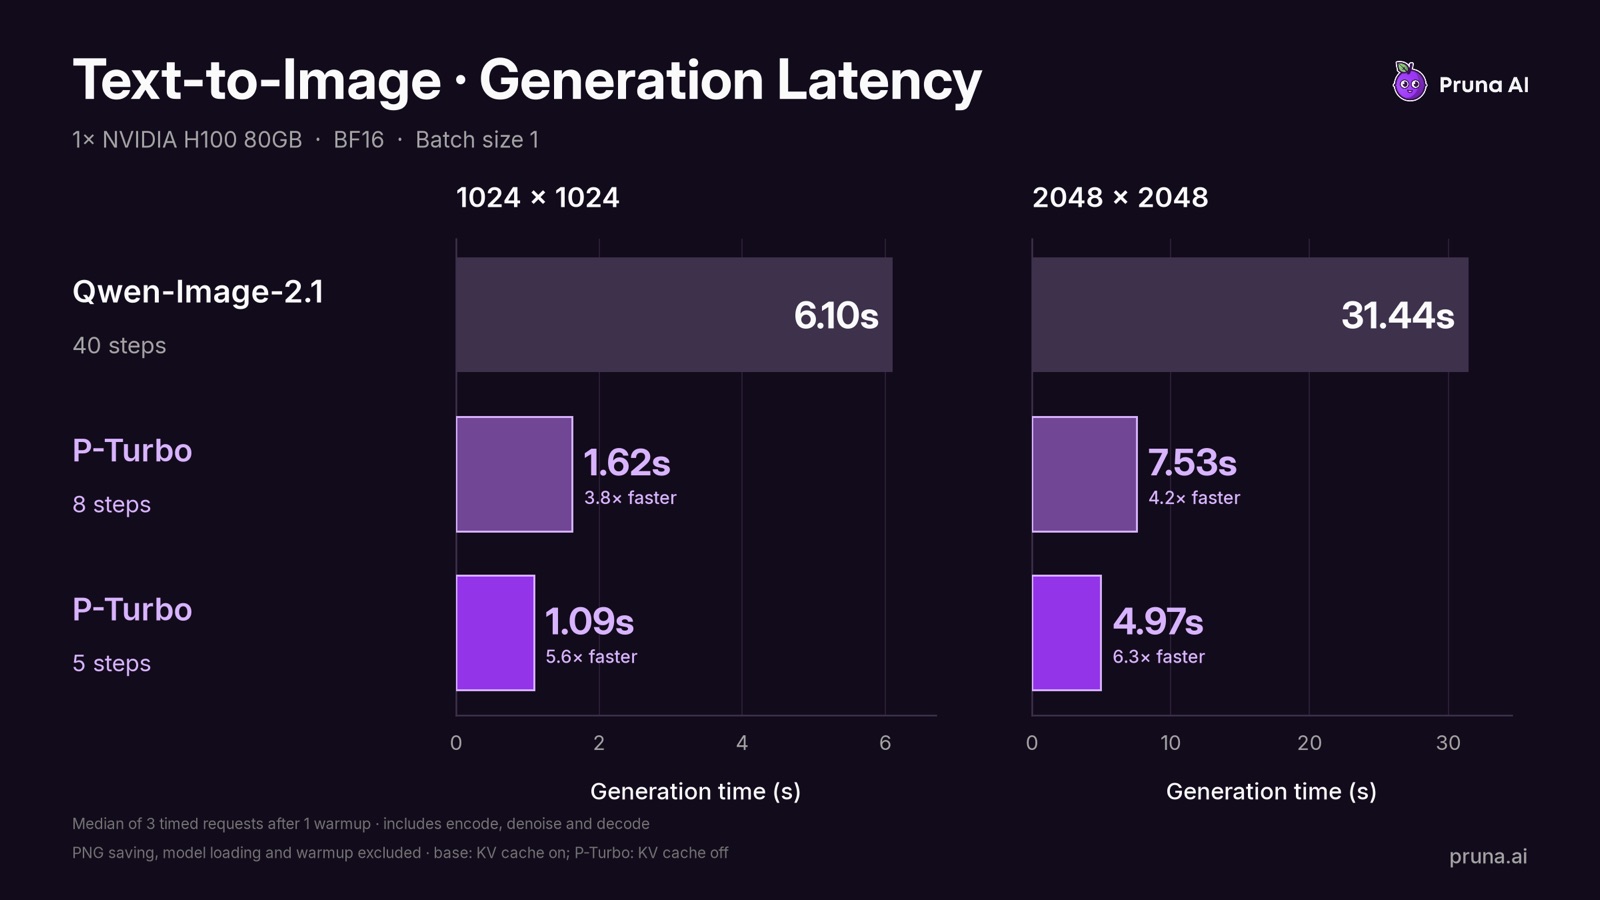
Le graphique de latence texte-image de la carte, mesuré sur un seul H100 80GB : médiane de trois requêtes après un échauffement, incluant l'encodage du prompt, le débruitage et le décodage, avec le modèle de base à 40 étapes avec KV cache et les adaptateurs à 5 ou 8 étapes sans celui-ci.
Le chiffre phare de PrunaAI est jusqu'à 6,3x plus rapide, et la carte prend soin de préciser ce qu'elle ne revendique pas : les temps ne signifient pas une qualité d'image équivalente, les LoRA sont restés non fusionnés pour le benchmark, et les images d'exemple activent le KV caching alors que le graphique n'a pas été remesuré avec ce réglage.
Couverture d'entraînement et limites
Les adaptateurs ont été entraînés uniquement en résolution 1K, sur un mélange de prompts simples et suréchantillonnés, couvrant le texte-image et l'édition d'une ou plusieurs images avec jusqu'à 3 images de référence. PrunaAI recommande de commencer à 1024x1024 et considère la sortie 2K, davantage d'images de référence et les prompts courts et vagues comme hors couverture, où la qualité peut varier.
La publication est explicitement étiquetée v0.1, en cours de développement :
- La qualité est inférieure à celle du modèle de base à 40 étapes, et le référentiel sera mis à jour au fur et à mesure que la distillation s'améliore.
- L'adaptateur 5 étapes est le plus rapide, et ses images sont visiblement moins bonnes que celles de l'adaptateur 8 étapes.
- Ce n'est pas un modèle autonome : les poids de base
Qwen/Qwen-Image-2.1sont toujours requis.
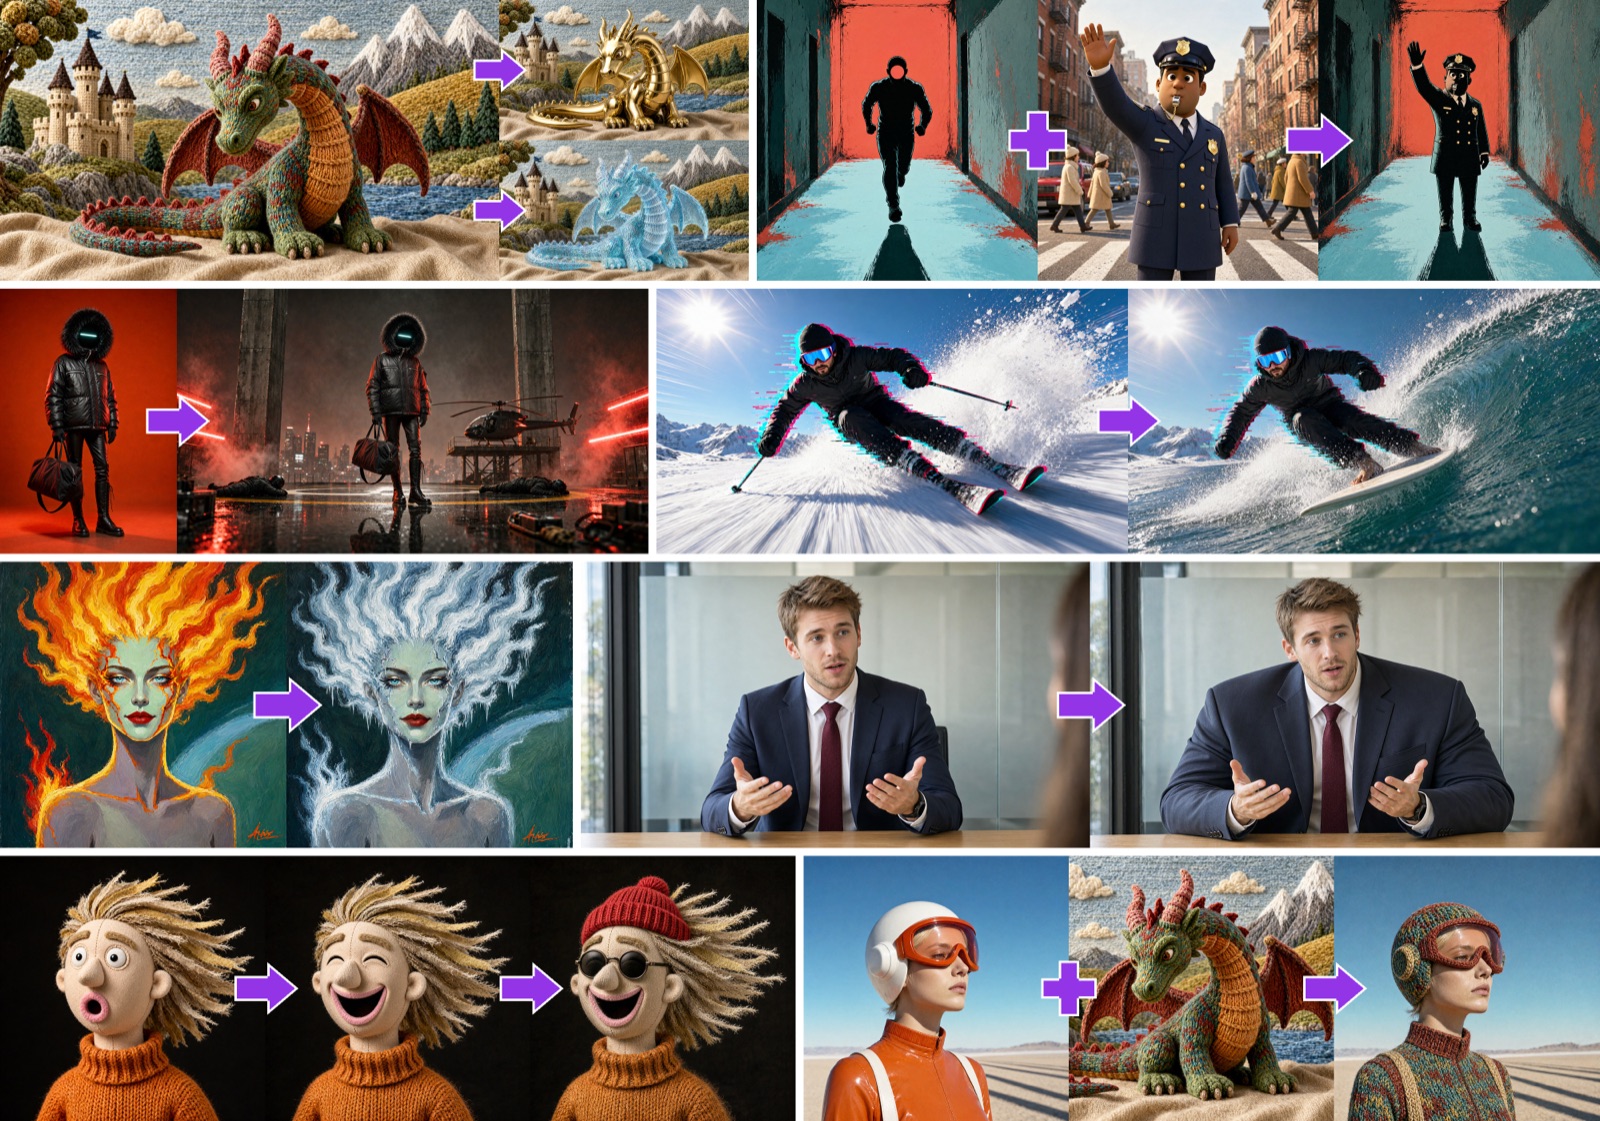
Grilles d'édition issues de la carte de modèle officielle.
Disponibilité dans ComfyUI
Il n'existe pas encore de package ComfyUI officiel pour ces adaptateurs : ils sont livrés sous forme de fichiers diffusers/PEFT avec un rank 64 et un alpha PEFT de 128, et l'alpha est stocké dans les métadonnées safetensors plutôt que dans les tenseurs que lit le chargeur LoRA de ComfyUI, si bien qu'un simple dépôt direct s'exécuterait à la mauvaise échelle. La communauté a comblé cet écart en moins d'un jour après la publication :
NidAll/pruna-image-2.1-comfyui-lorasest une conversion non officielle qui ajoute un tenseur scalaire.alphaà chacune des 224 cibles LoRA afin que les adaptateurs s'exécutent à l'échelle prévue avec une force LoRA de 1.0, sans toucher aux poids A et B. Elle fournit ses propres fichiers JSON de flux de travail en 5 étapes et 8 étapes.- Ces flux de travail n'utilisent que des nœuds natifs de ComfyUI :
ManualSigmas,SamplerCustom, Euler, CFG 1.0, force LoRA 1.0, aucun prompt négatif, et texte-image en 1024x1024. Les fichiers de base proviennent deComfy-Org/Qwen-Image-2.1, ce qui signifie que le transformerint8_convrotest la cible pratique pour toute personne limitée en VRAM.
ComfyUI prend en charge Qwen-Image 2.1 nativement depuis la publication Day-0, donc rien de plus n'a besoin d'être installé : un ComfyUI récent avec ManualSigmas et SamplerCustom couvre les deux flux de travail fournis.
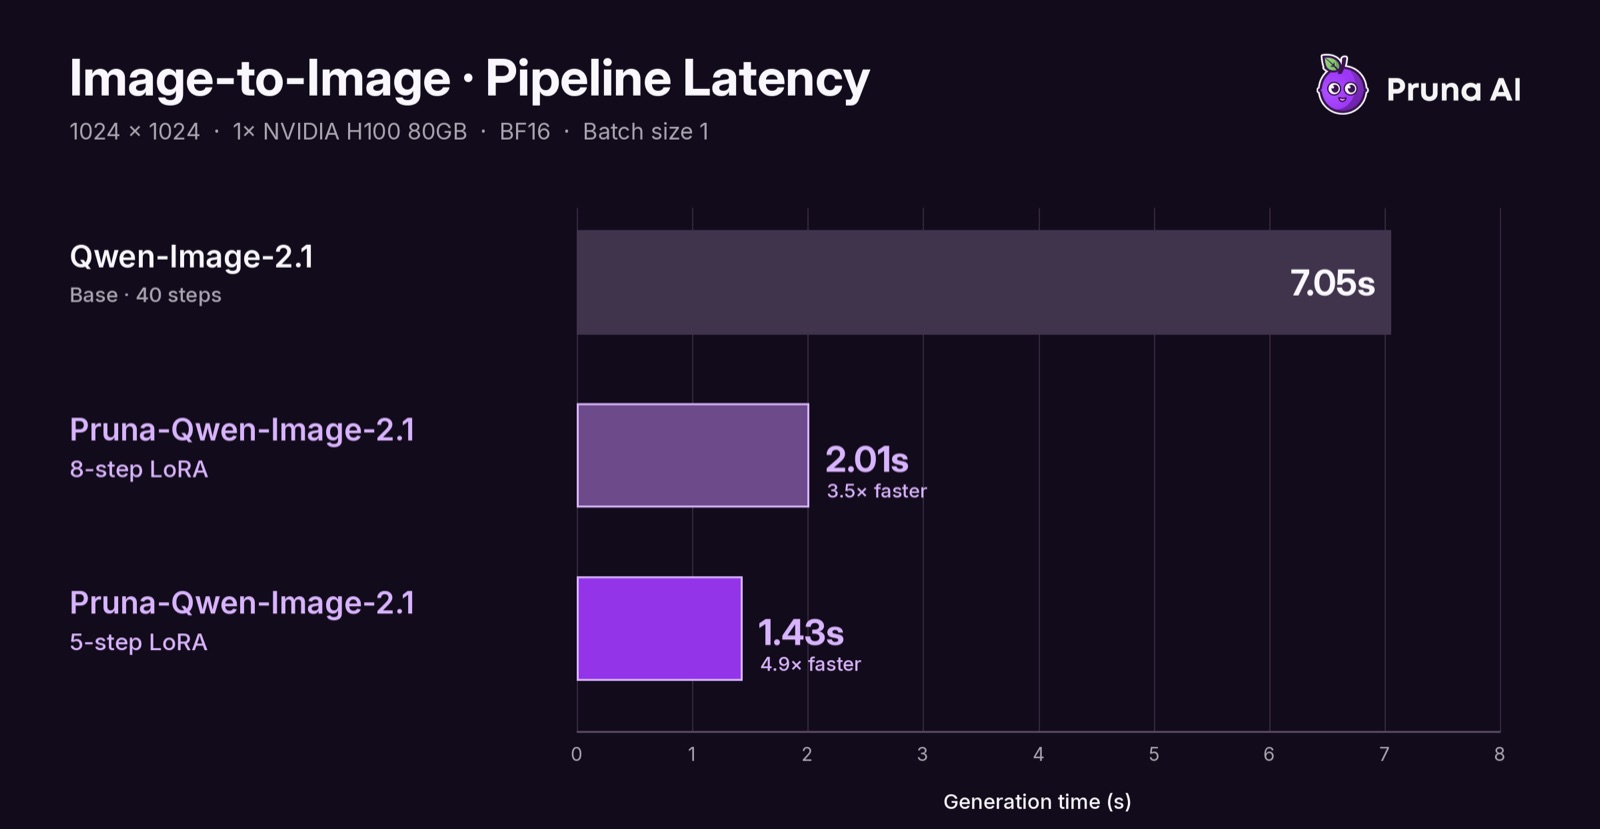
Un exemple d'édition issu de la carte de modèle, exécuté avec les adaptateurs few-step.
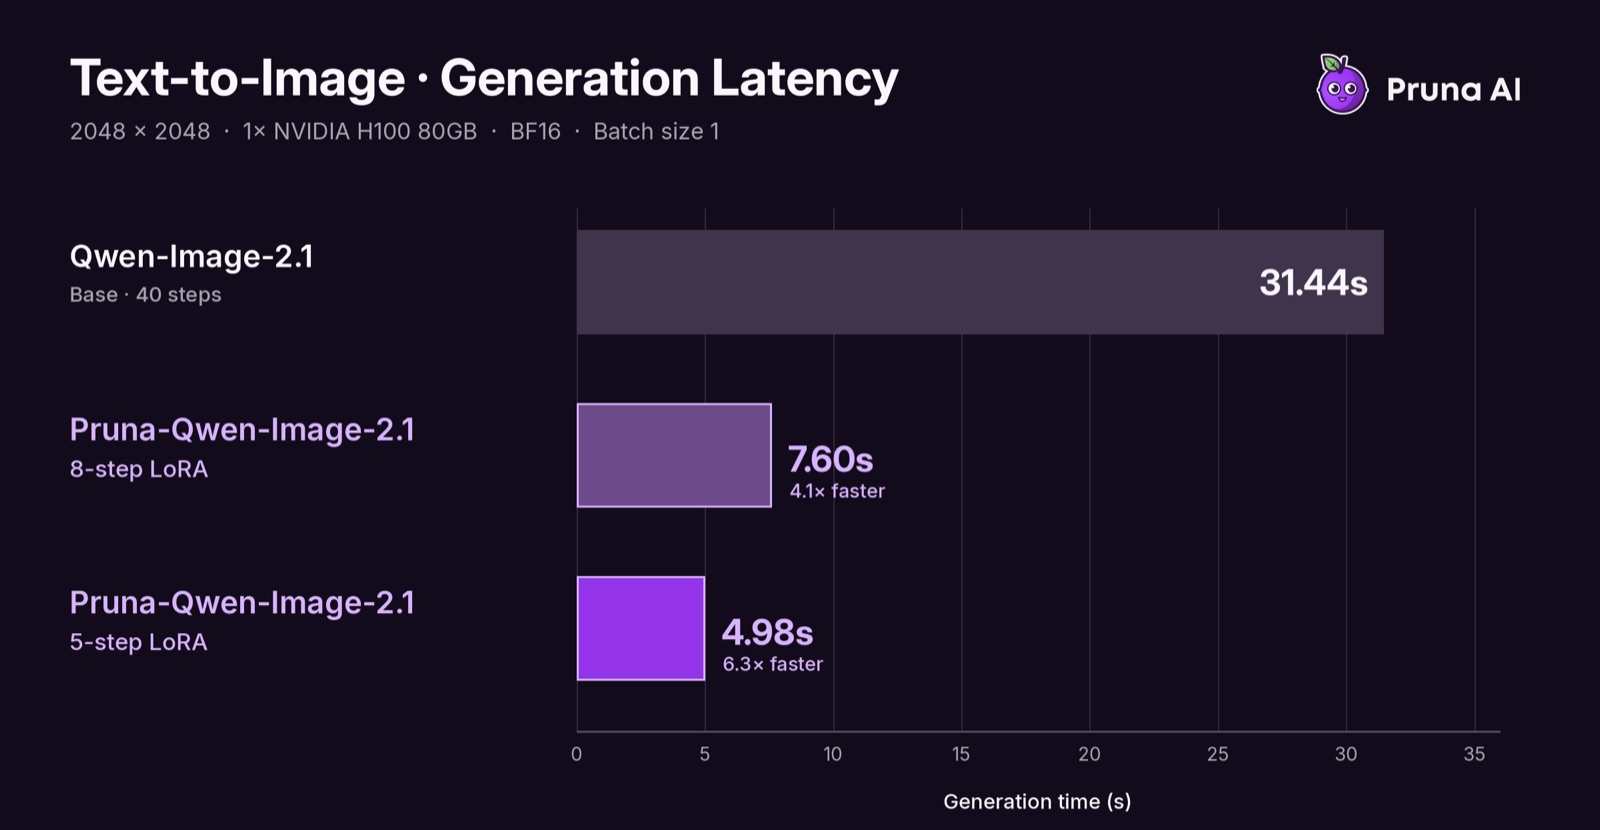
Texte-image en 2048, hors de la couverture d'entraînement 1K mais intégré aux mesures de latence publiées.
Les premiers tests viennent surtout de la communauté ComfyUI plutôt que de la publication elle-même : les adaptateurs ont été comparés au turbo de Viggle et aux LoRA Qwen Acc officiels dans le canal #qwen-image de Banodoco, où les testeurs ont particulièrement distingué l'adaptateur 8 étapes, et ils ont été publiés sur r/StableDiffusion et X peu après la mise en ligne des poids.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.