Direct3D-V3 : raffinement de maillage voxel sans latent dans ComfyUI
Direct3D-V3 raffine un maillage 3D grossier avec une diffusion voxel sans latent au lieu d'un VAE, et un pack de nœuds ComfyUI communautaire l'exécute désormais sur GPU Windows.
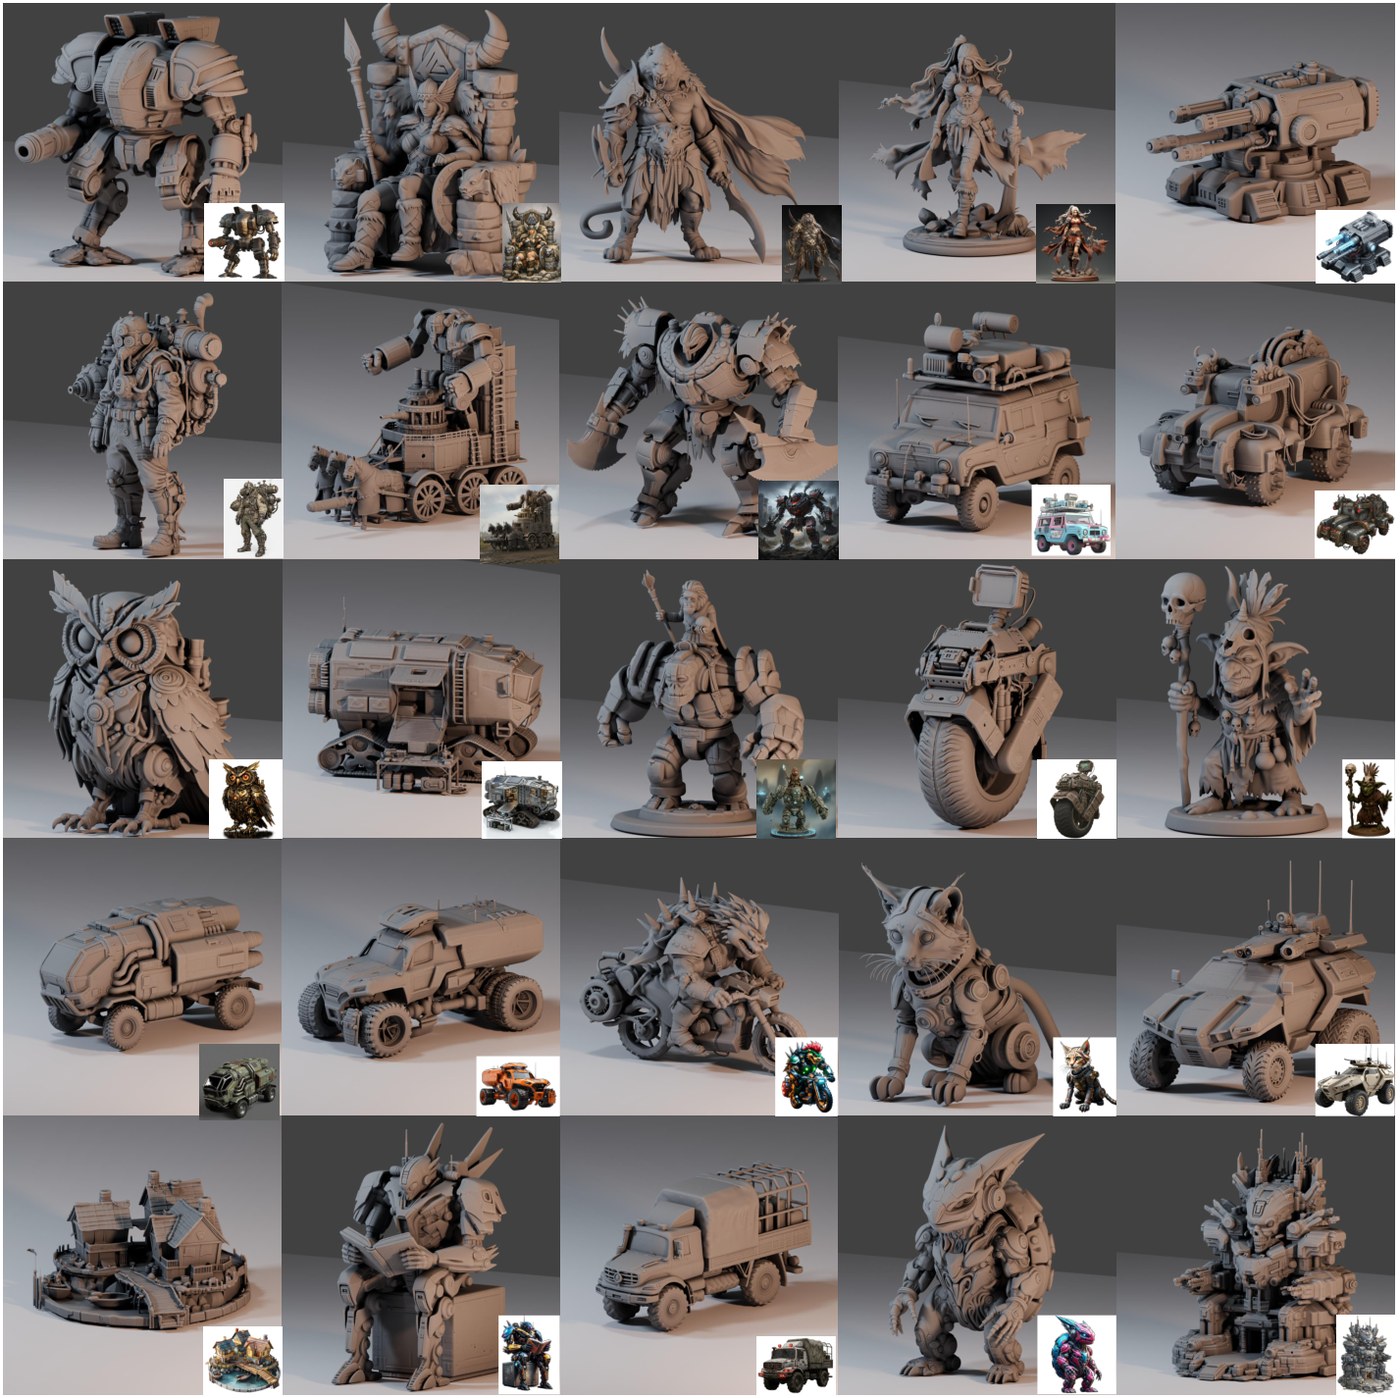
Maillages générés et détail de surface, issus des résultats supplémentaires du papier.
Ce qu'il fait
Fournissez-lui un maillage grossier dans la même orientation que votre image de référence, et il raffine la forme : gorges, chanfreins, structures fines et arêtes vives que l'étape grossière avait lissées. La régularisation implicite de variété garde les surfaces fermées. Le maillage est simplifié à 2 M de triangles par défaut (target_faces) et s'exporte en GLB.
L'argument du papier est que chaque chaîne image-vers-3D bâtie sur la diffusion latente jette deux fois la géométrie fine : une fois quand le VAE compresse la forme, et à nouveau parce que le VAE est entraîné pour la reconstruction tandis que le générateur est entraîné pour l'adéquation de distribution. Direct3D-V3 abandonne le VAE et modélise directement des grilles de voxels SDF brutes avec un transformer de diffusion, en ajoutant une régularisation de variété sur les voxels voisins ainsi qu'une tâche auxiliaire de prédiction de caméra pour que l'image de conditionnement s'aligne sur la géométrie générée.
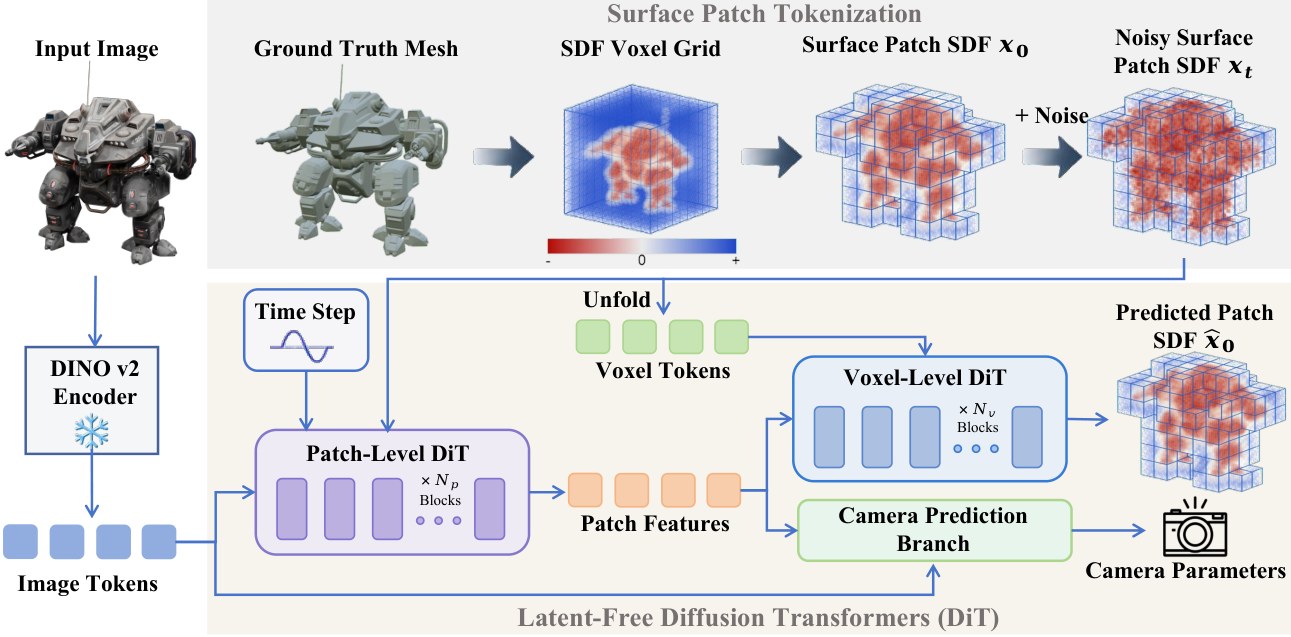
L'entraînement et l'échantillonnage se font sur la grille de voxels elle-même ; les maillages sortent via Marching Cubes.
Trois checkpoints sont fournis : 512, 1024 et 1536. Ils peuvent s'exécuter en cascade ou en une seule étape, et les valeurs de référence pour démarrer sont 15 étapes et CFG 4 en 512 et 1024.
L'exécuter dans ComfyUI
- Récupérez l'une des builds Windows depuis Direct3D-V3_Comfyui_Nodes (cu128 pour Python 3.12 et PyTorch 2.8, cu130 pour Python 3.13 et PyTorch 2.12.1) et extrayez le dossier dans
ComfyUI/custom_nodes. - Demandez l'accès à DINOv3 ViT-H+ sur Hugging Face. Le nœud l'utilise comme encodeur d'image, et l'installation demande un token de lecture.
- Lancez
setup.cmddans le dossier du nœud. Il construit un environnement Python privé.runtime, télécharge PyTorch, DINOv3 et le checkpoint 1536. Prévoir plusieurs Go d'espace disque est normal. - Ajoutez Direct3D-V3 Clean | Mesh File Path et Refine (Mesh File, Low VRAM), connectez le chemin du maillage, l'image de référence et un masque de premier plan, puis commencez avec
resolution = 1536etstage_mode = single_stage.
Les deux builds de nœuds sont autonomes : pas de CUDA Toolkit ni de Visual Studio, des voxelizers précompilés pour les séries RTX 20 à 50, et ComfyUI conserve son propre Python et PyTorch. L'attention est réglée par défaut sur efficient ; cudnn_fp16 est plus rapide en FP16 mais change l'arrondi, donc fixez la graine lorsque vous comparez les exports.
Ce que voient les testeurs
- MostAadTech, qui a construit le pack de nœuds, a exécuté l'étape 1536 avec 114 832 patchs de voxels à 6 008 Mio de VRAM réservée en pic et a terminé un dragon complet en 9 min 56 s avec le preset cuDNN, sans aucun rétrécissement.
- Une seconde exécution a rapporté 4,15 M de sommets / 8,3 M de triangles avec un prompt terminé en 325 s.
- Kijai a mesuré environ 4,9 Go de pic d'activations à environ 100 k tokens, dont environ 2 Go sont des tokens de saut qui restent résidents.
- Le pipeline complet réaliste est plus long que le raffineur seul : maillage grossier depuis Pixal3D ou TRELLIS.2, une normal map depuis Qwen-Image-2.1, puis Direct3D-V3, puis le texturage avec UltraTex.
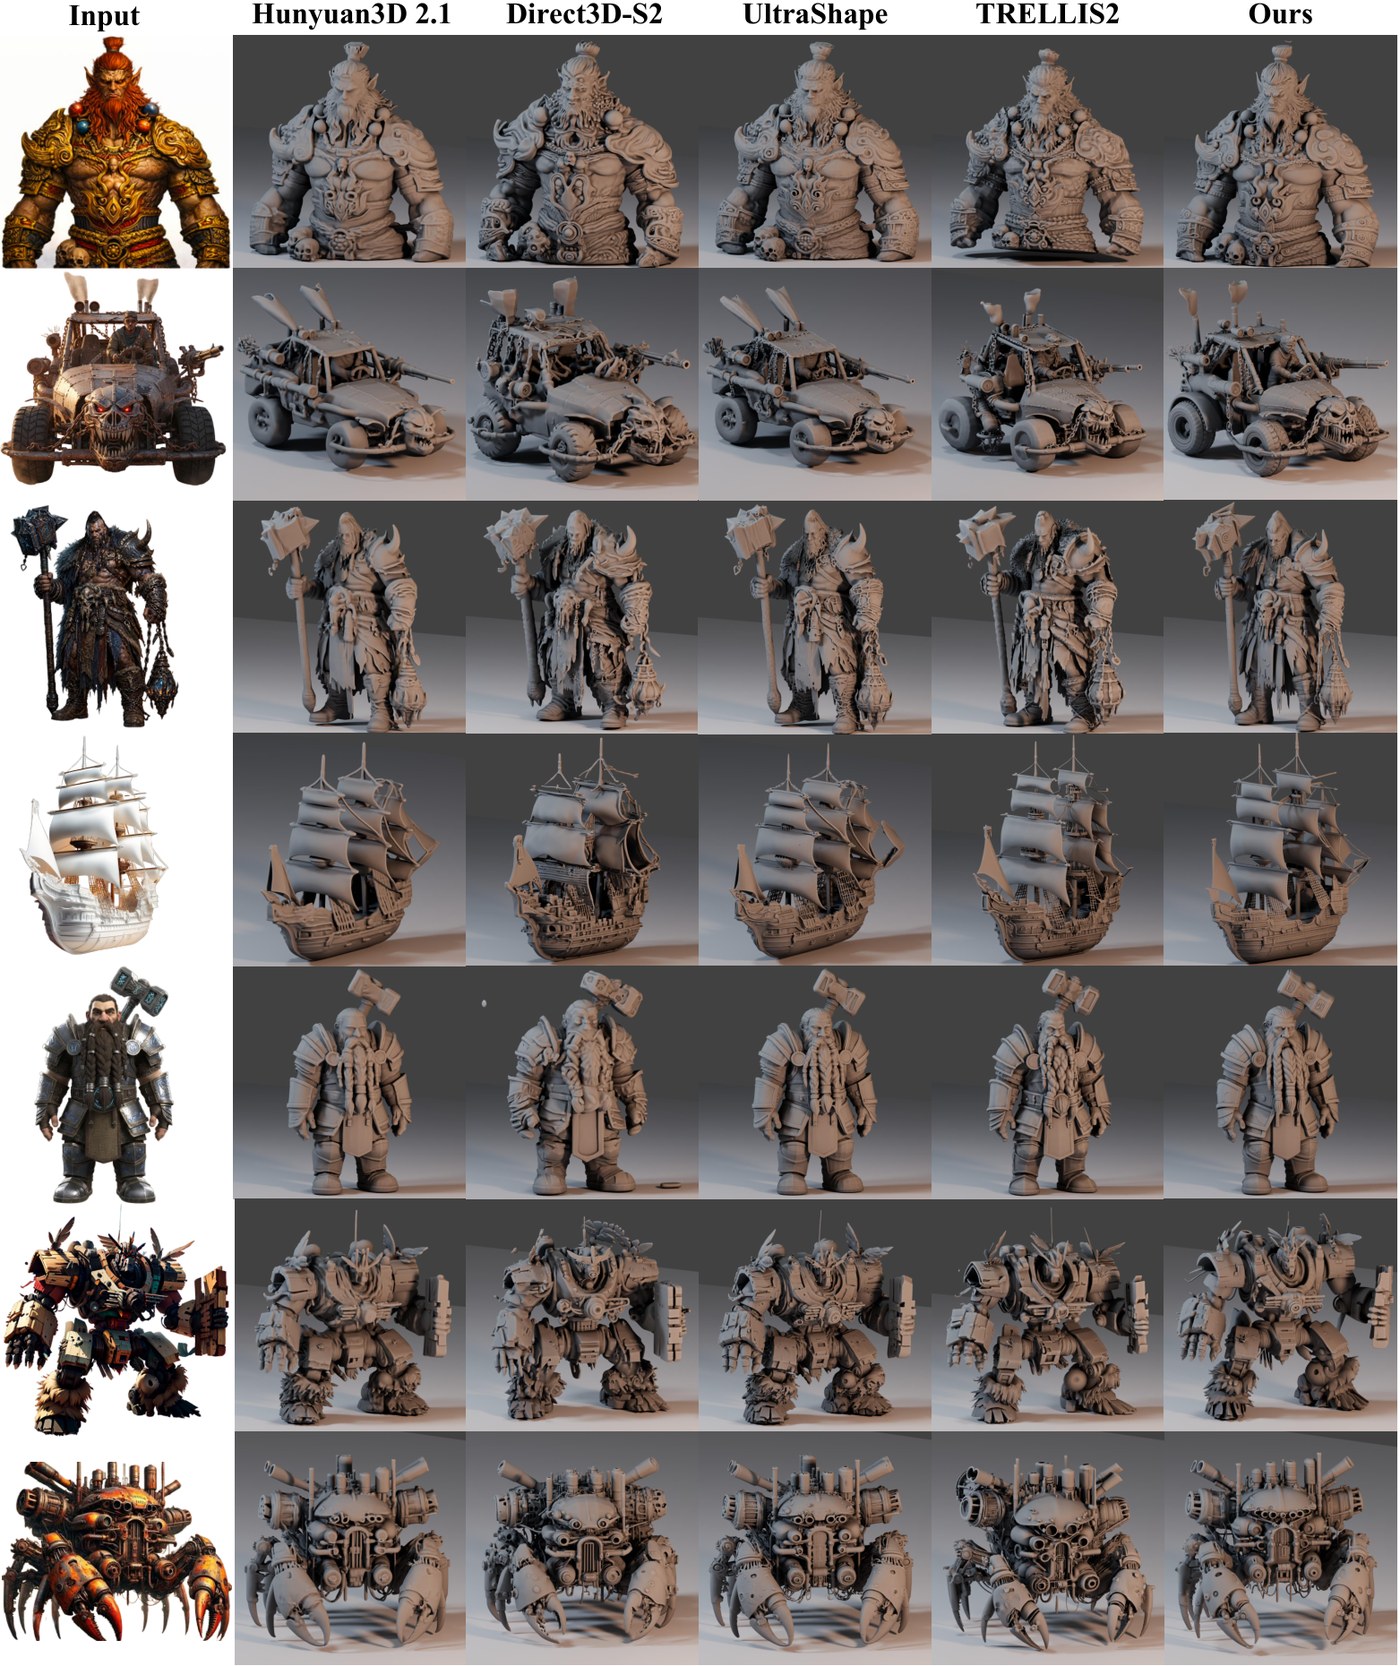
Comparaison qualitative avec d'autres méthodes image-vers-3D open source, issue du papier.
Avant de commencer
- Il n'y a pas d'étape grossière dans cette publication. Les auteurs renvoient vers Hunyuan3D-2.1 ou UltraShape-1.0 pour le maillage initial ; leurs propres modèles grossiers sont encore sur la liste des tâches à faire.
- L'image de référence compte plus que d'habitude. Une normal map de surface ou un rendu en argile blanc donne des détails nettement plus fins qu'une image RVB texturée. Le dépôt suggère ChatGPT (GPT Image 2.5) ou Lotus-2 pour cette conversion, et Qwen-Image-2.1 fonctionne comme option gratuite.
- Les poids publiés sont plus récents que le papier. Les auteurs indiquent que les checkpoints publiés utilisent quatre calques DINOv3 et l'optimiseur Muon, et produisent des surfaces plus fines que le modèle évalué dans le papier ; les figures du papier sous-estiment donc la sortie actuelle.
- Le code de texturage et d'entraînement n'est pas encore disponible. Seul le raffinement de maillage figure dans cette publication, la texture provient donc d'un modèle séparé.
L'obtenir
- Poids : wushuang98/Direct3D-V3 (checkpoints des étapes 512, 1024 et 1536)
- Code officiel, démo Gradio et exemples d'inférence : DreamTechAI/Direct3D-V3
- Papier : SIGGRAPH Asia 2026, arXiv 2611.26511 avec les résultats sur la page du projet
- Adaptateur ComfyUI (Windows) : Mstafa-awad/Direct3D-V3_Comfyui_Nodes
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.