L'extenseur Gemma-4 de Wuli pour MiniMax H3 dans ComfyUI
Wuli-Art a affiné Gemma-4-12B en un extenseur de prompt pour MiniMax H3 : un seul jeu de poids pour FL2VA et Ref2VA, fp8 à 13 Go, avec deux flux de travail ComfyUI.
Wuli-Art a publié Gemma4-for-MiniMax-H3-Prompt-Extend le 2026-11-16 : un fine-tune de Gemma-4-12B qui réécrit une idée simple en le prompt audiovisuel attendu par MiniMax H3. Il est livré en poids bf16, fp8 et int8, avec deux flux de travail ComfyUI, et ces graphiques n'utilisent que des nœuds de base.
Ce qu'il fait
Un prompt H3 est un bloc unique qui doit porter le plan, l'action dans le temps, le mouvement de caméra et l'univers sonore. L'écrire à la main est la partie lente. Ce modèle l'écrit à partir de votre phrase, plus les images ou références que vous avez déjà chargées.
Un seul jeu de poids sert les deux formats d'entrée : inutile d'avoir un extenseur différent pour le travail sur première/dernière image et pour le travail par référence.
| Format d'entrée H3 | Couvre | Ce que l'extenseur ajoute |
|---|---|---|
| FL2VA | T2VA, I2VA, L2VA, FL2VA | scène, action, mouvement de caméra, son, contraintes d'images |
| Ref2VA | génération conditionnée par référence | définitions des sujets, rôles des références, ce qu'il faut conserver |
Comment l'exécuter
- Placez
gemma4_12b_h3_pe_fp8_scaled.safetensors(13,0 Go) ou le fichier int8 dansComfyUI/models/text_encoders/. Le fichier bf16 fait 23,9 Go. - Glissez le flux de travail correspondant sur la toile : FL2VA ou Ref2VA. Ce sont des alternatives, pas deux étapes.
- Pointez les chargeurs UNET, text encoder, VAE et LoRA vers vos propres fichiers H3, écrivez le prompt, lancez. La sortie est du texte, que vous alimentez ensuite à votre graphique H3 habituel.
Prérequis de version : une version de ComfyUI prenant en charge TextGenerateV2 et l'encodeur de texte Gemma-4. La v0.46.0 dispose des deux.
Téléchargements
| Fichier | Taille | Emplacement |
|---|---|---|
gemma4_12b_h3_pe_fp8_scaled.safetensors | 13,0 Go | models/text_encoders/ |
gemma4_12b_h3_pe_int8.safetensors | 13,0 Go | models/text_encoders/ |
gemma4_12b_h3_pe_bf16.safetensors | 23,9 Go | models/text_encoders/ |
Comparé aux autres rédacteurs de prompts
La démo de la carte du modèle exécute cinq réglages sur les mêmes entrées : sans extension, Gemma-4-12B seul, le PE officiel de MiniMax, le réécrivain de lightx2v et ce modèle. Le cas 04 part d'une phrase chinoise de 31 caractères sur deux grues qui se battent, plus une première image.
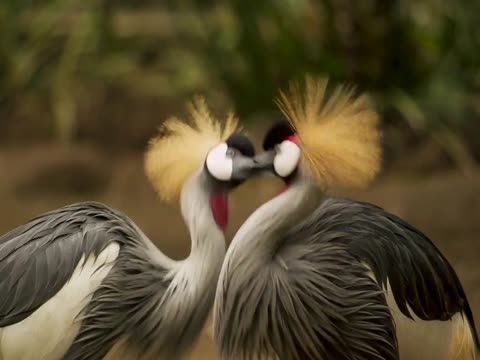 | 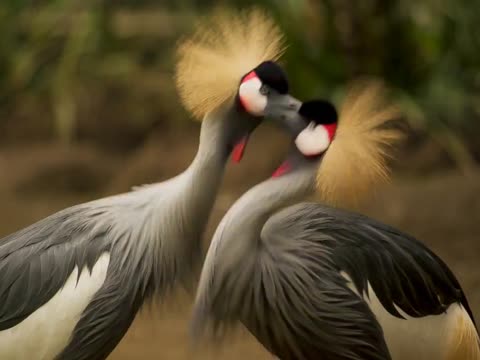 | 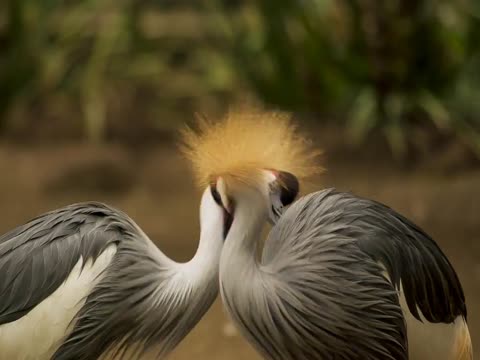 |
|---|---|---|
| Sans extension | PE officiel MiniMax | Extenseur Gemma-4-12B |
La longueur est la différence visible. Sur ce cas, la base Gemma-4 simple a écrit 1 097 caractères, le réécrivain de lightx2v 1 180, ce modèle 2 102 et le PE officiel 4 296.
Un échantillon de 5 secondes en 1024×768 généré à partir du prompt de cet extenseur.
Disponibilité
- Poids : Hugging Face · ModelScope
- Comparaison à cinq voies de 45 clips : page de démo Wuli
- Version H3 antérieure de Wuli-Art : MiniMax-H3-Turbo
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.