ComfyUI ajoute un nœud Video Deflicker pour les upscales
Le cœur de ComfyUI intègre le nœud Video Deflicker de Kijai : il supprime le scintillement des vidéos traitées image par image grâce à un flux RAFT natif 2,3x plus rapide.
Le cœur de ComfyUI s'est enrichi d'un nœud Video Deflicker : donnez-lui des images qui scintillent après un traitement image par image, comme un upscale frame par frame, et il rapproche chaque image de ses voisines tout en conservant son propre niveau de détail. Il a été intégré via la PR #17754 de Kijai, fusionnée le 15 novembre. Le seul fichier supplémentaire nécessaire est le checkpoint RAFT-large de torchvision, à placer dans ComfyUI/models/optical_flow/.
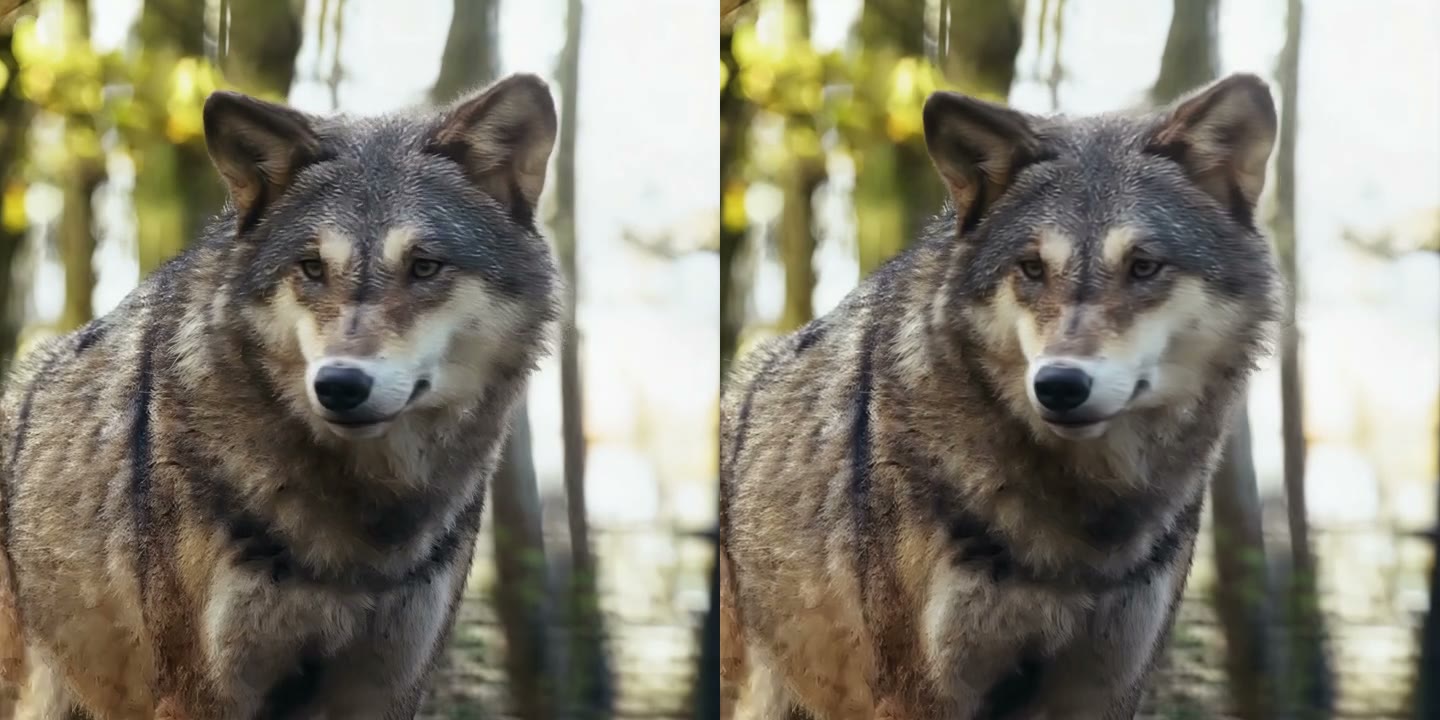
Gauche : un clip traité image par image. Droite : le même clip après Video Deflicker. Source : Comfy-Org/ComfyUI #17754
Les deux clips côte à côte, 53 images chacun, réencodés à 720 px par panneau.
Ce qu'il corrige
- Les upscales et les retouches image par image, où chaque image est traitée séparément et où les petites différences entre elles se lisent comme du scintillement.
- Fournir la source propre en tant que
guideest ce qui fait bien fonctionner le nœud : il lit le mouvement sur ces images stables plutôt que sur les images scintillantes. Sans guide, il utilise les images d'entrée et corrige moins. - Les vrais changements sont préservés.
thresholdconsidère comme réelles les différences par rapport à l'image voisine compensée en mouvement, de sorte qu'une coupe ou un geste rapide n'est pas lissé.
Comment l'utiliser
- Téléchargez
raft_large.pth(RAFT-large de torchvision, 21 Mo) depuis download.pytorch.org dansComfyUI/models/optical_flow/. ComfyUI ne télécharge jamais lui-même les poids de flux optique. - Ajoutez Load Optical Flow Model et sélectionnez
raft_large.pth. - Ajoutez Video Deflicker (catégorie
video) et connectez le modèle de flux, les images scintillantes et les images sources propres àguide.
| Entrée | Valeur par défaut | Ce qu'elle fait |
|---|---|---|
optical_flow | requis | RAFT-large fourni par Load Optical Flow Model |
images | requis | les images scintillantes |
guide | images | images stables à partir desquelles lire le mouvement, à n'importe quelle résolution |
strength | 1.0 | à quel point chaque image suit ses voisines ; une valeur plus élevée lisse davantage les détails fins |
direction | bidirectional | moyenne une passe avant et une passe arrière ; forward prend la moitié du temps |
threshold | 0.1 | les changements au-dessus de cette valeur restent nets ; 0 lisse tous les changements de la même manière |
Le flux est calculé au maximum en 768x768 en interne : un guide en 4K est donc réduit pour l'estimation du mouvement, et seule la résolution du solve s'exécute en pleine résolution.
Un RAFT plus rapide dans le cœur
La même PR a remplacé le raft_large de torchvision par une implémentation native : des réseaux en fp16 avec une corrélation en fp32, et la boucle de mise à jour s'exécute comme un graphique CUDA sous VRAM dynamique. C'est environ 2,3x plus rapide que la version torchvision en 1024x576. Les nœuds VOID de bruit warped l'utilisent désormais aussi.
Disponibilité
Le nœud est présent dans la branche principale depuis la fusion du 15 novembre. La dernière version étiquetée, v0.45.0 (10 novembre), est antérieure, donc utilisez une build nocturne jusqu'à la prochaine version.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.