TaoMate-FVSR restaure les visages des vidéos IA grâce à l'audio
TaoMate-FVSR reconstruit les bouches floues d'une vidéo générée grâce à la piste audio, resynchronise les lèvres pour le doublage et fournit des nœuds ComfyUI.
comfyui avec des nœuds, quatre flux de travail d'exemple et un téléchargeur de modèles : il fonctionne donc dans ComfyUI sans checkpoint converti.
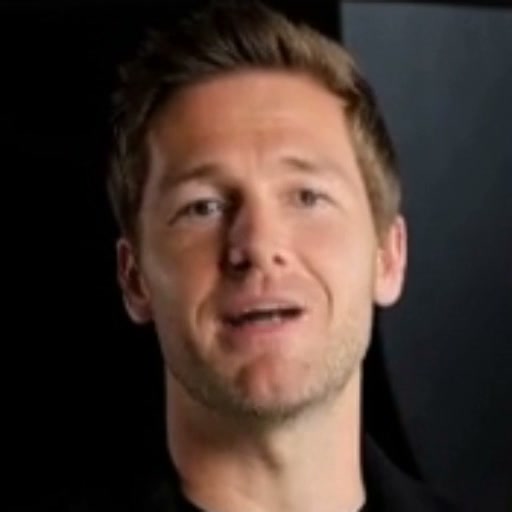
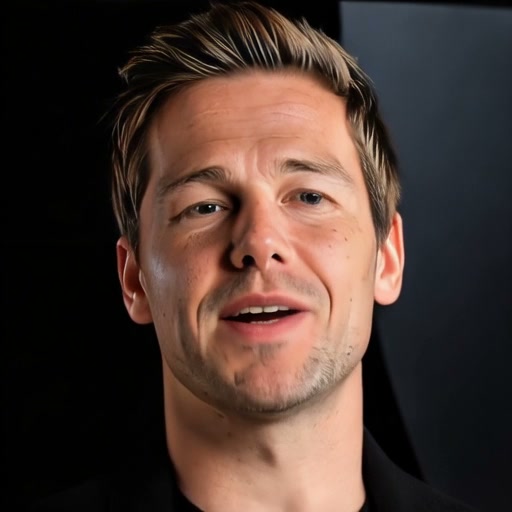
Il cible la défaillance typique de la vidéo générée : le visage est rendu de façon molle, les dents fusionnent en un flou blanc et la bouche ne suit pas la ligne. Améliorer ce qui est présent conserve la forme brisée ; régénérer le visage change l'identité. TaoMate-FVSR fait les deux à la fois, en utilisant l'audio pour piloter la bouche, une image de référence pour maintenir l'identité et les images précédemment générées pour garder le plan stable.
 |  |
|---|---|
| Découpe du visage en entrée, 512×512 | Sortie de TaoMate-FVSR, même image |
Le clip avant/après synchronisé du projet, découpes de visage à 25 fps.
Ce qu'il fait à un clip
- Mode scène complète. Il découpe la tête, la restaure, puis mélange la couleur et le masque et la recolle. La sortie conserve la résolution, la fréquence d'images et l'audio de la source, ce qui s'intègre directement dans un montage existant.
- Doublage visuel. Fournissez-lui un discours de remplacement au lieu de la piste originale et la bouche est resynchronisée sur cet audio.
- Image de référence. Par défaut, la première image passe une fois par GPEN pour construire la référence d'identité. Vous pouvez aussi fournir votre propre première image retouchée, ce que fait la variante « Ours+ » de l'article avec une image améliorée par GPT-Image : peau et détails plus beaux, mais pixels plus éloignés de la vérité terrain.
Sur son benchmark de 150 clips de tête parlante, il obtient les meilleurs LPIPS (0,0793) et DISTS (0,0858) parmi les références de restauration auxquelles il se compare, ainsi que le meilleur score de synchronisation labiale (Sync-C 7,413). Une réserve à connaître avant de juger les chiffres : la variante basée sur l'amélioration obtient un PSNR plus faible (23,52) tout en obtenant le meilleur score de qualité perceptuelle (MUSIQ 77,62) ; « restauré » et « fidèle à la vérité terrain » ne sont donc pas la même chose ici.
L'exécuter dans ComfyUI
- Dans
ComfyUI/custom_nodes, clonez la branchecomfyui:git clone --depth 1 --single-branch --branch comfyui https://github.com/TaoLiveAIGC/TaoMate-FVSR.git ComfyUI-TaoMate-FVSR - Installez ses exigences avec le Python de ComfyUI, en conservant la version de PyTorch CUDA existante.
- Récupérez les fichiers de modèle :
python scripts/download_models.py --dest ../../models/TaoMate-FVSR --gpen-source-dir ../../models/TaoMate-GPEN-source. Le script vérifie les tailles et les SHA256, et reprend les téléchargements partiels. - Ouvrez l'un des quatre flux de travail d'exemple.
yolo-gpen-workflowest le parcours scène complète avec découpe automatique du visage ;cropped-face-workflowpart de visages 512×512 préparés.
Prévoyez environ 14,89 Go de fichiers de modèle et de configuration, et 32 Go de mémoire système sur le clip le plus long testé. La cible de 16 Go de VRAM est mesurée sur un H20 avec un plafond de mémoire, pas sur une carte grand public, et le fonctionnement en 8/12 Go n'a pas été testé. Linux, Python 3.10 et PyTorch 2.9 constituaient la configuration validée ; les chemins Windows sont documentés mais non vérifiés.
1× ou 2×
Le modèle fonctionne à deux échelles. 1× conserve la découpe du visage en 512×512 et correspond au réglage par défaut ; 2× fonctionne en 1024×1024 pour plus de détails et exige plus de VRAM, le résultat étant ramené à 512×512 avant le collage. Les valeurs par défaut se trouvent dans config.json : 10 étapes, bruit 0,8, shift 5.0, guidage audio 4.0, guidage de référence 1.7, graine 42.
Disponibilité
- Poids : TaoLiveAIGC/TaoMate-FVSR, un seul
TaoMate-FVSR.safetensorsplusconfig.json. - Code et nœuds ComfyUI : TaoLiveAIGC/TaoMate-FVSR, avec le guide d'installation en anglais et en chinois.
- Article : arXiv 2611.03393 ; davantage de comparaisons sur la page du projet.
La branche ComfyUI est étiquetée expérimentale : l'installation est manuelle, elle n'est pas enregistrée dans ComfyUI Manager et elle réutilise les poids d'origine plutôt que de fournir un checkpoint spécifique aux nœuds.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.