LongCat Video Avatar 1.6 : un avatar parlant au-delà de 10 minutes
LongCat Video Avatar 1.6 transforme une photo et une piste audio en vidéo d'avatar synchronisée au-delà de dix minutes, avec un chemin en 8 étapes et des poids INT8.
Images issues des clips d'aperçu de la 1.6 : un portrait et une piste audio.
Ce qui change dans la 1.6
| Domaine | 1.6 |
|---|---|
| Mouvement des lèvres et de la bouche | moins de formes de bouche crispées ou trop rouges, moins de scintillement dans la zone de la bouche |
| Clips longs | accumulation d'erreurs autoregressives réduite, les vidéos peuvent dépasser 10 minutes tout en conservant l'identité et la structure du corps |
| Vitesse | optimisations du pipeline de bout en bout et de l'exécution image par image, aucun nouveau modèle à apprendre |
| Déploiement | DiT INT8 en poids uniquement en option, plus un indicateur FP8 pour Transformer Engine |
La 1.6 repose sur la même architecture de base que la 1.5 et conserve la pile de deux adaptateurs : un LoRA DMD pour les premières passes et un LoRA OPSD pour les suivantes, mélangés à chaque étape. Avec la configuration par défaut en 8 étapes, les quatre premières étapes utilisent uniquement DMD et les quatre dernières uniquement OPSD ; augmentez --mix_steps ou --mix_alpha pour donner plus d'influence à DMD au début.
Voir en vidéo
Un test de continuation issu de la carte du modèle, où le clip continue au lieu de se dégrader.
Au-delà de la parole : le modèle anime aussi le chant et la performance à partir de l'audio seul.
Comparaison
Meituan a organisé une arène de 33 051 votes humains par paires sur 15 appariements de modèles. La 1.6 termine deuxième derrière OmniHuman-2.0, et sa marge sur la 1.5 est faible : 16 Elo.
| Rang | Modèle | Elo de l'arène |
|---|---|---|
| 1 | OmniHuman-2.0 (fermé) | 1236.7 |
| 2 | LongCat-Video-Avatar 1.6 (ouvert) | 1068.1 |
| 3 | LongCat-Video-Avatar 1.5 (ouvert) | 1051.8 |
| 4 | HeyGen (fermé) | 906.4 |
| 5 | OmniHuman-1.5 (fermé) | 880.6 |
| 6 | Kling Avatar 2.0 (fermé) | 854.7 |
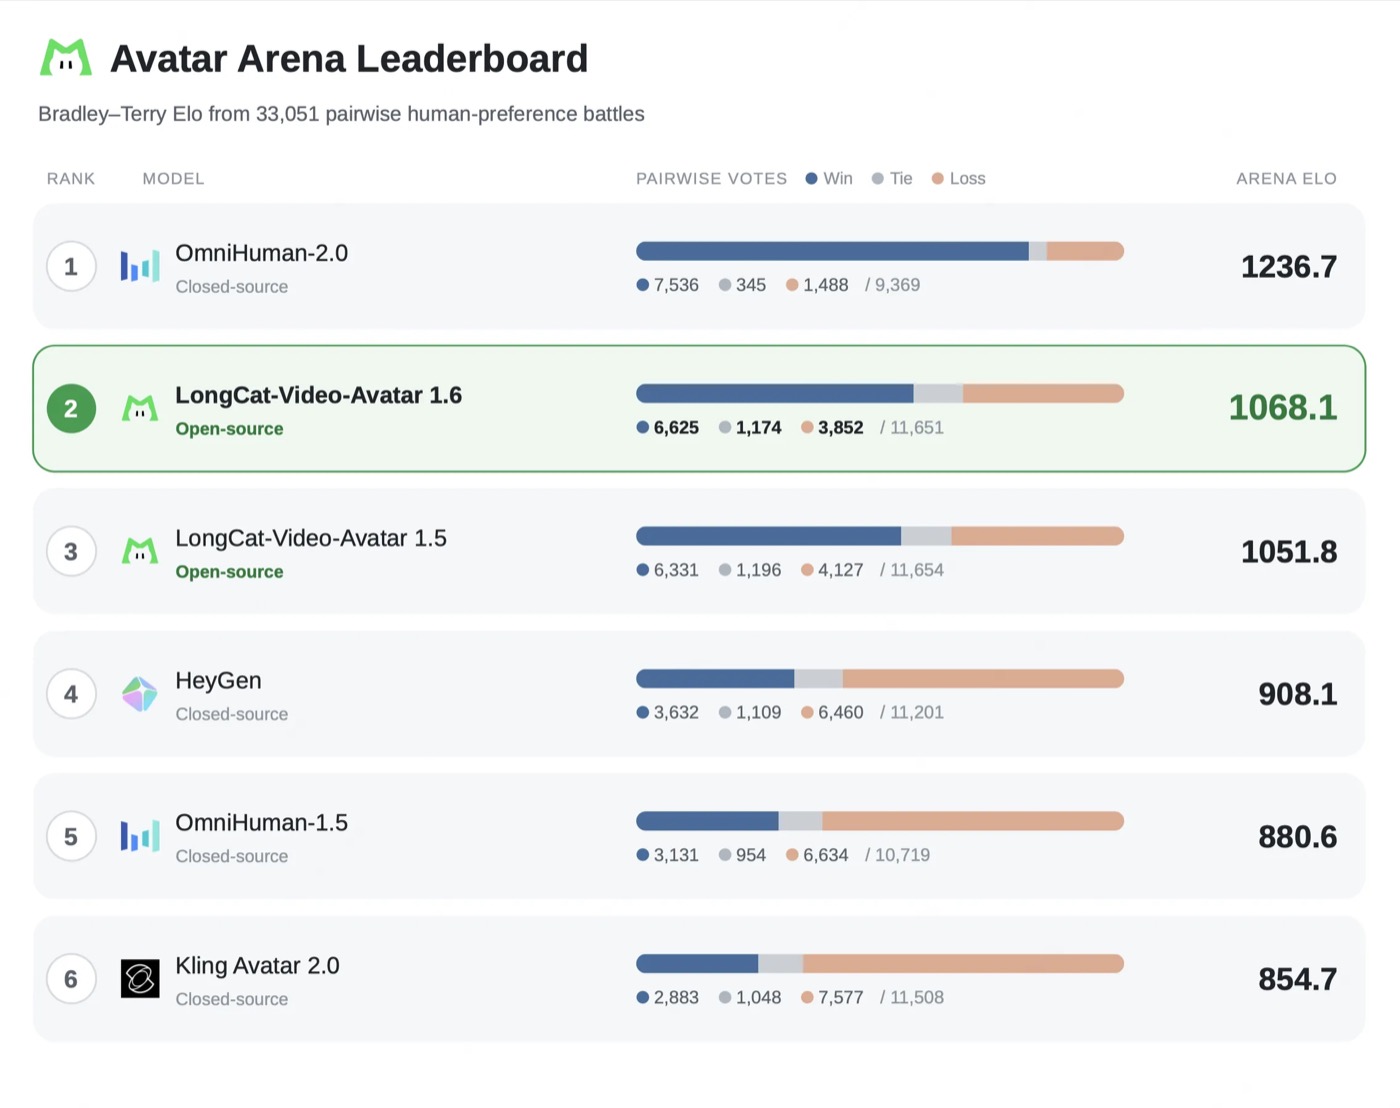
Le classement tel que publié dans la carte du modèle 1.6.
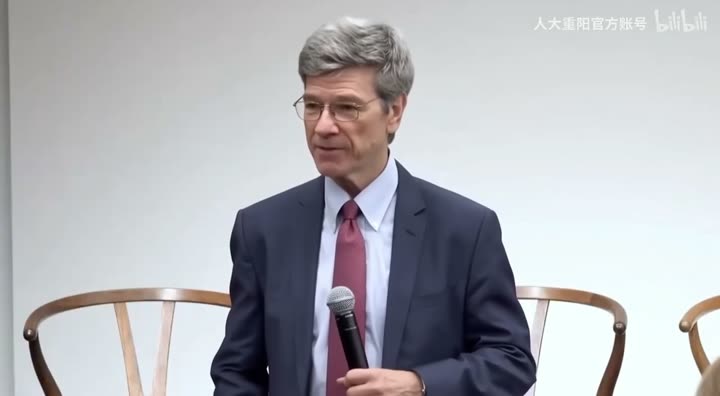
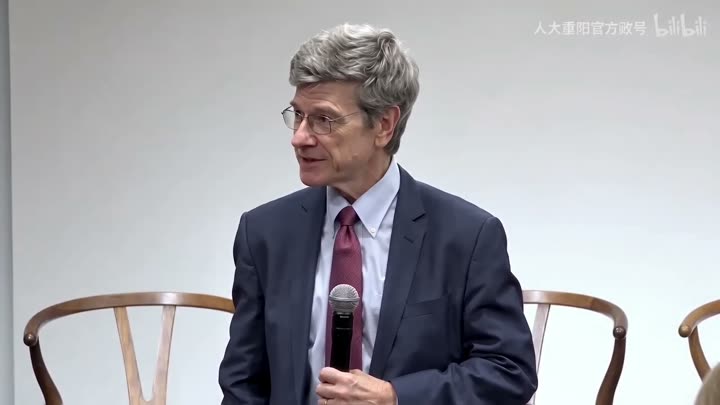
Même entrée, trois systèmes, une image chacun :
| LongCat-Video-Avatar 1.6 | OmniHuman-2.0 | HeyGen |
|---|---|---|
 |  |  |
Ce qu'il faut pour l'exécuter
- Le DiT en BF16 fait environ 30 Go répartis sur six shards ; le DiT INT8 optionnel fait tomber cela à environ 15 Go.
- Les deux LoRA font 2,35 Go chacun, et le dépôt inclut son encodeur audio Whisper-large-v3 et un séparateur de voix.
- Les commandes de démo officielles utilisent
torchrunsur deux GPU avec parallélisme de contexte. Au-delà de deux GPU, un espace de travail All-to-All est activé viaLONGCAT_A2A_WORKSPACE=1. - Ne combinez pas
--use_int8avec--use_fp8. FP8 nécessite Transformer Engine, et--compile_ditentraîne un coût de traçage lors de la première exécution de chaque forme d'entrée.
Statut dans ComfyUI
Le support ComfyUI s'arrête toujours à la 1.5. Le pack communautaire ComfyUI-LongCat-Avatar (★43) n'a pas été mis à jour pour le nouveau checkpoint, il n'existe donc pas encore de chemin de nœuds pour la 1.6. En attendant, la 1.6 passe par le pipeline Python officiel.
Disponibilité
- Poids : meituan-longcat/LongCat-Video-Avatar-1.6
- Page du projet avec les vidéos de comparaison complètes : LongCat-Video-Avatar 1.6
- Code d'inférence et Rapport technique : meituan-longcat/LongCat-Video
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.