ComfyUI v0.45.0 double la vitesse de génération de texte de Qwen3.x
ComfyUI v0.45.0 réécrit la génération de texte Qwen3.x : Qwen3.5 9B passe de 106 à 219 tokens/s sur une RTX 5090, grâce au MTP arborescent adaptatif et à l'attention INT8.
L'amélioration de prompt, la légendation d'images et l'écriture d'histoires dans ComfyUI relèvent toutes de la génération de texte : elles bénéficient donc de l'accélération gratuitement. La seule chose à configurer est l'option mtp du nœud Generate Text, qui reste sur auto par défaut.
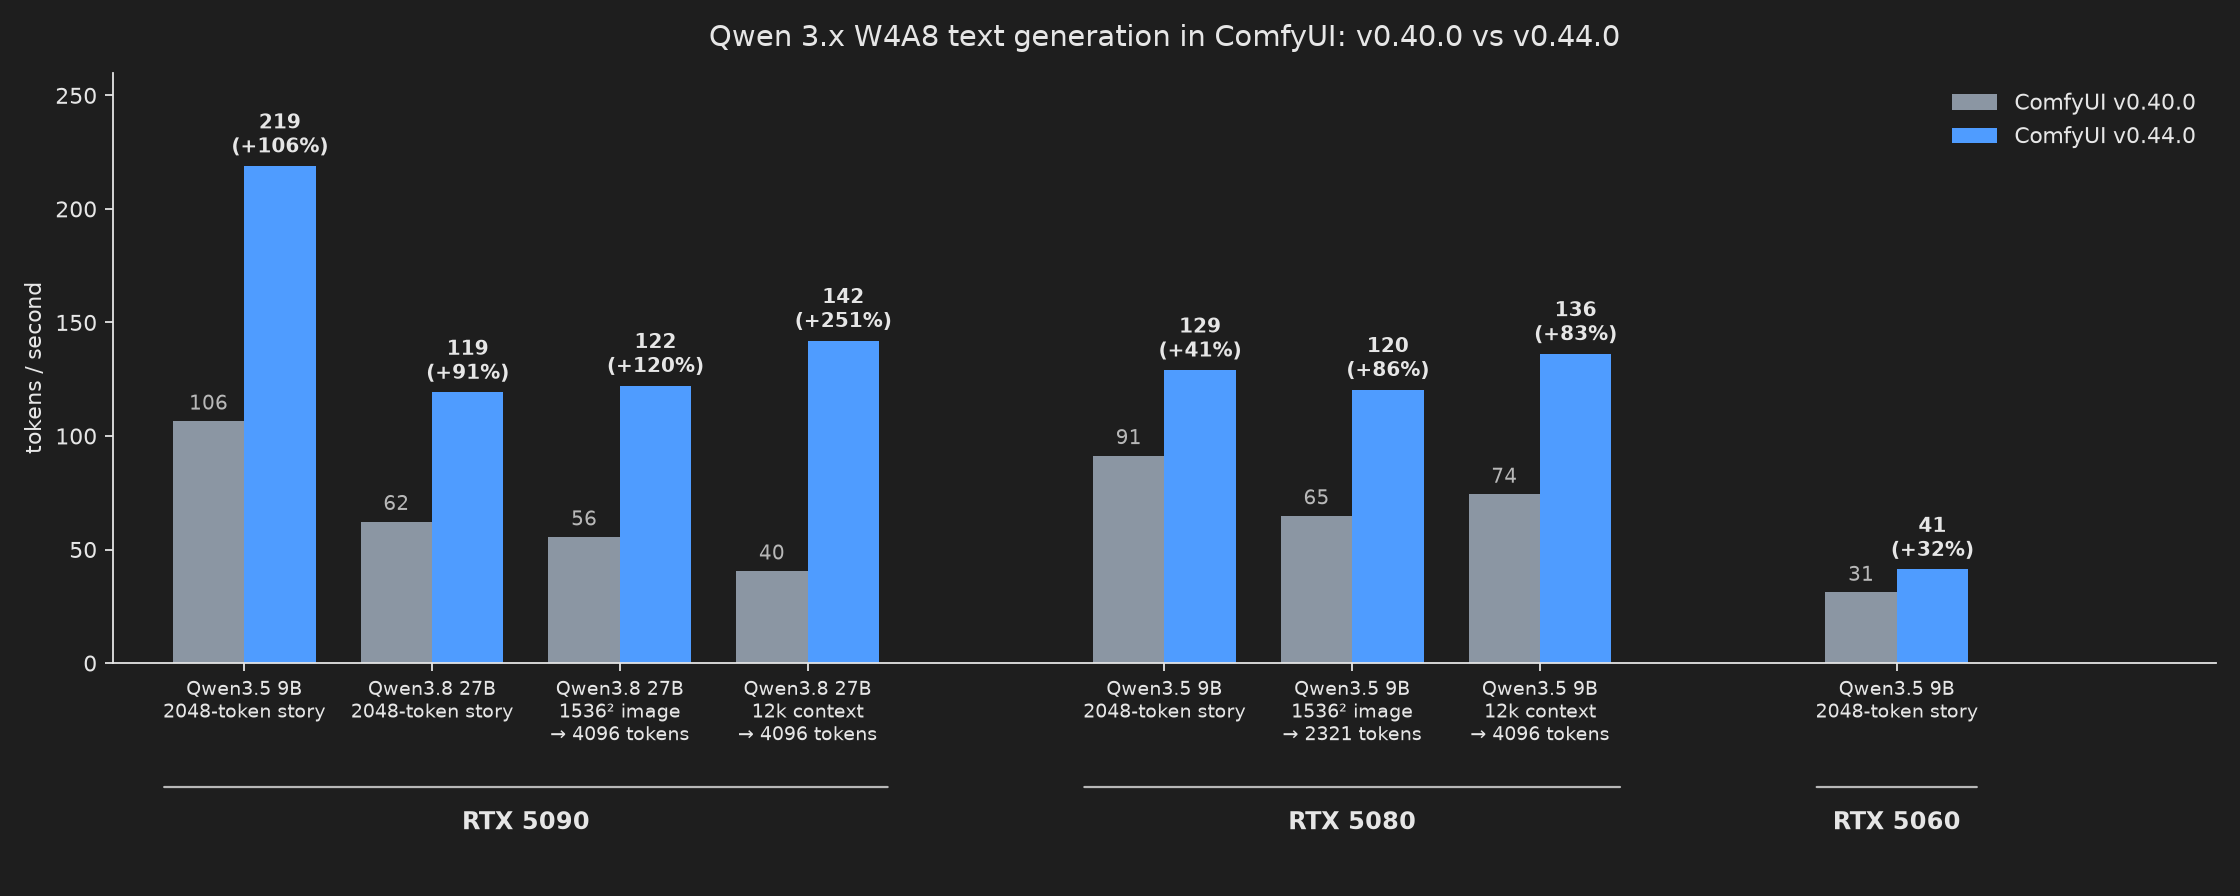
Extrait de l'article d'ingénierie de Comfy-Org annonçant la réécriture.
Débits de tokens mesurés
| Checkpoint | GPU | AVANT | v0.45.0 |
|---|---|---|---|
| Qwen3.5 9B | RTX 5090 | 106 tok/s | 219 tok/s |
| Qwen3.5 9B | RTX 5080 | 91 tok/s | 129 tok/s |
| Qwen3.8 27B, décrivant une image 1536×1536 | RTX 5090 | 55 tok/s | 122 tok/s |
Qwen3.8 27B W4A8 a atteint 137 tokens par seconde sur une RTX 5090 en décrivant une image 1500×1500 et en écrivant une histoire.
Ce qui a changé
- Noyau matrice-vecteur : les poids W4A8 et W6A8 sont désormais entrelacés avec leurs échelles par groupe dans l'ordre dans lequel le noyau les lit, de sorte que chaque bloc de threads lit une plage contiguë au lieu de sauter entre deux tenseurs. La réorganisation a lieu une seule fois par chargement de modèle, dans la VRAM, sans coût supplémentaire en RAM ou en VRAM.
- MTP arborescent adaptatif : la tête de prédiction multi-tokens ne propose plus une simple chaîne de suppositions. Elle conserve les tokens arrivés en deuxième position comme frères, vérifie jusqu'à huit lignes en une seule passe et replanifie la forme de l'arbre tous les 32 pas. Le code, les listes et les prompts réutilisés dans la sortie récompensent la profondeur ; l'écriture créative récompense la largeur.
- Attention Comfy-Kitchen : attention INT8 et prise en charge du cache KV pour le chemin d'attention du LLM, ce qui réduit l'utilisation de VRAM du cache KV et accélère le prefill sur les prompts longs et les prompts système.
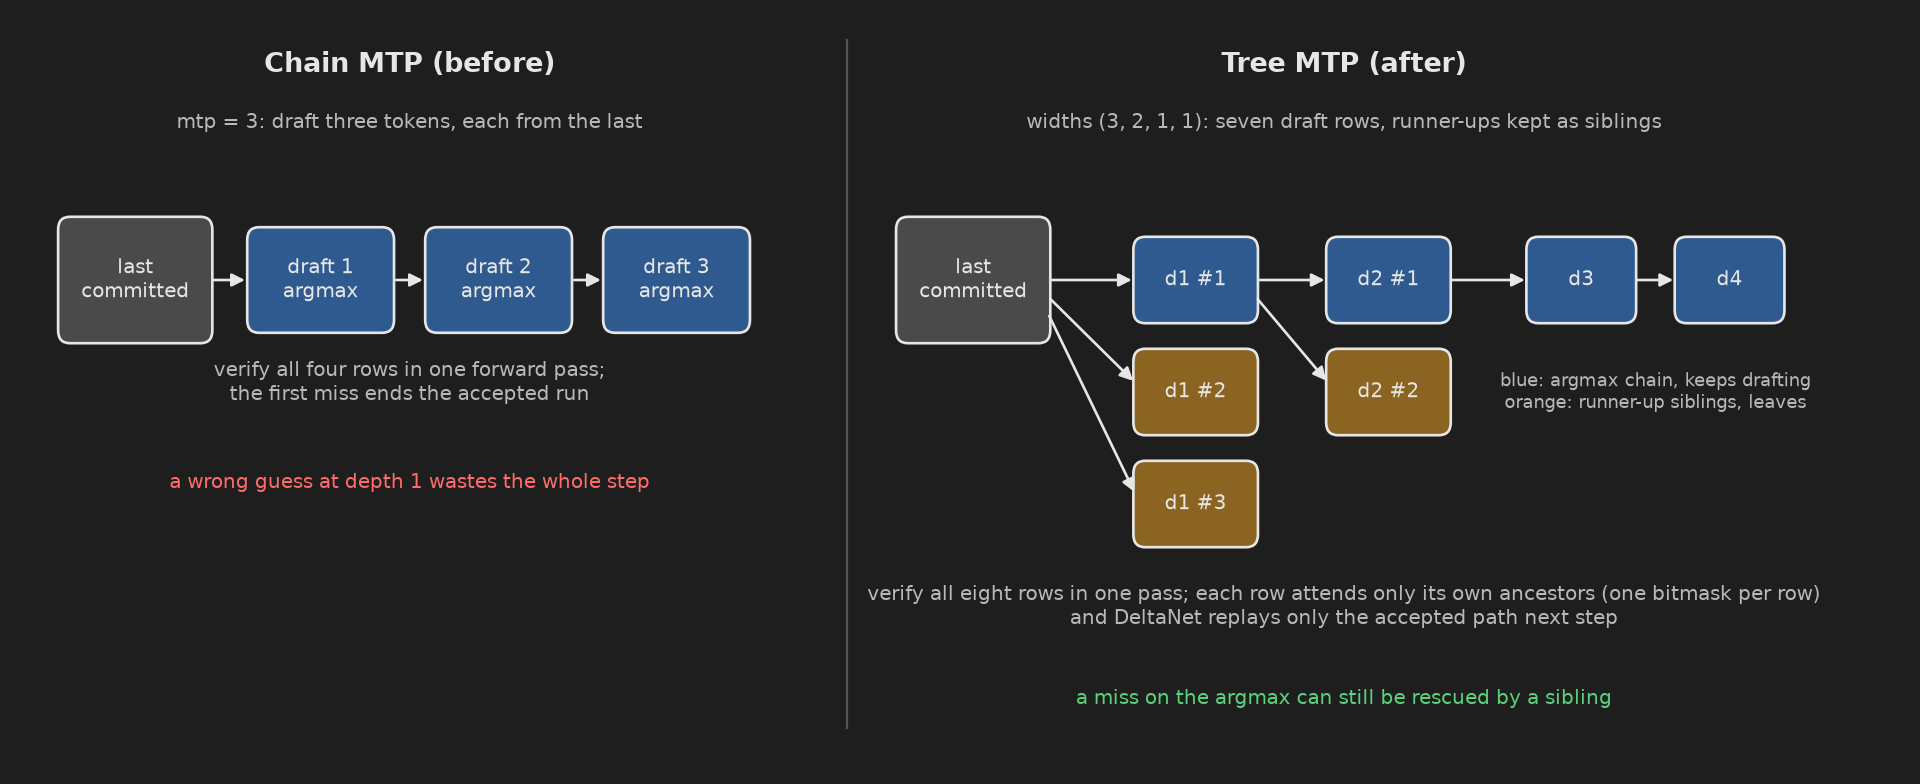
Le MTP en chaîne propose un seul chemin ; le MTP arborescent conserve les tokens arrivés en deuxième position comme frères et les vérifie ensemble.
Comment l'activer
- Mettez à jour vers ComfyUI v0.45.0 ou une version plus récente.
- Chargez un checkpoint Qwen3.x et exécutez-le via le nœud
Generate Text. - Laissez
mtpsurauto. Les valeurs épinglées2à5fixent toujours la profondeur de brouillon, et les modestree*fixent à la fois la largeur et la profondeur. - Facultatif : démarrez ComfyUI avec
--use-ck-attentionpour l'attention Comfy-Kitchen. Cela nécessite une version de Comfy Kitchen incluant la prise en charge de l'attention.
Tout ce qui précède fonctionne sur les GPU NVIDIA et AMD, sous Windows et Linux, et les contextes plus longs qui manquaient de mémoire tiennent désormais. Un détail issu de l'infobulle du nœud : la sortie MTP reste correctement distribuée mais diffère de la sortie non MTP pour la même graine.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.