WeVisOne-VL dans ComfyUI : boîtes, masques et mattes en une invite
WeVisOne-VL de Tencent tourne désormais dans le cœur de ComfyUI. Un nœud Detect transforme une requête texte en boîtes, masques, mattes alpha, points, comptages et boîtes OCR.
WeVisOne-VL est le modèle de vision de Tencent WeChat Vision, et il fonctionne désormais dans le cœur de ComfyUI. La prise en charge est arrivée le 2026-11-09 avec la PR 17632. Vous lui donnez une image et une phrase, il renvoie des boîtes, des masques, des mattes alpha, des points, un comptage ou des boîtes OCR. Pas de SAM, pas de nœuds personnalisés, pas de backend de segmentation séparé.
Les checkpoints 2B et 4B sont des fine-tunes de Qwen3-VL dotés d'un décodeur de masques de 9,6 M de paramètres. Le nœud lit la phrase, écrit les coordonnées sous forme de tokens simples, et le décodeur transforme les tokens correspondants en sortie au niveau du pixel.
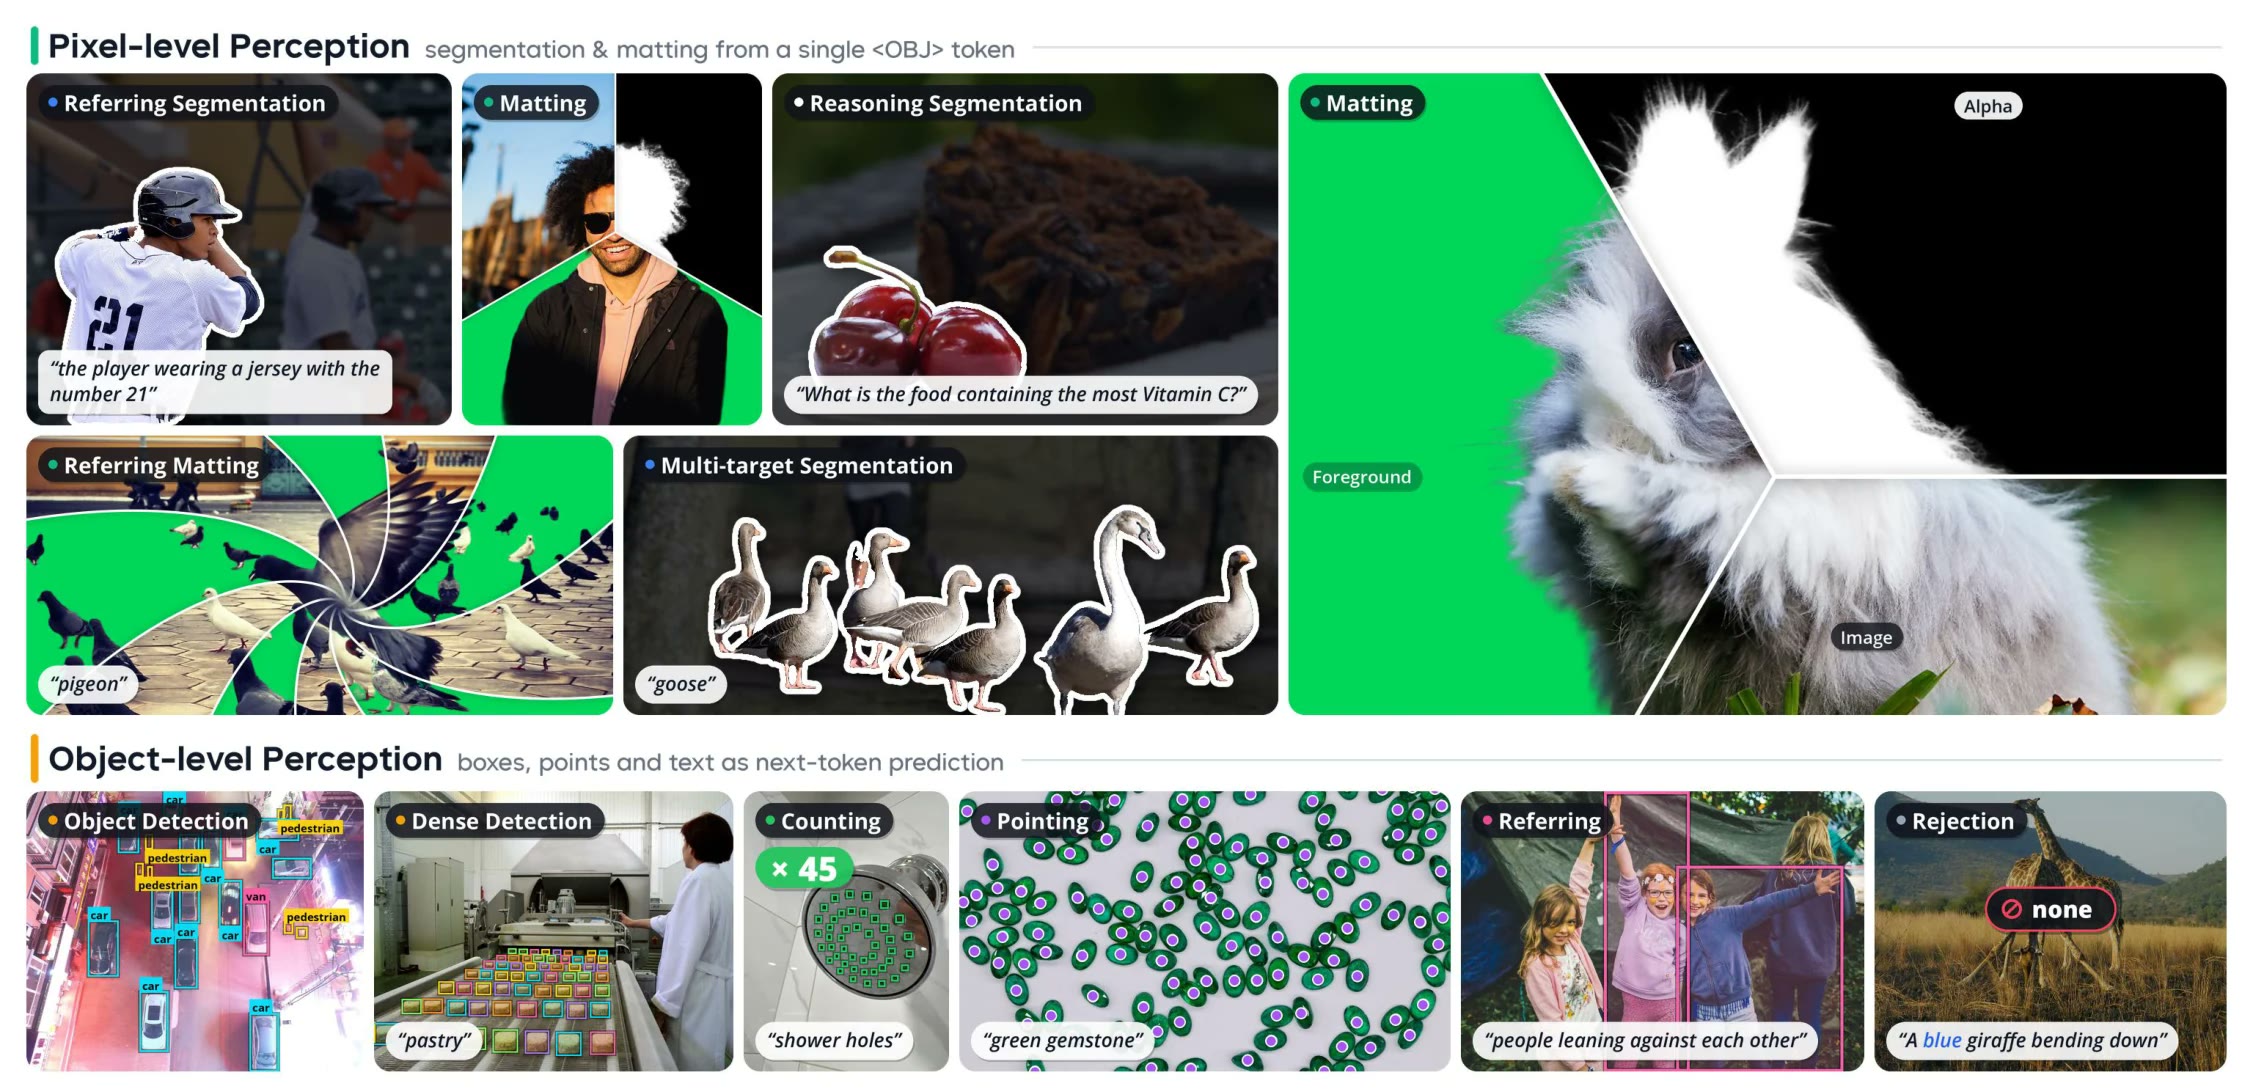
Un seul modèle couvre les points, les boîtes, les masques binaires et les mattes alpha continus. Source : page du projet
Ce que renvoie le nœud
WeVisOne-VL Detect se trouve sous image/detection et possède quatre sorties : masks, bboxes, points (JSON en coordonnées pixel) et le texte brut de la réponse. Ce que vous obtenez dépend de la tâche choisie.
| Tâche | Ce que vous saisissez | Sortie |
|---|---|---|
segmentation | une phrase, par ex. person | boîtes plus mattes alpha par instance |
detection | un label par ligne | boîtes, prêtes pour Draw BBoxes |
referring | une phrase descriptive | boîtes de l'objet correspondant |
point | un label par ligne | coordonnées de points au format JSON |
count_box / count_point | le sujet, par ex. cars | comptage, avec boîtes ou points |
ocr | laisser vide | chaque mot sous forme de boîte |
ocr_grounding | la chaîne de texte | l'emplacement de ce texte |
visual_prompt | boîtes de référence issues d'une autre exécution | objets similaires à la référence |
freeform | l'intégralité de votre prompt | réponse brute |
Activez individual_masks pour conserver un masque par boîte au lieu d'un masque d'union unique. Pour des découpes, reliez masks et l'image à InvertMask + JoinImageWithAlpha.
Chaque coordonnée est un token allant de <0> à <1000>, donc une boîte coûte quatre tokens. Source : page du projet
Comment l'utiliser
-
Mettre à jour ComfyUI. Le nœud est sur master ; la dernière balise (v0.44.2) ne l'inclut pas encore.
-
Télécharger les poids depuis Comfy-Org/WeVisOne-VL dans
ComfyUI/models/text_encoders/. Le repack contient quatre fichiers :Fichier Taille wevisone_vl_4b_bf16.safetensors9,7 Go wevisone_vl_4b_int8_convrot.safetensors5,3 Go wevisone_vl_2b_bf16.safetensors4,9 Go wevisone_vl_2b_int8_convrot.safetensors2,9 Go -
Charger un
CLIPLoaderde typestable_diffusion, choisissez l'un de ces fichiers, puis connectez-le à l'entréeclipdu nœud.
L'exemple à trois groupes de la PR : matting alpha sur une personne, détection et OCR. Remplacez les trois nœuds LoadImage par vos propres images.
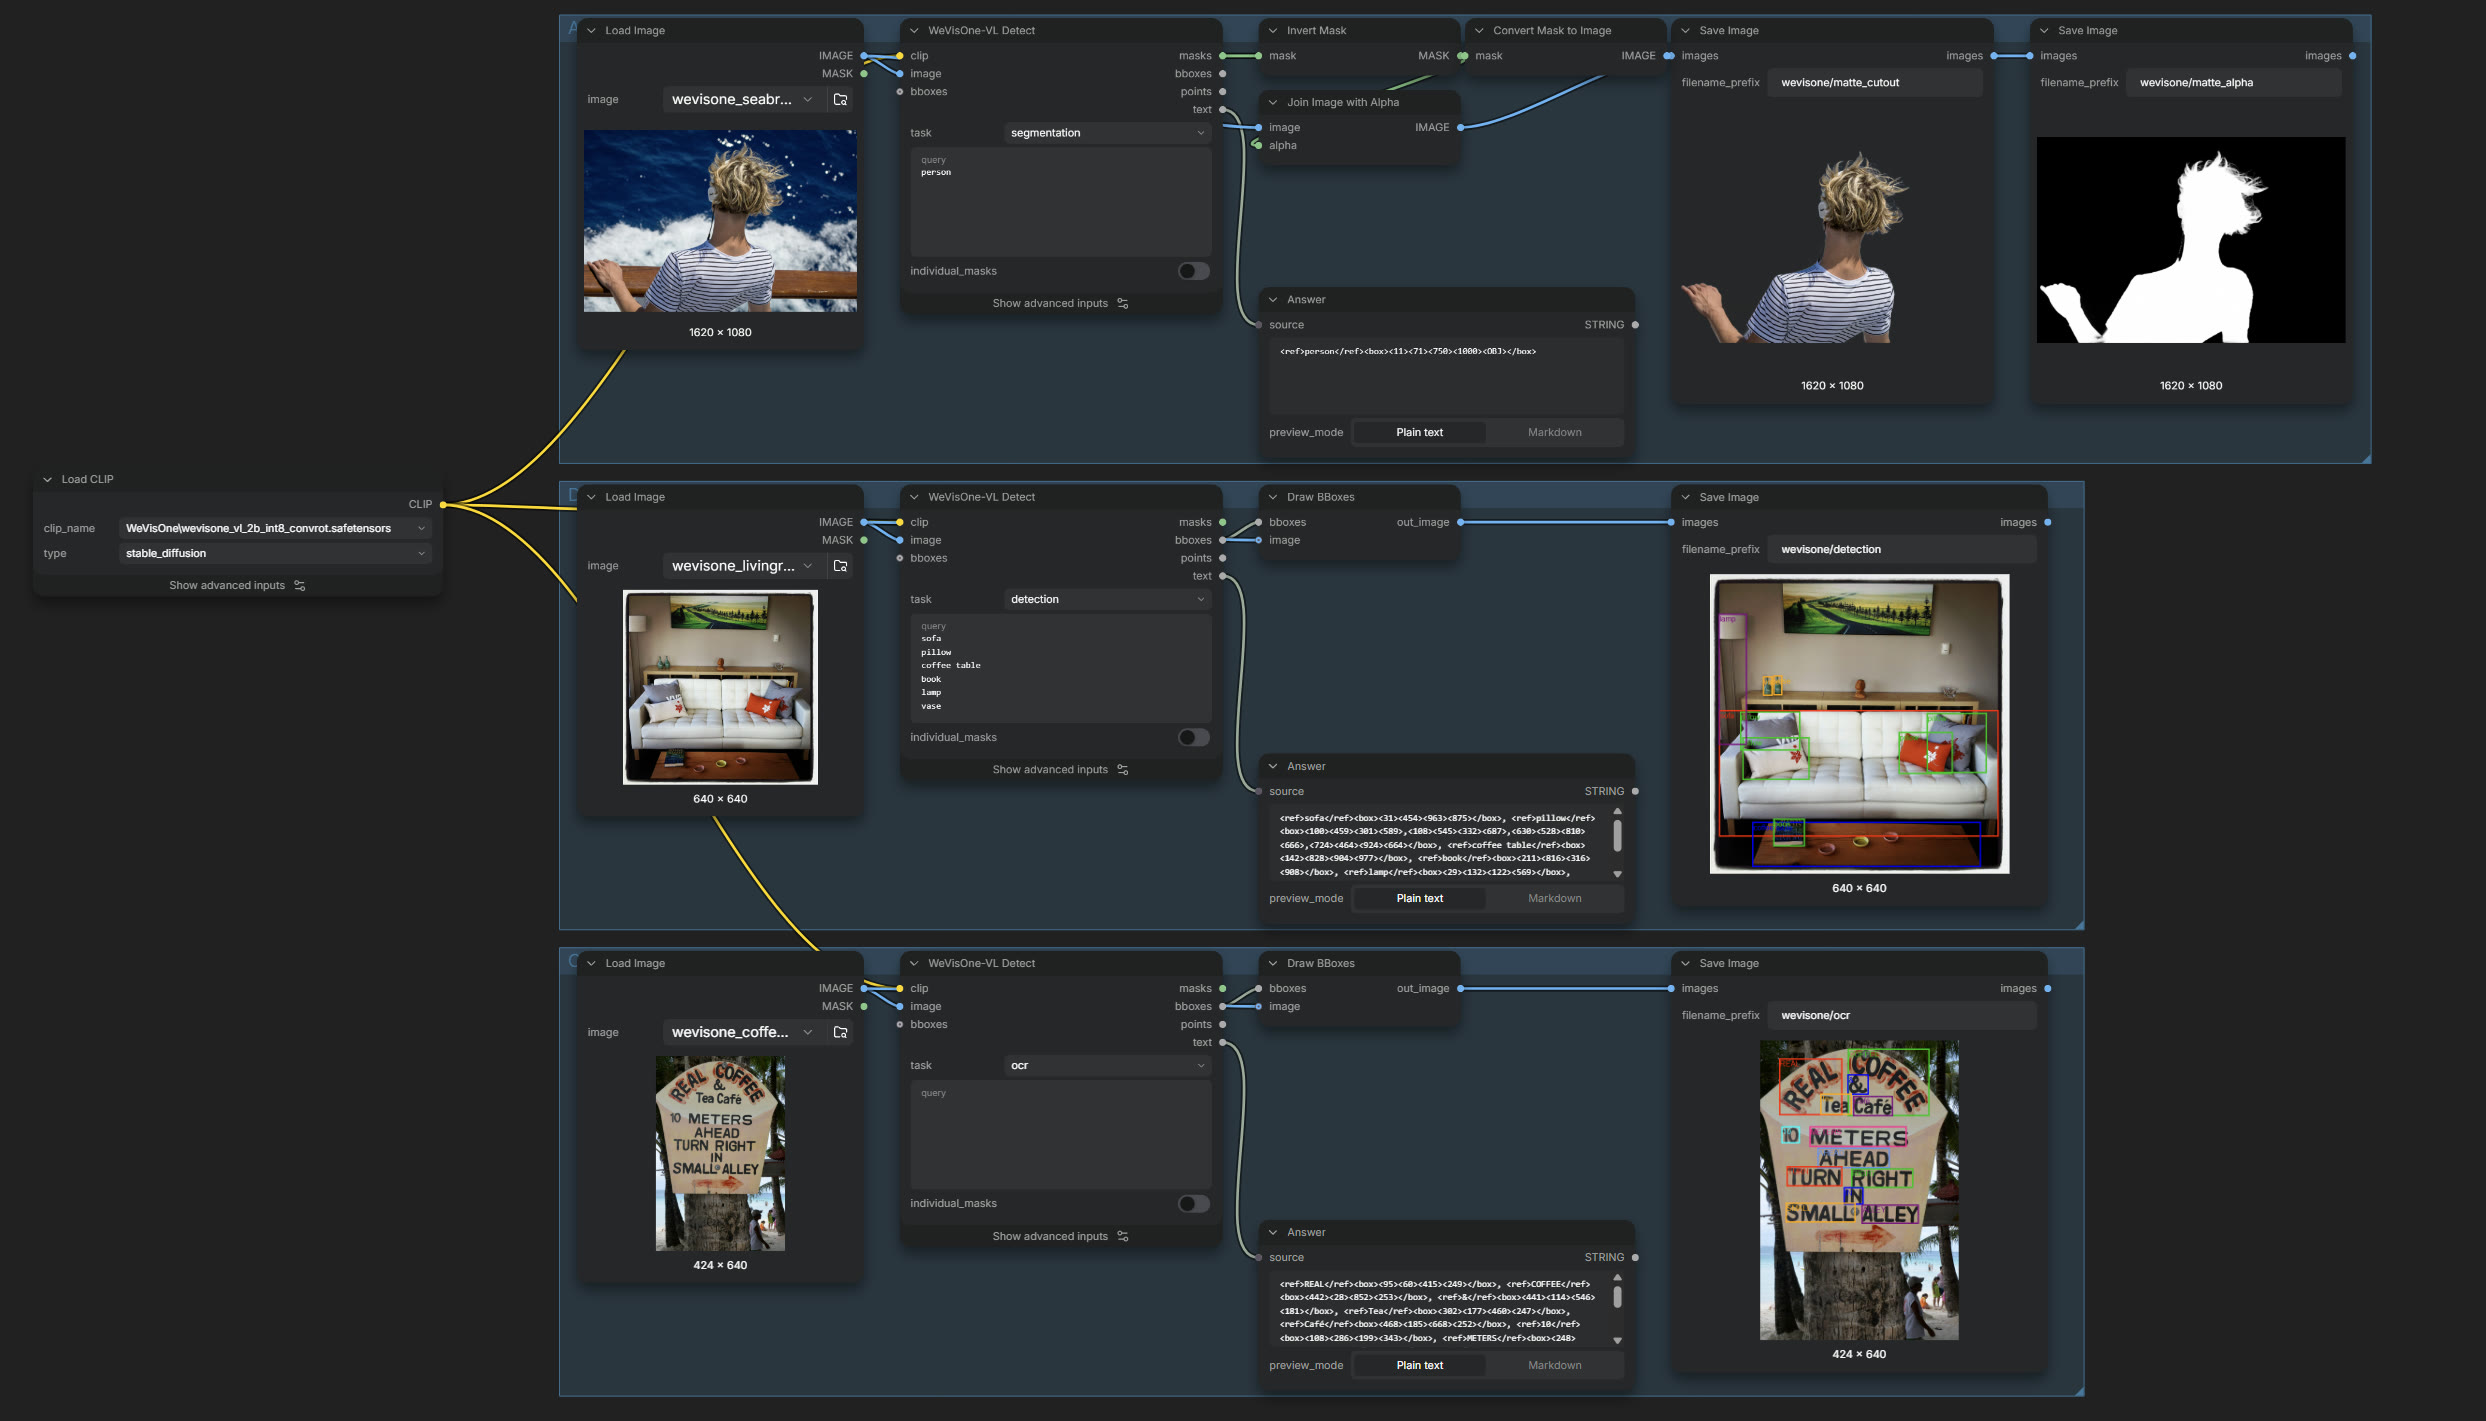
Matting alpha, détection et OCR dans un seul graphique. Source : PR 17632
Quelle est sa performance
Chiffres clés du modèle 4B face à la meilleure référence ouverte de chaque benchmark :
| Tâche | Benchmark | Référence | WeVisOne-VL-4B |
|---|---|---|---|
| Détection | LVIS, F1 | 50,7 | 55,3 |
| Rejet des cibles absentes | WeRef-Bench | 73,0 | 96,4 |
| OCR | TotalText, F1 | 43,3 | 52,0 |
| Segmentation par référence | ReasonSeg, gIoU | 65,0 | 71,2 |
| Matting de boîtes | P3M-500-NP, MAD (plus bas est mieux) | 15,4 | 7,3 |
La ligne sur le rejet est celle qui compte dans un graphique : demandez un objet absent de l'image et le modèle écrit None au lieu d'inventer une boîte.
Limites
- Images uniques uniquement. Le décodeur de pixels rejette les grilles vidéo : ce n'est donc pas un nœud de suivi.
- Les arêtes alpha fines dérivent encore en cas d'occlusion importante ou de sujets transparents, et la formulation de la requête modifie les résultats.
detectionetpointattendent un label par ligne ; une liste séparée par des virgules est lue comme une seule phrase.
Poids originaux : tencent/WeVisOne-VL-4B et 2B. Le repack ComfyUI ci-dessus est celui qui se charge.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.