Open-H3-Regenerate-2K-IC : le 2K qui garde visages et textes
NVlabs signe une version in-context d'Open-H3-Regenerate-2K : un LoRA qui redessine un brouillon MiniMax H3 en 2K ou 4K en gardant visages, lèvres et textes à l'écran.
Open-H3-Regenerate-2K-IC est la deuxième version du raffineur MiniMax H3 open source de NVlabs. Elle fait le même travail que la version d'octobre : porter un brouillon 1344x768 en 2K ou 4K en trois étapes. Ce qui change, c'est la place du brouillon. La première version réinjectait du bruit dans le brouillon puis le polissait, ce qui faisait dériver les visages, les formes de bouche et les petits textes. La version IC conserve le brouillon propre dans le contexte du transformer Ref2VA et dessine le clip haute résolution à partir du bruit à côté, de sorte que l'identité, la synchronisation labiale, le texte des panneaux et la mise en page suivent le brouillon.
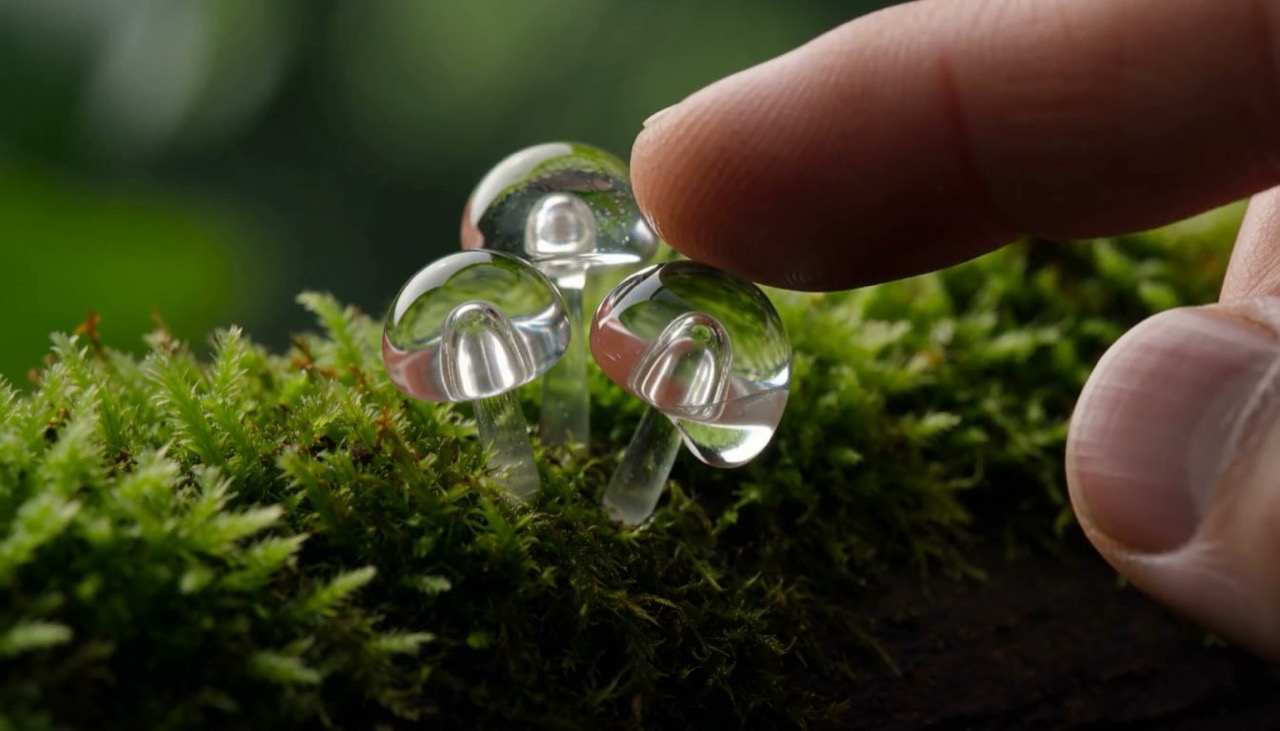 | 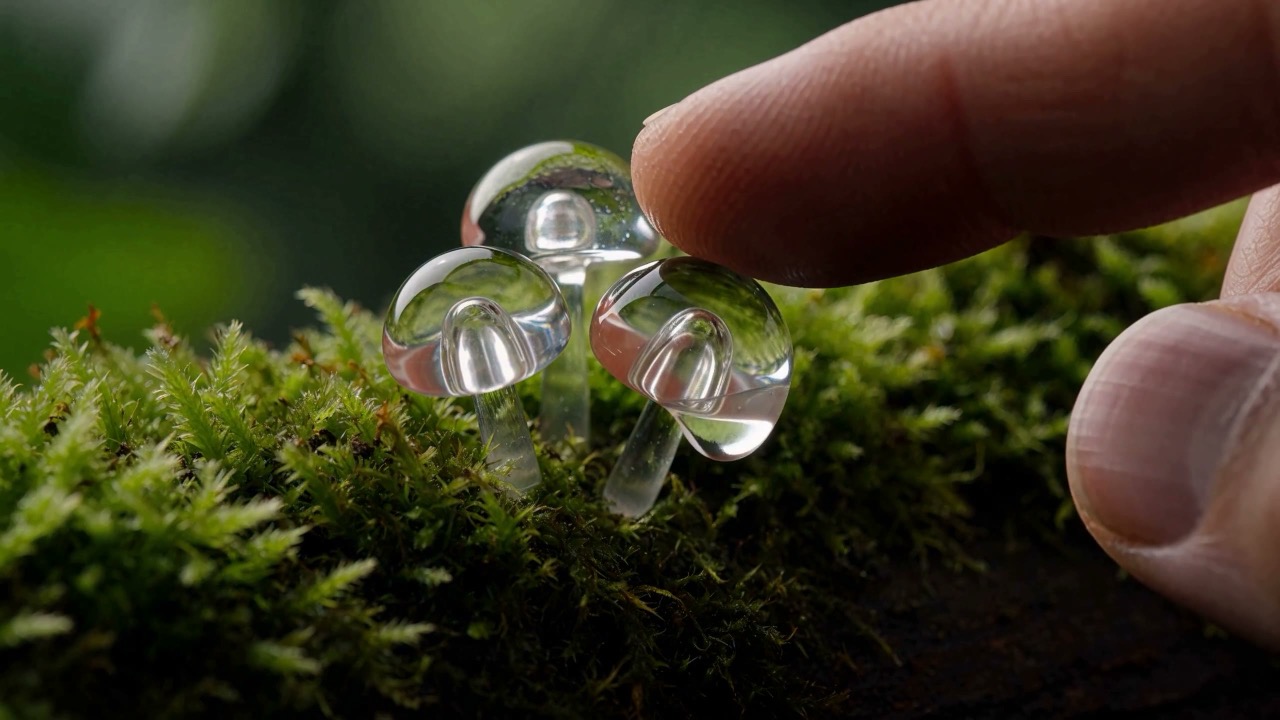 |
|---|---|
| Brouillon H3, 1344x768 | La même image après le passage IC, 2560x1440 |
Images issues du clip de comparaison du projet. Source : page du projet
La sortie IC de ce clip en 2560x1440, avec l'audio du brouillon. Source : page du projet
Ce qu'il préserve
Face à l'API officielle H3-Regenerate-2K, la comparaison sur le parking est le cas le plus parlant : l'API rend le panneau comme des marques illisibles, la version IC affiche toujours « PRIVATE CAR PARK ». Face à la première version ouverte, la sortie IC ajoute moins de nouvelle texture mais laisse les yeux, les rides et les formes de bouche là où le brouillon les avait placés.
Le LoRA IC est entraîné sur le transformer Ref2VA gelé, qui lit déjà les vidéos de référence comme des tokens supplémentaires. Chaque paire d'entraînement est un vrai clip 768P vers 4K ; sa copie réduite est placée devant comme référence propre, tandis que la cible est bruitée de façon variable, du bruit pur jusqu'au propre, et la perte ne porte que sur les tokens de la cible.
Comment l'utiliser
Fournissez-lui le brouillon 768P comme <Video 1>, plus la légende qui l'a généré, inchangée. Trois échantillonneurs, tous à CFG 1 :
up3(par défaut) : le latent du brouillon passe par l'upscaler latent à convolution 3D, est bruité jusqu'à sigma 0,835 et terminé en trois appels au transformer.up4: même départ upscalé à sigma 0,923, quatre appels.hf8: bruit pur et les huit étapes HyperFlow.
La sortie est en 1080p, 2K (2560x1440, par défaut) ou 4K (3840x2160) ; les brouillons 384P, 512P et 576P reviennent en 768P. L'audio est copié du brouillon sans modification, un latent audio silencieux est livré avec les poids, et le résultat 2K est décodé via le VAE H3 rapide tandis que le 4K utilise le VAE standard.
Dans ComfyUI
Il n'existe pas de nœuds officiels, mais deux solutions communautaires existent déjà :
- Kijai a compressé le LoRA FP32 de 8,3 Go en un fichier bf16 rank-21 de 200 Mo qui se charge comme un LoRA normal sur le modèle Ref2VA.
- ComfyUI-OpenH3Regenerate2KIC fournit quatre nœuds (Prepare Draft, Official Prompt, Sigma Grid, Compose Target Latent), le LoRA converti full-rank de 5,9 Go et trois flux de travail : texte vers brouillon vers 2K, image de référence vers brouillon vers 2K, et brouillon vers 2K.
Les poids et le code d'inférence sont sur Hugging Face, avec le CLI de référence dans NVlabs/Sana.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.