HyperFlow H3 Flash : MiniMax H3 14B en 6 étapes sur un seul GPU
HyperFlow H3 Flash de Video Rebirth compresse MiniMax H3 à 13,7B, échantillonne en 4 à 8 étapes à CFG 1 et tourne depuis un GGUF de 9,1 Go sur un GPU 24 Go avec audio stéréo.
Q4_K_M fait 9,1 Go, et l'ensemble tourne sur un GPU 24 Go. Video Rebirth mesure 12,7× par rapport à la référence H3 sur un seul B200.
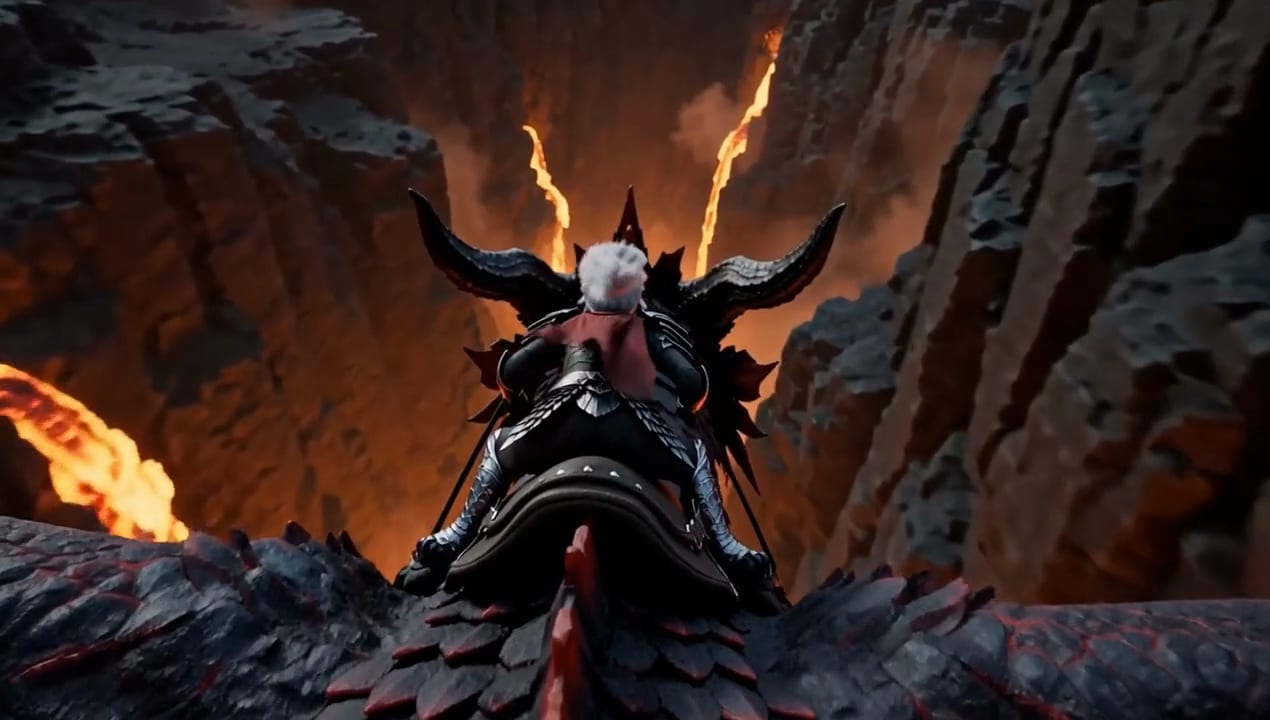
Sortie pleine qualité à 6 étapes. Images fixes publiées avec la version.
Ce qui a changé
La petite taille vient d'une factorisation de rang faible du transformer de base, et non d'une nouvelle architecture. Tout le reste est du H3 : le même encodeur de texte, le VAE vidéo, le VAE audio et les nœuds H3 natifs de ComfyUI.
- Sortie : 5,2 à 15 s à 24 fps, 1344x768 par défaut, bande-son stéréo 32 kHz.
- Échantillonnage :
euler, 4 étapes pour la vitesse, 6 par défaut, 8 pour la qualité. Pas de prompt négatif : le modèle a été entraîné à CFG 1. - Tâches : texte vers vidéo, première image, première et dernière image, et référence vers vidéo avec jusqu'à 9 images (12 dans le chemin Python, qui accepte aussi des références vidéo et audio).
Tailles et vitesse
Un clip de 5,2 s à 6 étapes, chiffres de Video Rebirth :
| matériel | temps |
|---|---|
| 4x B200 | 8,7 s |
| 1x H200 | 36 s |
| 1x RTX 5090 | 92 s |
| quantification GGUF | fl2va | ref2va | cas d'usage |
|---|---|---|---|
Q4_K_M | 9,1 Go | 9,2 Go | défaut pour les GPU 24 Go |
Q8_0 | 14,9 Go | 15,2 Go | au plus proche de la pleine précision |
Q3_K_M | 7,2 Go | 7,4 Go | le plus petit |
La build INT8 convrot fait environ 16 Go par tâche et cible les cartes de classe H100 et B200, ou une carte RTX 24 Go disposant de beaucoup de RAM système.
L'exécuter dans ComfyUI
- Mettez à jour ComfyUI vers 0.43 ou plus récent pour
MiniMaxH3ImageToVideoetMiniMaxH3ReferenceToVideo. - Clonez ComfyUI-GGUF et ComfyUI-HyperFlow-Flash dans
custom_nodes/. - Placez le GGUF dans
models/diffusion_models/, ainsi que l'encodeur de texteqwen3vl_32b_minimax_h3_nvfp4_awqde 15,7 Go et les VAE vidéo et audio de Comfy-Org/MiniMax-H3. - Ouvrez Workflow > Parcourir les modèles > ComfyUI-HyperFlow-Flash. Quatre modèles :
hyperflow_t2v,hyperflow_i2v,hyperflow_flf2v,hyperflow_ref2v.
Sur une machine avec 16 Go ou 32 Go de RAM, démarrez ComfyUI avec --fast-disk. L'encodeur de texte à lui seul fait 15,7 Go : c'est donc la RAM, et non la VRAM, qui manque généralement en premier.
Le modèle hyperflow_t2v : HyperFlow GGUF Loader et HyperFlow Sigmas remplacent le chargeur et le scheduler H3.
Avant de télécharger
- Les LoRA entraînés sur le H3 complet ne se chargent pas. Le transformer compressé n'a pas les calques correspondants : les turbos et les sliders du modèle 31B sont donc hors jeu.
- L'accélération est plus faible que ne le suggère le nombre de paramètres. Kijai a mesuré environ 10 % de gain par rapport au modèle complet élagué dans ComfyUI, car le coût de l'attention reste identique à cette résolution. LukeG89 a jugé que cela n'en valait pas la peine.
- Les GPU 16 Go ne sont pas encore mesurés. L'empreinte la plus faible testée est de 24 Go.
Le clip GPU grand public de la page de publication.
Disponibilité
Poids : VideoRebirthAI/hyperflow-h3-flash (GGUF et INT8 convrot, v1.0.0, 2026-11-06). Code et nœuds ComfyUI : Video-Rebirth/hyperflow-h3-flash et ComfyUI-HyperFlow-Flash Vitrine : videorebirth.com/lp/hyperflow-flash.
Il s'agit d'un modèle Video Rebirth, et non d'une publication MiniMax. Il est distinct du LoRA HyperFlow 8 étapes, qui fonctionne toujours sur le H3 complet de 31B.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.