Viggle Remake : retourne n'importe quelle vidéo avec deux LoRA H3
Viggle Remake est une paire de LoRA MiniMax H3 open source pour remplacer des personnages ou modifier une séquence existante : peignez une à quatre images, conservez la bande-son et lancez-le dans ComfyUI dès 12 Go.
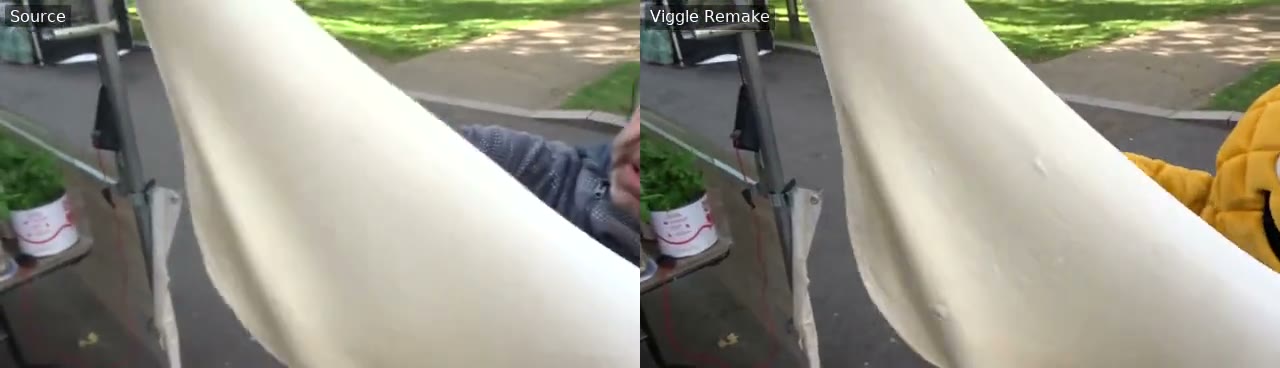
À gauche : le clip source. À droite : le même plan avec la mascotte ananas remplacée, mouvement, caméra et timing inchangés.
Viggle travaille dans cette direction depuis Viggle-Animate fin août, qui remplaçait un personnage dans un plan à partir d'une seule image repeinte, sur un finetune H3 ref2va fortement distillé. Remake est ce que la fiche du modèle appelle le « Viggle-Animate v2 » qui y était présenté, et il évolue de deux manières : c'est un LoRA sur le transformer H3 standard plutôt qu'un finetune, et il modifie plus que des personnes.
Deux modes
Les deux modes prennent le clip source plus une à quatre images de référence, appelées <Picture 1> à <Picture 4> dans le prompt. Vous peignez vous-même ces références, soit par-dessus des images extraites du clip, soit à partir de zéro, et chacune peut être épinglée à l'image source dont elle a été peinte.
swapremplace des personnes et des personnages, un ou plusieurs à la fois.editfait le reste : remplacer, supprimer ou insérer des objets, changer l'arrière-plan, la météo ou la lumière.
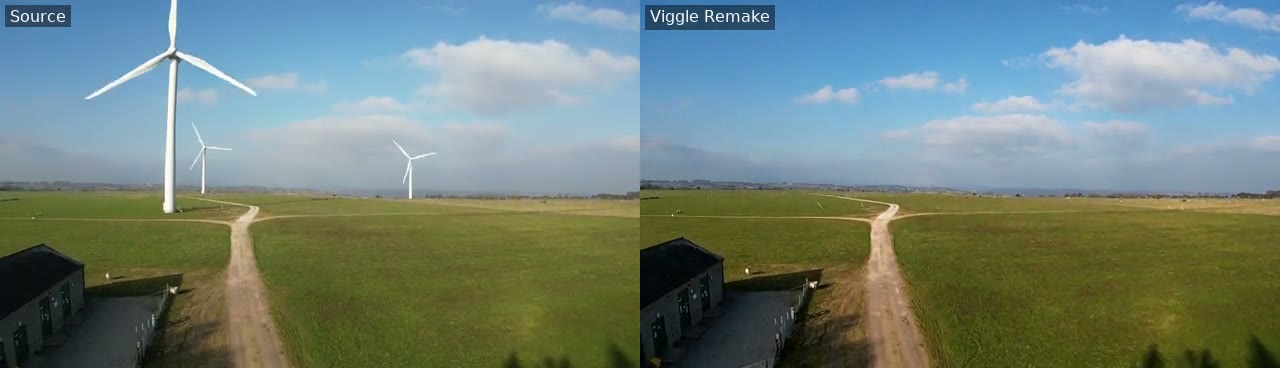
Le LoRA edit qui supprime des objets d'un plan pendant que le mouvement de caméra et le reste du plateau restent en place.
L'identité vient des images peintes, pas d'un encodeur de visage ni d'un masque de segmentation. C'est pourquoi le pipeline n'a besoin ni d'estimation de pose ni de suivi, et aussi pourquoi la fiche du modèle précise sans détour qu'il ne peut pas vérifier le consentement : le seul endroit où l'identité se décide est l'image que vous peignez.
Ce que c'est, techniquement
Chaque mode est un LoRA PEFT, de rang 256 et alpha 256, sur 302 couches linéaires du transformer FL2VA de H3, stocké en bf16 avec quatre tenseurs proj_in / proj_out en fp32. Rien d'autre dans le modèle de base ne change ; le LoRA est un delta appliqué au chargement. Le référentiel fournit aussi les mêmes poids remballés aux noms de couches ComfyUI, des transformers int8 et GGUF fusionnés, et un échantillonneur de référence dans inference/sample.py.
Le son est transporté plutôt que généré. La sortie conserve la bande-son du clip source, donc une source silencieuse donne un résultat silencieux, et l'encodage audio est complété à la fin parce que l'encodage audio standard de ComfyUI rogne une piste sur des blocs entiers de 800 échantillons aux deux extrémités, la décalant de jusqu'à 400 échantillons par rapport à l'image.
La voie ComfyUI
ComfyUI exécute H3 nativement, donc le pack de nœuds ne couvre que les quatre points sur lesquels les nœuds standards se comportent différemment. Il ajoute trois nœuds, testés avec ComfyUI 0.42.0 :
- Viggle Remake Conditioning, qui prend les images source, l'audio, jusqu'à quatre références, les images épinglées et le prompt.
- Viggle Remake Keyframe Until, qui transforme les références épinglées en keyframes jusqu'à une fraction donnée de la plage échantillonnée.
- Viggle Remake Noise, qui reproduit le bruit de départ de l'échantillonneur de référence pour une graine.
Le graphe est autrement standard : LoraLoaderBypassModelOnly, BasicGuider, KSamplerSelect avec euler, ManualSigmas, SamplerCustomAdvanced, deux décodages VAE, Create Video à 24 fps.
Un réglage mérite d'être répété parce qu'il change la sortie plutôt que la vitesse. Le simple LoraLoaderModelOnly fusionne le LoRA dans les poids bf16, et en bf16 une grande partie de la mise à jour s'arrondit : le projet mesure qu'il n'en survit que 37 à 73 pour cent dans les couches d'attention et MLP, et le rendu fusionné sur l'exemple swap est 7 pour cent moins net (21,2 dB contre 24,7 dB). LoraLoaderBypassModelOnly garde le LoRA comme branche séparée pour 2 à 3 pour cent de temps en plus par rendu.
| swap | edit | |
|---|---|---|
| LoRA | viggle_remake_swap_comfyui.safetensors | viggle_remake_edit_comfyui.safetensors |
| ManualSigmas | 1.0, 0.990476, 0.965243, 0.923077, 0.8, 0.631579, 0.0 | 1.0, 0.983607, 0.96, 0.923077, 0.857143, 0.705882, 0.0 |
Cartes plus modestes : int8 et GGUF
La voie bf16 demande une carte de 80 Go et environ 144 Go de modèle de base. En dessous, chaque mode est fourni sous forme d'un seul fichier transformer avec le LoRA déjà fusionné en fp32 et quantifié, remplaçant à la fois le modèle de diffusion de base et le chargeur de LoRA dans le graphe.
| fichier | taille | chargeur |
|---|---|---|
int8/viggle_remake_{swap,edit}_pruned_int8_convrot.safetensors | 21,0 Go | Charger Modèle Diffusion (core) |
gguf/*-Q8_0.gguf | 22,3 Go | Unet Loader (GGUF) |
gguf/*-Q6_K.gguf | 17,6 Go | Unet Loader (GGUF) |
gguf/*-Q4_K_M.gguf | 14,3 Go | Unet Loader (GGUF) |
Le tableau des cartes du projet, mesuré avec l'exemple edit à 226 images et deux références épinglées :
- 12 Go : Q4_K_M ou Q8_0 avec
--reserve-vram 8; int8 ne tourne qu'à 124 images. - 16 Go : int8 en 832x480 ; Q4_K_M ou Q6_K avec
--reserve-vram 6; en 1280x736, Q4_K_M avec--reserve-vram 10et 124 images. - 24 Go : int8 ou Q4_K_M en 832x480 ; Q4_K_M ou Q8_0 en 1280x736 avec
--reserve-vram 20. - 32 à 80 Go : int8 ou Q8_0 confortablement en 832x480 ; en 1280x736, le fichier int8 manque de mémoire à 226 images sur des cartes de 48 et 80 Go, tandis que Q8_0 tient sur 24 Go avec une réserve.
Qualité par rapport à la référence bf16 plus LoRA, en PSNR sur chaque image : int8 obtient 27,2 dB en swap et 46,8 dB en edit, Q8_0 26,9 et 49,8, Q6_K 24,6 et 44,6, Q4_K_M 20,6 et 38,3. La colonne swap est la plus bruitée : arrondir les mêmes poids bf16 d'une seconde manière légèrement différente déplace déjà ce rendu à 29,6 dB, donc quelques dB d'écart ne constituent pas un classement de formats.
Vitesse
Sur un B200 en 832x480 avec 226 images et deux références épinglées, ComfyUI prend environ 95 secondes par rendu une fois les modèles chargés, soit environ 13,5 secondes par étape sur six étapes, contre environ 58 secondes pour sample.py. Un premier rendu incluant le chargement prend 2,5 à 3 minutes. En 1280x736, une étape coûte 64 à 72 secondes et un rendu 510 à 585 secondes. Le projet n'a mesuré que des B200 et le dit ; les cartes grand public seront plus lentes.
Limites
- Un rendu couvre une fenêtre de 90 à 345 images (
17n+5, 24 fps) ; le projet recommande jusqu'à 294 images, environ 12 secondes, et les vidéos plus longues deviennent des fenêtres que le serveur MCP découpe aux frontières de plans. - Le prompt H3 en six sections est requis, et ses horodatages doivent correspondre au nombre d'images.
- Les images peintes décident de l'identité et de l'apparence ; les images épinglées fixent aussi la composition à cette image.
- Échecs connus : un personnage non humanoïde dans un long plan unique, de petits artefacts dans les détails fins, et des plans qui dérivent dans le temps quand un clip multi-plans est rendu sans épingles.
L'exemple swap livré avec les flux de travail ComfyUI : 226 images, deux références épinglées aux images 12 et 184.
L'exemple edit : les éoliennes quittent le plateau tandis que le panoramique et la lumière restent.
Disponibilité
Les poids, les LoRA, les fichiers int8 et GGUF, le pack de nœuds et les flux de travail sont sur Hugging Face, avec COMFYUI.md, PROMPTING.md et MODIFICATIONS.md à côté. Le référentiel fait environ 210 Go au complet, donc le guide ComfyUI ne télécharge que les sous-ensembles comfyui/ et examples/inputs/. Il a été publié le 4 novembre 2026 et annoncé par @viggleai le même jour ; la fiche ne contient aucun benchmark face à d'autres modèles d'édition, donc les chiffres ci-dessus sont ceux du projet lui-même.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.