P-H3-Image : génération d'images MiniMax H3 dans ComfyUI
P-H3-Image de PrunaAI génère des images de 8 MP en 8 étapes sans CFG et retouche avec jusqu'à 8 références. ComfyUI l'intègre nativement dès son lancement.
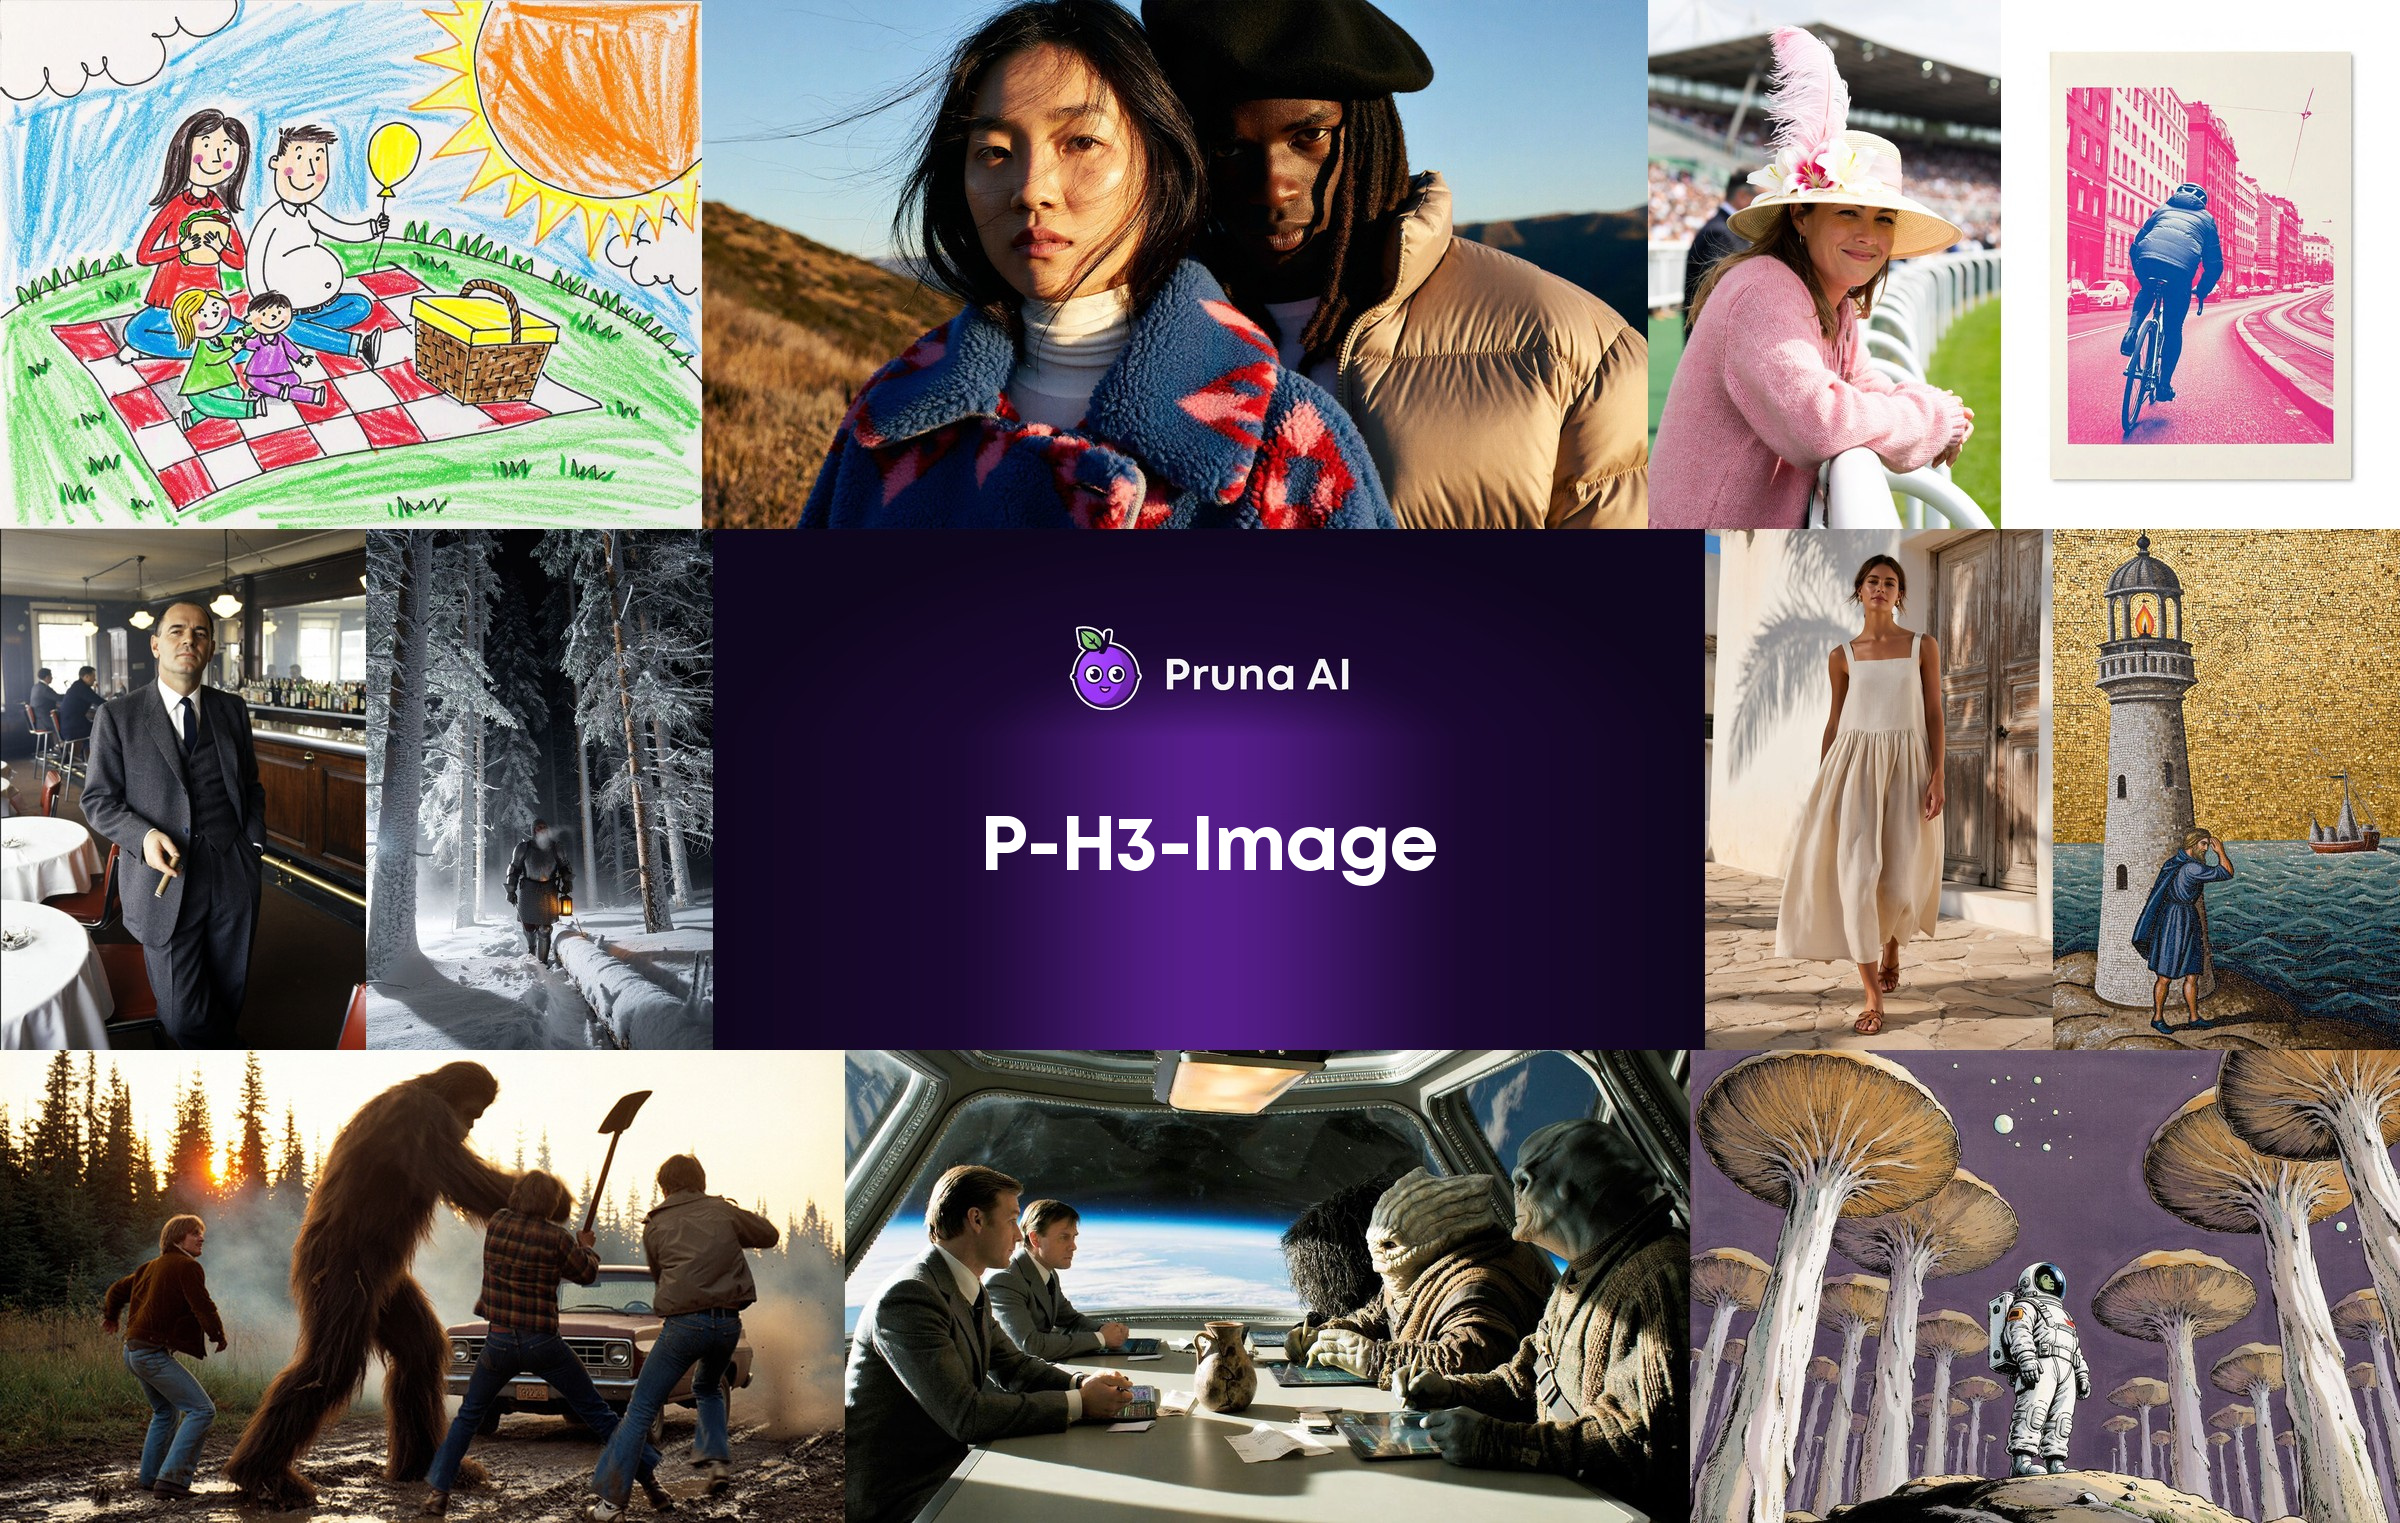
Exemples issus de la fiche du modèle officielle. La fiche présente P-H3-Image comme adapté au photoréalisme, aux rendus cinématographiques et éditoriaux, ainsi qu'aux styles graphiques avec de courts textes entre guillemets.
Ce qu'est le modèle
Cette version est un transformer de 33,1 milliards de paramètres avec un encodeur textuel de 4 milliards, un VAE et un suréchantillonneur de prompt séparé, pour 100 Go en bf16. Il s'agit d'un fine-tune de MiniMax H3 plutôt que d'une nouvelle architecture : il hérite donc du VAE et de la pile d'attention de H3 et consacre son budget d'entraînement aux images fixes plutôt qu'à la vidéo.
| Tâches | Génération texte-image et retouche avec 1 à 8 images d'entrée |
| Échantillonnage | 8 étapes, sans CFG ni prompt négatif |
| Résolution | 8 MP pour la génération texte-image, 4 ou 8 MP pour les retouches |
| Suréchantillonneur de prompt | Inclus, activé par défaut, basé sur Qwen3.5-9B |
| Poids | Transformer 33,1 B, encodeur textuel 4 B, VAE, suréchantillonneur de prompt |
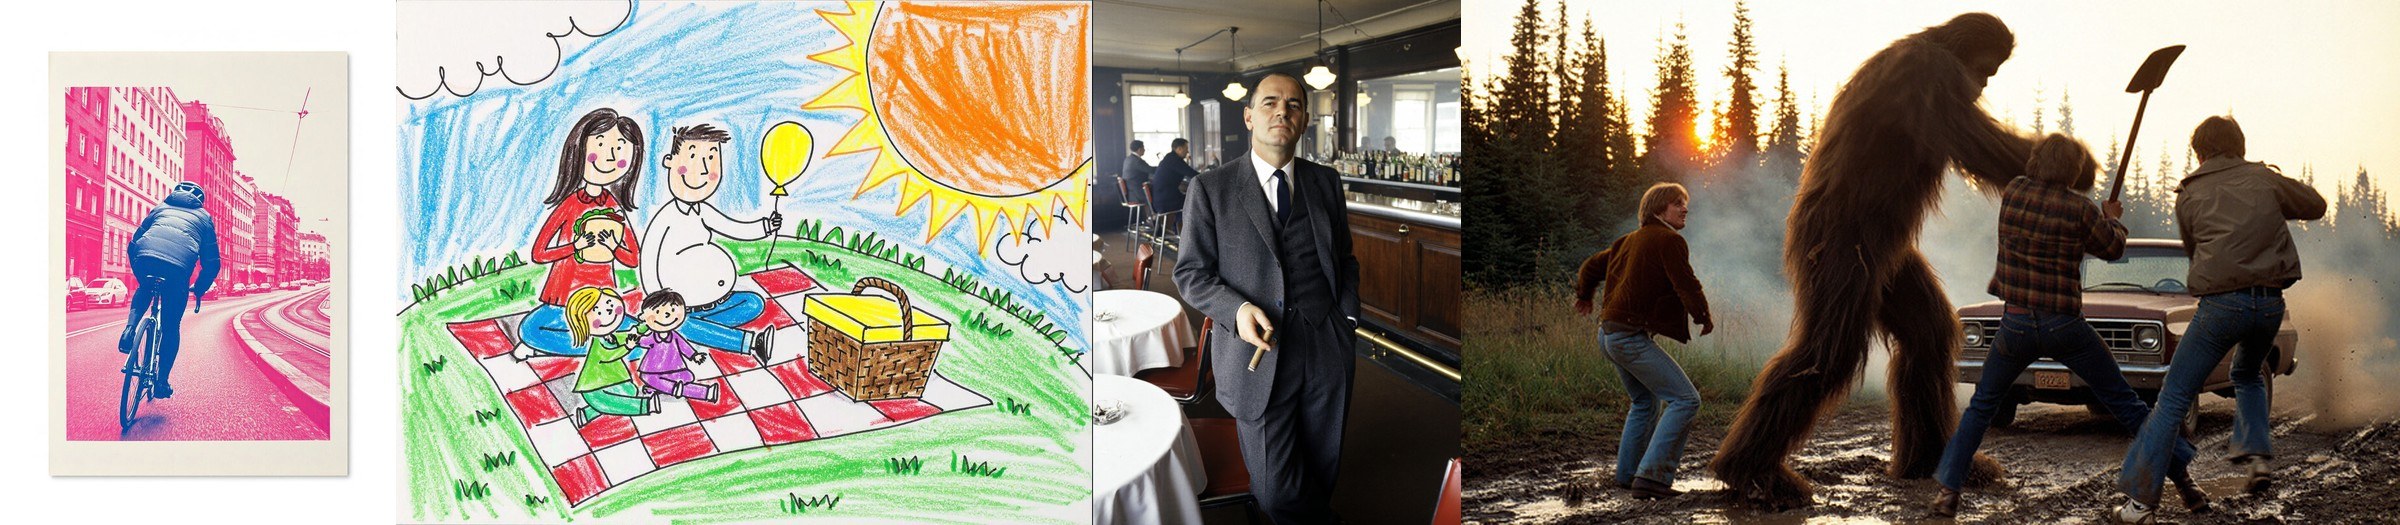
Couverture de styles issue de la fiche du modèle, rendue en 8 MP.
Prise en charge native dans ComfyUI dès le jour du lancement
ComfyUI a intégré la prise en charge de PH3Image dans la PR 17506 (CORE-697) le 2026-11-03, le jour même où PrunaAI a publié la révision update-for-launch des poids. Les deux modèles de flux de travail officiels de Comfy-Org/workflow_templates portent minComfyUIVersion: 0.44.0, donc toute version antérieure à 0.44.0 ne peut pas les ouvrir.
Le graphe n'utilise que des nœuds intégrés : Charger Modèle Diffusion charge le checkpoint, MiniMax H3 Sigma Shift fonctionne à 1.0 pour les deux décalages, Charger CLIP avec le type minimax charge l'encodeur textuel, et le nouveau nœud Conditionnement p-h3-image transforme le prompt et les éventuelles images en conditionnement et en latent d'image. L'échantillonnage utilise Sigmas manuels sur la grille de 8 étapes, puis ÉCHANTILLONNEUR Personnalisé Avancé avec GuideBasique et euler, sans CFG ni prompt négatif. Le LoRA facultatif se charge via LoraLoaderModelOnly réglé sur modèle uniquement.
Quels fichiers télécharger
PrunaAI/P-H3-Image-Comfy reprend les poids dans les formats natifs de ComfyUI, et les précisions peuvent être combinées librement tant que chaque composant provient d'une seule ligne. MiniMax H3 seul représente 143 Go de poids ; le plus petit ensemble P-H3-Image représente un téléchargement de 20 Go qui culmine à 21 Go de VRAM en 8 MP.
| Composant | Dossier | bf16 | int8 | w4a8 |
|---|---|---|---|---|
| Modèle de diffusion | diffusion_models/ | 40,5 Go | 21,2 Go | 13,4 Go |
| Encodeur textuel | text_encoders/ | 9,1 Go | 5,1 Go | 3,6 Go |
| Suréchantillonneur de prompt | text_encoders/ | 19,3 Go | 9,7 Go | 6,7 Go |
| VAE | vae/ | 5,6 Go | 3,1 Go | aucun |
| Ensemble | Téléchargement | Pic de VRAM à 8 MP |
|---|---|---|
| bf16 | 55 Go | 56 Go |
| int8 | 30 Go | 31 Go |
| w4a8 + VAE int8 | 20 Go | 21 Go |
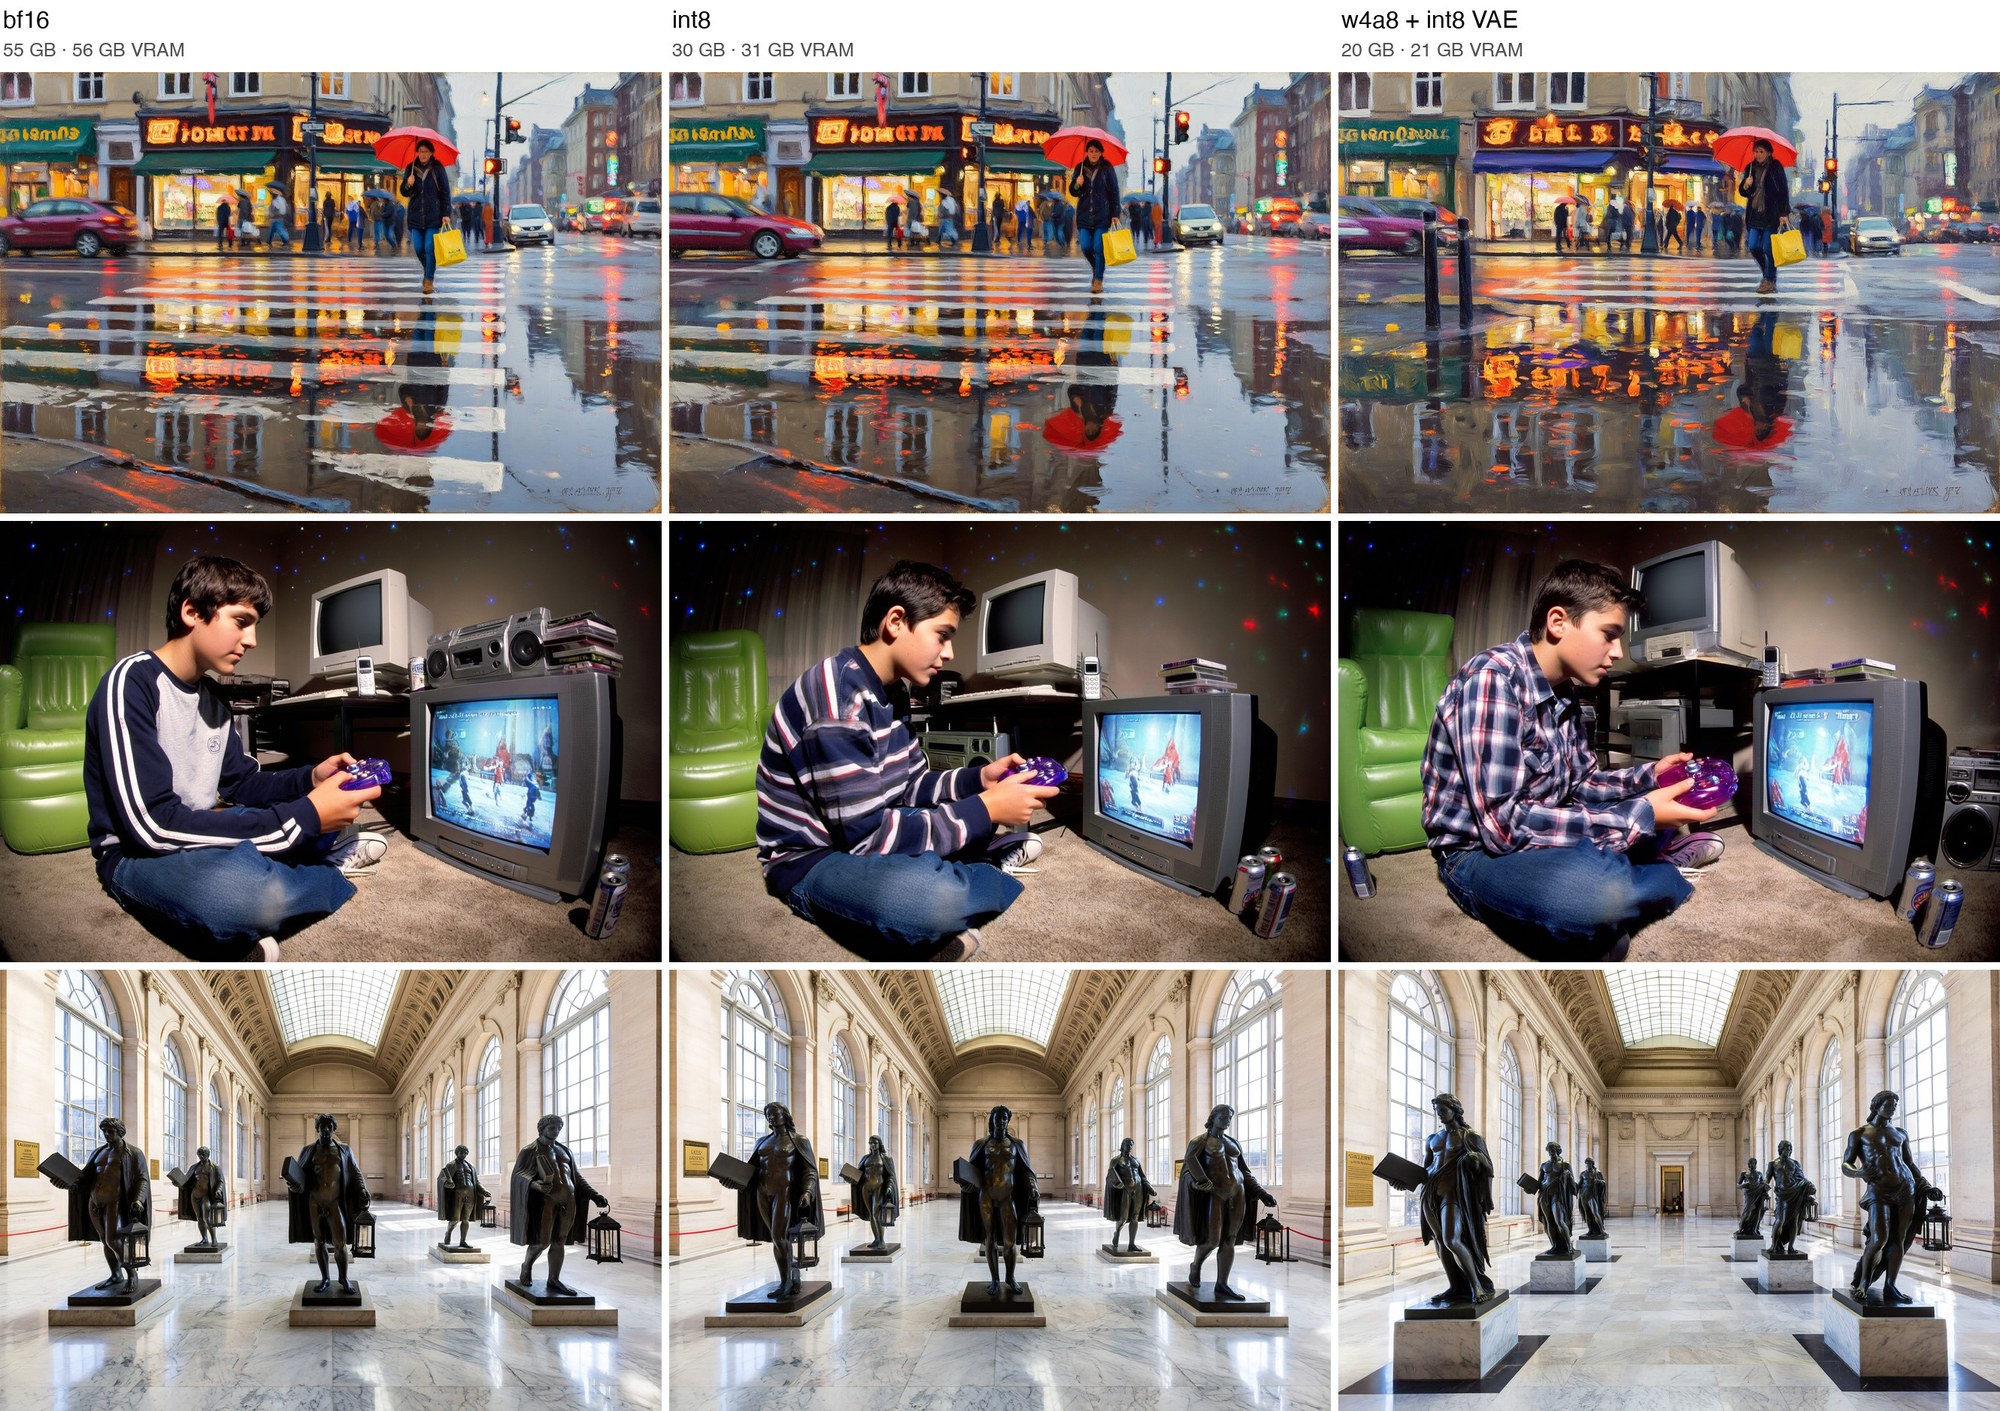
Les mêmes prompts et la même graine en bf16, int8 et w4a8 à 8 MP, chaque en-tête indiquant sa taille de téléchargement et son pic de VRAM.
Les fichiers int8 restent très proches du bf16, souvent presque au pixel près. w4a8 conserve la qualité mais fait davantage varier les détails et parfois la composition. Tous deux sont des formats de quantification propres à ComfyUI : int8 applique une rotation de Hadamard groupée pour neutraliser les valeurs aberrantes et stocke des échelles par ligne, les activations étant quantifiées à la volée, tandis que w4a8 place des poids 4 bits dans un codebook à 16 niveaux, avec une échelle FP8 pour 16 entrées, et conserve les couches sensibles en int8. Aucun des deux ne nécessite de données de calibration, et les deux s'exécutent sur les noyaux INT8 de comfy-kitchen pour NVIDIA Ampere ou plus récent, ainsi que pour AMD RDNA3/4.
Il y a aussi un LoRA de 2,0 Go dans loras/, qui applique le même comportement à vos propres poids MiniMax H3 au lieu du checkpoint complet. Deux des quatre flux de travail du dépôt sont construits autour de lui.
Le suréchantillonneur de prompt fait partie du modèle
P-H3-Image réagit bien mieux à des prompts complets et précis qu'à des requêtes courtes ; chaque flux de travail d'exemple exécute donc d'abord le suréchantillonneur. Dans ComfyUI, ce n'est pas non plus un nœud personnalisé : Charger CLIP de type minimax plus TextGenerate avec décodage glouton, de sorte qu'une même requête produit toujours le même prompt.
Pour la génération texte-image, Formater le texte compose Aspect ratio: 1:1 et Request: ... sur deux lignes avec thinking activé. Pour les retouches, il écrit un bloc <Picture N> par image, avec image_1 à 1 MP et les références complétées par remplissage jusqu'à cette taille via Images par lot. Un Commutateur If/Else Utiliser le suréchantillonneur de prompt, réglé sur false, envoie la requête au modèle telle quelle.
Le suréchantillonneur s'exécute avant le modèle de diffusion, et ComfyUI le retire de la VRAM lorsque P-H3-Image a besoin de la mémoire ; sa sortie est mise en cache, donc il ne s'exécute à nouveau que lorsque la requête ou les images changent. Le suréchantillonneur bf16 est celui recommandé, à 19,3 Go et environ 21 Go de VRAM.
Retouche avec jusqu'à huit images
Une retouche utilise l'image à modifier comme image_1, plus jusqu'à sept références, dans le même ordre dans Images par lot et sur le nœud de conditionnement, avec un bloc <Picture N> pour chacune dans l'entrée du suréchantillonneur. La requête peut les nommer comme bon lui semble : ainsi, « le chapeau de la deuxième photo » renvoie à la deuxième image. Seule l'image 1 est retouchée ; les autres servent de contexte.
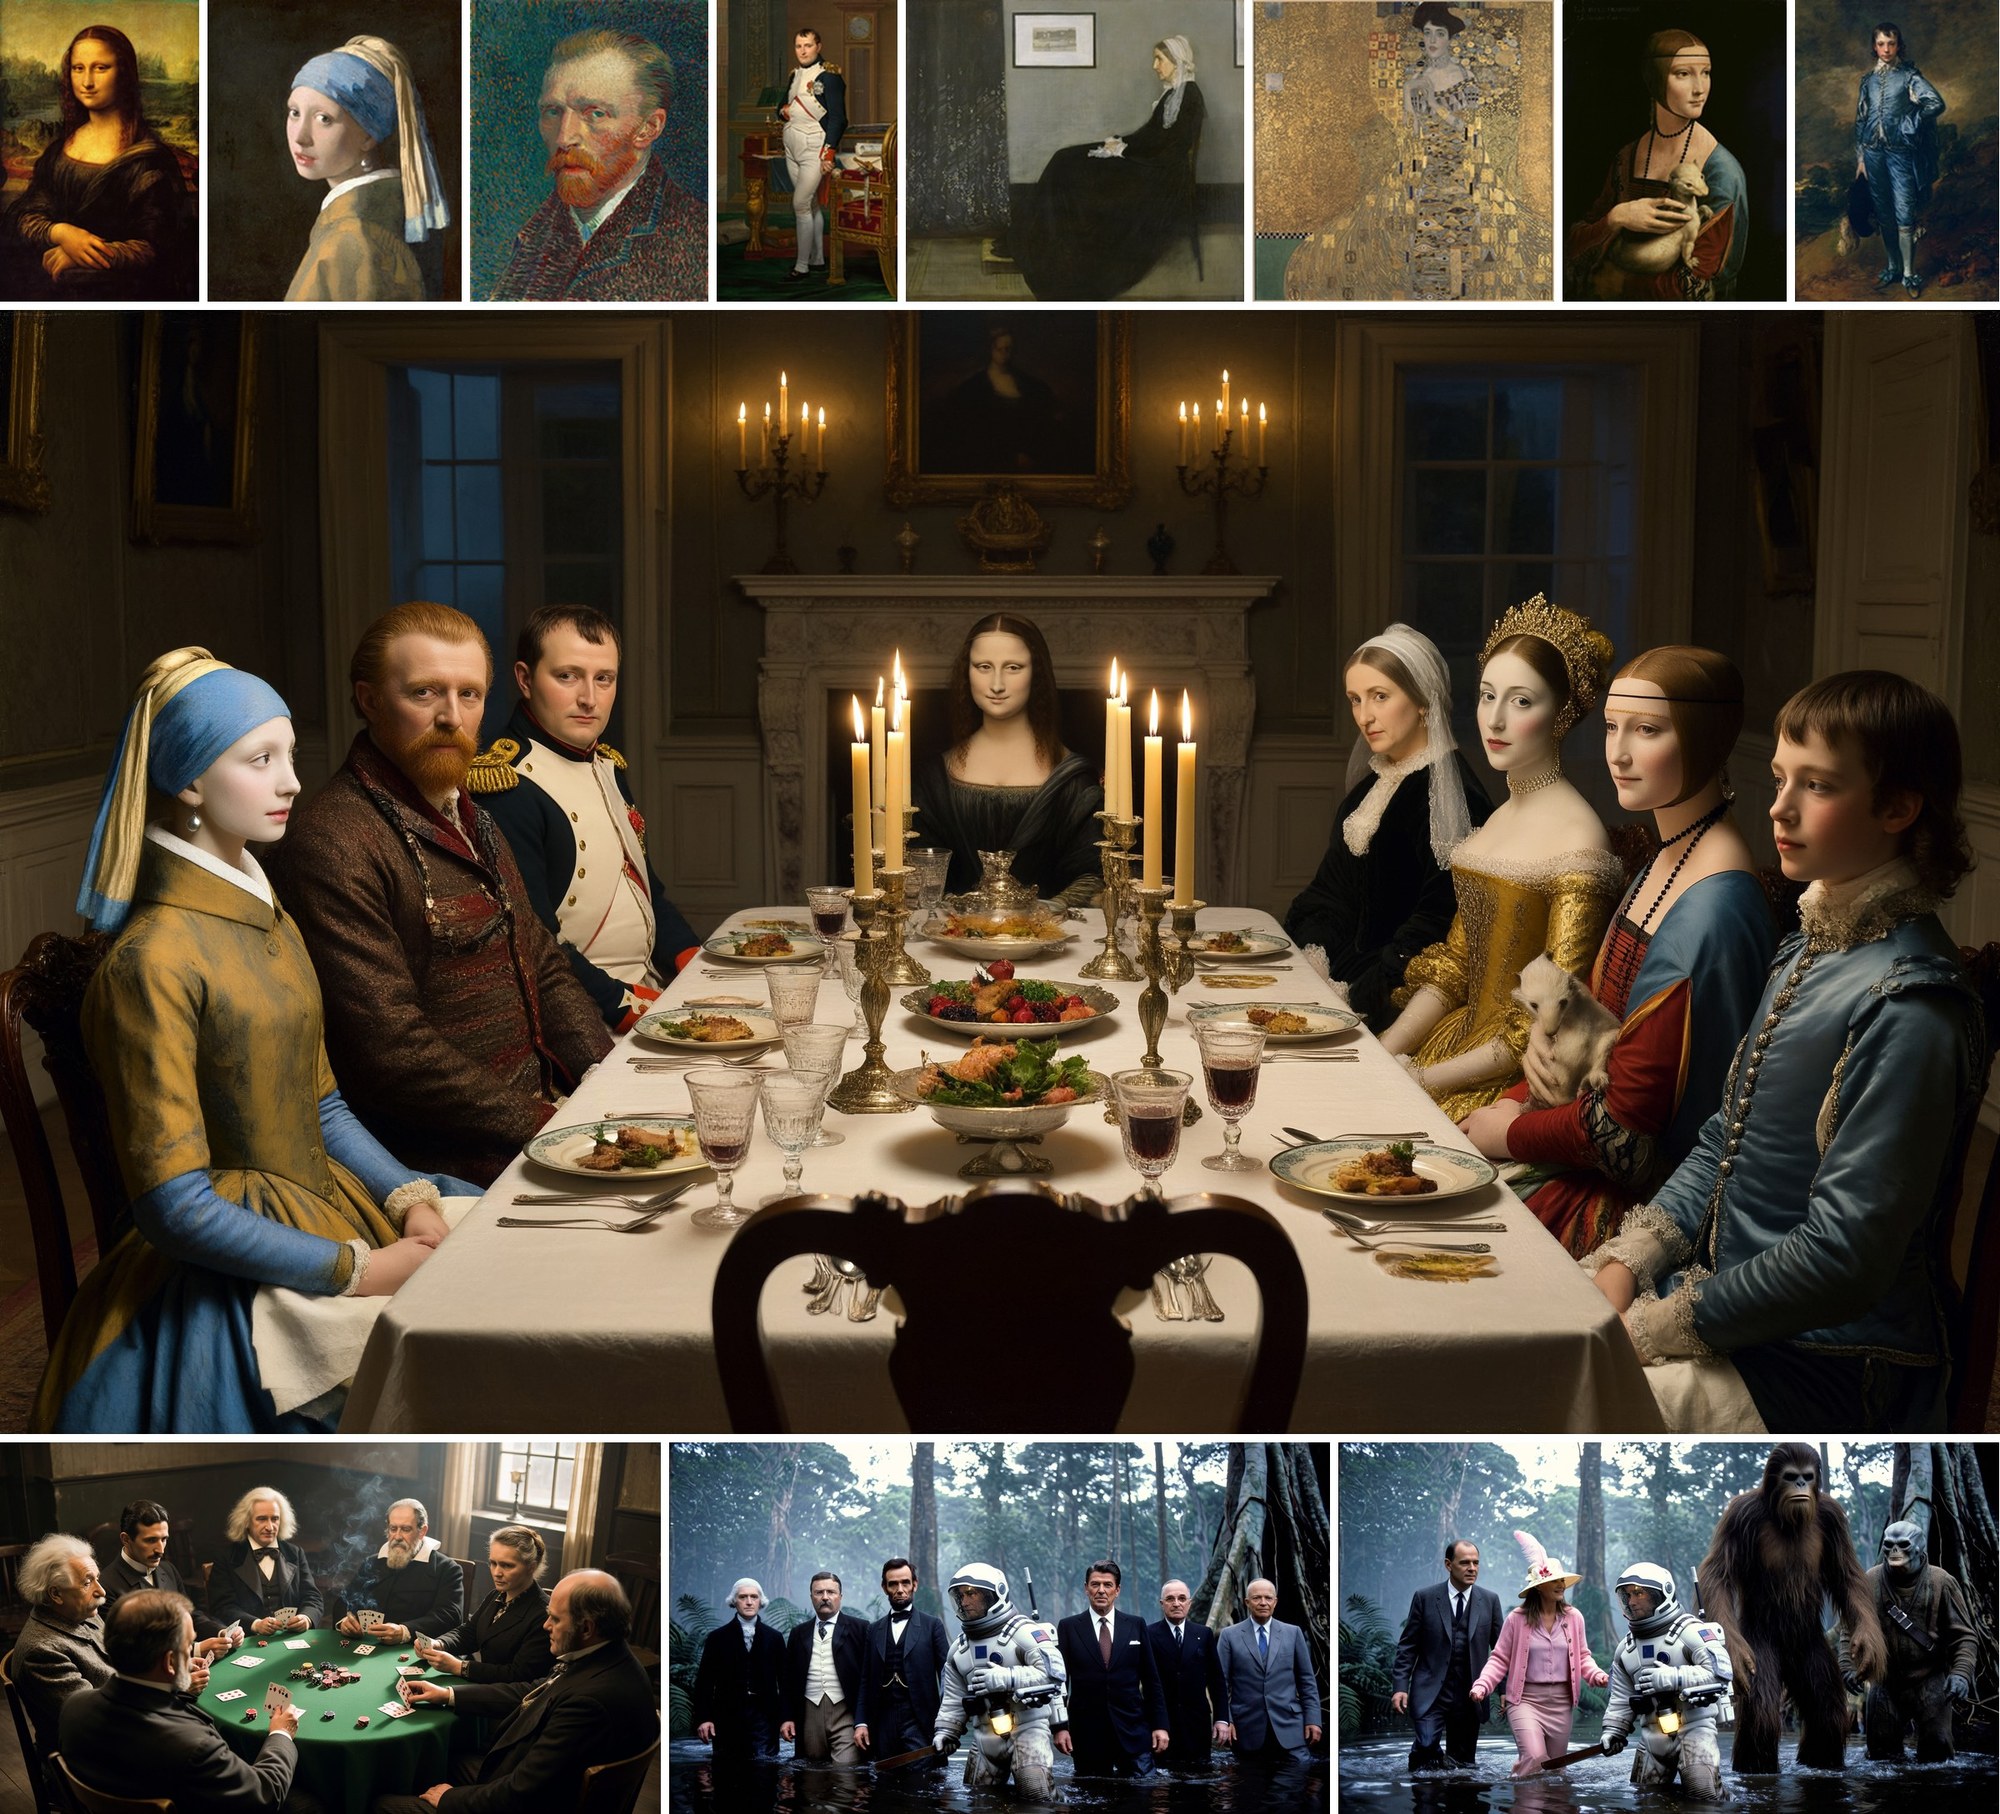
Huit portraits du domaine public et la scène de dîner que P-H3-Image a composée à partir d'eux en une seule requête.
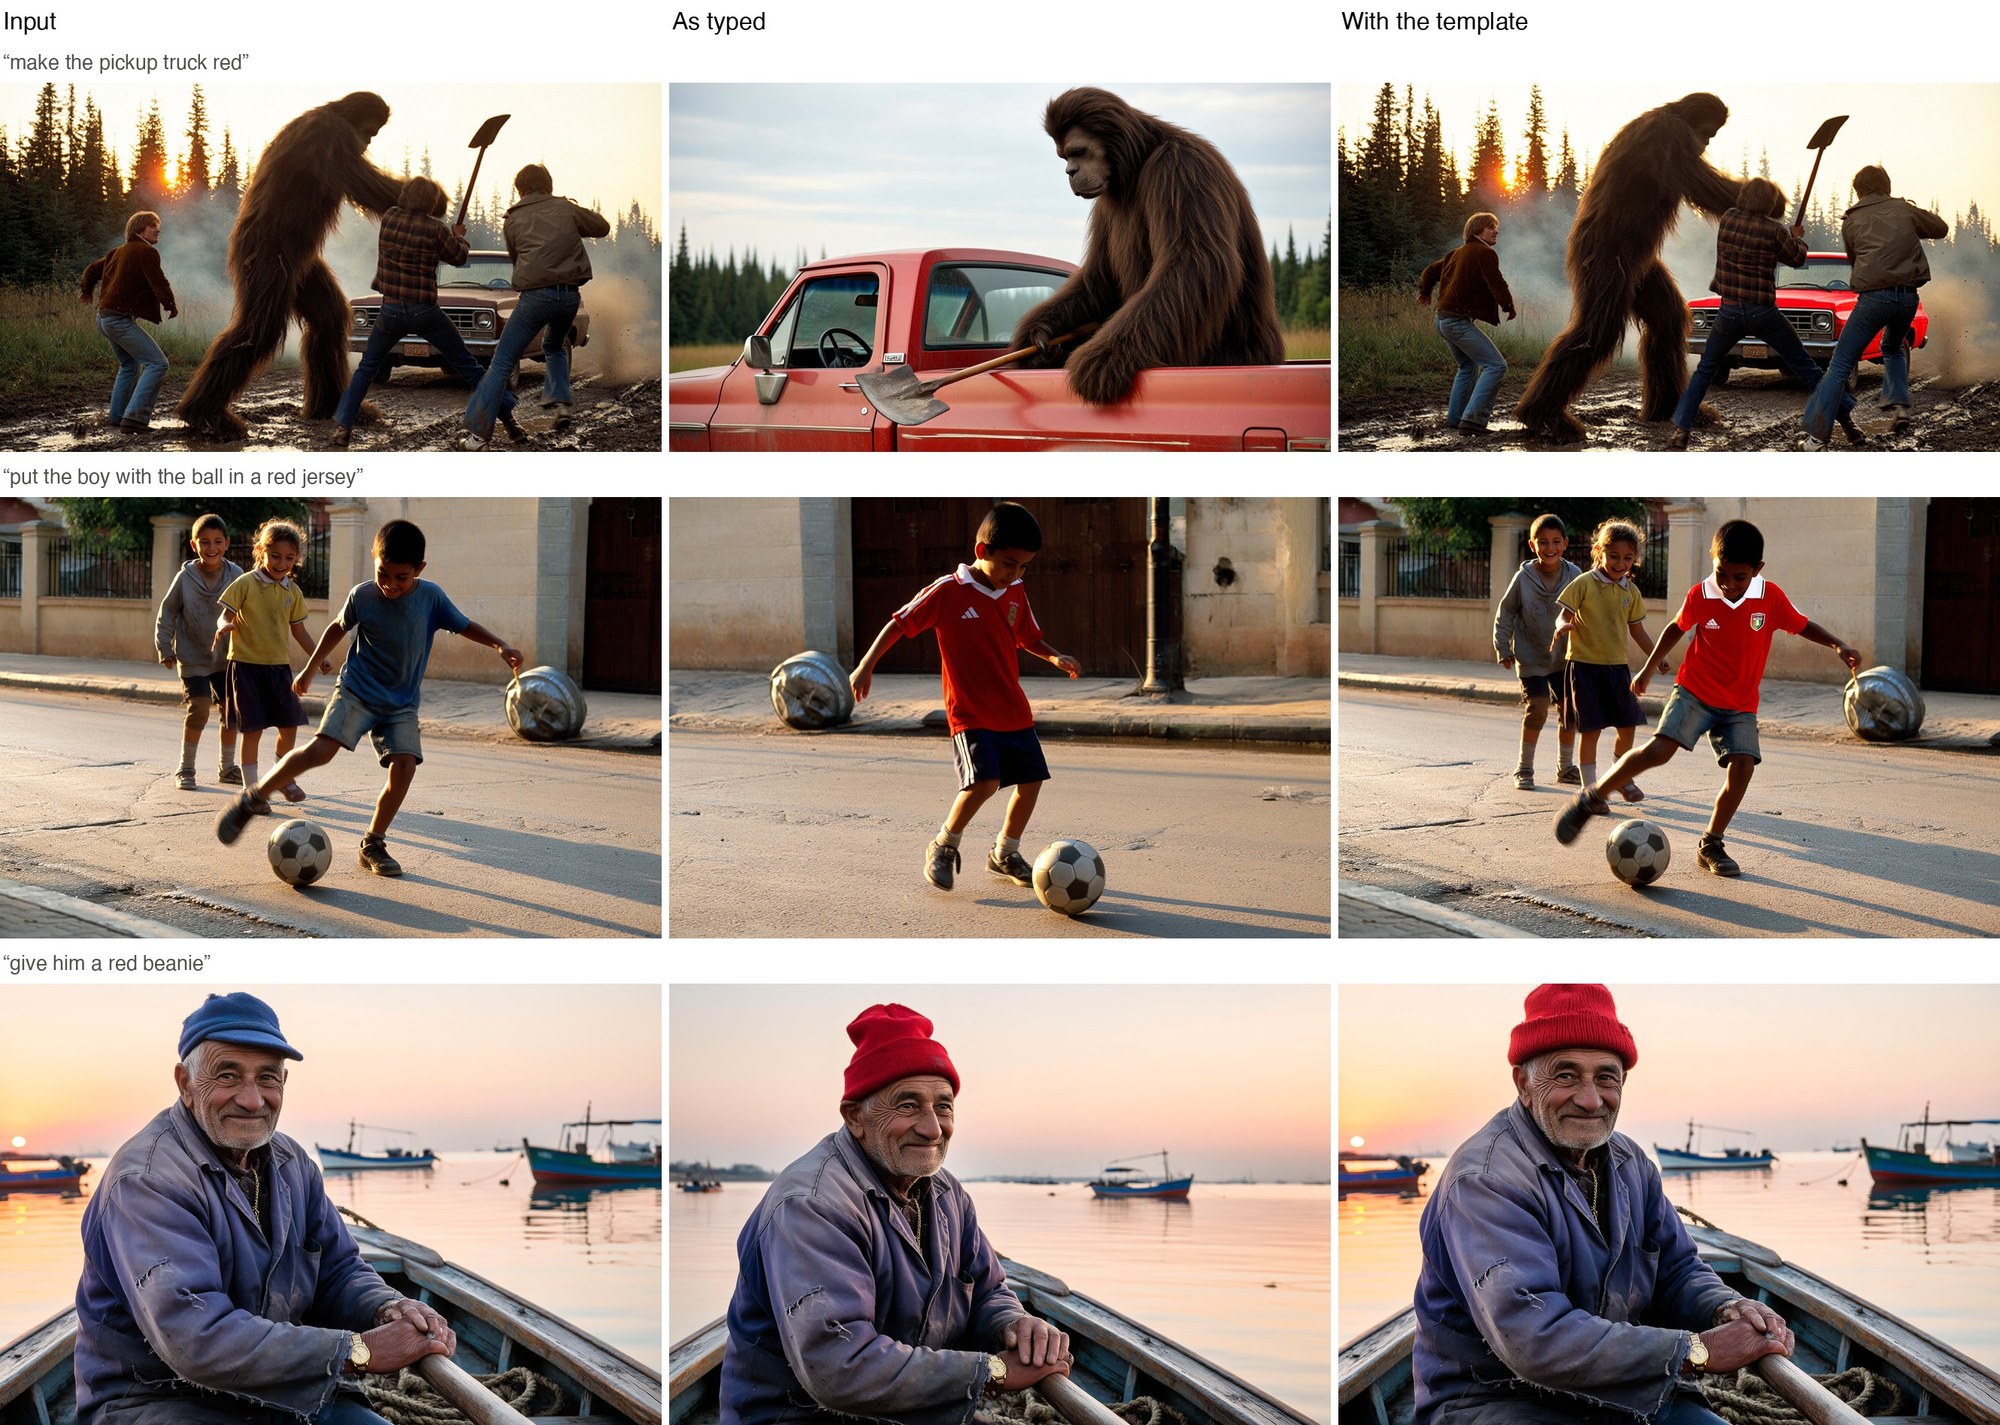
Sorties de retouche issues de la fiche officielle.
8 MP, le point de fonctionnement
Le modèle est entraîné pour 8 MP et la fiche indique sans détour que 2 et 4 MP donnent de moins bons résultats, les artefacts étant plus visibles sur les visages, les mains et les petits détails. La taille texte-image par défaut est 2912 x 2912, et les côtés sont arrondis à des multiples de 32.
| Format d'image | 8 MP (largeur x hauteur) | 4 MP, pour les retouches |
|---|---|---|
| 1:1 | 2912 x 2912 | 2048 x 2048 |
| 4:3 | 3360 x 2496 | 2368 x 1760 |
| 3:4 | 2496 x 3360 | 1760 x 2368 |
| 3:2 | 3552 x 2368 | 2496 x 1664 |
| 2:3 | 2368 x 3552 | 1664 x 2496 |
| 16:9 | 3872 x 2176 | 2720 x 1536 |
| 9:16 | 2176 x 3872 | 1536 x 2720 |
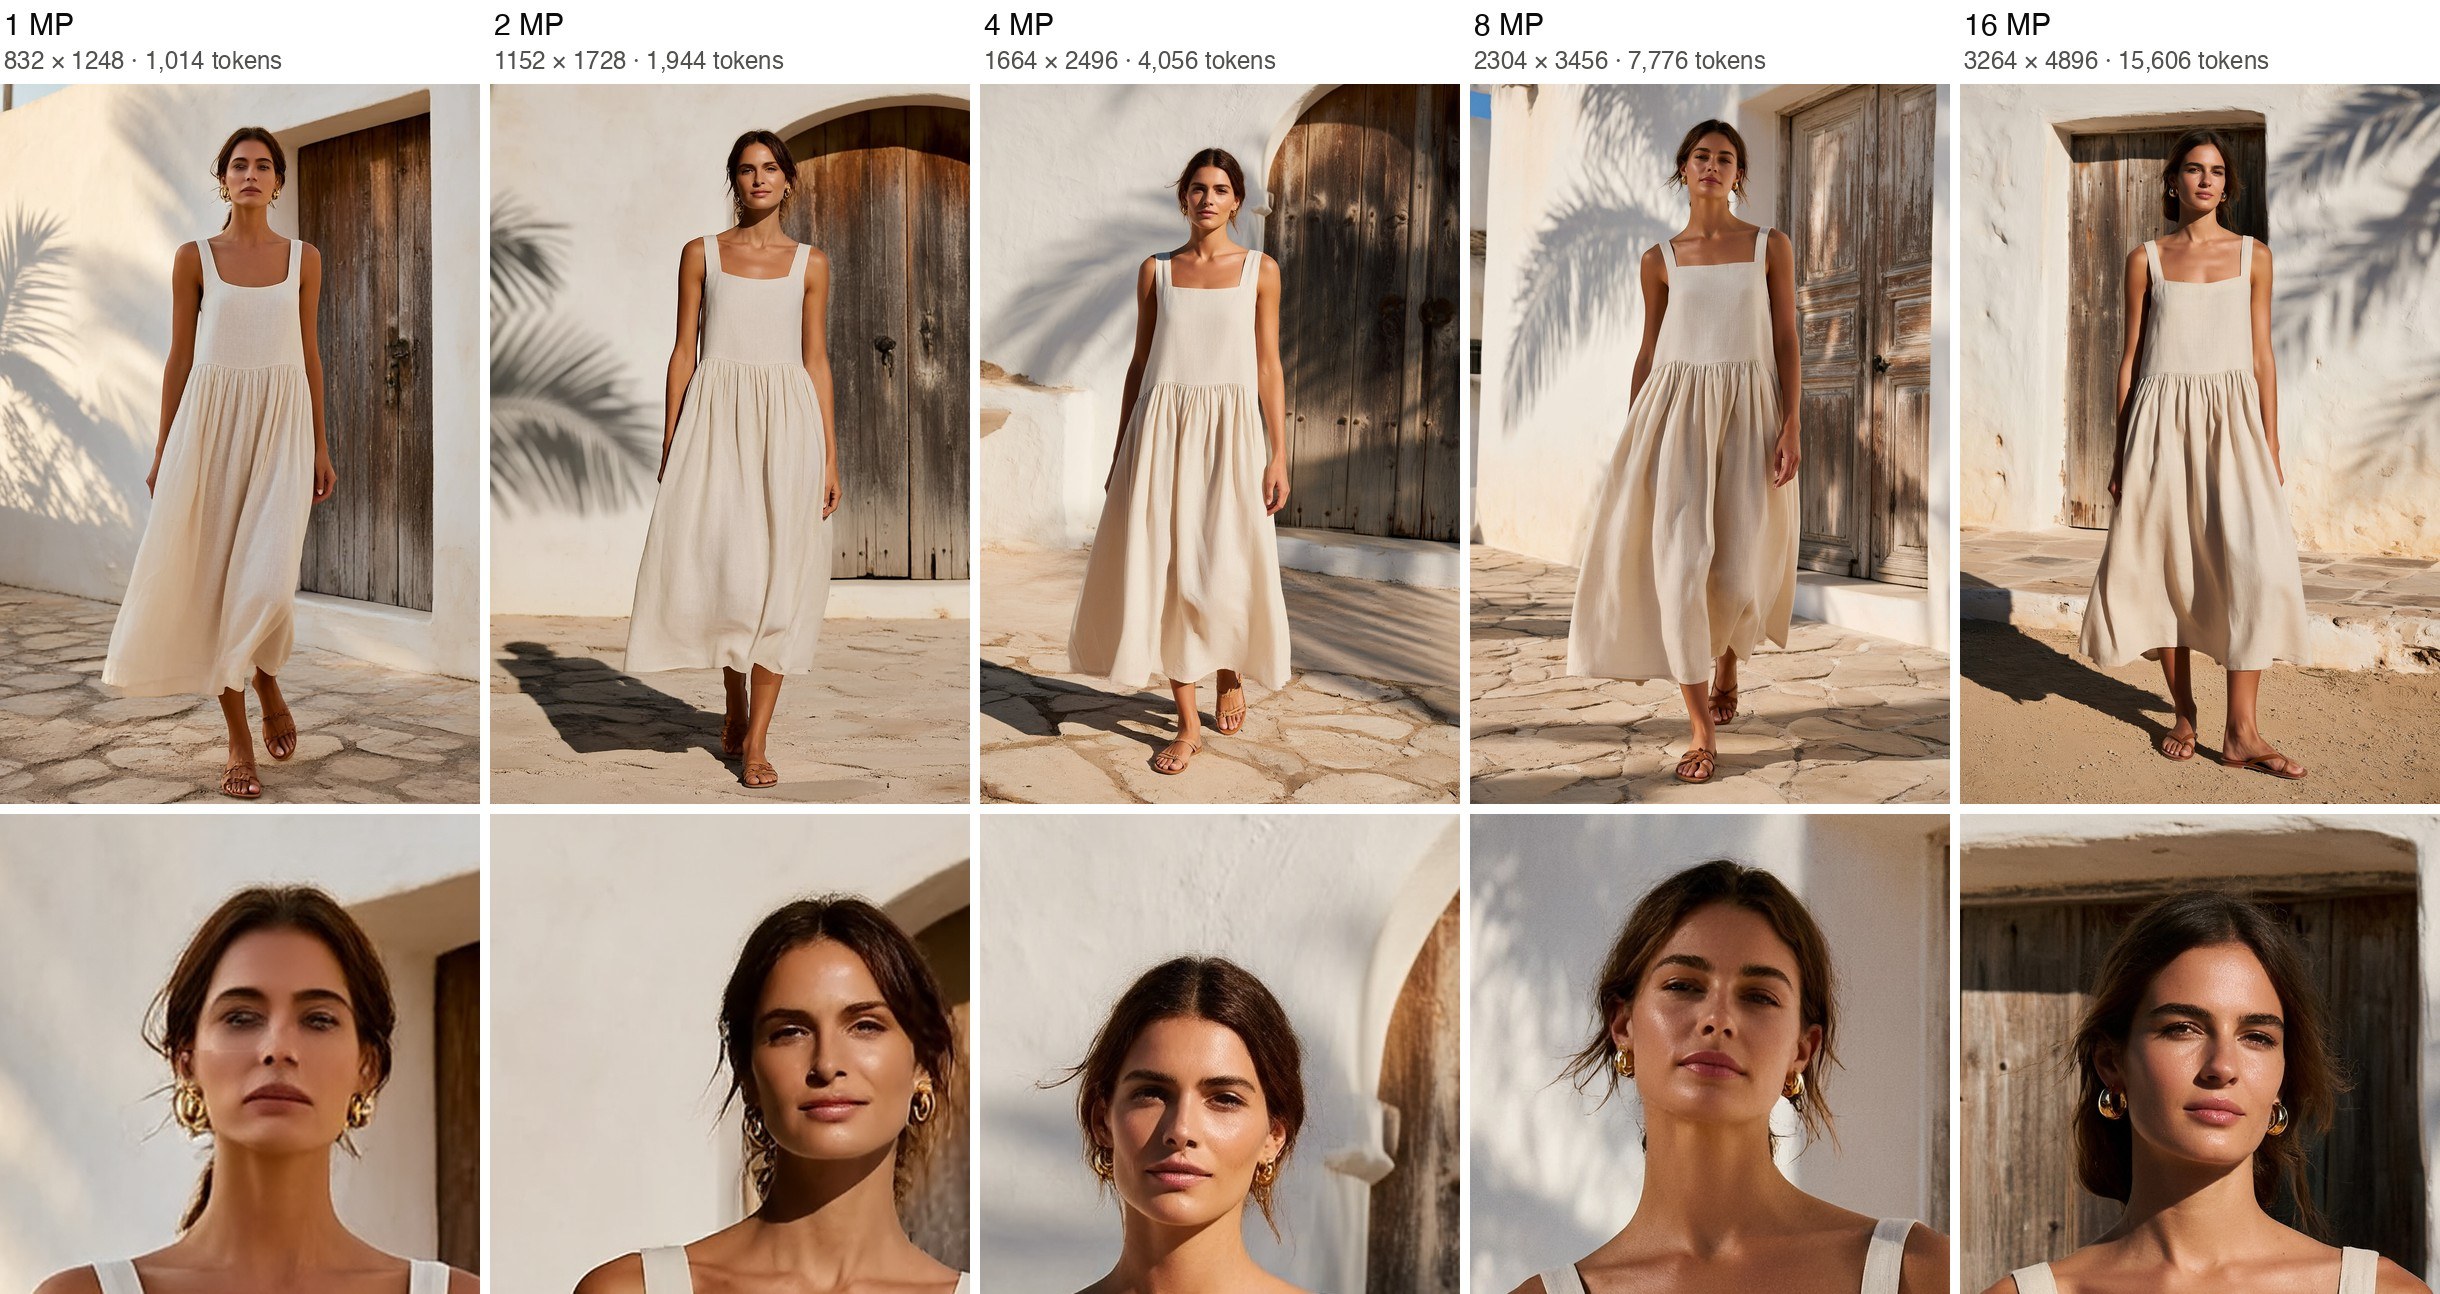
Le même prompt et la même graine de 1 à 16 MP, avec le visage agrandi. À 1 MP, la peau est lisse et cireuse ; à partir de 8 MP, la texture, les mèches rebelles et les boucles d'oreilles ressortent.
Les retouches sans largeur et hauteur explicites sont générées à la taille de l'image 1, agrandie jusqu'à au moins 4 MP. Indiquer les deux dimensions change la taille de la toile, pas les images qu'elle contient.
Disponibilité
- Poids et pipeline diffusers : PrunaAI/P-H3-Image
- Fichiers et flux de travail ComfyUI : PrunaAI/P-H3-Image-Comfy
- Démo navigateur : PrunaAI/P-H3-Image sur Hugging Face Spaces
- Prise en charge ComfyUI : PR 17506, dans la v0.44.0
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.