NitroFusion2 : Z-Image-Turbo en 1 étape avec workflows ComfyUI
NitroFusion2 distille Z-Image-Turbo en une ou deux étapes, avec des workflows ComfyUI natifs, des GGUF dès 2,0 Go et des int8 environ 1,7x plus rapides.
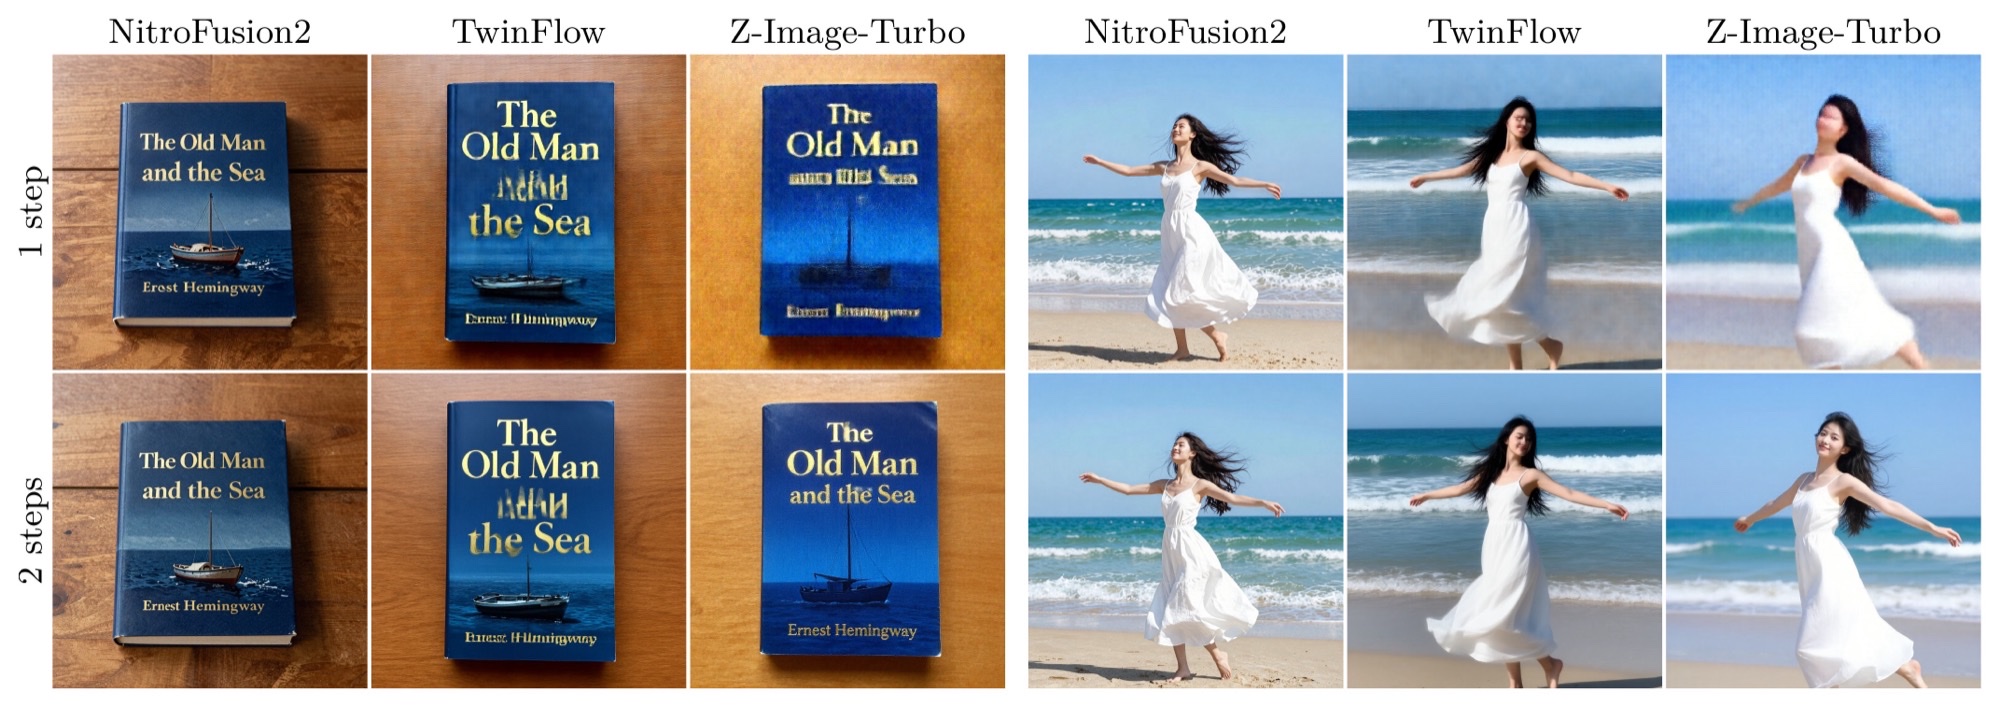
Même prompt et même graine : Z-Image-Turbo face à NitroFusion2 à une et deux étapes. Extrait de la carte du modèle.
Ce qui a changé
Le modèle de base tourne déjà en huit étapes. NitroFusion2 le pousse à une seule en déplaçant la perte adversariale sur le flux texte du MMDiT : au milieu du réseau, les tokens de texte ont lu l'image et contiennent un résumé de ce qui a été généré, si bien qu'un discriminateur entraîné à cet endroit voit la vision du prompt lui-même sur l'image. L'effet concret est que la typographie et les petits détails survivent mieux à une seule étape qu'une simple distillation du nombre d'étapes n'y parvient habituellement.
L'exécuter
Trois fichiers dans les dossiers standard de ComfyUI, puis un flux de travail :
nf2-bf16.safetensors(12,31 Go) dansmodels/diffusion_models/qwen_3_4b.safetensorsdansmodels/text_encoders/, chargé enlumina2ae.safetensorsdansmodels/vae/
Une étape s'exécute en euler / simple, CFG 1, shift 3. Deux étapes passent à shift 6 et ajoutent le LoRA de dé-distillation à 0,5 pour la première étape uniquement, puis 0,0 pour la seconde ; le flux de travail officiel en deux étapes procède ainsi avec deux passes d'échantillonnage.
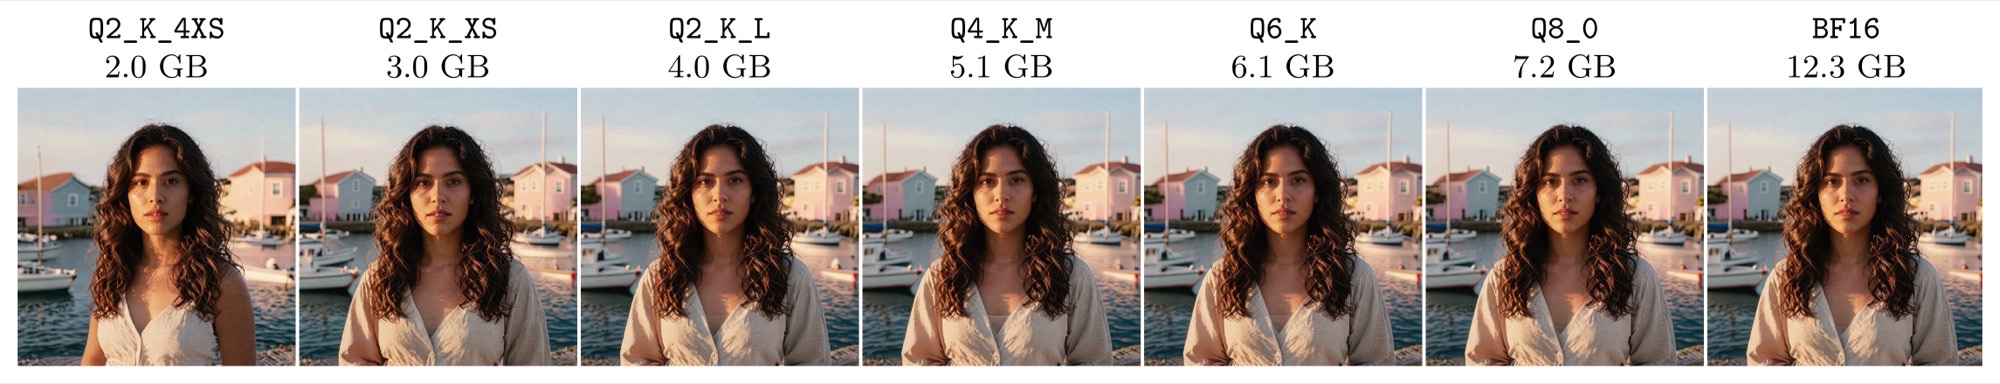
Les paliers GGUF publiés sur un prompt et une graine, de la précision haute à basse. Extrait de la carte du modèle.
Des fichiers plus légers
Le référentiel contient des GGUF allant de nf2-Q2_K_4XS (2,0 Go) à nf2-Q8_0 (7,2 Go), chacun avec son propre flux de travail en une et deux étapes sur la page du modèle. Un ensemble ComfyUI tiers ajoute des quantifications natives ComfyUI du même fichier nf2-bf16, mesurées en 1024² sur une 4090 (PedroMarinhoDev/NitroFusion2-ComfyUI) :
| Fichier | Taille | 1 étape, 4090 | Erreur de prédiction vs bf16 |
|---|---|---|---|
| bf16 | 12,31 Go | 0,50 s | 0 |
| int8 ConvRot | 6,18 Go | 0,29 s | 13,4 % |
| W6A8 | 5,02 Go | 0,30 s | 17,5 % |
| W4A8 | 3,49 Go | 0,29 s | 33,6 % |
Cette erreur est relative à la prédiction bf16 sur 12 prompts x 4 échantillons de bruit, et l'auteur indique qu'elle se concentre presque entièrement dans les textures fines plutôt que dans la composition, les visages ou le texte. À lire comme un classement entre les trois fichiers, pas comme un score de qualité absolu.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.