Anima RGBA offre un véritable canal alpha à Anima dans ComfyUI
Anima RGBA associe un VAE Qwen-Image 4 canaux à un LoRA Anima pour générer des PNG transparents dans ComfyUI sans nœuds personnalisés, avec une MAE alpha de 0,0027.
transparent background dans le prompt, et VAE Decode renvoie du RVB direct plus un alpha que Save Image écrit sous forme de PNG RGBA. Aucun nœud personnalisé.
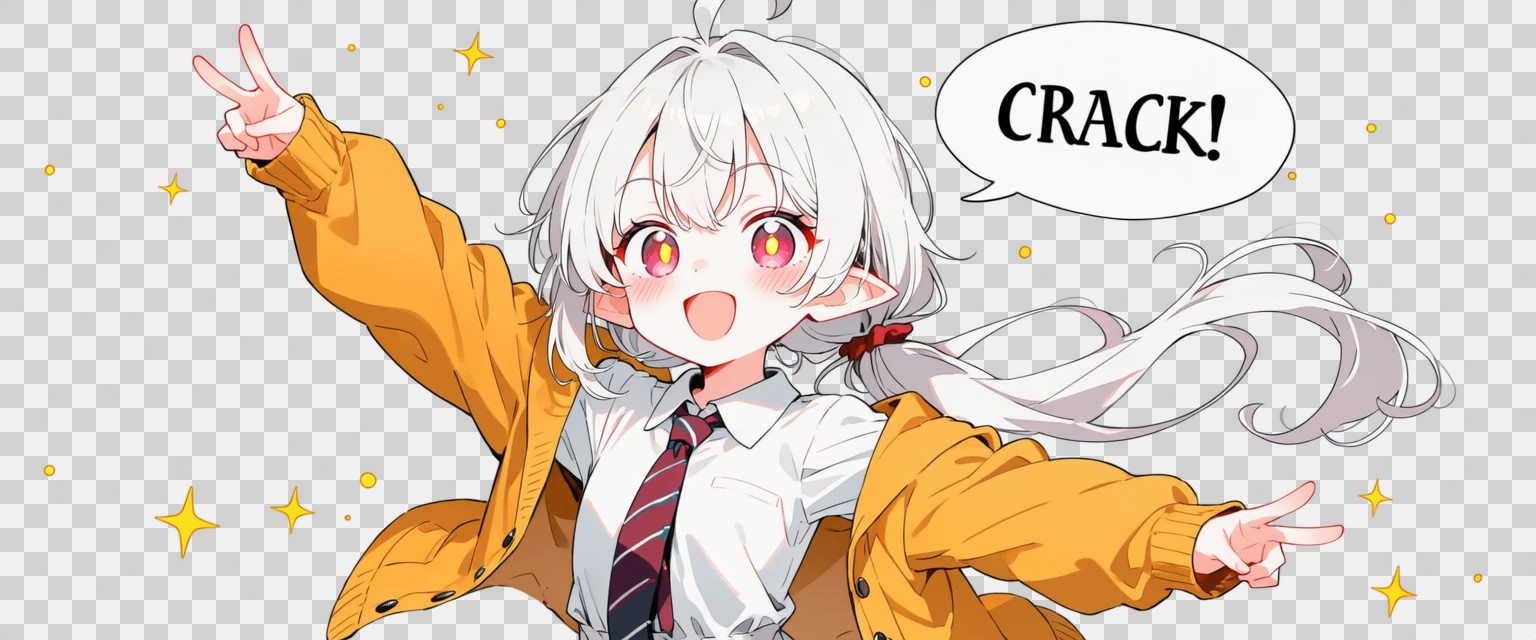
Généré avec le VAE RGBA et le LoRA, affiché sur un damier.
Anima utilise le VAE Qwen-Image, qui décode en trois canaux. Demander au modèle un arrière-plan transparent produit donc un sujet dessiné sur un arrière-plan que le modèle a été prié d'imaginer vide, et le détourage est réalisé ensuite par une passe de matting. Un VAE RGBA déplace cette opération dans le décodeur : la dernière couche possède simplement quatre canaux au lieu de trois.
Transformer un VAE à 3 canaux en VAE à 4 canaux
L'astuce est plus modeste qu'elle n'en a l'air. Le VAE conserve son latent à 16 canaux en résolution 1/8, donc rien ne change dans l'espace latent d'Anima. L'encodeur prend le RVB composé sur blanc plus un canal alpha ; le décodeur produit du RVB direct, non prémultiplié, plus l'alpha.
L'initialisation fait le reste : les poids à 3 canaux sont copiés, la nouvelle colonne d'entrée alpha démarre à zéro, et la nouvelle ligne de sortie alpha démarre à zéro avec un biais de +1, si bien qu'avant tout entraînement le modèle reproduit le VAE d'origine et décode tout comme opaque. L'entraînement tire ensuite le nouvel encodeur vers les latents de l'original gelé pour le même composite blanc, ce qui maintient l'espace latent là où Anima travaille déjà et ne laisse au LoRA qu'un petit résidu alpha à apprendre.
La composition sur blanc est un choix délibéré : le RVB n'est pas défini là où l'alpha est nul, et un composite blanc est ce qu'Anima dessine déjà pour les prompts d'arrière-plan transparent, donc les latents RGBA restent proches de ceux que produit le modèle de base. La dérive mesurée est une distance RMS de 0,058 en unités de l'écart-type du latent, soit environ 6 % d'un sigma, et c'est cet écart que le LoRA comble.
Ce que disent les chiffres
Le VAE a été entraîné pendant 12 000 étapes avec un lot de 4 sur des recadrages de 512 px, avec une perte L1 sur le composite par rapport à des arrière-plans unis aléatoires, LPIPS à 0,2, la L1 alpha, un terme de gradient de Sobel alpha, et une MSE des latents de référence par rapport à l'encodeur d'origine ; 15 % de chaque lot était constitué d'images opaques servant de régularisation. Sur un ensemble de validation de 200 images transparentes et 50 images opaques en 512 px, dont aucune n'a servi à l'entraînement :
| Métrique | Valeur |
|---|---|
| MAE alpha | 0,0027 (environ 0,7 / 255) |
| RMSE alpha | 0,0157 (environ 4 / 255, concentré sur les arêtes) |
| PSNR composite sur blanc | 34,94 dB |
| PSNR composite sur noir | 33,17 dB |
| PSNR opaque, VAE Qwen-Image d'origine | 34,26 dB |
| PSNR opaque, VAE Anima RGBA | 34,74 dB |
La reconstruction opaque est légèrement meilleure que l'original plutôt que légèrement moins bonne, et c'est là le résultat utile : remplacer le VAE ne coûte rien sur les images ordinaires.
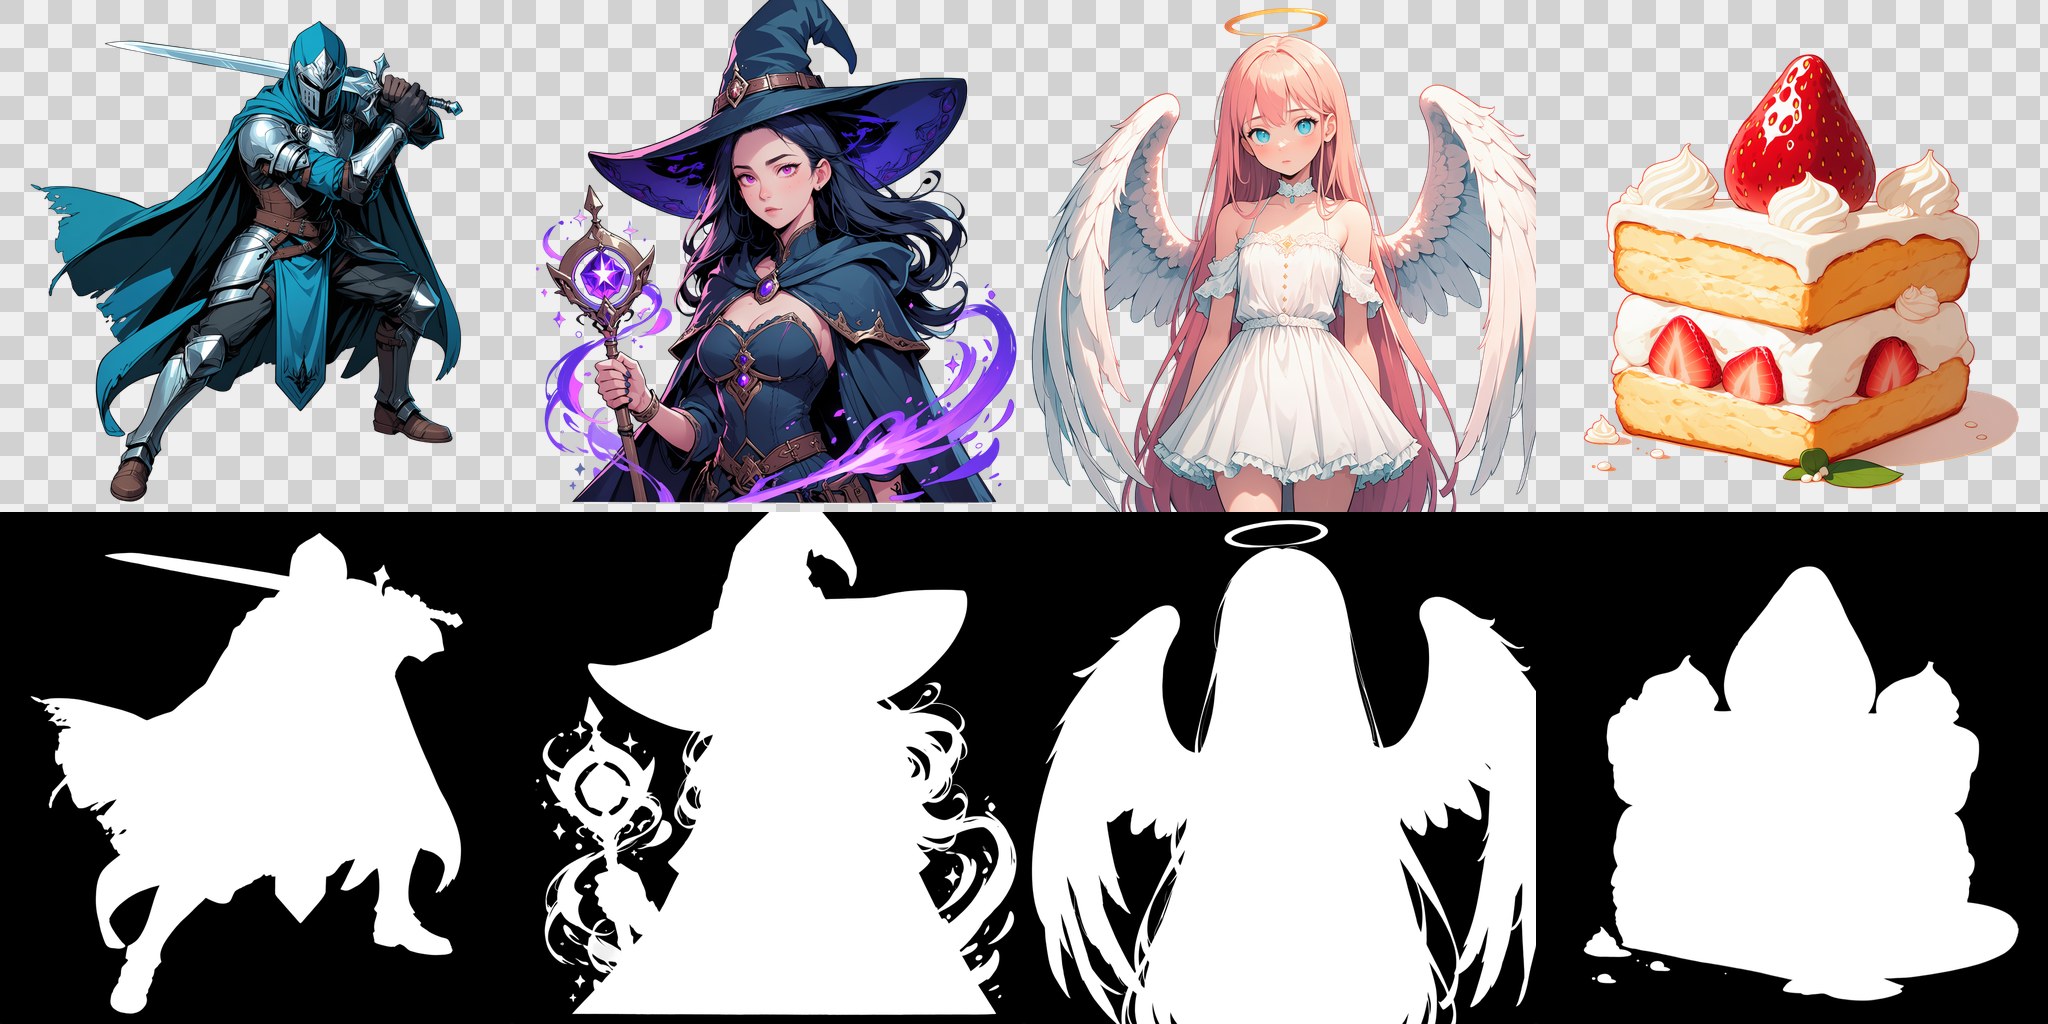
Ligne du haut : sortie RGBA sur un damier. Ligne du bas : le canal alpha seul.
Pourquoi le LoRA reste nécessaire
Sans lui, le VAE produit toujours un canal alpha, mais un canal brumeux : les personnages et les vêtements blancs ressortent partiellement transparents, car les latents du modèle de base ne correspondent qu'approximativement à ce qu'attend le nouveau décodeur. Le LoRA est entraîné sur les latents de ce VAE, au rang 32, sur 25 000 étapes, avec 18 426 images et l'encodeur de texte Qwen3 ainsi que l'adaptateur LLM gelés. Les images transparentes sont légendées avec deux lignes de déclenchement alternées, transparent background et isolated on a transparent background, tandis que les images de régularisation opaques ne portent aucun déclencheur.
Le tableau de test de la carte du modèle, 8 prompts par 2 graines en 1024 x 1024, montre ce qui se passe lorsqu'on touche aux réglages :
| Force du LoRA | Poids du déclencheur | Transparent | Pixels semi-transparents |
|---|---|---|---|
| aucune | 1,0 | 16 / 16 | 12,8 % |
| 1,0 | 1,0 | 16 / 16 | 0,9 % |
| 1,2 | 1,0 | 16 / 16 | 1,0 % |
| 1,5 | 1,0 | 16 / 16 | 1,4 % |
| 1,0 | 1,2 | 16 / 16 | 0,9 % |
| 1,0 | 1,5 | 16 / 16 | 0,9 % |
Chaque réglage produit un résultat transparent, donc le chiffre qui compte est la part de pixels semi-transparents parasites : 12,8 % sans LoRA contre 0,9 % avec les valeurs par défaut. Pousser le LoRA à 1,5 n'aide pas et ajoute des débris semi-transparents et de la fumée autour du sujet ; pousser plutôt le poids du déclencheur laisse l'image et l'alpha presque inchangés. C'est l'inverse de l'instinct habituel, et la carte le dit clairement : augmentez le poids du déclencheur, pas la force du LoRA.
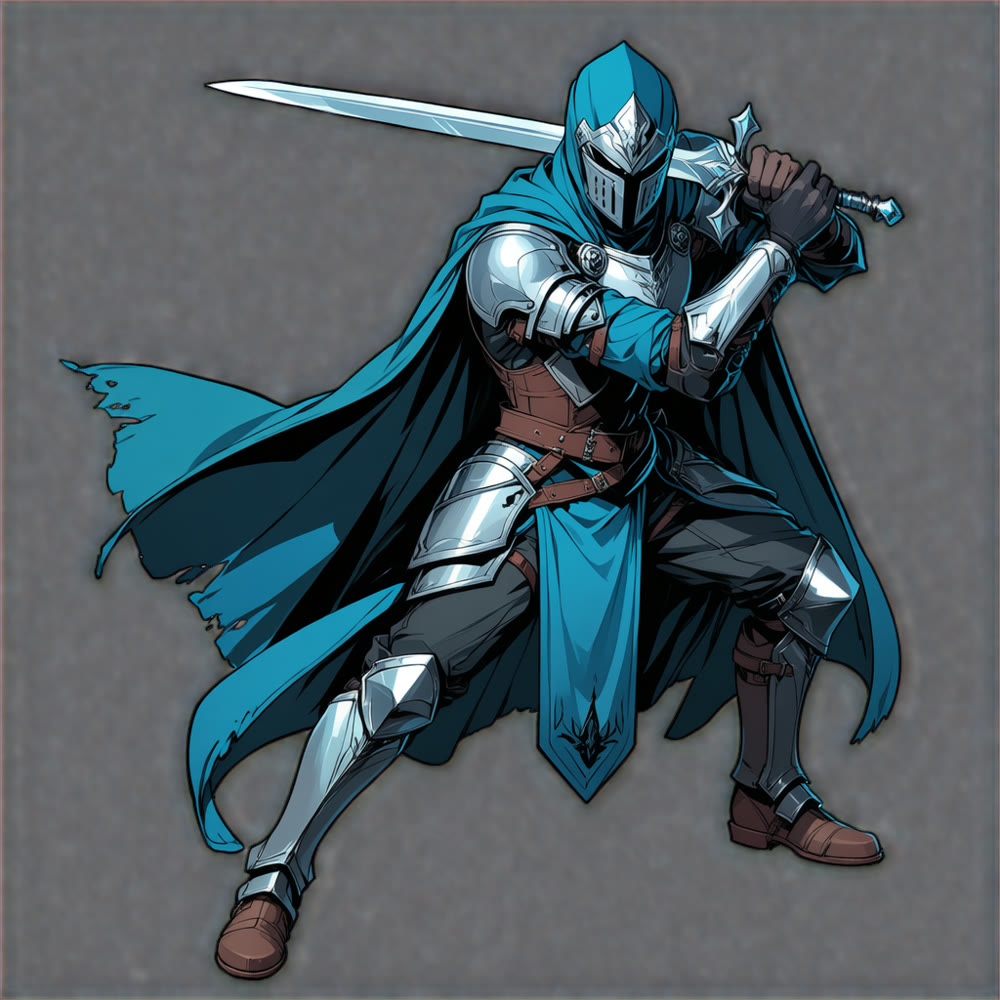
Un personnage en pied à LoRA 1,0, 30 étapes, CFG 4,5, er_sde avec simple.
Les limites
Le VAE a été entraîné sur des recadrages de 512 px et décode à des résolutions plus élevées, mais les détails semi-transparents fins comme les mèches de cheveux, le verre et la fumée constituent son point faible. L'alpha généré est essentiellement binaire, donc les vêtements translucides ressortent généralement opaques. Les gros plans qui remplissent le cadre conservent parfois un arrière-plan blanc opaque, plus souvent lorsque d'autres LoRA sont empilés. Il est conçu pour le contenu anime et illustration, ce que dessine Anima.
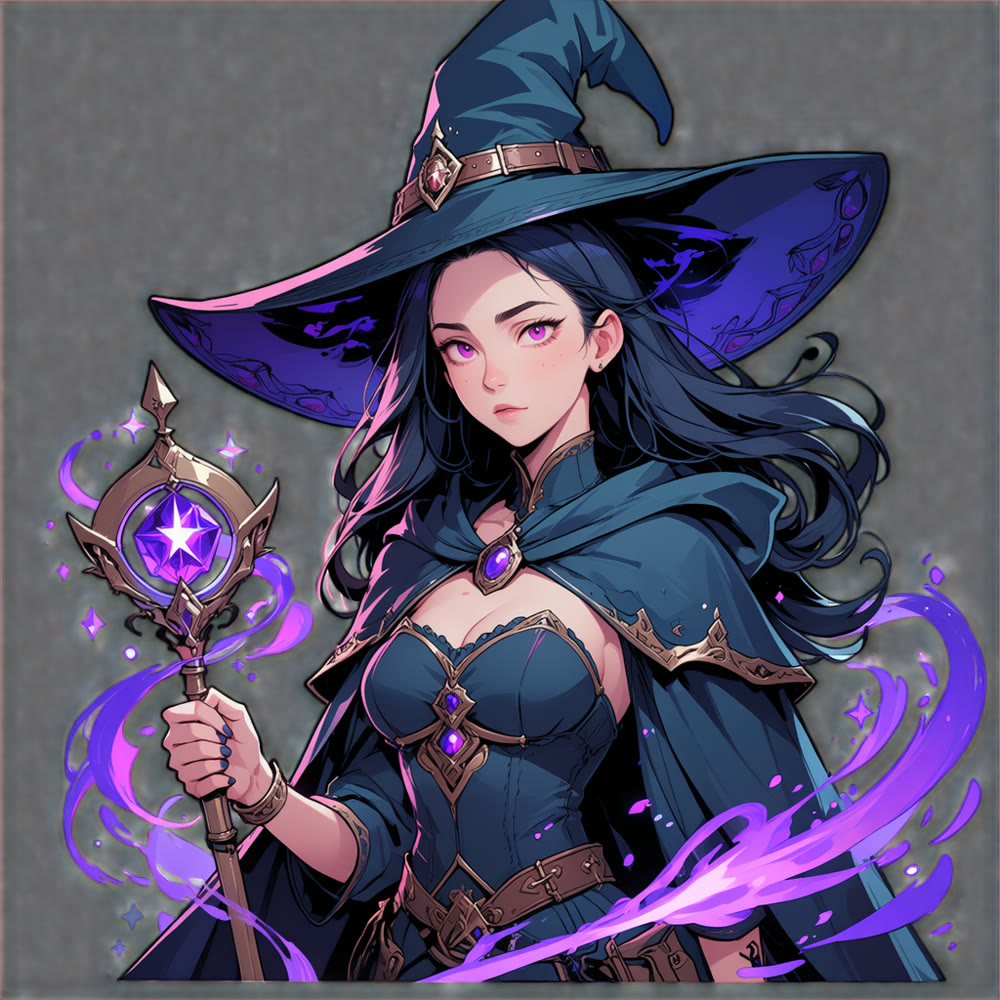
La même recette sur un autre sujet, l'alpha préservé à travers le chapeau et le bâton.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.