Lightning v2 RL : Qwen-Image 2.1 en 4 étapes, affiné par RL
Lightning v2 RL de LightX2V remplace l'adaptateur de 67 Mo par un transformer Qwen-Image 2.1 complet distillé en 4 étapes et affiné par apprentissage par renforcement.
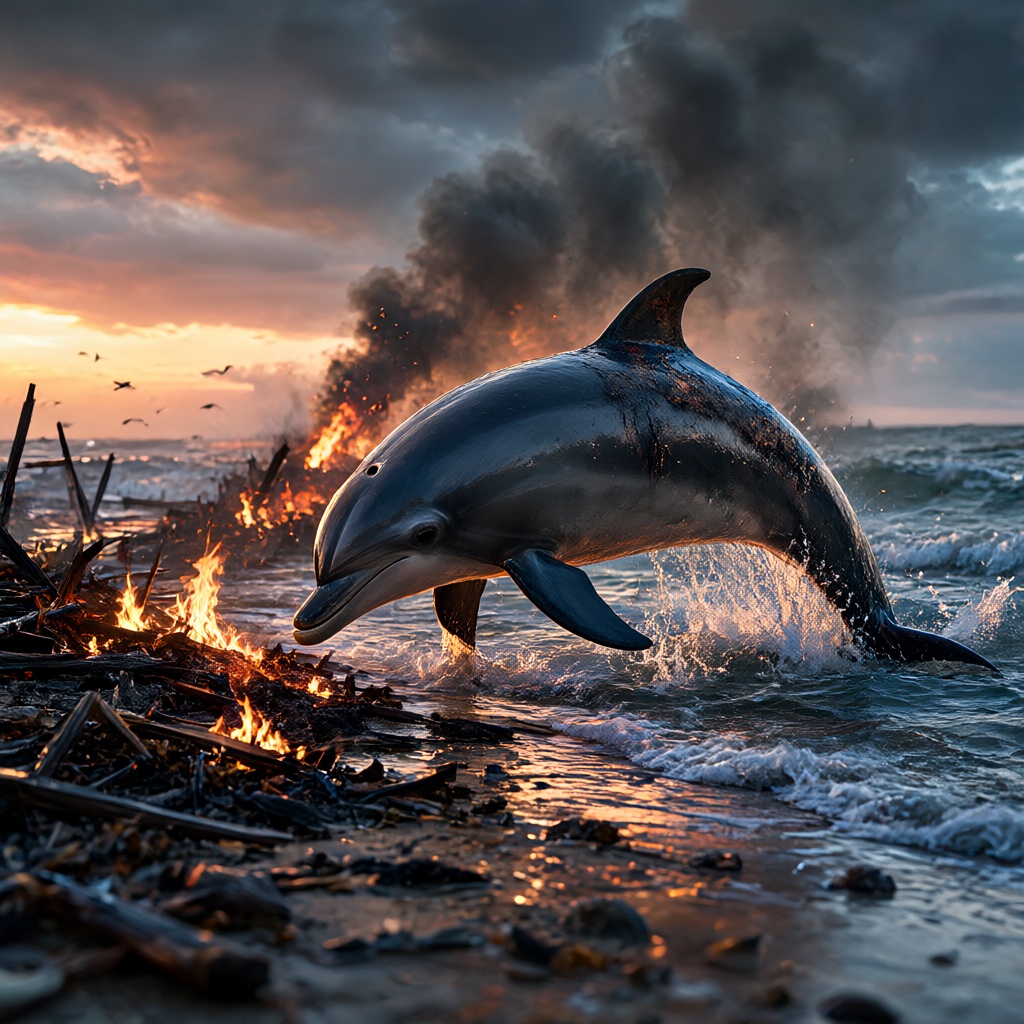
Un rendu 1024 x 1024 du checkpoint RL en quatre étapes, « Dauphin sur un rivage en feu ».
Ce qui change par rapport au LoRA
La version d'octobre attachait un adaptateur de 67 Mo au checkpoint Qwen-Image 2.1 d'origine et reposait sur une liste de sigmas fixe au moment de l'échantillonnage. La v2 modifie les deux moitiés de ce dispositif :
- Poids complets du transformer au lieu d'un adaptateur : un unique
diffusion_pytorch_model.safetensorsstocké en FP32 (28,5 Go) avec son propreconfig.json, décrit dans la carte du modèle comme chargeable en BF16 pour l'inférence. Il n'y a pas de LoRA à empiler. - Une étape d'apprentissage par renforcement après la distillation. La carte décrit le checkpoint comme la version affinée par RL de Lightning v2, entraînée avec LightX2V RL. Seul le checkpoint affiné est publié, les poids v2 d'avant le RL ne sont donc pas disponibles pour comparaison.
- Trois tâches à partir d'un seul checkpoint : texte-vers-image, édition à référence unique et génération multi-référence, que la v1 visait également.
Le programme en quatre étapes
La configuration d'échantillonnage est fournie sous le nom inference_config.json, et ce n'est pas le programme uniforme qu'utilisait le LoRA v1. La v2 exécute quatre sigmas de 1.0, 0.95418, 0.89508 et 0.704534, avec true_cfg_scale à 1.0 et le cache KV activé :
pipe.scheduler = FlowMatchEulerDiscreteScheduler(
    **inference_config["scheduler"],
)
image = pipe(
    prompt=prompt,
    width=1024,
    height=1024,
    sigmas=SIGMAS,                    # 1.0, 0.95418, 0.89508, 0.704534
    num_inference_steps=len(SIGMAS),
    true_cfg_scale=1.0,
    use_kv_cache=True,
)
Trois étapes se situent au-dessus de 0,89 et la quatrième descend de 0,895 à 0,705 avant que le scheduler ajoute le zéro terminal : l'essentiel du débruitage se produit donc tôt. Le README précise explicitement que régler num_inference_steps=4 seul ne reproduit pas ce programme, et que les sigmas stockés sont déjà décalés, si bien que le décalage dynamique doit rester désactivé.
Quatre étapes contre quarante
Le référentiel associe chaque exemple à une exécution en 40 étapes des poids Qwen-Image 2.1 d'origine, même prompt, même graine, même CFG 1.0 et une sortie en 1024 x 1024.
| Modèle de base, 40 étapes | Lightning v2 RL, 4 étapes |
|---|---|
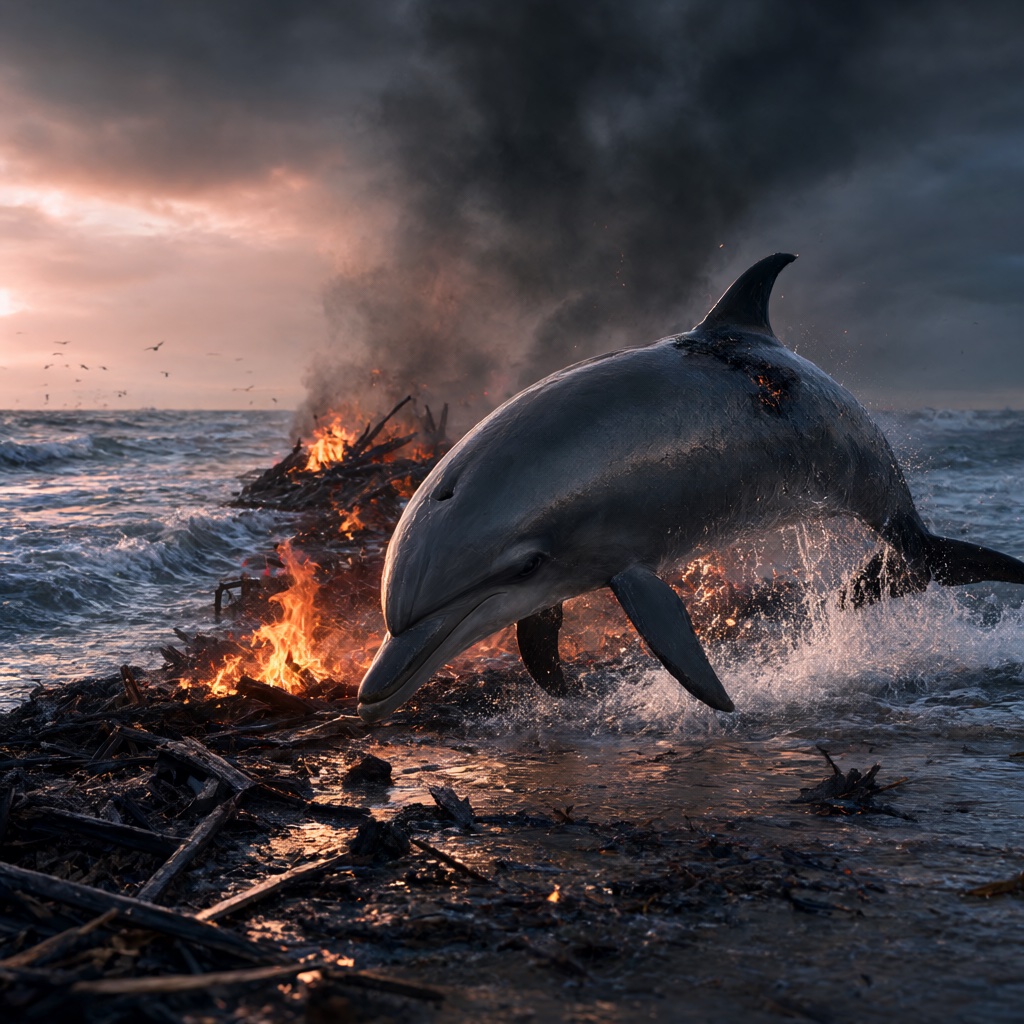 | |
| Dauphin sur un rivage brûlé | Dauphin sur un rivage brûlé |
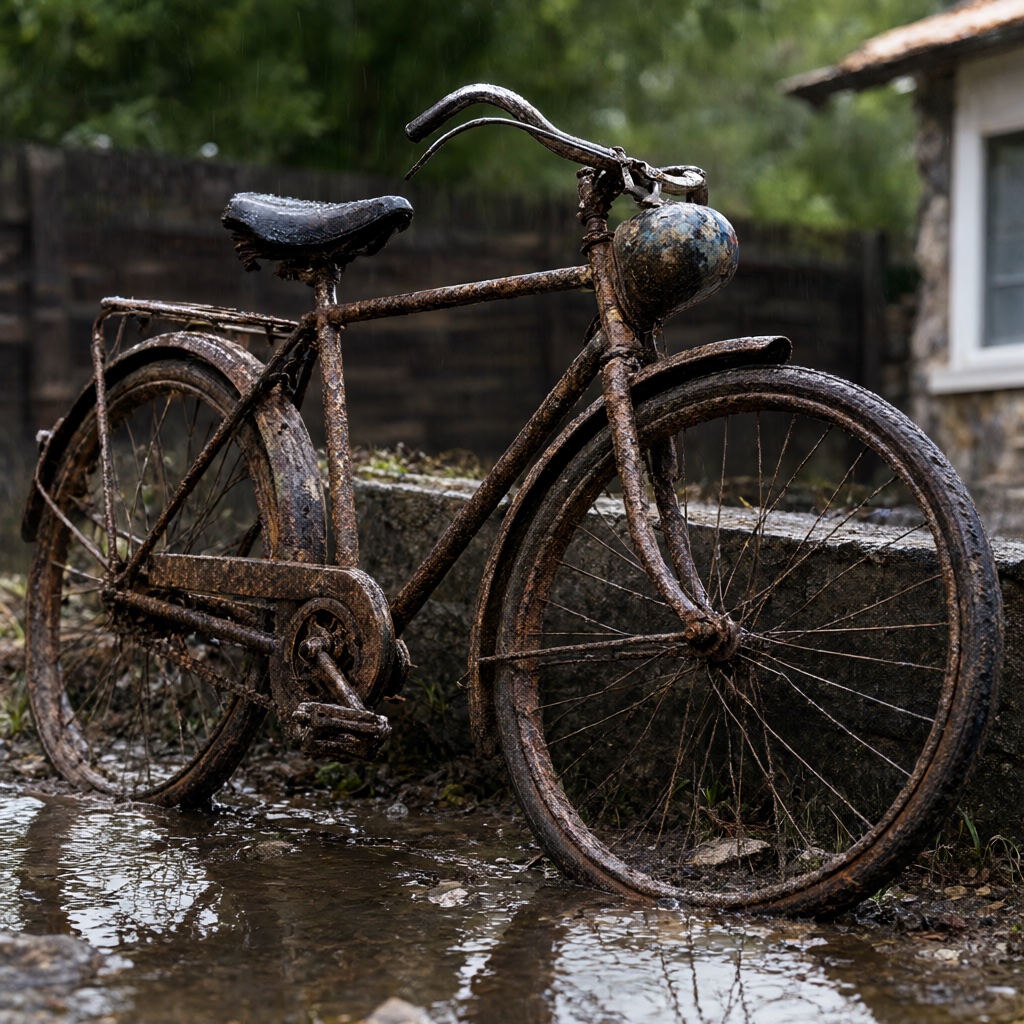 | 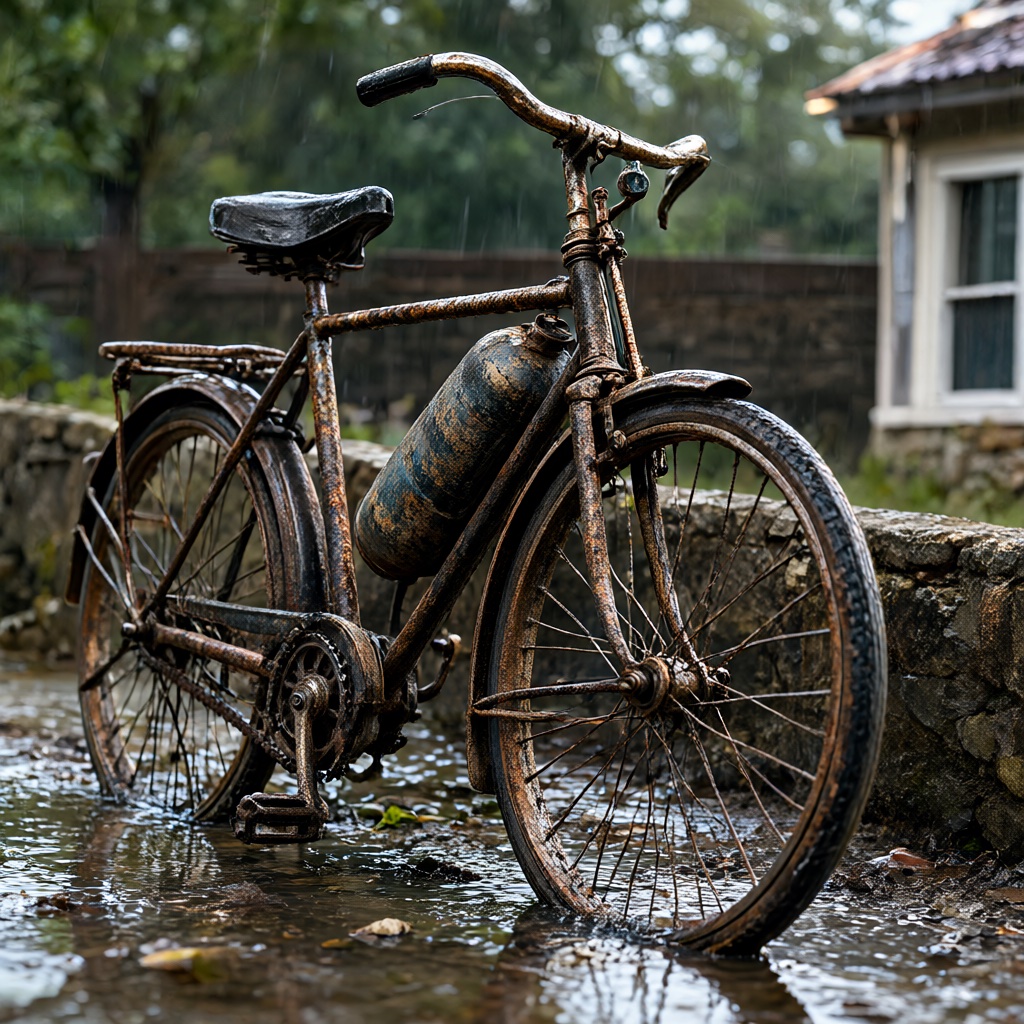 |
| Vélo patiné sous la pluie | Vélo patiné sous la pluie |
Les deux prompts sont de longues descriptions de scène structurées : celui du dauphin détaille la couleur des nuages, les panaches de fumée, les poutres calcinées, le placement des braises et l'éclairage de la nageoire dorsale avant de s'arrêter ; celui du vélo détaille la rouille sur chaque tube du cadre, le nombre de rayons et les traînées de pluie. La carte les présente comme des exemples de validation sélectionnés, et non comme un benchmark, et avertit que le texte fin, l'anatomie, le nombre d'objets et la préservation précise des références peuvent encore nécessiter des vérifications.
Éditer une référence unique
Pour l'édition, l'image de référence est passée comme argument image du pipeline, dans le même appel qui porte l'instruction :
| Référence | Modèle de base, 40 étapes | Lightning v2 RL, 4 étapes |
|---|---|---|
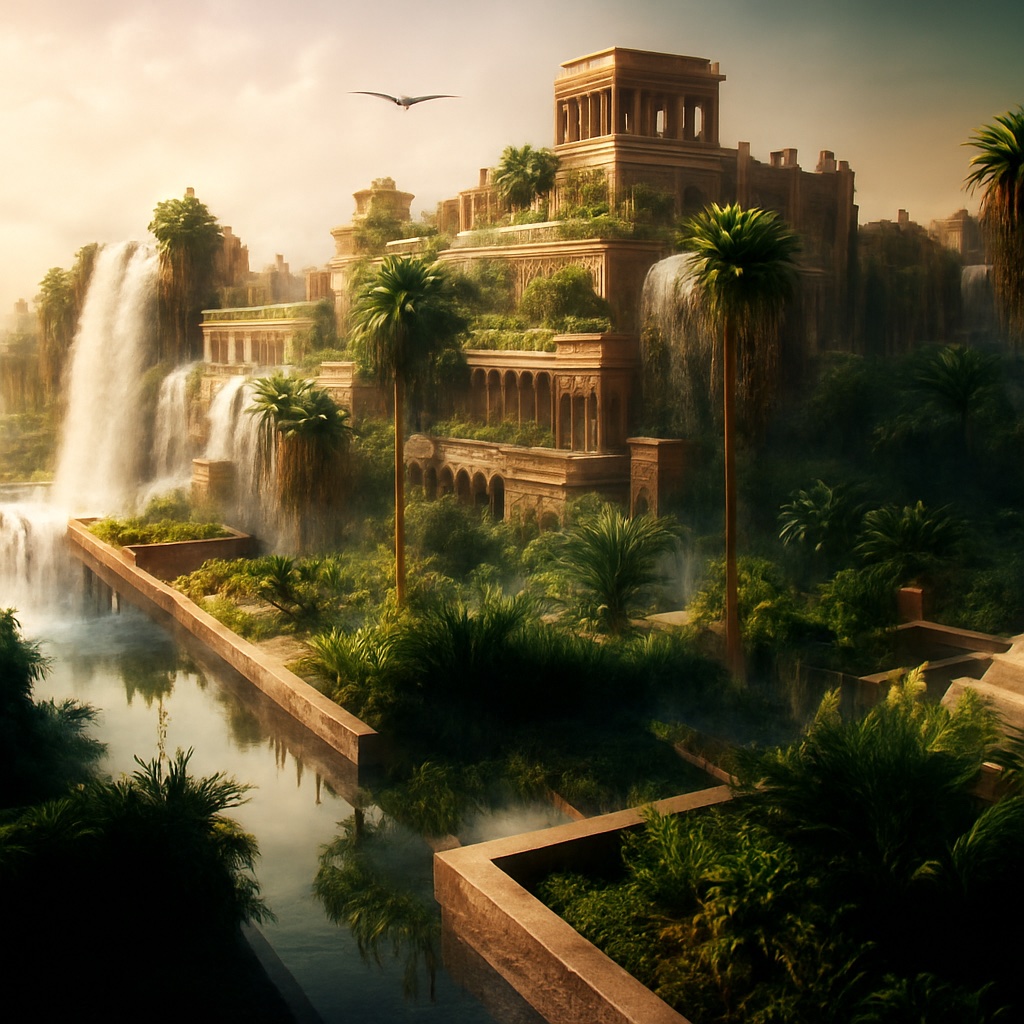 | 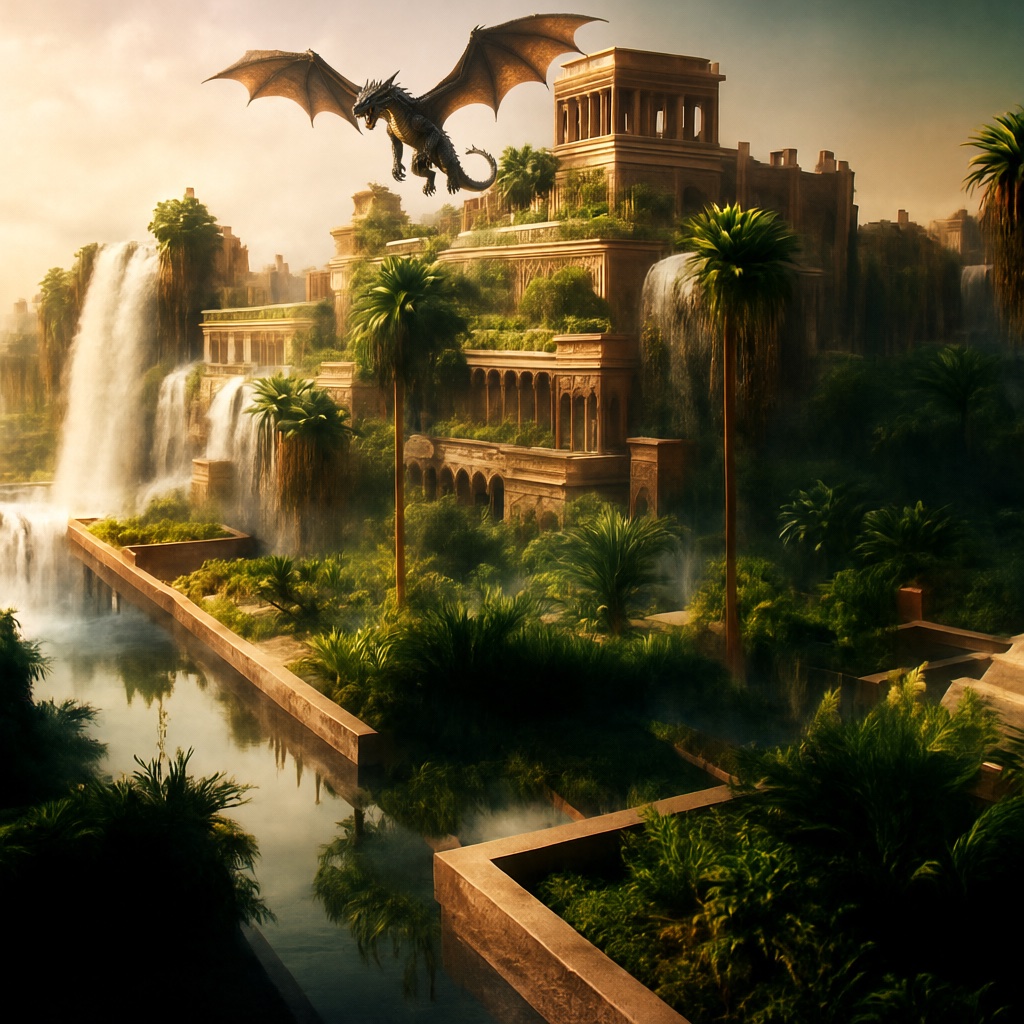 | 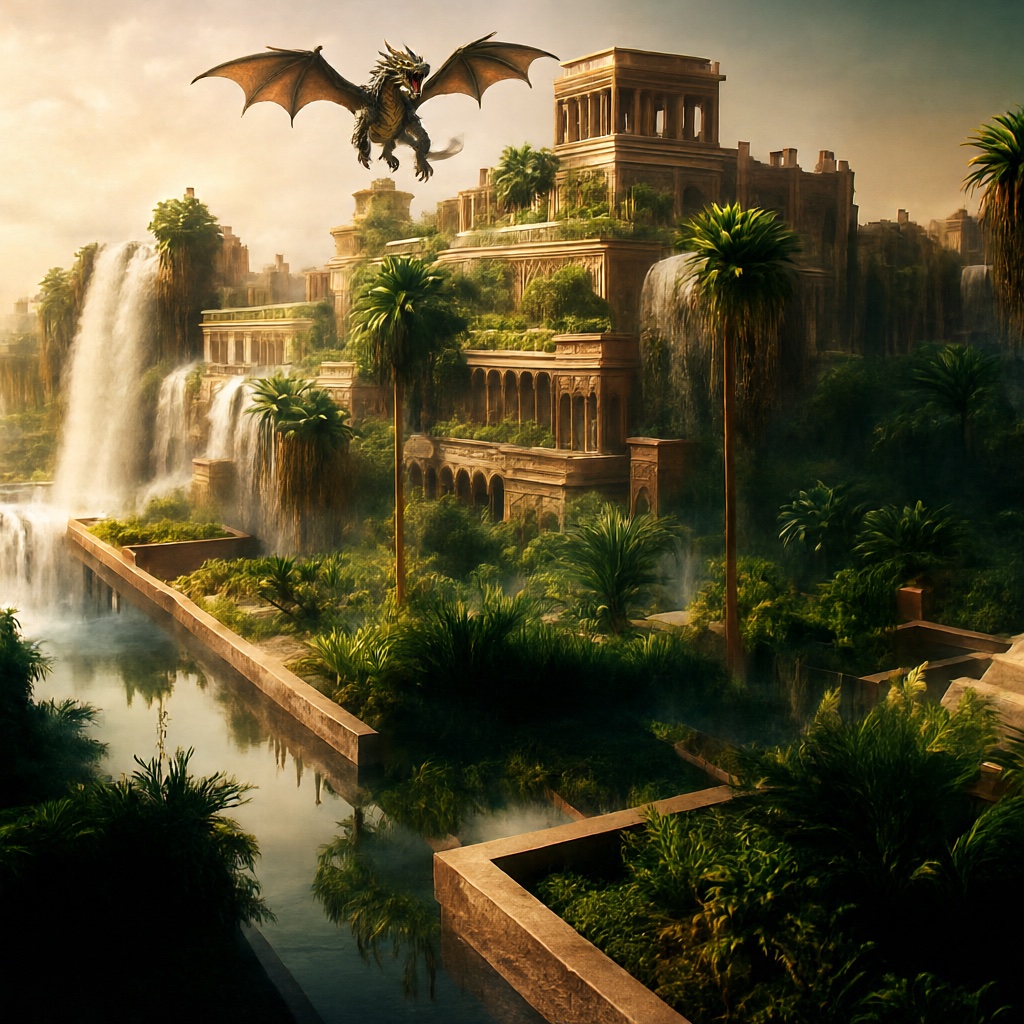 |
« Remplace l'oiseau qui vole dans le ciel en haut au centre par un dragon volant qui plane à la même position et à la même distance. … Garde tout le reste totalement inchangé : l'architecture en pierre en terrasses … les cascades … »
Le prompt fixe le dragon sur la direction de vol de l'oiseau, puis énumère ce qui ne doit pas bouger : galeries de pierre, jardins sur les toits, cascades, palmiers, brume et ciel voilé. Le deuxième exemple d'édition du référentiel remplace pour sa part la scène d'un guitariste.
Génération multi-référence
Le parcours multi-référence prend plusieurs images à la fois et les adresse par index dans le prompt (<image1>, <image2>), ce qui permet à la carte de distinguer deux références :
| Références | Modèle de base, 40 étapes | Lightning v2 RL, 4 étapes |
|---|---|---|
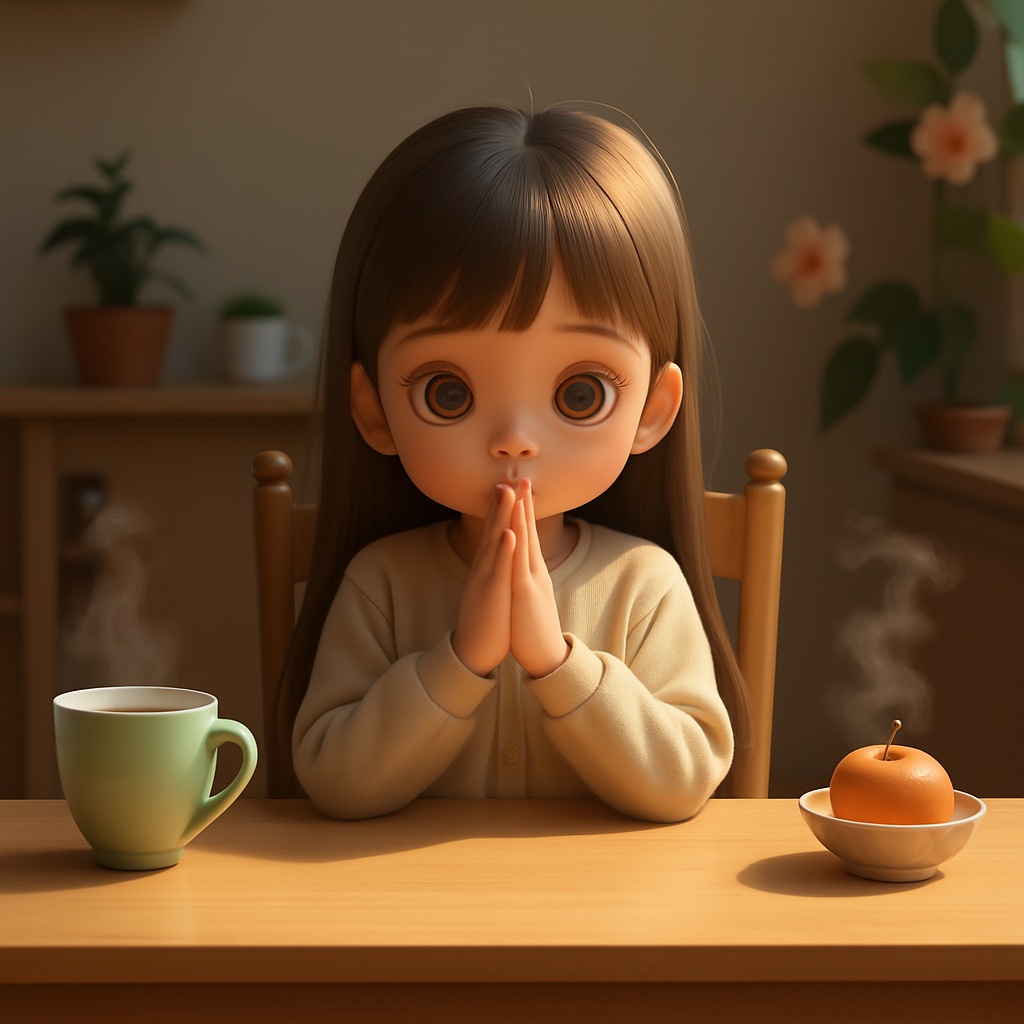 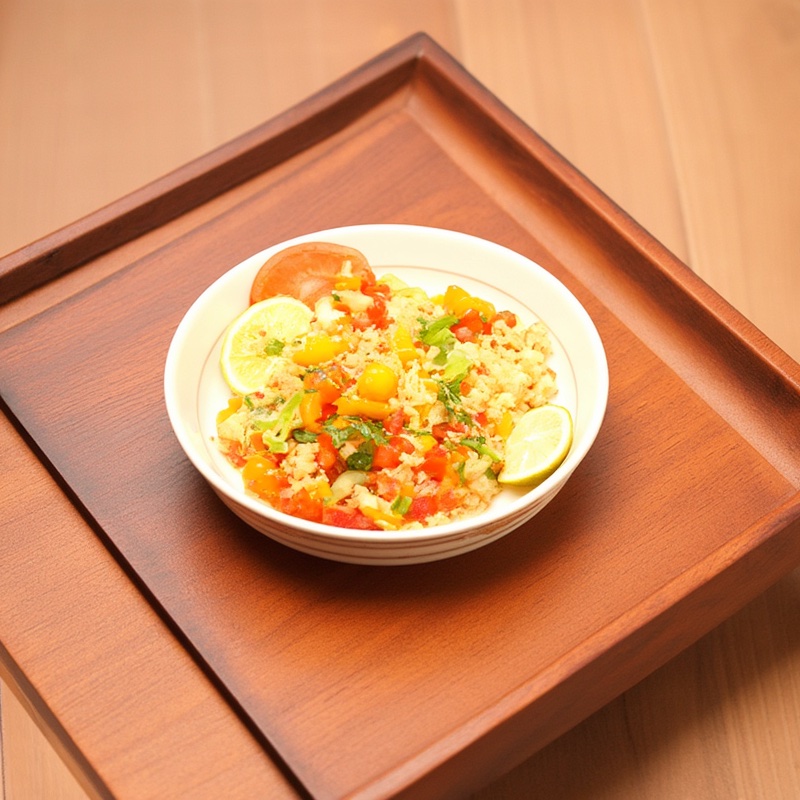 | 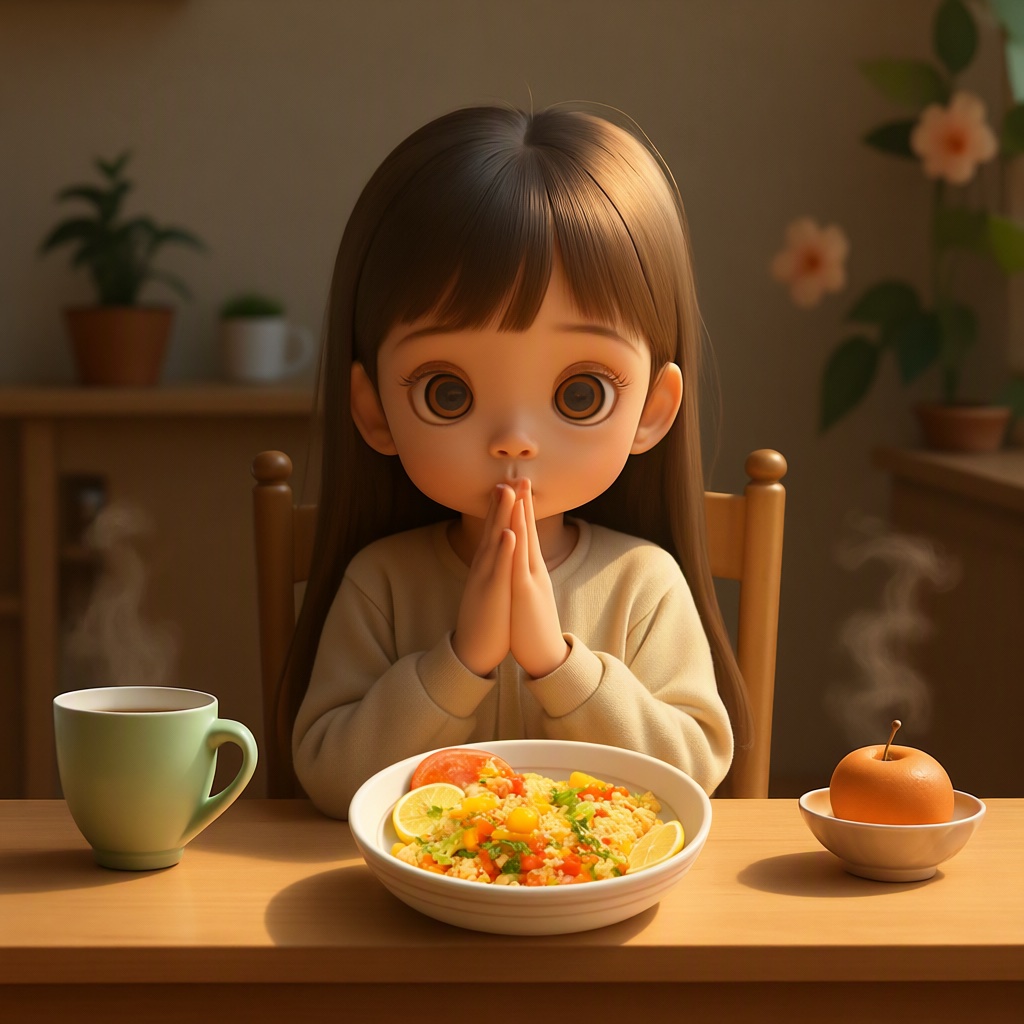 | 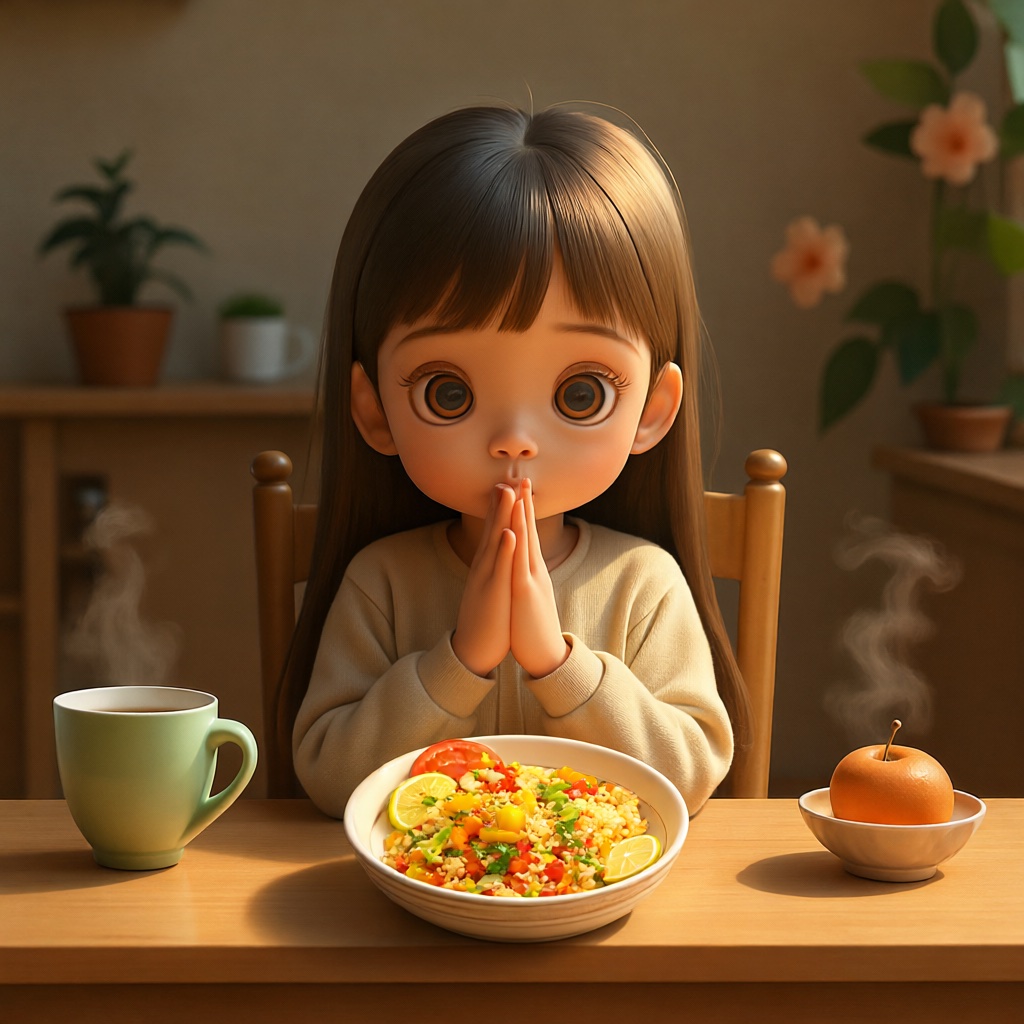 |
« Sur <image1> (toile), place le bol de nourriture extrait de <image2> sur la table en bois … Rends le bol et la nourriture ajoutés dans le même style d'illustration 3D douce que <image1> plutôt que dans le style photoréaliste de <image2>. … »
L'instruction précise l'échelle, la perspective, la direction de la lumière et la direction de l'ombre, plus une liste explicite de ce qu'il faut préserver de la toile : le visage de la fille, son gilet, la tasse fumante, le compotier, l'étagère derrière elle. Un second exemple multi-référence transfère un motif de porcelaine florale sur une théière dans une scène de portrait.
Disponibilité
Poids : lightx2v/Qwen-Image-2.1-Lightning-v2-RL sur Hugging Face. Modèle de base : Qwen/Qwen-Image-2.1. Framework d'entraînement et d'inférence : ModelTC/LightX2V.
Les fichiers publiés sont au format Diffusers (QwenImage21Transformer2DModel, 32 couches, 32 têtes), et le démarrage rapide de la carte les charge via QwenImage21Pipeline en remplaçant le transformer du pipeline. Le référentiel n'inclut pas de poids au format ComfyUI, et au moment de la publication il n'existe aucun checkpoint converti, build GGUF ni loader pour ceux-ci : la voie ComfyUI pour Lightning reste donc le LoRA v1.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.