HairDeck : cartes de cheveux et spring bones depuis une image
HairDeck génère un ensemble de cartes de cheveux stylisées à partir d'une seule image, ajoute les chaînes de spring bones qui les animent et exporte des avatars GLB ou VRM.
Les cheveux sont la partie d'un personnage 3D que les pipelines image-to-3D ratent le plus souvent. La reconstruction de mèches donne une coiffure réaliste lourde à rendre, et la reconstruction de maillage donne un unique bloc fusionné qu'un artiste ne peut ni recoiffer, ni restyler, ni animer. Les coiffures en cartes sont ce que la production stylisée livre réellement, et elles sont fabriquées à la main, ruban par ruban.
HairDeck traite la coiffure pour ce qu'elle est du point de vue d'un artiste : un ensemble non ordonné de primitives. Chaque carte de cheveux est un seul token, et un transformer de diffusion d'ensembles débruit toutes les cartes ensemble, de sorte que le modèle n'a jamais à décider dans quel ordre les cheveux arrivent. Le résultat conserve des cartes individuelles avec des UV par carte, plus les chaînes de spring bones qui les font bouger.
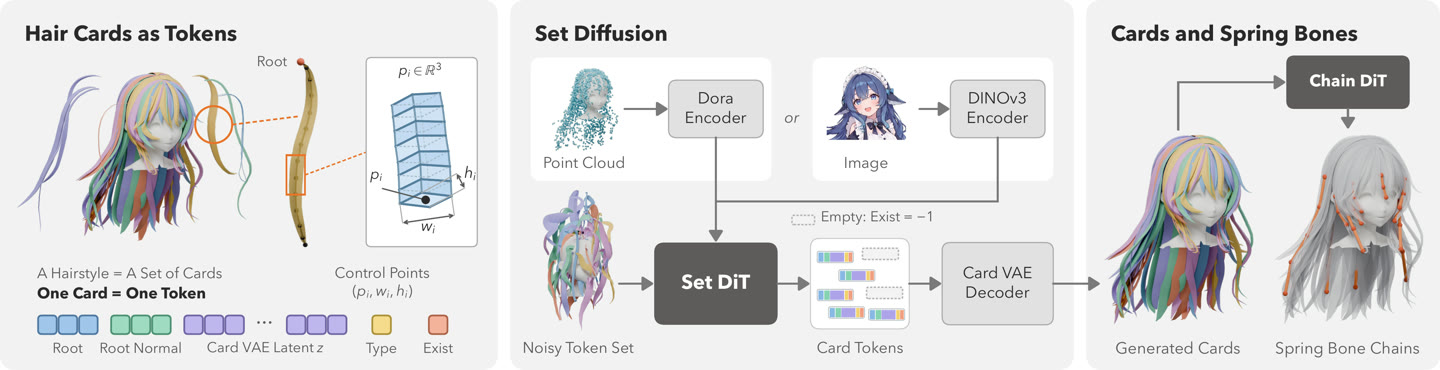
Le pipeline : tokens de cartes de cheveux, diffusion d'ensembles conditionnée par image ou par nuage de points, et cartes générées avec leurs chaînes de spring bones.
Les cartes comme un ensemble
Le seul générateur antérieur de cartes de cheveux stylisées, CHARM, décode une coiffure de manière autorégressive comme une longue séquence de points de contrôle. L'ordre de la séquence devient donc déterminant, et une erreur tôt dans la séquence se propage au reste de la chevelure.
HairDeck inverse ce principe. Un VAE de cartes encode chaque carte en un token, le transformer d'ensembles les examine toutes en même temps, et le VAE de cartes décode chaque token en géométrie avec ses propres coordonnées UV. Les cartes sont conditionnées par une image par défaut, ou par un nuage de points via un quatrième modèle publié.
Les spring bones viennent avec les cheveux
La géométrie seule ne fait pas un asset. Une coiffure en cartes dans un moteur de jeu ou un avatar VRM ne paraît vivante que parce que des spring bones tirent chaque carte avec un peu de physique, et ces chaînes sont normalement construites à la main et peintes en poids une fois le maillage terminé.
Un modèle de diffusion de chaînes les génère directement, conditionné par les tokens de cartes, de sorte que l'exportation transporte le skinning autant que la géométrie. Une image en entrée, et il en sort une coiffure qui bouge.
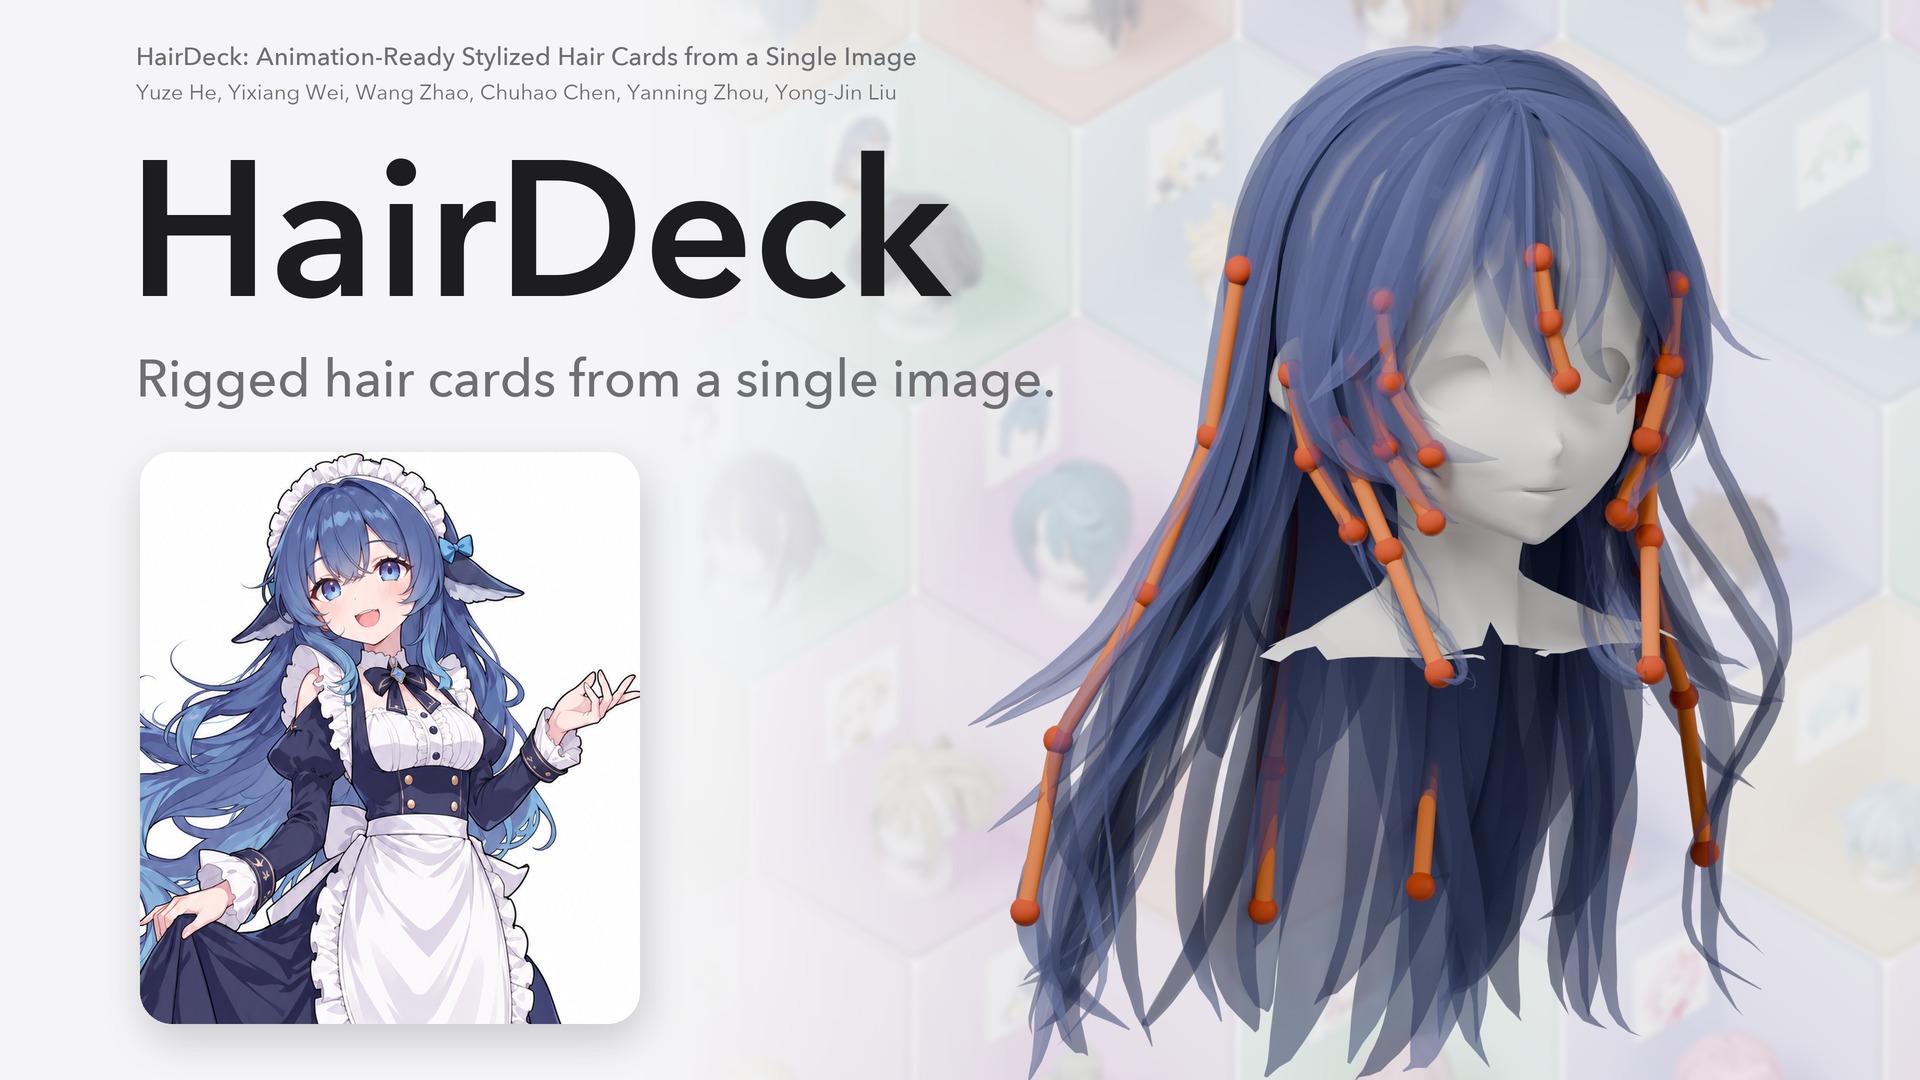
Une image de la démo du projet : cartes générées sur le corps d'avatar fourni.
La vidéo de démo du projet : une image d'entrée, quatre variations générées et l'aperçu VRM de rotation de la tête.
Ce qui est fourni
| Modèle | Rôle | Checkpoint |
|---|---|---|
| Image DiT | Génère les tokens de cartes conditionnés par une image | ckpt/image_model/model.safetensors |
| Card VAE | Décode le latent d'un token de carte en géométrie de carte | ckpt/card_vae/model.safetensors |
| Chain DiT | Génère les chaînes de spring bones conditionnées par les tokens de cartes | ckpt/chain_model/model.safetensors |
| Point-cloud DiT | Génère les tokens de cartes conditionnés par un nuage de points | ckpt/pointcloud_model/model.safetensors |
Le parcours image exécute Image DiT, Card VAE et Chain DiT. Le modèle de nuage de points est utilisé par le parcours de génération et d'évaluation sur nuage de points. Le référentiel fournit également les statistiques de normalisation, le repère de tête canonique, un avatar modèle VRoid Studio pour l'exportation VRM, et 100 cas de test avec leur géométrie de cartes d'origine, afin que l'évaluation puisse être reproduite sans l'ensemble d'entraînement.
L'inférence nécessite Linux x86-64, Python 3.12 et un GPU NVIDIA CUDA, testé avec PyTorch 2.8 et CUDA 12.8. La pile de prétraitement est plus lourde que les modèles : SAM 3 et DINOv3 ViT-L/16 sont des téléchargements à accès restreint qui exigent d'accepter leurs licences, BiRefNet-matting gère le détourage, et l'exportation VRM pilote Blender 4.2 LTS avec l'add-on VRM, que le script d'installation peut récupérer seul. Le parcours VRM reste un pipeline Python et Blender, et non un nœud personnalisé ComfyUI.
Une seule commande génère de une à quatre variations, et --no-chains omet le modèle de spring bones lorsque seules les cartes sont souhaitées :
python scripts/image_to_hair.py character.png --out results/my_character --n 4
python -m hairdeck.vrm.export results/my_character/character 0
Les chiffres de l'article
Sur le propre jeu de test de CHARM, HairDeck annonce une distance de Chamfer inférieure de 44 % et plus de la moitié de l'erreur d'orientation des cartes en moins, tout en étant 33 fois plus rapide. À partir d'images uniques, les auteurs indiquent qu'il surpasse CHARM, les pipelines image-to-3D et les méthodes à base de mèches, ce qui est la comparaison qui compte pour quiconque lui fournit un personnage généré plutôt qu'un personnage rendu.
Disponibilité
- hyz317/HairDeck sur Hugging Face : quatre checkpoints, données de support, 100 cas de test, Apache-2.0
- hyz317/HairDeck sur GitHub : inférence, démo locale, code d'évaluation et d'entraînement, actuellement le seul parcours pris en charge
- Une démo Space hébergée qui génère des cheveux et exporte en VRM depuis le navigateur
- Il n'existe aucune intégration ComfyUI officielle. Un pack communautaire très récent, FengLairh/ComfyUI-HairDeck, encapsule les mêmes checkpoints dans trois nœuds (chargement, génération, sauvegarde) qui s'exécutent dans le propre processus Python de ComfyUI et préparent un Blender portable pour l'exportation VRM ; il est apparu le 1er novembre et n'a pas été validé ici
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.