Krea 2 Turbo en 3 étapes: LoRA de distillation plus détaillé
Un LoRA rank-64 fait passer Krea 2 Turbo de 8 à 3 étapes à cfg 1.0, avec une texture fine mesurée à 1,11x celle de l'enseignant, et un flux de travail ComfyUI en nœuds natifs.
Le même auteur qui a fait passer Krea 2 Turbo de 8 étapes à 4 puis jusqu'à 2 comble désormais le vide : cet adaptateur exécute le modèle en 3 étapes, soit un débruitage environ 2,6x plus rapide (de 65,4 s à 24,9 s en 1024x1024, float16, encodage texte et décodage VAE exclus), tout en mesurant une texture fine à 1,11x celle de l'enseignant 8 étapes sur les 22 prompts de test de l'auteur, contre 1,04x pour l'adaptateur 4 étapes. Turbo d'origine à 3 étapes tombe à 0,58x : c'est cet écart que le LoRA comble.
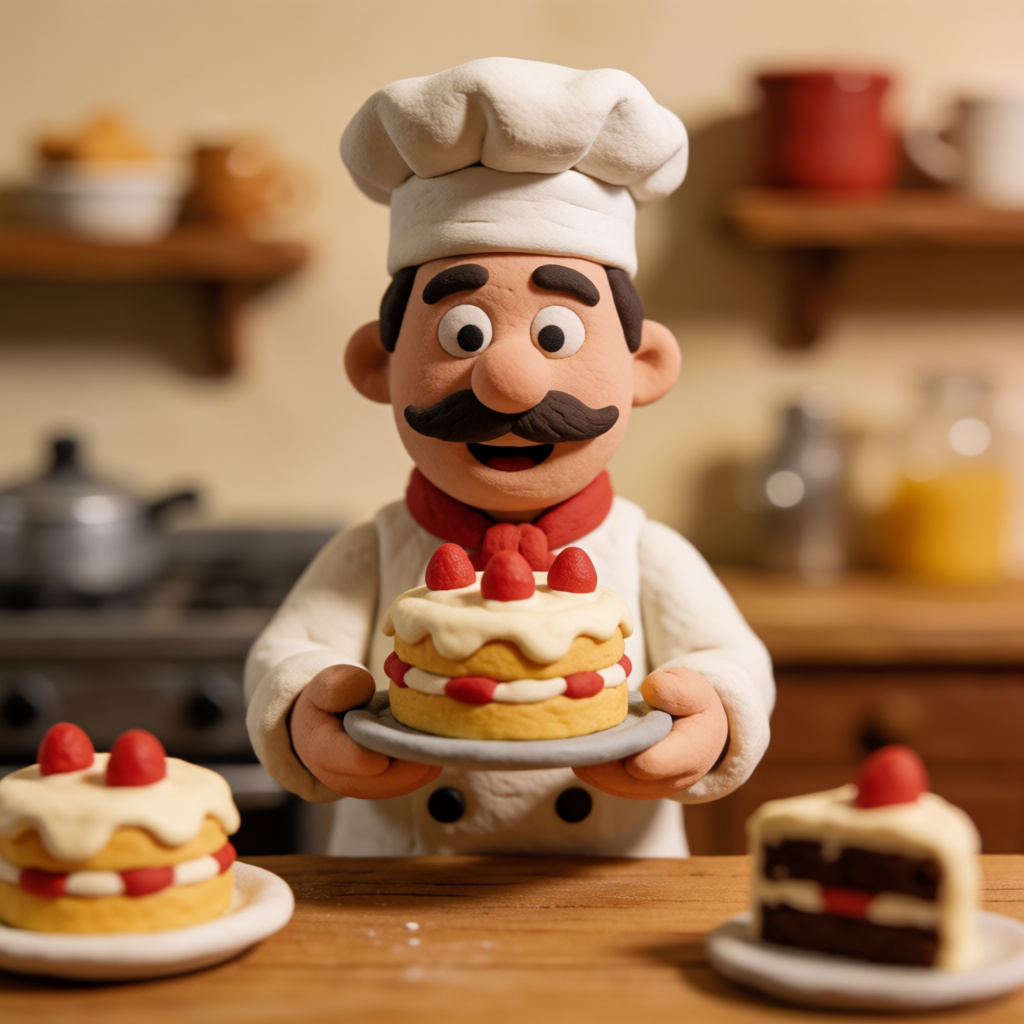 | 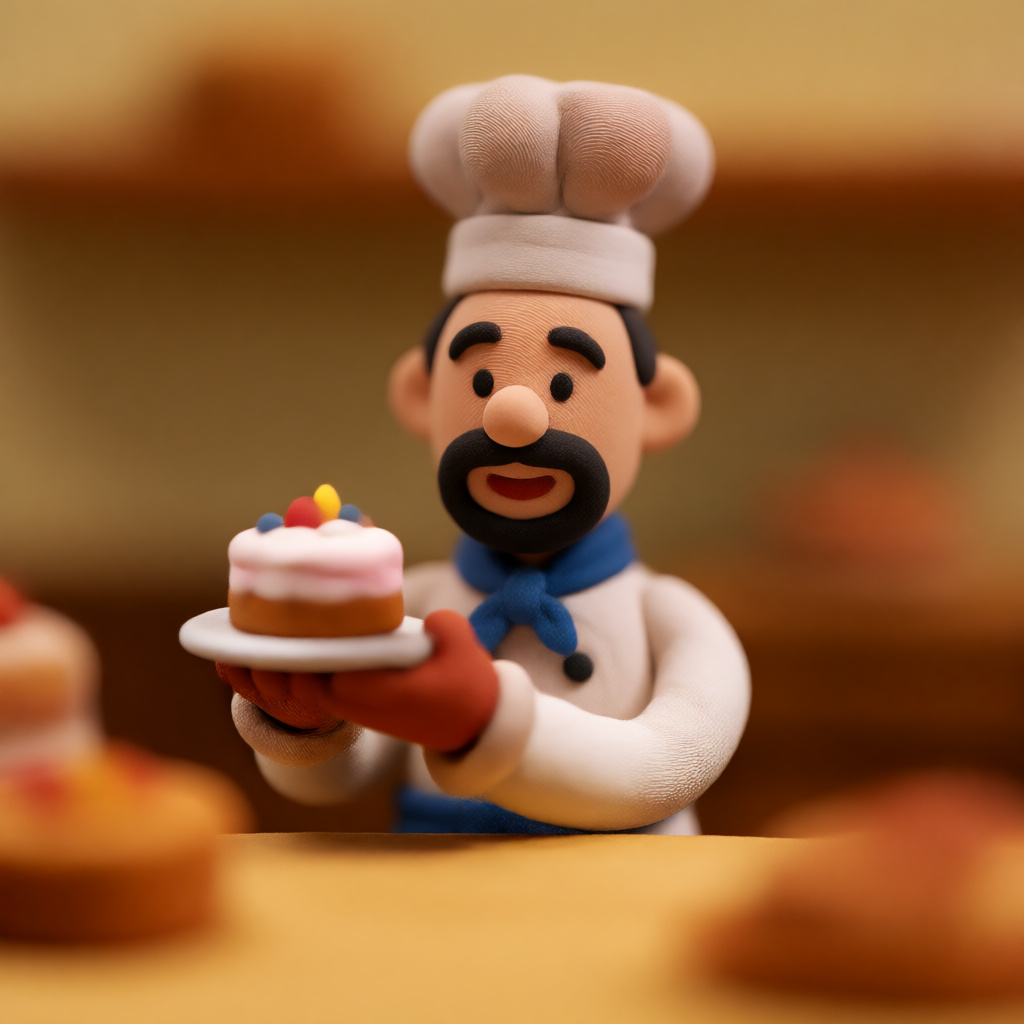 | 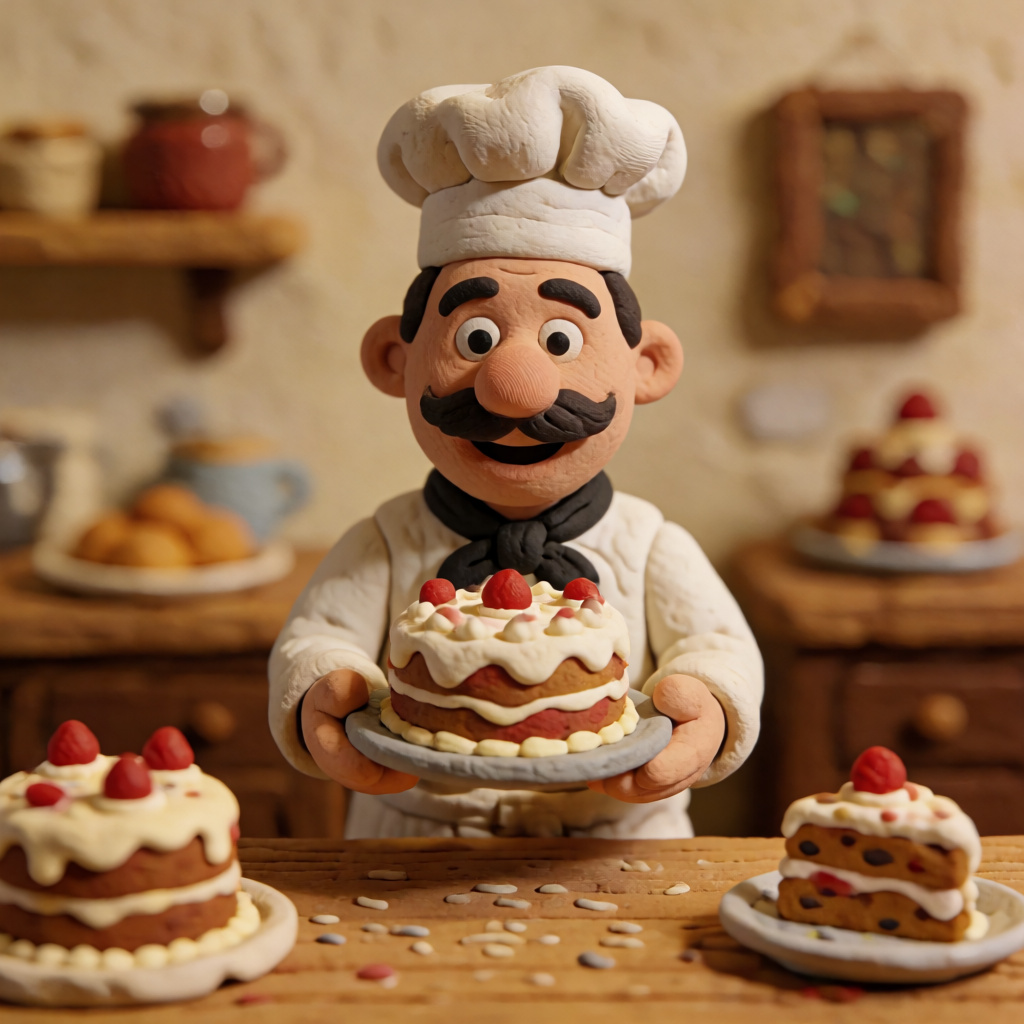 |
|---|---|---|
| Turbo, 8 étapes : la référence de qualité | Turbo à 3 étapes, sans LoRA : mou et plat | 3 étapes avec le LoRA : le détail retrouvé |
Le projet est toujours en entraînement : le checkpoint partagé aujourd'hui est chk00030000, issu de poids stabilisés où les 600 derniers échantillons amènent le taux d'apprentissage à zéro, et l'auteur annonce d'autres checkpoints. Les deux fichiers de poids du dépôt contiennent ce même checkpoint sous les noms de clés diffusers et ComfyUI.
Trois étapes selon la planification propre à Turbo
L'étudiant effectue trois appels sur les sigmas 3 étapes propres à Turbo, [1.0, 0.8633, 0.6123], avec le mu canonique du modèle de 1,15 et sans guidance. L'entraînement est parti des poids de l'adaptateur 4 étapes publié, en conservant sa forme : rank 64 sur les mêmes 228 modules. Environ 30 000 échantillons ont été tirés de trajectoires enregistrées de l'enseignant, à 11 résolutions, de 512x768 jusqu'à 1440x1440 et 1824x1024.
Deux choses diffèrent des adaptateurs antérieurs. La base a tourné en bf16 sur un seul H100/H200 (les projets 4 étapes et 2 étapes s'entraînaient sur une RTX 3090 face à une base int8 en poids seuls), soit environ 91 heures pour les 30 000 échantillons. Et l'objectif reste la correspondance de distribution plutôt que l'imitation de trajectoire : l'étudiant est noté par huit critiques qui s'appuient sur les features intermédiaires du réseau de la base gelée, couvrant les artefacts, la plausibilité d'une vraie photographie, la composition au premier appel, le contenu, l'accord avec le prompt, le lettrage, les grands visages et l'ensemble du déroulement en trois appels. Correspondre à ce que l'enseignant produirait plausiblement, plutôt qu'à son chemin exact, c'est ce qui empêche trois étapes de sombrer dans le flou et les bords doublés.
Les bandes mesurées confirment : texture fine à 1,11x celle de l'enseignant, les bandes 16 pixels et 8 pixels à 1,10x et 1,12x, et la couleur au niveau de l'enseignant.
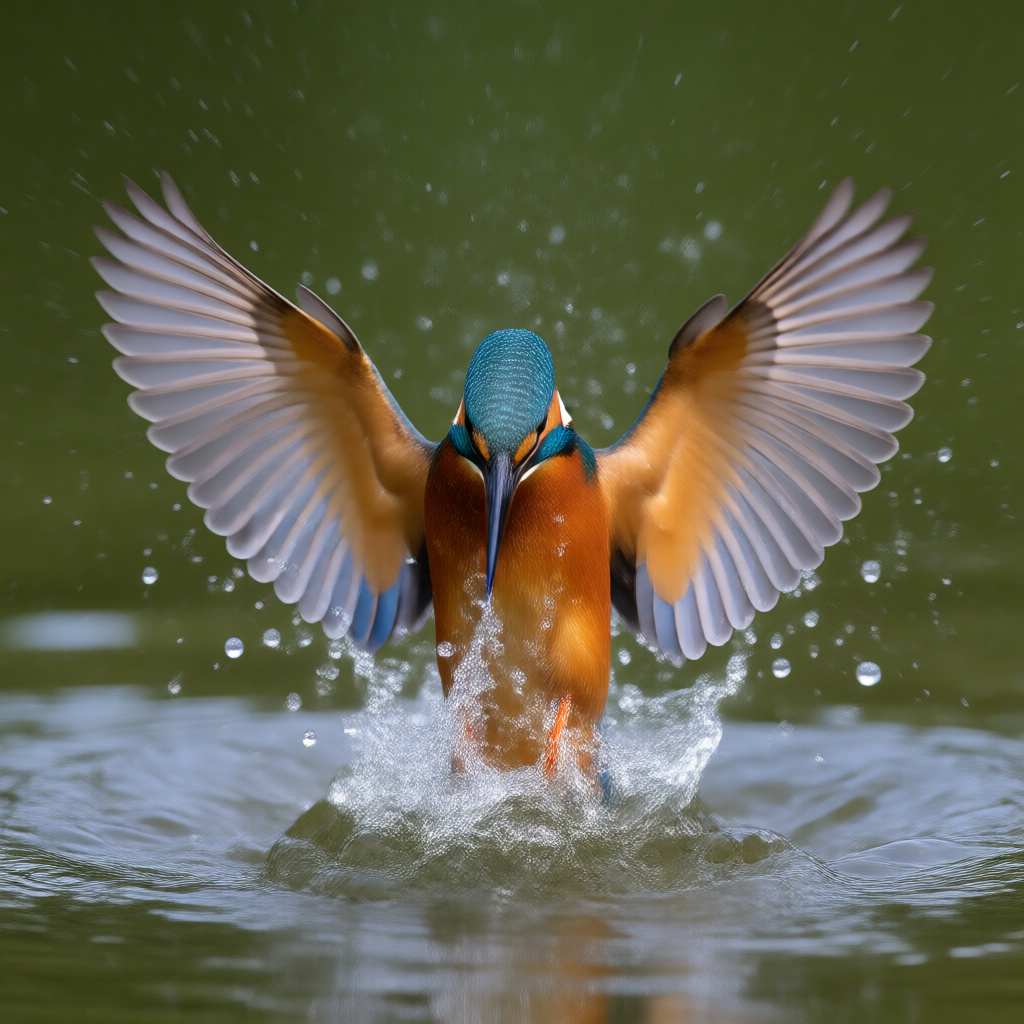
Turbo à 3 étapes sur le prompt kingfisher, sans l'adaptateur. La version du LoRA, même graine et même prompt, constitue l'image de couverture.
Ce qu'il coûte en échange
L'auteur publie les coûts en même temps que les gains, et ils valent la peine d'être lus avant de l'adopter :
- Plus éloigné de l'image de l'enseignant que l'adaptateur 4 étapes : distance 0,401 contre 0,320, accord de détail 0,26 contre 0,39. Trois étapes est un chemin plus court depuis le même bruit, donc le cadrage, la pose ou un petit élément peuvent différer du rendu 8 étapes à la même graine. L'image de l'enseignant est une référence de qualité, pas une cible à reproduire.
- Texture plus forte que celle de l'enseignant : le grain dans les zones plates mesure 1,57x celui de l'enseignant, contre 1,29x dans la version antérieure. Le papier aquarelle, les pores de la peau et le grain de film ressortent davantage ; une force inférieure à 1,0 l'adoucit.
- De légers bords doublés sur les cheveux, les traînées de pluie et les membres fins, surtout en 768x1024 et 1024x768 : l'indice de ghosting est 1,14x celui de l'enseignant, là où l'adaptateur 4 étapes se situe à 1,02x.
- Les petits visages dans les foules restent le point faible de tout adaptateur few-step.
La fenêtre de force utile du LoRA est étroite autour de 1,0, car à trois étapes l'adaptateur fait tout le travail de transformation d'appels grossiers en une image terminée. Quand la proximité avec le rendu propre de l'enseignant compte plus que la vitesse, l'adaptateur 4 étapes est le meilleur outil.
Utilisation dans ComfyUI
Le dépôt fournit krea2_turbo_3step_rank_64_lora_comfyui.safetensors sous les noms de clés ComfyUI, plus krea2_turbo_3step_lora_t2i.json, un flux de travail construit uniquement avec des nœuds natifs.
| fichier | à placer dans |
|---|---|
krea2_turbo_3step_rank_64_lora_comfyui.safetensors | ComfyUI/models/loras/ |
krea2_turbo_bf16.safetensors (depuis Comfy-Org/Krea-2) | ComfyUI/models/diffusion_models/ |
qwen3vl_4b_bf16.safetensors (même dépôt) | ComfyUI/models/text_encoders/ |
qwen_image_vae.safetensors (même dépôt) | ComfyUI/models/vae/ |
Paramètres : steps 3, cfg 1.0, sampler euler / simple, force du LoRA 1.0.
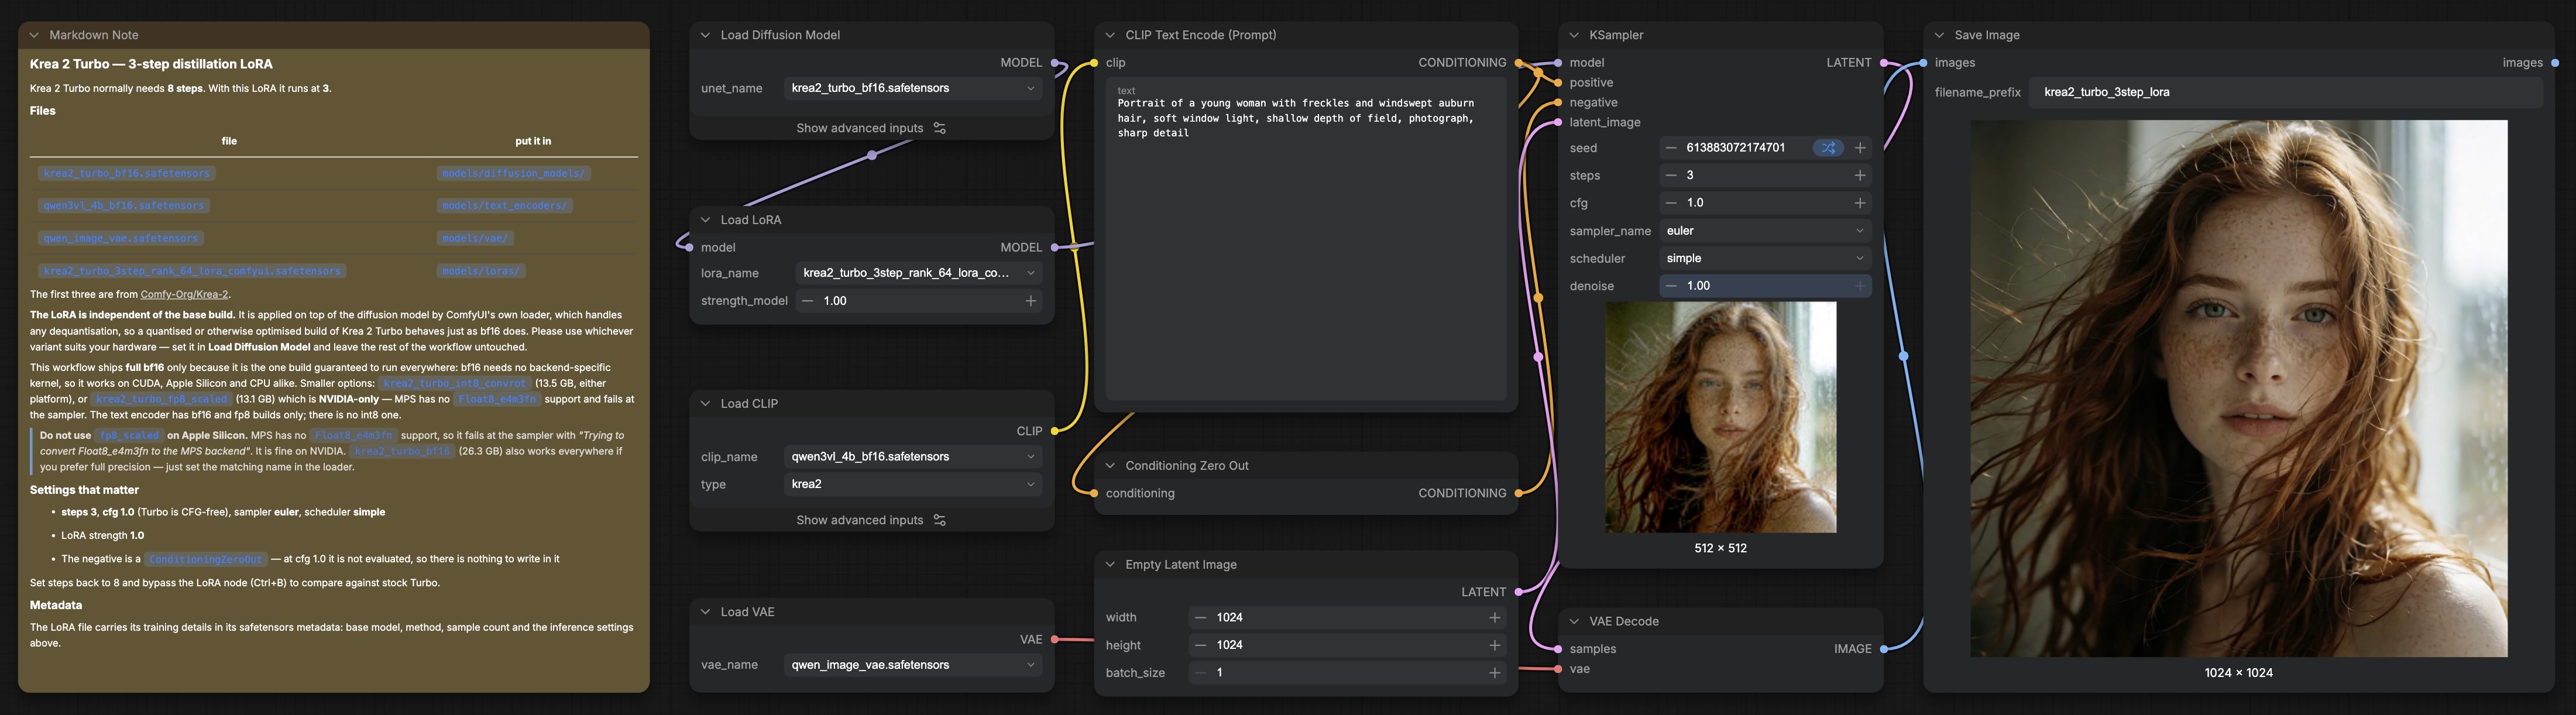
Le flux de travail fourni : Krea 2 Turbo plus le LoRA 3 étapes, uniquement des nœuds natifs.
guidance_scale=0.0 de l'exemple diffusers est le même réglage, écrit à la manière de diffusers.
Deux mises en garde issues de la carte du modèle. Une base quantifiée échange du détail contre de la mémoire : sur le Turbo 4 bits (nvfp4) de Comfy Cloud, la texture fine de l'adaptateur a mesuré environ un cinquième de moins qu'un rendu bf16 complet. Et sur Apple Silicon, les builds fp8_scaled ne se chargent pas, car MPS ne dispose pas de Float8_e4m3fn ; un flux de travail MLX séparé existe dans le dépôt et exécute le même LoRA via le nœud LVNodes Krea 2 MLX de l'auteur.
En bonus, il se charge aussi sur Krea 2 Raw, qui partage l'architecture : sur Raw à 13 étapes avec CFG 3.5, il conserve la composition de Raw et ajoute du détail que Raw manque à ce nombre d'étapes. L'auteur précise clairement qu'il s'agit d'un terrain non entraîné, et non d'un mode pris en charge.
Disponibilité
- Hugging Face : lvladikov/Krea2-Turbo-Distill-3step-LoRA, avec 22 planches de comparaison et le compte rendu complet de l'entraînement dans
DETAILED-README.md - Le LoRA 4 étapes reste la correspondance la plus proche de la sortie 8 étapes de Turbo ; le LoRA 2 étapes demeure l'option d'aperçu
- Toutes les mesures ci-dessus sont celles de l'auteur, prises sur 22 prompts de test ; la carte liste les problèmes connus par ordre de fréquence d'apparition
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.