Primal VAE : un downsample 2x calqué sur les latents de Flux
Ostris publie Primal VAE, deux autoencodeurs d'environ 80M de paramètres qui ne réduisent que 2x et laissent le patchify 8x au DiT, sans facteur d'échelle.
2x1 sous-échantillonne 2x vers un seul canal, 2x2 vers deux canaux.
La plupart des VAE modernes compressent l'image 8x puis fournissent au modèle de diffusion un latent qu'il faut remettre à l'échelle avec un facteur d'échelle mesuré, un facteur de décalage ou des statistiques de batch-norm. Primal VAE emprunte l'autre voie : le VAE n'effectue qu'une réduction spatiale 2x, et l'étape de patchify du DiT fournit les 4x restants. Un latent à 1 canal en 2x, patché 4 fois, devient 16 canaux en 8x, soit la même forme que produit un VAE Flux.1 ; la variante à 2 canaux aboutit à 32 canaux en 8x, la forme du VAE Flux.2.
| modèle | latent | patch 4 | même forme que |
|---|---|---|---|
2x1 | 1 canal @ 2x | 16 canaux @ 8x | VAE Flux.1 (16 canaux @ 8x) |
2x2 | 2 canaux @ 2x | 32 canaux @ 8x | VAE Flux.2 (32 canaux @ 8x) |
Les deux checkpoints comptent environ 80M de paramètres, et les côtés de l'image doivent être des multiples de 16.
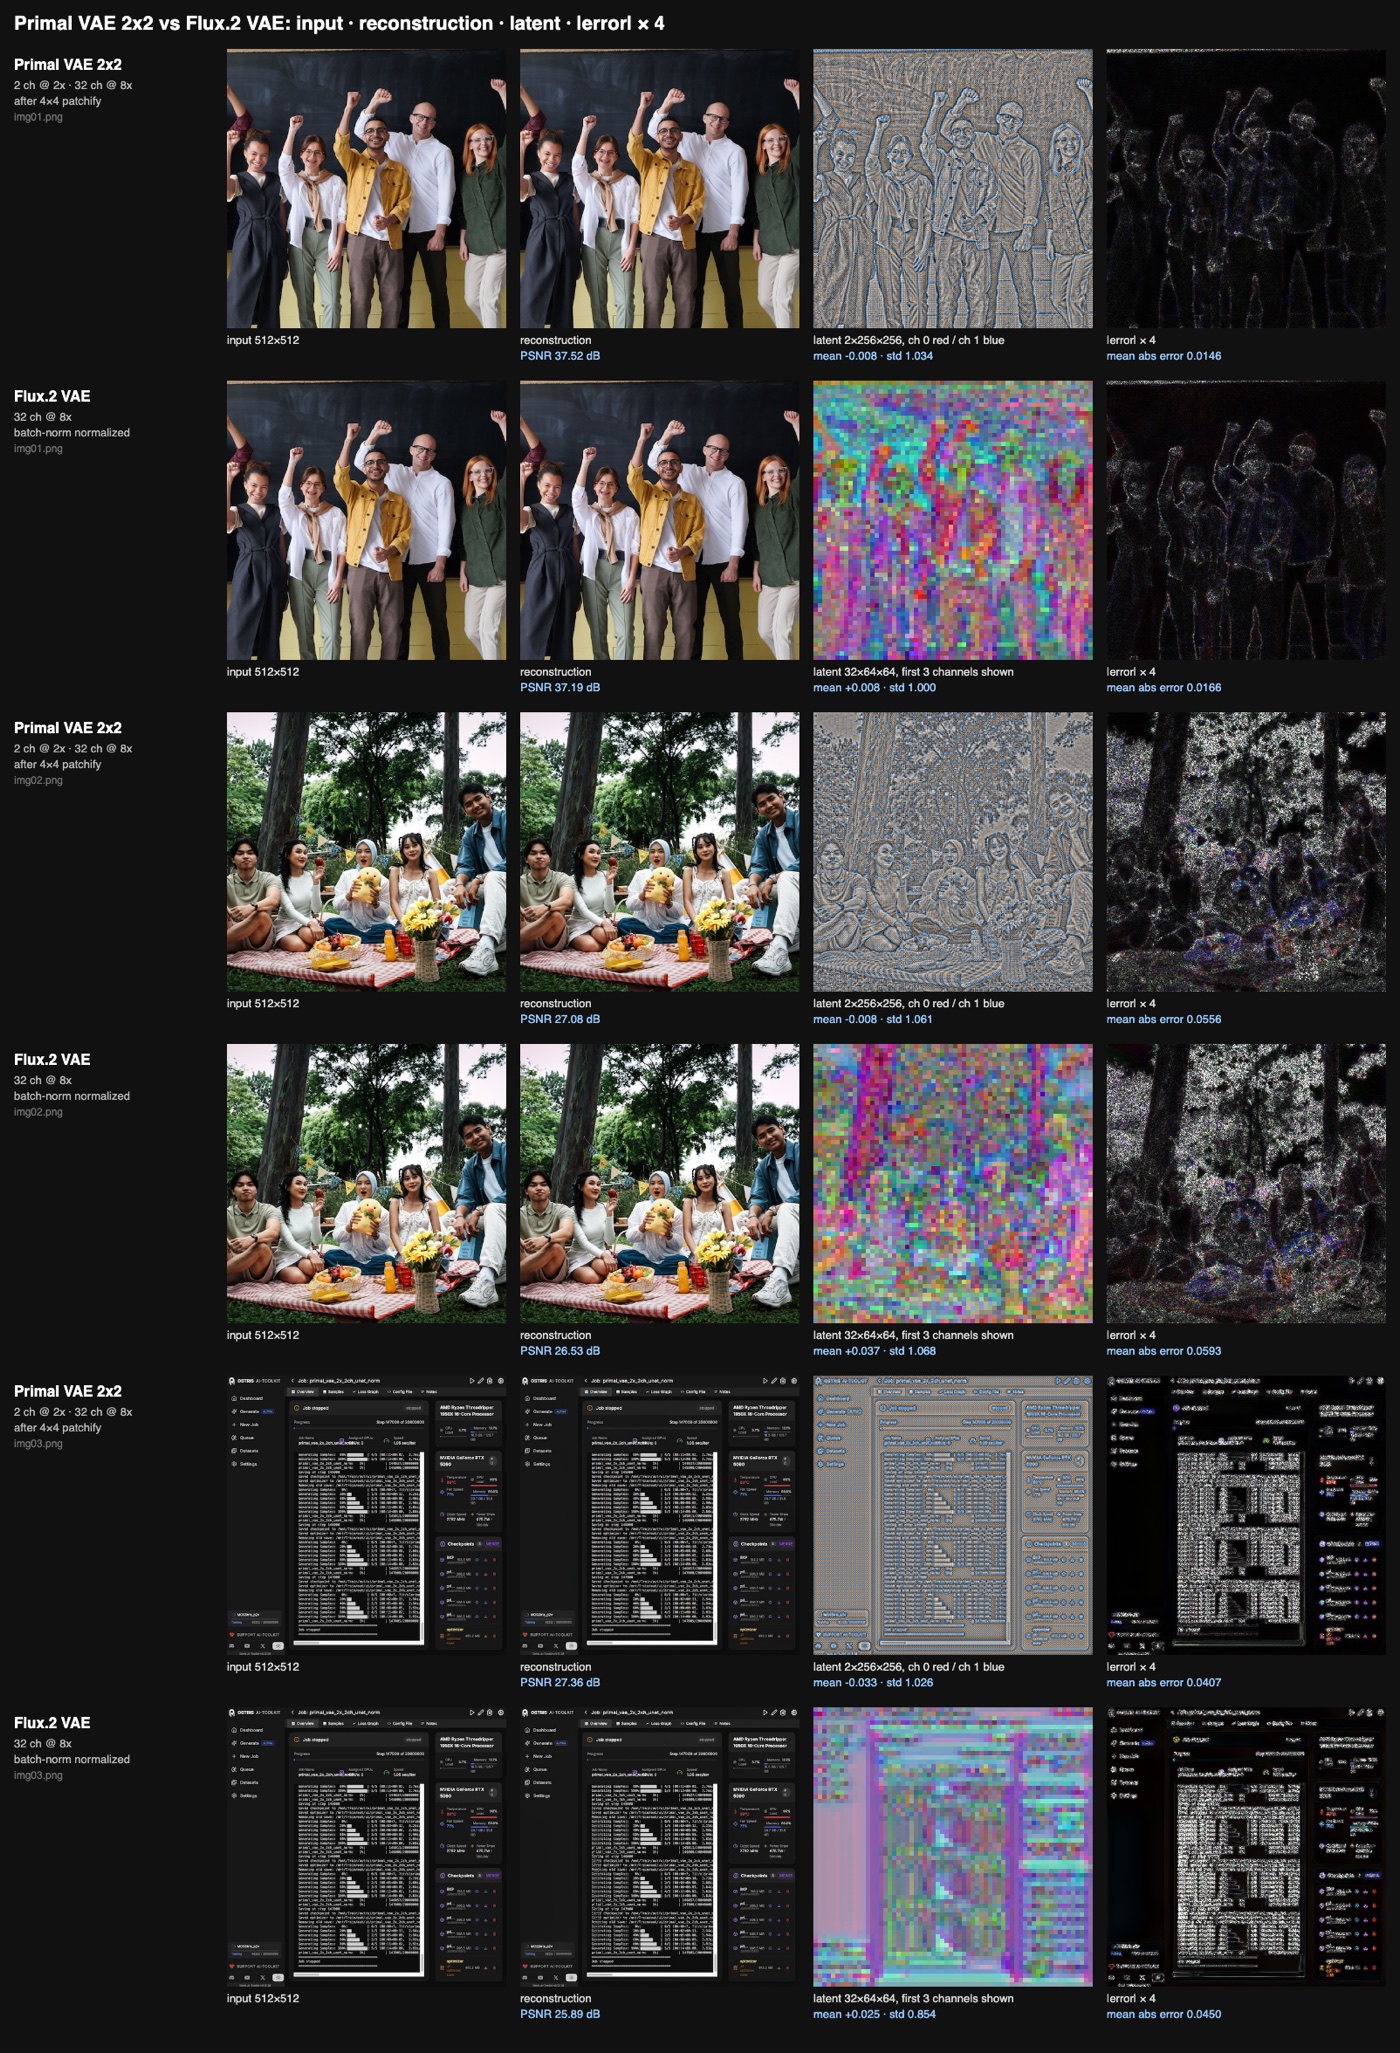
Chaque ligne correspond à l'entrée, la reconstruction, le latent et |error| x 4. Sous chaque ligne Primal VAE se trouve le VAE Flux avec la même disposition de latent, sur la même image. Les latents sont affichés à 3 sigma ; le latent à deux canaux place le canal 0 en rouge et le canal 1 en bleu.
Qualité de reconstruction sur les trois images de 512 px du référentiel, en dB :
| image | Primal 2x1 | VAE Flux.1 | Primal 2x2 | VAE Flux.2 |
|---|---|---|---|---|
| img01 (personnes, studio) | 32.1 | 35.7 | 37.5 | 37.2 |
| img02 (pique-nique, feuillage) | 22.0 | 24.2 | 27.1 | 26.5 |
| img03 (capture d'écran d'interface) | 21.3 | 24.7 | 27.4 | 25.9 |
L'auteur affirme clairement que trois images et le PSNR ne constituent pas un benchmark, et qu'un VAE KL paie un coût de reconstruction pour le bruit de sa postérieure, ce qu'un VAE déterministe ne fait pas. La variante 2x2 égale ou dépasse le VAE Flux.2 avec le même budget d'information, soit 32 valeurs par bloc de 8x8 pixels. La variante 2x1 reste en retrait derrière le VAE Flux.1 sur les contenus texturés : un canal en 2x représente une réduction de 12:1 sans marge, et elle a reçu bien moins de la moitié des étapes d'entraînement de la version 2x2 (62k contre 147k).
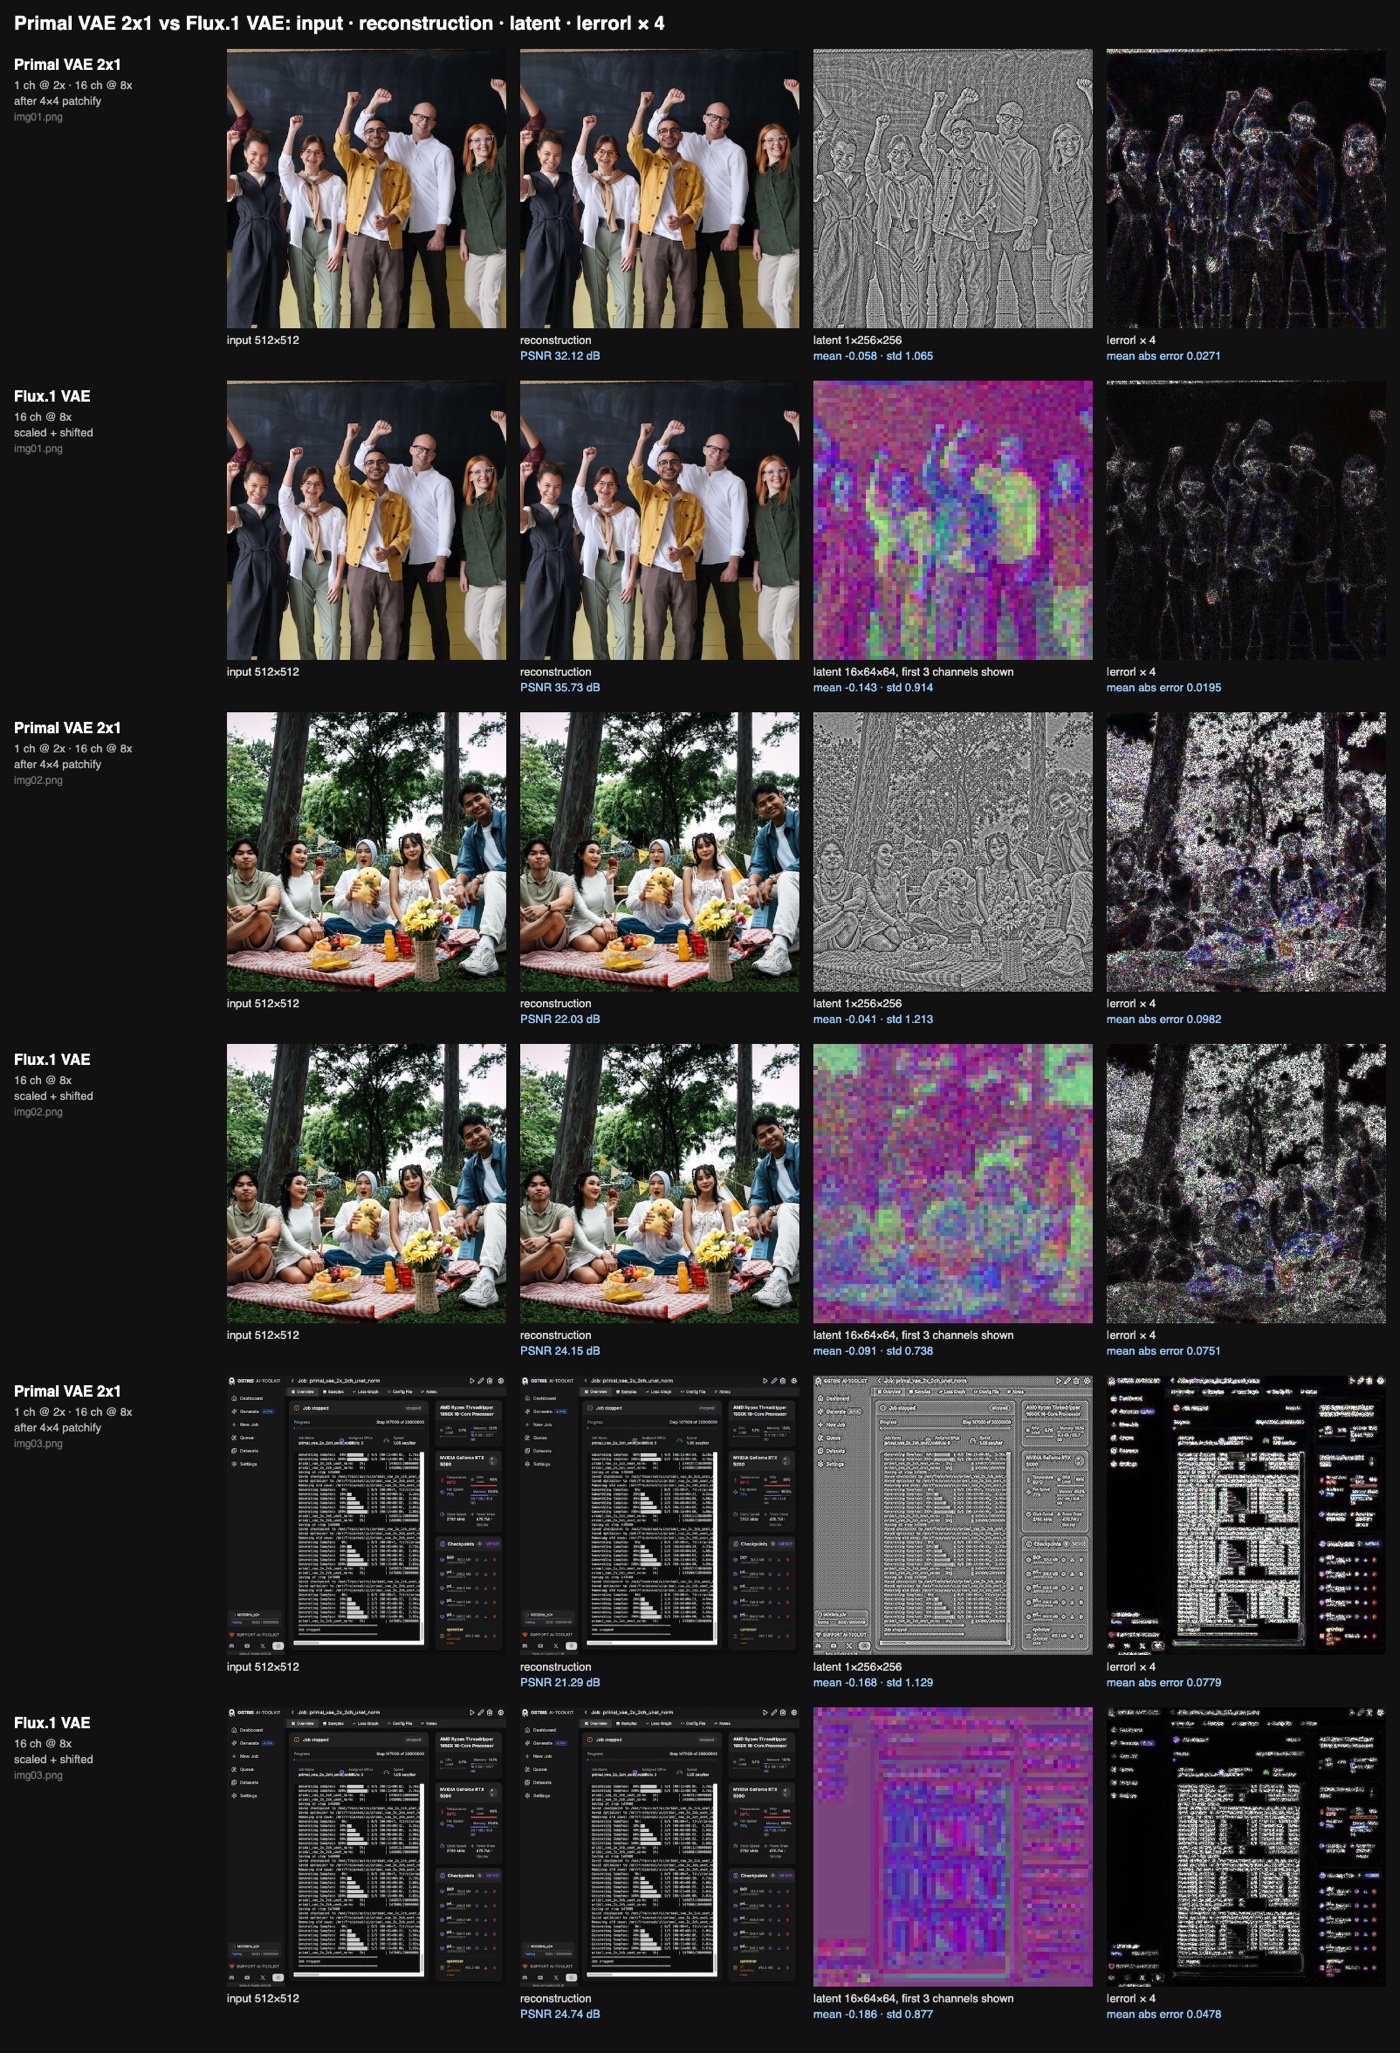
La comparaison à 1 canal. Le latent monocanal est affiché en gris et son écart-type par image dérive encore, de 1.07 à 1.21, car il n'a reçu la normalisation par image que durant ses 9k dernières étapes.
Architecture
Les deux variantes sont le même réseau et ne diffèrent que par leurs canaux de sortie :
- L'entrée passe par
pixel_unshuffle(2), si bien que le RGB devient 12 canaux à demi-résolution. Tout s'exécute à la résolution du latent ou en dessous, ce qui fait du latent une carte spatialement fidèle de l'image. - L'encodeur et le décodeur sont des U-Nets convolutifs en miroir comportant quatre niveaux à 1/2, 1/4, 1/8 et 1/16 de la taille de l'image, des largeurs de 96 / 192 / 384 / 384, et des blocs résiduels dont les dilatations alternent 1, 2, 4.
- La normalisation est une RMSNorm sur les canaux à chaque position. Il n'y a aucune statistique spatiale et aucune attention, donc une tuile s'encode et se décode comme l'image complète, moyennant un certain chevauchement.
- L'encodeur se termine par une simple convolution 3x3 vers 1 ou 2 canaux. Pas de postérieure, pas de terme KL, pas de convolutions de quantification.
Garder le latent aligné sur le bruit
Un modèle de diffusion est entraîné face à du bruit gaussien, donc le latent devrait déjà ressembler à du bruit gaussien. Au lieu d'ajouter un terme KL puis de mesurer un facteur d'échelle après coup, les statistiques entrent directement dans la loss appliquée à la sortie de l'encodeur :
- Moment loss :
mean^2 + (std - 1)^2avec un poids de 0.1, calculée par image et par canal, de sorte que chaque image ressorte avec une moyenne de 0 et un écart-type de 1, et pas seulement le dataset en moyenne. - Gaussian order-statistic loss : les valeurs latentes de chaque image et de chaque canal sont triées puis comparées aux statistiques d'ordre attendues d'une loi normale standard de même taille, via l'approximation de Blom. Cela fixe toute la forme de la distribution plutôt que les deux premiers moments, si bien qu'une image grise uniforme s'encode encore en quelque chose qui ressemble à du bruit plutôt qu'à une constante.
De ce fait, il n'y a aucun facteur d'échelle, aucun facteur de décalage et aucune normalisation de latent à transporter, et l'encodage renvoie un simple tenseur plutôt qu'une distribution : encode donne [B, 1, H/2, W/2] sans .latent_dist et sans étape d'échantillonnage.
Entraînement
La reconstruction repose sur une MAE à 0.5 et une LPIPS à 1.0, plus un terme L1 à 0.1 sur le spectre 2D en log-amplitude qui pousse l'énergie haute fréquence sans exiger une phase exacte. Par-dessus, plusieurs astuces visent à rendre le latent plus facile à utiliser en diffusion :
- Retournements et rotations de latent empruntés à EQ-VAE : sur 50 % des étapes, le latent est retourné ou pivoté de 90 degrés puis décodé face à l'image transformée de la même manière, de sorte que le latent doit être une image de l'image plutôt qu'un code arbitraire.
- Décodage perturbé par du bruit : sur 20 % des étapes, le décodeur reçoit
z + sigma * noiseavecsigmatiré par image dansU(0, 0.5)et doit malgré tout reconstruire l'image propre, ce qui apprend au décodeur à tolérer l'erreur de diffusion. - 5 % des images sont remplacées par une couleur uniforme aléatoire, car les zones uniformes sont le cas difficile pour un latent normalisé par image.
- La variante 2x1 a passé ses 9k dernières étapes sous un critique : un ViT SigLIP2 NaFlex gelé fournit des features de patch issues des calques 4, 8 et 12 de l'image réelle et de l'image reconstruite en résolution native, de petites têtes convolutives normalisées spectralement s'entraînent avec une hinge loss plus R1, et le décodeur reçoit le terme générateur avec un poids de 0.1. La version 2x2 a été entraînée sans critique.
Les fichiers de poids publiés sont les checkpoints d'entraînement, inchangés, en fp32. Les charger avec torch_dtype=torch.bfloat16 pour l'inférence coûte environ 0.05 dB.
Disponibilité
Primal VAE n'est pas encore utilisable dans ComfyUI. Il n'existe pas de nœud de chargement de VAE personnalisé, pas de repack Comfy-Org ni de prise en charge native : le référentiel fournit une implémentation diffusers AutoModel avec trust_remote_code=True (modeling_primal_vae.py plus config.json), et le chemin documenté est AutoModel.from_pretrained("ostris/primal_vae", variant="2x1") suivi de patchify / unpatchify pour atteindre la disposition de tokens Flux.1 ou Flux.2.
Une discussion du référentiel ouverte le 31 octobre demande directement s'il peut fonctionner dans ComfyUI et n'a pas encore de réponse fonctionnelle ; une autre discussion de la communauté propose un binaire Rust monofichier pour l'inférence locale sur GPU ou CPU.
Tout le reste passe par Python : vae.encode(x) renvoie le latent, vae.patchify(latent, compression=8) le transforme en tokens de forme Flux.1 ou Flux.2, et vae.decode(vae.unpatchify(tokens)) le ramène, sans aucun facteur d'échelle ni décalage appliqué d'un côté ou de l'autre. L'architecture est lue à partir des formes de tenseurs, donc un fine-tune exporté depuis ai-toolkit peut être chargé avec weights_name="my_finetune.safetensors".
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.