RelayVSR X2 : un upscaler vidéo 2x entraîné sur des clips H3
L'équipe LightX2V a réentraîné RelayVSR pour une super-résolution vidéo native 2x : 45 FPS sur un H100, suppression du scintillement et deux checkpoints.
scripts/relayvsr de LightX2V, et aucun nœud ComfyUI n'existe encore pour ce modèle.
Un clip H3 en 768x1344 double proprement vers 1536x2688, ce qui correspond à une résolution de finition normale. RelayVSR ne faisait que du 4x : le même clip partait donc en 3072x5376 et payait quatre fois le travail de pixels pour une sortie dont la plupart des plans n'ont pas besoin. X2 calcule en 2x au lieu de calculer en 4x puis de redimensionner vers le bas.
Le scintillement d'abord, la netteté ensuite
Les modèles de super-résolution ont tendance à amplifier le léger scintillement temporel que porte déjà une vidéo générée : le clip upscalé peut donc paraître moins bon en mouvement que la source, même lorsque les images individuelles semblent plus nettes. La conception de RelayVSR cible précisément ce problème : un grand modèle génératif écrit des latents de référence pour quelques images clés seulement, et un petit réseau VSR propage ces références sur chaque image, avec un lookahead borné et un cache KV en anneau d'images dans l'implémentation LightX2V.
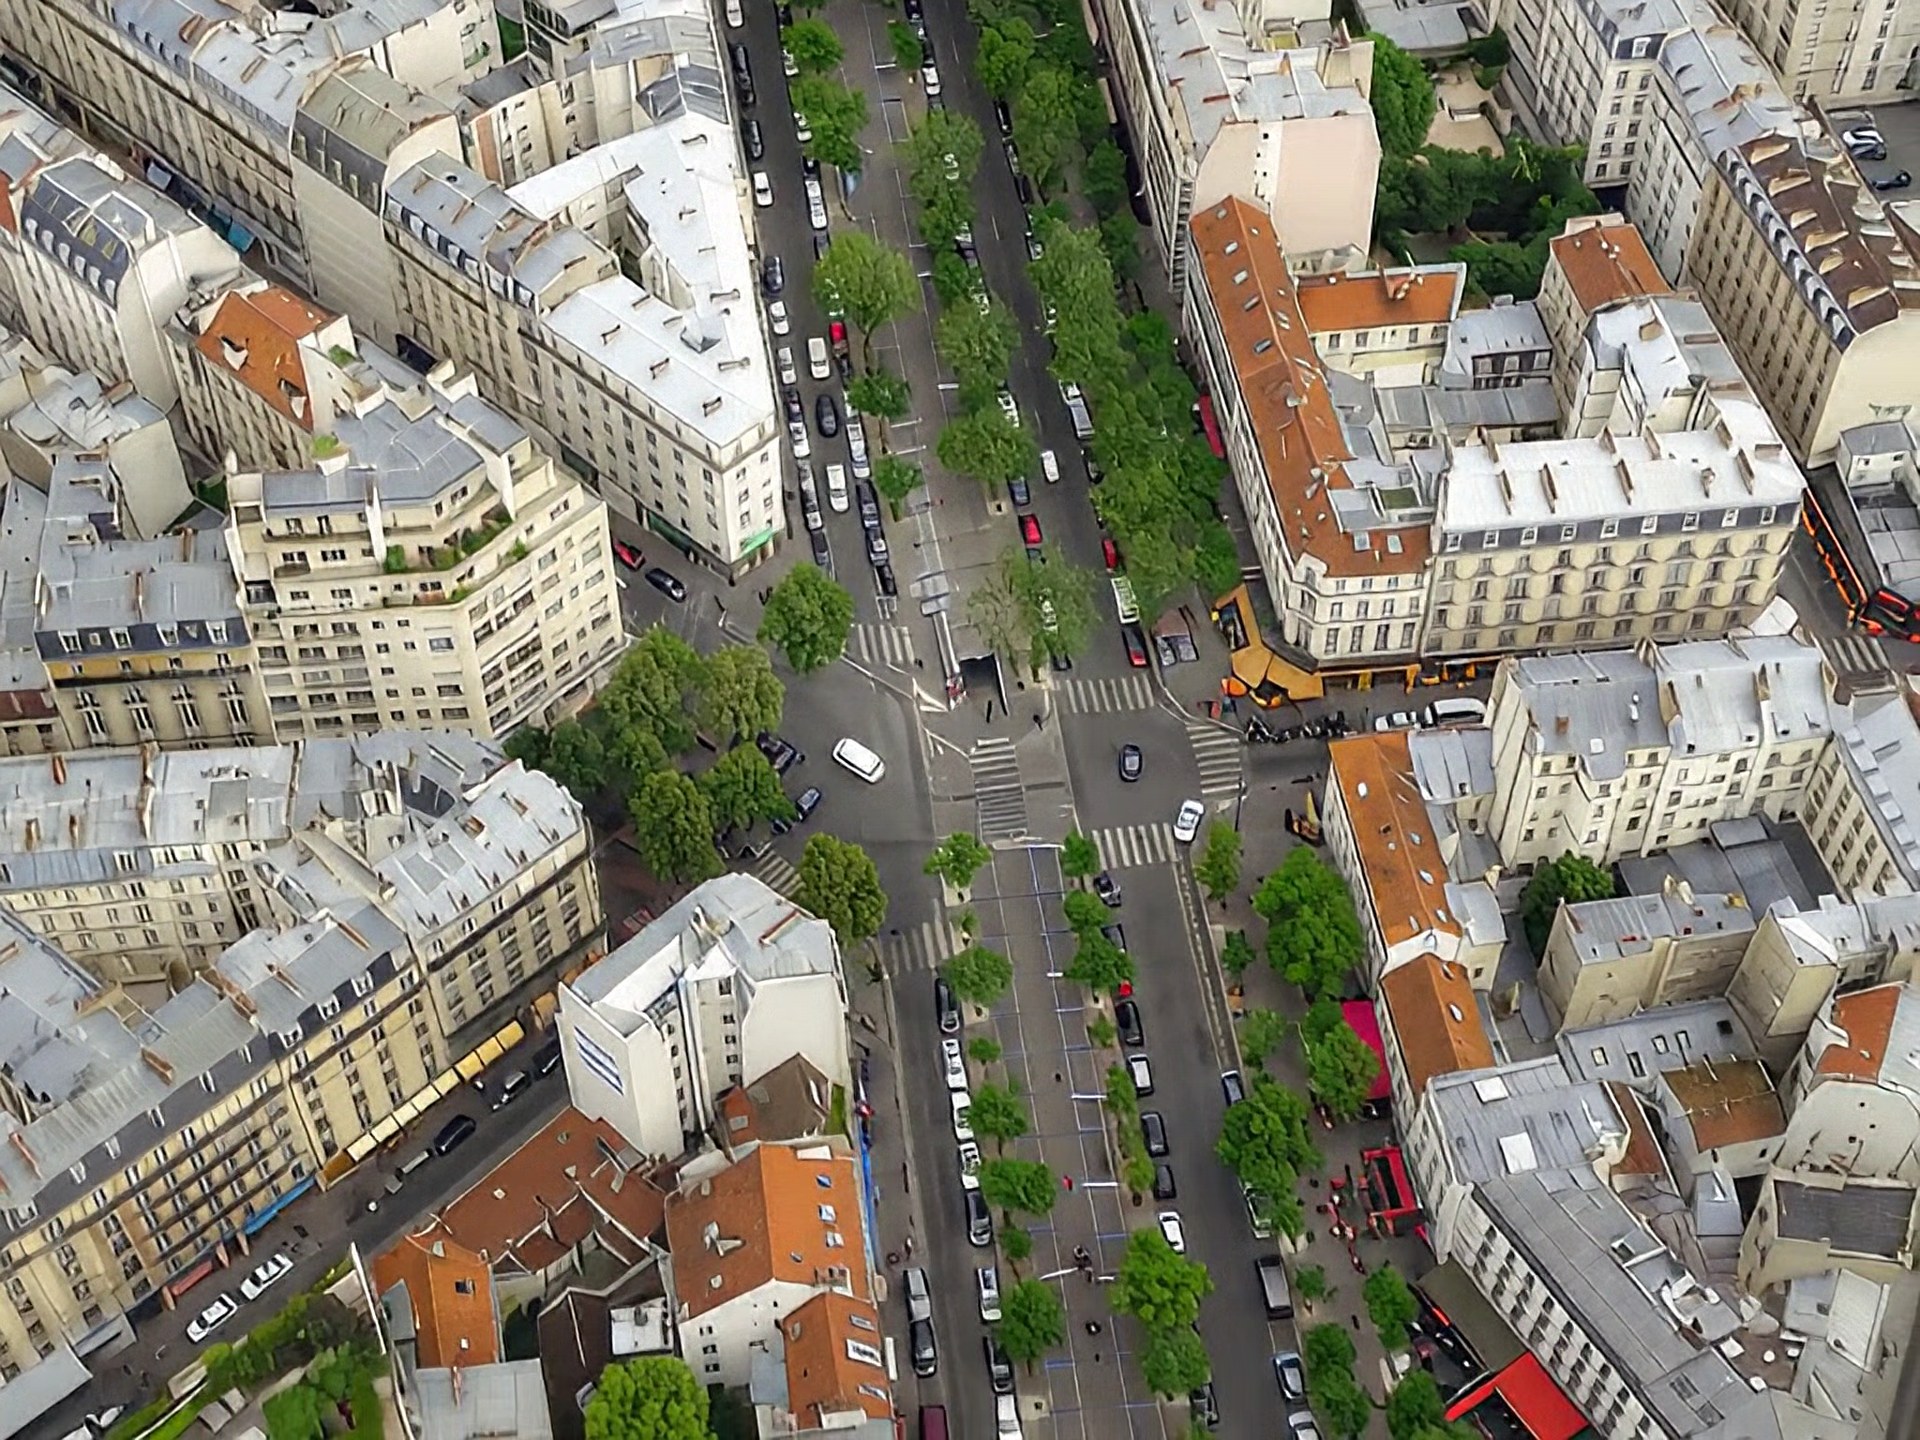
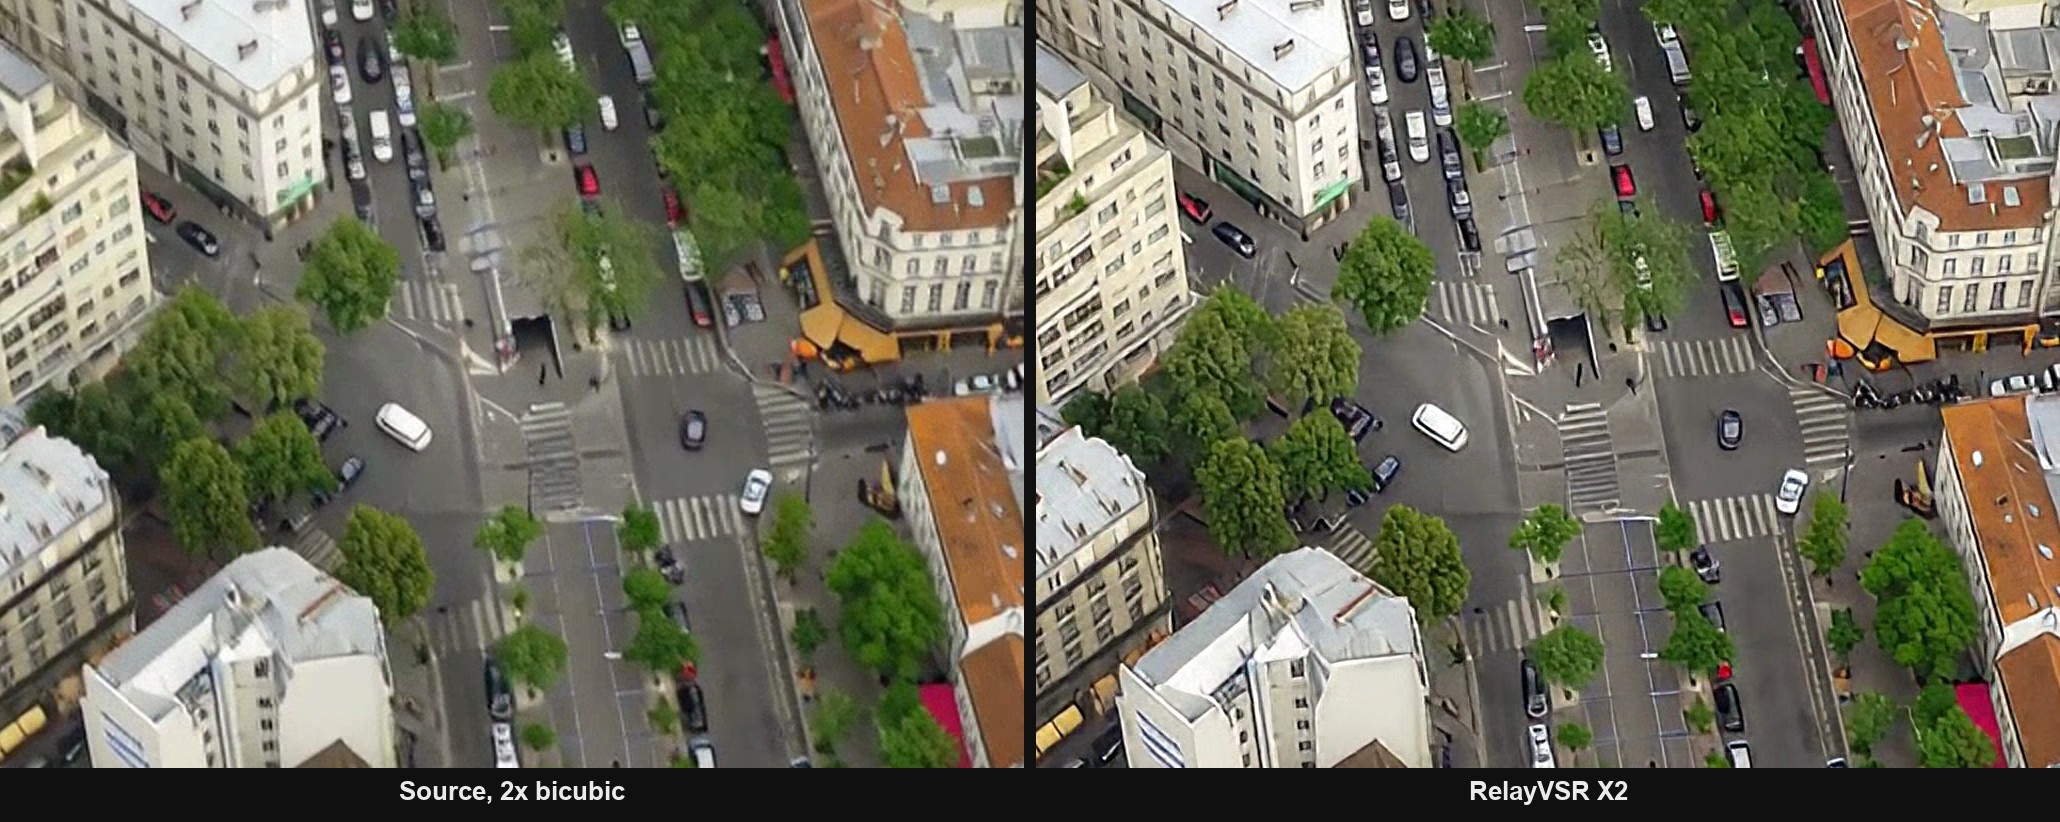
L'entrée du benchmark publié est elle-même une sortie H3 : un clip de toit vu par drone en 1024x768 à 24 fps, avec un léger scintillement préexistant. La grille de comparaison montre donc le cas autour duquel le modèle a été entraîné, et non des images de caméra propres.
Deux checkpoints, une seule échelle
La version X2 se présente sous la forme de deux fichiers qui doivent être téléchargés dans le même répertoire :
wan_x2.safetensors(10,1 Go), le checkpoint basé sur Wan qui génère les références des images clés éparses.flash_x2.safetensors(127 Mo), le décodeur conditionnel compact qui super-résout les images restantes.
Le runner LightX2V valide l'échelle et l'architecture, et rejette les poids 2x et 4x mélangés plutôt que de charger une paire incompatible. La taille de sortie n'est pas un réglage utilisateur : elle suit les dimensions d'entrée et sr_ratio, qui doit valoir 2 pour le modèle X2. L'ancien checkpoint 4x accepte toujours sr_ratio=2, mais il calcule en 4x en interne puis réduit ensuite, ce qui est justement le coût que cette version existe pour éviter.
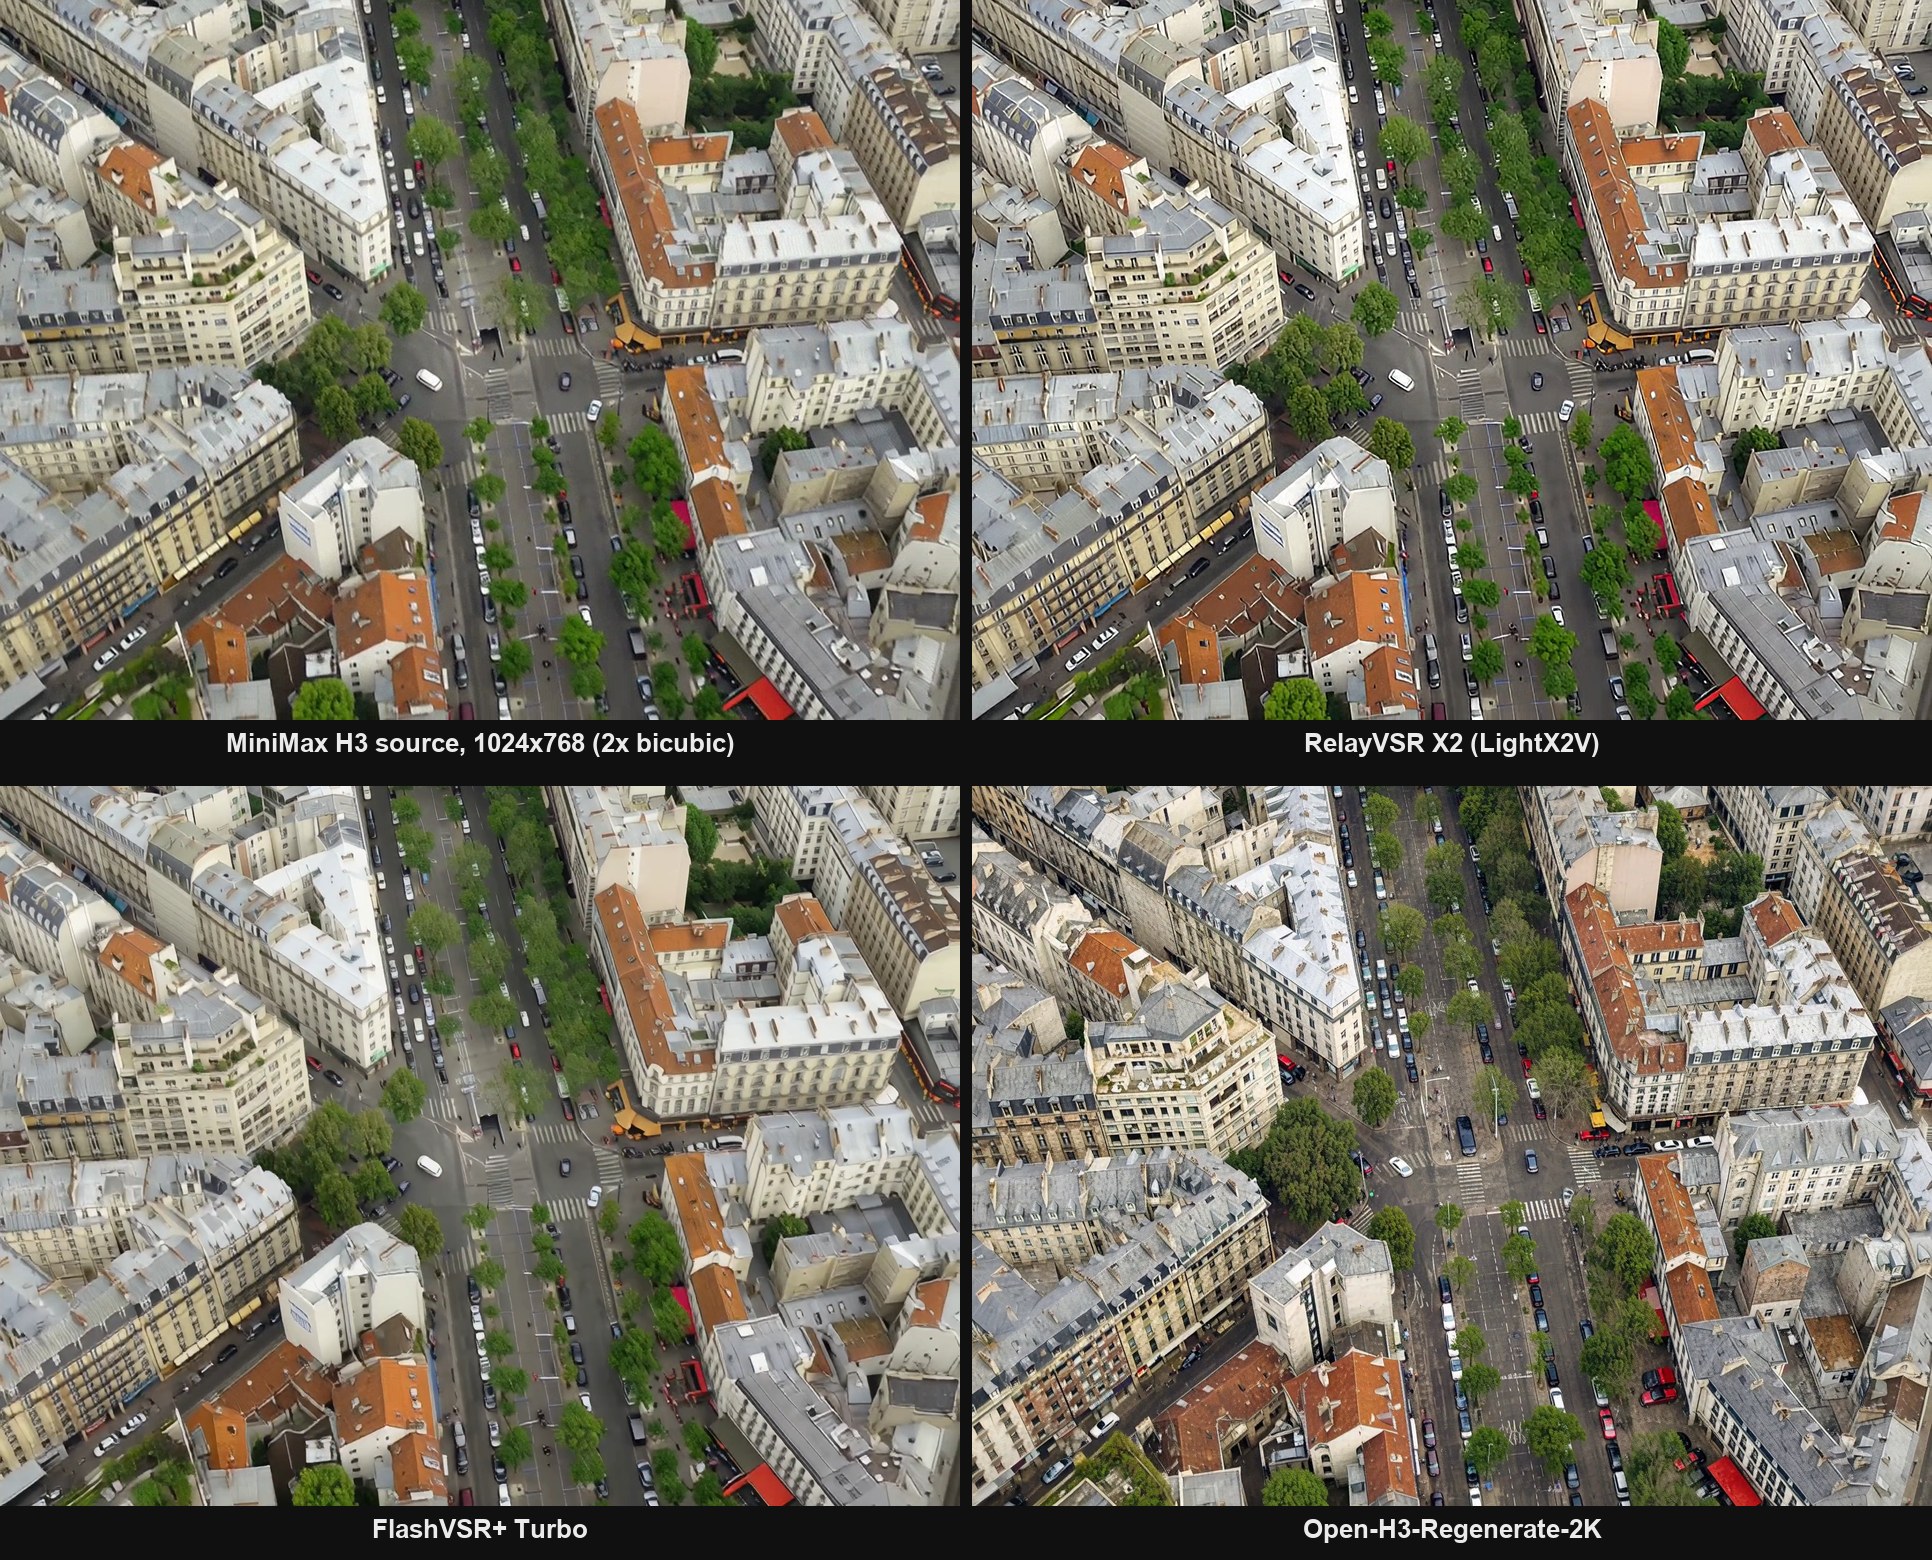
Même image affichée en 960x720 : source H3 upscalée 2x en bicubique (en haut à gauche), RelayVSR X2 (en haut à droite), FlashVSR+ Turbo (en bas à gauche) et Open-H3-Regenerate-2K (en bas à droite). Images issues des clips du benchmark publié.
Mesuré sur un seul H100
La carte rapporte une exécution mesurée par modèle après un échauffement à résolution identique, séquentiellement sur un seul H100 80GB avec PyTorch 2.11.0 et CUDA 13.0, sur 243 images de 1024x768 à 24 fps :
- RelayVSR X2 (LightX2V) : 5,348 s, 45,44 FPS, sortie 2048x1536
- SwiftVR (LightX2V) : 6,399 s, 37,98 FPS
- SwiftVR : 7,252 s, 33,51 FPS
- RelayVSR 4x (LightX2V) : 19,304 s, 12,59 FPS, sortie 4096x3072
- RelayVSR 4x : 26,332 s, 9,23 FPS, sortie 4096x3072
- FlashVSR+ Turbo : 54,024 s, 4,50 FPS
- SeedVR2-3B : 352,820 s, 0,69 FPS
- Open-H3-Regenerate-2K : 784,954 s, 0,31 FPS
Ce sont des chiffres H100 pour un clip de 10 secondes. L'article derrière le modèle 4x original rapporte 29,29 FPS en 1080p sur un A100 avec 13,82 Go de mémoire de pointe, contre 7,80 FPS et 24,447 Go pour FlashVSR-Tiny : l'architecture est donc conçue pour tenir sur un seul GPU plutôt que pour gagner sur une machine de benchmark.
Une mesure précoce d'un utilisateur sur Banodoco situe l'écart dans la même portée sur du matériel grand public : JohnDopamine a relevé les horodatages d'une exécution où l'étape de finition de Relay a pris environ 85 secondes, tandis que FlashVSR+ en affichait 331 (message). Même clip, GPU et configuration propres à cet utilisateur : à lire comme un ratio plutôt que comme une vitesse absolue.
L'exécuter
L'inférence se trouve dans LightX2V, pas dans un paquet séparé :
git clone https://github.com/ModelTC/LightX2V.git
cd LightX2V
hf download lightx2v/RelayVSR_X2 \
    wan_x2.safetensors flash_x2.safetensors \
    --local-dir ./models/RelayVSR_X2
Pointez scripts/relayvsr/run_relayvsr_x2_sr.sh vers le clone, les poids, une vidéo d'entrée et un GPU, conservez --model_cls relayvsr_x2 avec --config_json configs/relayvsr/relayvsr_x2.json et --sr_ratio 2, puis lancez le script depuis la racine du référentiel. La configuration par défaut garde les deux checkpoints résidents, avec compilation et échauffement activés ; relayvsr_x2_block_offload.json décharge les blocs Wan pour réduire l'usage de VRAM, et relayvsr_x2_sp.json répartit un clip sur deux GPU.
Pour un travail répété, il existe un mode serveur résident : démarrez python -m lightx2v.server --model_cls relayvsr_x2 --task sr, puis envoyez le chemin d'entrée, sr_ratio, le chemin de sortie et la graine à /v1/tasks/video/ pour chaque clip, afin que les poids ne se chargent qu'une fois.
Disponibilité
RelayVSR X2 est une version LightX2V : Linux et un GPU NVIDIA, exécution en CLI ou via le serveur, sans nœud ni wrapper ComfyUI publié à ce jour et sans pipeline diffusers dans le référentiel. Le changelog de LightX2V mentionne l'encodage asynchrone et la conservation de l'audio source, si bien qu'un clip H3 garde la piste avec laquelle il a été généré. Quiconque veut l'utiliser dans un graphique doit actuellement envelopper le runner lui-même.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.