Pika H3 Flex transforme MiniMax H3 en un LoRA ComfyUI en six étapes
Pika a post-entraîné MiniMax H3 pour en faire Pika H3 Flex, un modèle six étapes livré en deux LoRA ComfyUI, avec trois modèles officiels et 12 références.
Pika H3 Flex est la version post-entraînée de MiniMax H3 par Pika : le même modèle omni de 33B, réentraîné sur un corpus audio-vidéo interne, distillé d'un enseignant à 50 étapes jusqu'à six étapes d'échantillonnage, puis affiné par apprentissage par récompense et optimisation des préférences. Pika a publié les poids sur Hugging Face, ouvert le package d'inférence sur GitHub et livré une note technique accompagnée de l'article de lancement le 29 octobre 2026.
Pour ComfyUI, l'essentiel est que Flex n'est pas une nouvelle architecture. Il arrive sous la forme de deux adaptateurs LoRA dans la disposition native des modules MiniMax H3 : il se charge donc via le nœud standard LoraLoaderModelOnly, par-dessus la base H3 que vous possédez déjà, avec trois modèles de flux de travail officiels dans la bibliothèque de modèles.
 |  |
|---|---|
| Référence de première image | Une image de la sortie en six étapes |
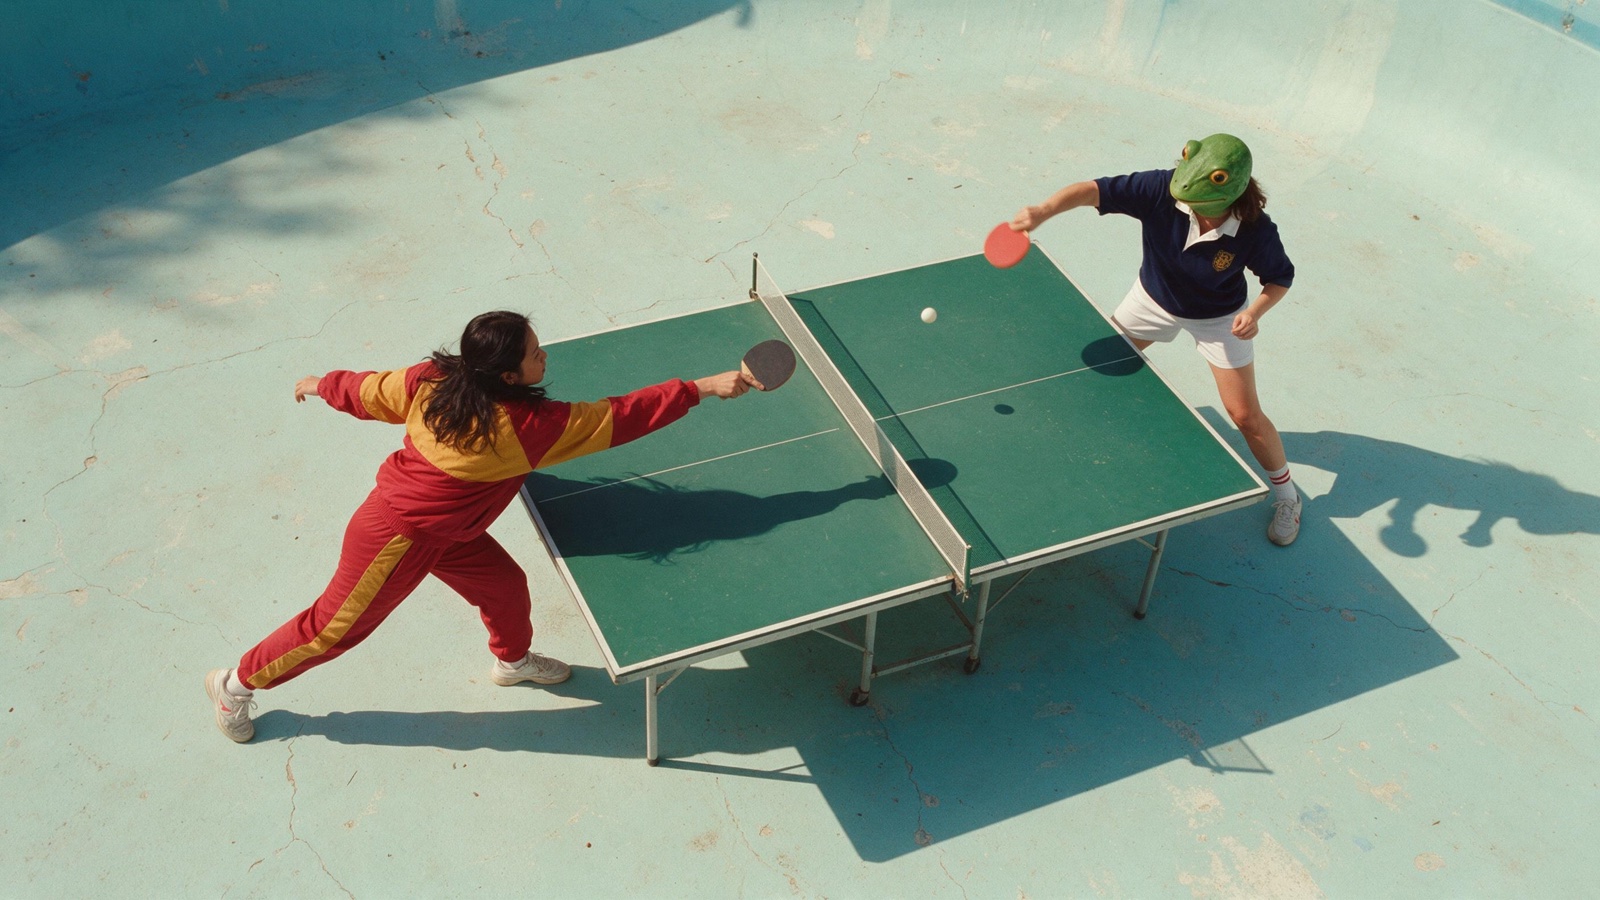
La démo de tennis de table : une seule image en entrée, et le prompt demande cinq mouvements de caméra scriptés (vue du dessus, grue descendante, panoramiques fouettés, une orbite à 180 degrés, un travelling bas) dans une prise de 15 secondes. Source : carte du modèle Pika H3 Flex
Le clip complet du rallye de caméra avec sa bande-son générée, issu de la sélection de démonstrations de Pika dans le référentiel du modèle.
Deux adaptateurs, un programme en six étapes
Flex sépare les deux voies de conditionnement de H3 en adaptateurs distincts, en suivant la séparation opérée par le modèle de base lui-même :
| Adaptateur | Conditionné sur | Tâches |
|---|---|---|
| FL2VA | texte, plus éventuellement une première et/ou une dernière image | texte vers vidéo (T2V), première image (I2V), dernière image, première et dernière image |
| Ref2VA | texte, plus des références ordonnées d'images, de vidéos et d'audio | référence vers vidéo, transfert de mouvement, échange de personnage, édition guidée par référence |
Ref2VA accepte jusqu'à 9 images, 3 vidéos et 3 clips audio autonomes, avec 12 fichiers de référence au total, et au moins une image ou une vidéo est requise. Chaque vidéo de référence ou clip audio autonome doit durer de 2 à 15 secondes, chaque groupe étant plafonné à 15 secondes cumulées. La bande-son d'une vidéo reste attachée à cette vidéo et ne compte pas comme un fichier audio supplémentaire.
La sortie est nativement en 480p ou 768p sur 11 ratios d'aspect, à 24 fps, avec un audio stéréo à 32 kHz mixé dans le fichier, pour des durées demandées de 5 à 15 secondes. La grille d'images de H3 arrondit ces valeurs : une demande de 5 secondes renvoie 124 images, une demande de 15 secondes en renvoie 362.
Un seul prompt pilote trois personnes animées séparément sur des balcons superposés à travers une orbite, un push-in, un boom vertical et une orbite inverse, sans aucune coupe.
La sortie ComfyUI
Trois modèles sont livrés dans la bibliothèque de modèles ComfyUI sous Video : video_pika_h3_flex_t2v.json, video_pika_h3_flex_fl2va.json et video_pika_h3_flex_ref2va.json, tous documentés sur la page de tutoriel ComfyUI. Chacun associe un modèle de diffusion H3 int8 élagué à l'adaptateur correspondant et exécute le programme publié par Pika : l'échantillonneur LCM avec ManualSigmas et CFG 1.0 via BasicGuider, la force de l'adaptateur fixée à 1.0.
Deux détails comptent si vous construisez votre propre graphique au lieu de charger un modèle :
- La grille de sigmas fait partie du contrat du checkpoint. Le manifeste de Pika liste les nœuds
1000/750/500/250/100/40/0, un décalage vidéo de 12, un décalage audio de 3 et un bruit intermédiaire frais. Choisir six étapes dans un échantillonneur générique ne reproduit pas ce contrat. - N'empilez pas un second LoRA d'accélération. L'adaptateur est déjà distillé en six étapes, et le tutoriel précise qu'ajouter un LoRA turbo ou Lightning par-dessus casse la sortie.
Les connecteurs sont de simples conversions BF16 plutôt qu'un nouveau checkpoint : les modules ordinaires conservent le rang 128, tandis que les projections Q/K/V fusionnées ont été portées au rang 384, et la conversion réordonne les moitiés SwiGLU pour correspondre à la disposition native de H3. Le readme de l'adaptateur de Pika précise explicitement que l'intégrité des fichiers et la conversion des tenseurs ont été validées, mais qu'aucun rendu ComfyUI de bout en bout n'a été vérifié dans le cadre du téléversement. Attendez-vous à un certain écart par rapport au package d'inférence de référence.
Un premier retour d'expérience du canal #pika-h3-flex-early le confirme : le testeur NebSH a enchaîné une passe de 6 étapes en 960x544 dans un upscale latent plus une passe de 4 étapes en 1920x1088, obtenant un résultat en 2560x1440 en 3 min 17 s, tandis que WAS a signalé du popping sur les détails à haute fréquence, comme des oiseaux lointains, à quatre étapes, et a suggéré de rester à six.
Comment Pika est arrivé à six étapes
L'analyse technique approfondie décrit trois étapes de post-entraînement par-dessus le H3 publié, distillé par guidage :
- Affinage supervisé sur un jeu de données audio-vidéo interne et esthétiquement sélectionné, couvrant des tâches de génération et d'édition, toujours aux 50 étapes de l'enseignant.
- Projected Distribution Matching Distillation (PDMD, Wang et al. 2026) pour réduire l'échantillonnage de 50 à six étapes. Pika indique que la DMD standard était instable dans leurs essais et que la PDMD s'entraînait plus fiablement avec une meilleure qualité de sortie.
- Apprentissage par récompense après distillation via ReFL (esthétique et netteté) et DPO (suivi d'instructions, réalisme, qualité visuelle), entraînés comme deux LoRA distincts puis fusionnés en un seul adaptateur, de sorte que le comportement combiné ne coûte aucune étape d'échantillonnage supplémentaire.
Une pile de service distincte fait le reste : projections AdaLN dépendantes du pas de temps mises en cache, noyaux fusionnés, FlashAttention-4 et attention à blocs épars avec communication compressée. Sur huit GPU B300 en 768p à 5 secondes avec audio, cela a fait passer l'inférence complète de 3,409 s à 2,129 s, soit un gain de vitesse de 1,60x, à checkpoint et programme en six étapes constants.
Ce que disent les chiffres, et ce qu'ils ne disent pas
Pika a évalué Flex face à MiniMax H3 officiel, Fal H3 Max et HeyGen Video (qualité) en 768p sur le même jeu de prompts, et annonce le meilleur score sur les cinq métriques de qualité visuelle et audio :
| Métrique | Pika H3 Flex | MiniMax H3 | Fal H3 Max |
|---|---|---|---|
| Technique vidéo | 12,3 | 11,7 | 10,6 |
| Esthétique vidéo | 5,41 | 5,28 | 5,00 |
| Esthétique audio | 7,02 | 6,85 | 6,89 |
| Alignement audio-vidéo | 0,212 | 0,208 | 0,216 |
L'alignement audio-vidéo et texte-vidéo se situe à peu près au niveau des comparateurs, et ces chiffres proviennent de l'évaluation de Pika elle-même. Dans leur étude en aveugle par paires, Flex domine sur l'anatomie humaine, la composition complexe et la synchronisation audio pour la génération conditionnée par texte et image, ainsi que sur le style visuel, le cadrage et les mouvements de caméra pour la génération conditionnée par référence. Pika précise aussi que les autres systèmes restent préférés sur la physique, la narration multi-scènes, l'éclairage et les matériaux, ainsi que sur les tâches de référence très axées sur l'action.
Les A/B de la communauté sont pour l'instant limités, mais cohérents avec un modèle en six étapes utilisable plutôt qu'avec un miracle gratuit. Kijai a exécuté le même prompt T2V d'exemple avec DMAD puis Flex, six étapes chacun, et a rapporté que DMAD échouait sur ce cas, tandis que djbfilmz a comparé Flex en six étapes à une exécution en vingt étapes sans l'adaptateur et a déclaré qu'il itérerait sur Flex et ferait un rendu complet en vingt étapes pour les versions finales. Le tutoriel revendique pour sa part un clip de 5 secondes en 1344x768 en une minute environ sur une seule carte.
 |  |
|---|---|
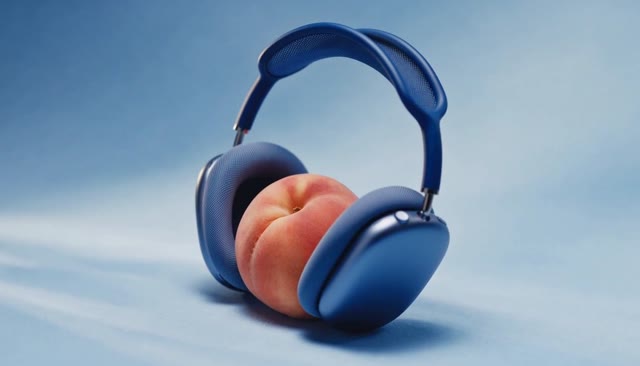
| Film produit multi-plans | Références de personnage et d'environnement plus un clip de mouvement |
Deux autres cas de démonstration : un film publicitaire en neuf plans à partir d'une seule référence de produit, et un transfert de mouvement qui reprend la chorégraphie d'une vidéo tandis que l'identité et le style viennent de deux images fixes.
Disponibilité
Le référentiel contient les deux adaptateurs FP32 (fl2va/adapter.safetensors, ref2va/adapter.safetensors, 2,77 Go chacun) pour le package d'inférence Pika, les conversions ComfyUI BF16 (1,96 Go chacune) sous comfy/loras/, et les composants de base H3 au format Diffusers qui, selon Pika, totalisent environ 210 Go. Chaque modèle ComfyUI ne charge que la partition de transformer dont il a besoin.
Les extensions hébergées de Pika restent hors du téléchargement : l'upsampling 1080p, 2K et 4K à partir d'un brouillon 768p, cinq pistes audio séparées (dialogue, musique, SFX, bruitage, ambiance), l'amélioration de prompt et la pile de service accélérée sont toutes des fonctionnalités API. L'inférence locale en poids ouverts couvre le 480p et le 768p.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.