Open-H3-Regenerate-2K : affinage 4K ouvert pour MiniMax H3
NVlabs Sana publie Open-H3-Regenerate-2K, un LoRA d'affinage ouvert qui redessine les brouillons MiniMax H3 en 2K et 4K en trois étapes de débruitage.
Open-H3-Regenerate-2K est l'alternative ouverte de l'équipe NVlabs Sana à l'étape H3-Regenerate-2K de MiniMax, la seconde moitié du pipeline H3 qui redessine un brouillon 768P terminé à une résolution supérieure. La version hébergée de cette étape ne fournit aucun poids ; l'équipe l'a donc reconstruite sous la forme d'un unique LoRA d'affinage sur un transformer H3 gelé et un VAE vidéo, puis a publié les poids sur Hugging Face avec le code et une page projet.
L'affineur prend un brouillon en 384P, 512P, 576P ou 768P et renvoie un clip natif en 768P, 1080P, 2K (2560x1440) ou 4K (3840x2160) de 5 à 15 secondes, en trois étapes de débruitage plutôt qu'en une passe d'échantillonnage complète. Par défaut, il décode via le VAE H3 rapide à 24 calques de StreamRender-H3 plutôt qu'avec le décodeur publié.
 | 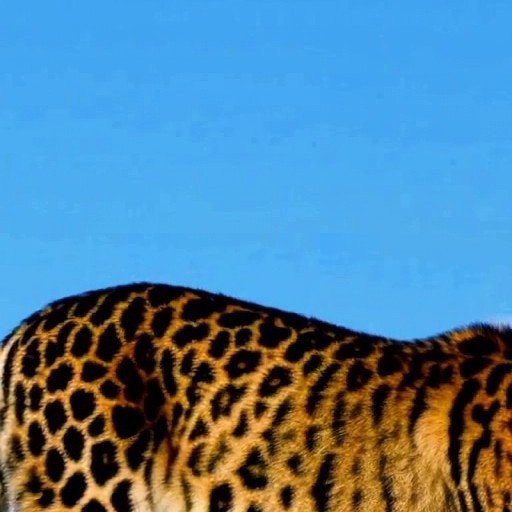 |
|---|---|
| Image du brouillon, même recadrage | Régénéré en 2K |
La même image et la même fenêtre issues du jeu de comparaison du projet, qui associe des recadrages de l'API officielle H3-Regenerate-2K à ceux de l'affineur ouvert. Source : page projet
Ce que remplace l'affineur
H3 génère en deux étapes : le modèle de base fixe le contenu et le mouvement à basse résolution, puis une étape de régénération redessine les visages, les tissus, la fourrure et le feuillage en pleine taille. Seule la première étape a été publiée sous forme de poids en août ; la seconde n'existait que sous forme d'API hébergée qui accepte une sortie H3 768P non modifiée et renvoie du 2K.
Open-H3-Regenerate-2K conserve la même séparation et ouvre la seconde étape. L'entrée n'est pas limitée au modèle de base H3 : le projet présente des brouillons réalisés par LTX-2 et SANA-Video en 1024x576, et l'affineur transpose leur disposition, leur couleur et leur mouvement sur la grille plus grande.
Comment trois étapes font le travail
Le brouillon est encodé une seule fois, puis un upscaler latent à convolution 3D agrandit le latent directement sur la grille cible, sans décodage ni réencodage intermédiaire. Le latent agrandi est rebruité jusqu'à sigma 0.909 puis débruité en trois étapes d'Euler (0.909, 0.857, 0.667 vers 0) avec le classifier-free guidance désactivé, de sorte que chaque étape n'est qu'un seul appel au transformer en pleine résolution.
Trois adaptateurs portent le comportement en quelques étapes, et la publication les fusionne en un seul fichier en concaténant leurs facteurs sur l'axe de rang :
- l'affineur Open-H3 lui-même, EMA à l'étape 5000, rang 384
- LightX2V FL2VA Turbo v1.2, rang 128
- LMS Sharp v1.0, rang 64
Le LoRA fusionné est de rang 576 sur 312 couches linéaires, stocké en FP32 aux côtés des branches de courbe de pas de temps Sharp, conservées en modules séparés car elles lisent une courbe 8-D au lieu de l'entrée de la couche. La vérification de fusion du projet indique que le delta fusionné correspond aux trois adaptateurs séparés avec une erreur relative de 2.2e-8.
Vitesse et benchmarks
L'équipe a mesuré un clip de 5 secondes sur un seul B200, du latent 768P vers 2560x1440, à chaud, médiane de trois exécutions. L'upscale latent, les trois étapes d'affinage et le décodage VAE ont pris 22,45 secondes avec le forward SoL-Engine et le décodeur VAE rapide, contre 87,26 secondes pour le forward diffusers standard avec le décodeur publié. C'est en contournant le décodage et le réencodage que vient l'essentiel du gain : le décodeur rapide traite le clip 2K en 1,58 seconde au lieu d'environ 15.
Sur RefinerBench-150, avec les deux systèmes exécutés en 2560x1440, l'équipe rapporte des scores supérieurs à l'API officielle sur les trois axes UniPercept ainsi qu'en qualité esthétique, qualité d'image et cohérence du sujet VBench. Dans une étude en aveugle de 200 jugements, l'affineur ouvert a été préféré dans 87 % des cas.
 | 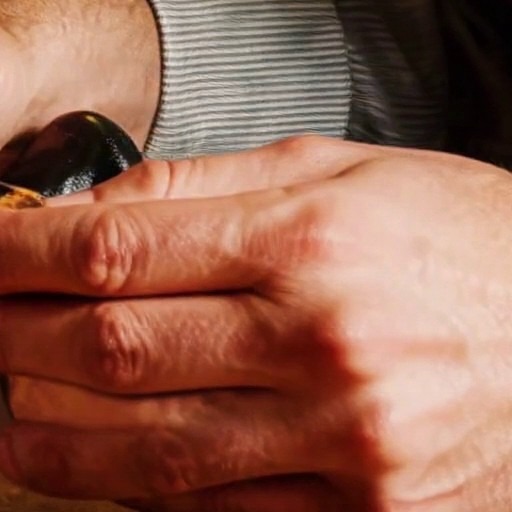 |
|---|---|
| Image du brouillon, seconde scène | Régénéré en 2K |
Une seconde paire de recadrages issue du même jeu de comparaison. Source : page projet
Disponibilité
Il n'existe pas de nœuds ComfyUI officiels pour l'affineur. L'implémentation de référence est une CLI Python dans le référentiel Sana (Linux, Python 3.11, PyTorch 2.11 avec CUDA 13.0), et l'assistant download.py récupère les poids, le LoRA fusionné, l'upsampler latent et le décodeur VAE rapide.
Des utilisateurs de ComfyUI l'ont porté eux-mêmes : Kijai a publié l'affineur seul sous forme de LoRA de rang 384 afin qu'il puisse être associé à d'autres distills, et des conversions communautaires du LoRA complet adapté sont disponibles sur Hugging Face (father558, DrakenZA). Les convertisseurs signalent qu'une conversion directe reproduit des poids erronés, car la disposition Diffusers nécessite une transformation SwiGLU ; les conversions réalisées sans cette étape sembleront cassées.
Le référentiel liste le LoRA d'affinage, le décodeur VAE rapide (1,62 milliard de paramètres) et une copie non modifiée des composants Diffusers H3, de sorte que tout le chemin 768P vers 2K peut fonctionner sans l'API MiniMax.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.