Qwen-Image 2.1 en 2 étapes : LoRA DMD2 à CFG 1
Un LoRA de distillation DMD2 fait tourner Qwen-Image 2.1 en texte vers image et édition multi-référence en 2 étapes à CFG 1, avec une démo Space en direct.
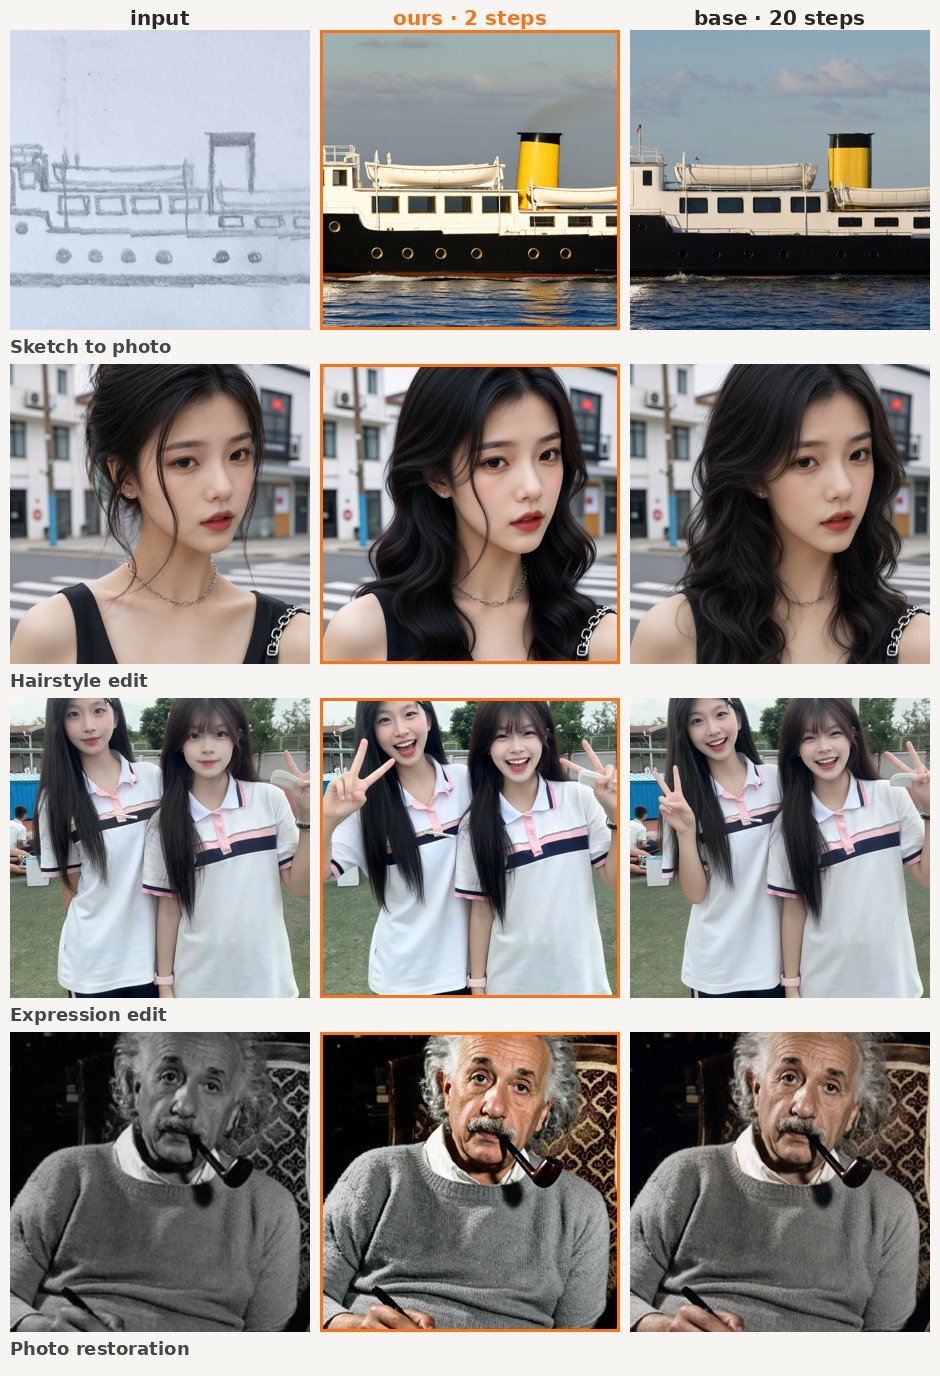
Croquis vers photo, coiffure, expression et restauration de photo, même entrée, même prompt et même graine. Chaque ligne présente l'entrée, le LoRA à 2 étapes, puis le modèle de base à 20 étapes.
Pourquoi 2 étapes constitue un autre palier
Qwen-Image 2.1 est livré à 40 étapes, et les accélérateurs publiés jusqu'ici descendent à 8 (le checkpoint Turbo d'Alibaba) et à 4 (le LoRA Lightning de LightX2V). Cet adaptateur vise le plancher de cette plage, et le planning est fixe plutôt que recommandé :
| Paramètre | Valeur |
|---|---|
| Étapes | 2 |
| Planning sigma | [1.0, 0.5], fixe |
| CFG | 1 (true_cfg_scale=1.0) |
| Rang / alpha du LoRA | 32 / 32 |
| Modules adaptés | attention uniquement : to_q, to_k, to_v, to_out.0 |
| Taille du fichier | 64 MB (256 tenseurs) |
La carte est explicite : le LoRA a été entraîné sur cette paire exacte de sigmas, le scheduler doit donc être épinglé avec use_dynamic_shifting=False et shift=1.0. En laissant le décalage dynamique activé, les sigmas sont remis à l'échelle selon la résolution, et l'adaptateur n'échantillonne plus le chemin sur lequel il a été distillé.
N'adapter que l'attention est l'autre choix délibéré. La carte soutient que cela préserve l'image d'entrée plus fidèlement pour l'édition que d'adapter aussi les blocs feed-forward, là où les adaptateurs few-step antérieurs pour ce modèle dépensaient l'essentiel de leur budget.
Comment il a été entraîné
DMD2 (Distribution Matching Distillation) avec appariement de distribution on-policy et guidage CFG de l'enseignant, sans perte de régression ni perte GAN dans l'objectif. L'entraînement a duré 2 000 étapes sur un seul H100, sur des recadrages multi-aspects d'environ 1 MP, ce qui correspond à la plage de résolutions utilisée par les démos. L'enseignant à 20 étapes est la référence à laquelle la carte se compare, et non le réglage par défaut du modèle à 40 étapes.
Ce qui survit à 2 étapes
L'édition et la composition multi-référence continuent de fonctionner. Qwen-Image 2.1 prend une liste d'images de condition et le prompt s'y réfère par leur position, donc une exécution en deux étapes résout encore des prompts comme « place le chat de l'image 1 sur la plage de l'image 2 » sans s'effondrer sur une seule référence :
image = pipe(
    prompt="Place the cat from Picture 1 on the beach from Picture 2.",
    image=[cat, beach],
    num_inference_steps=2,
    sigmas=[1.0, 0.5],
    true_cfg_scale=1.0,
).images[0]
Le texte vers image est le même appel avec l'argument image retiré. La sortie RGBA reste inchangée, puisque le canal alpha provient du modèle de base et non de l'adaptateur.
Le Space de démo de l'auteur, Qwen Image 2.1 Realtime, place le même planning derrière une interface en direct : le mode temps réel diffuse un résultat en 512 px qui se met à jour à mesure que le prompt change, et le mode pleine qualité passe à 1024 et 1536.
Exécutions de la communauté
Dans le canal #qwen-image de Banodoco, les testeurs ont exécuté l'adaptateur dans ComfyUI au-dessus des nœuds natifs Qwen-Image 2.1 et publié des comparaisons d'étapes. RuneX a rapporté qu'un échange de tête en 2 étapes fonctionne et qu'une étape supplémentaire était légèrement meilleure, avec les échantillonneurs Euler, ER-SDE et LCM. patientx a mesuré 2, 3 et 4 étapes d'affilée et a trouvé que 3 étapes étaient « très proches du vrai résultat », 4 utilisables et 8 une régression, le temps total d'exécution ne bougeant presque pas entre 2 et 4 étapes car le chargement du modèle domine.
Le seul accroc pour ComfyUI est le nommage. Le safetensors est enregistré au format diffusers/PEFT, transformer.transformer_blocks.N.attn.to_q.lora.down.weight et les tenseurs .lora.up correspondants, tandis que le loader de ComfyUI se base sur les noms de paramètres propres au modèle, commençant à transformer_blocks.N. Le préfixe transformer. doit être retiré avant que le loader ne mappe quoi que ce soit, sinon il signale les clés comme non mappées et le LoRA ne fait rien.
Disponibilité
Poids du LoRA : linoyts/Qwen-Image-2.1-DMD2-2steps sur Hugging Face. Modèle de base : Qwen/Qwen-Image-2.1. Démo : Qwen Image 2.1 Realtime.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.