MiniMax H3 reçoit un LoRA VBVR pour la cohérence des objets
Licon VBVR est un LoRA image-to-video pour MiniMax H3 entraîné sur des données VBVR, ciblant la duplication d'objets, le clipping et l'ordre des actions.
Licon VBVR est un LoRA image-to-video pour MiniMax H3, publié par Licon Studio le 23 octobre (Hugging Face). L'adaptateur est entraîné sur des données VBVR retraitées pour H3, et il cible les modes de défaillance qui apparaissent lorsqu'un clip doit maintenir plusieurs objets dans le temps : copies involontaires du même objet, corps qui traversent les accessoires et actions qui se produisent dans le mauvais ordre.
Images issues du clip de validation du projet. Source : Licon VBVR
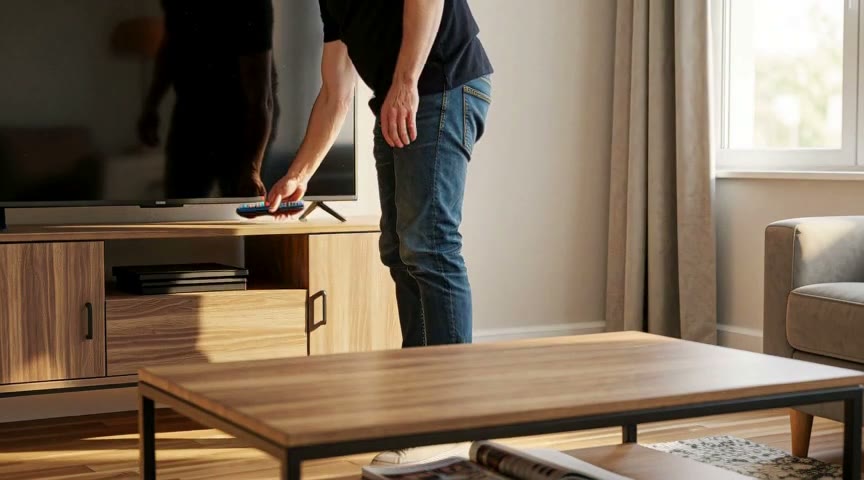
La publication fournit six cas de validation, chacun avec l'image d'entrée de la première frame, le prompt exact et une paire côte à côte rendue avec la même graine, avec et sans le LoRA. Les deux ci-dessous sont en 864x480, longs de 384 frames, soit 12,25 secondes chacun.
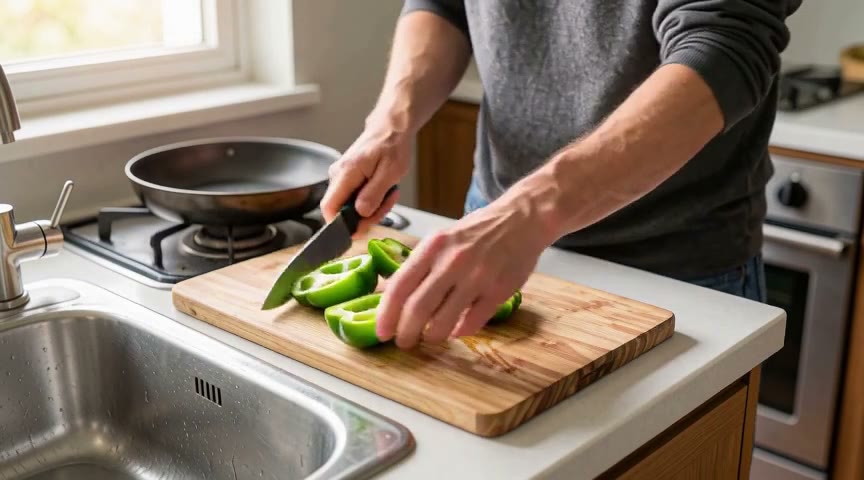 | 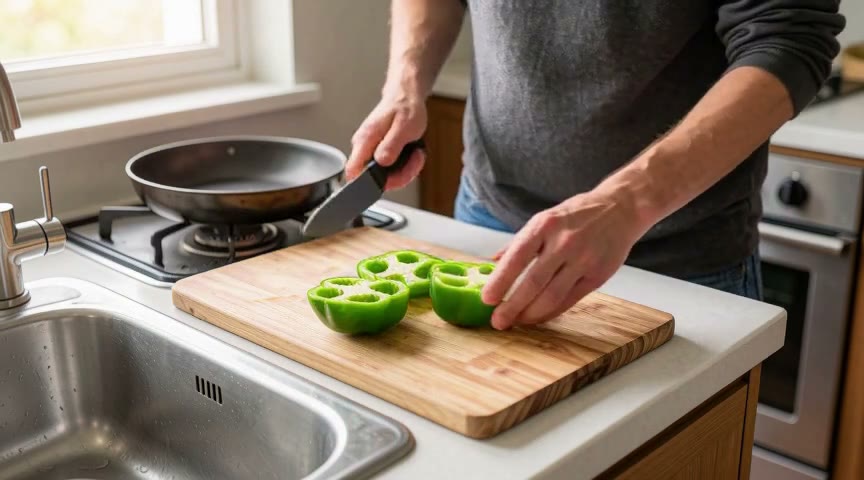 |
|---|---|
| Scène de cuisine, H3 de base | Scène de cuisine, H3 plus VBVR |
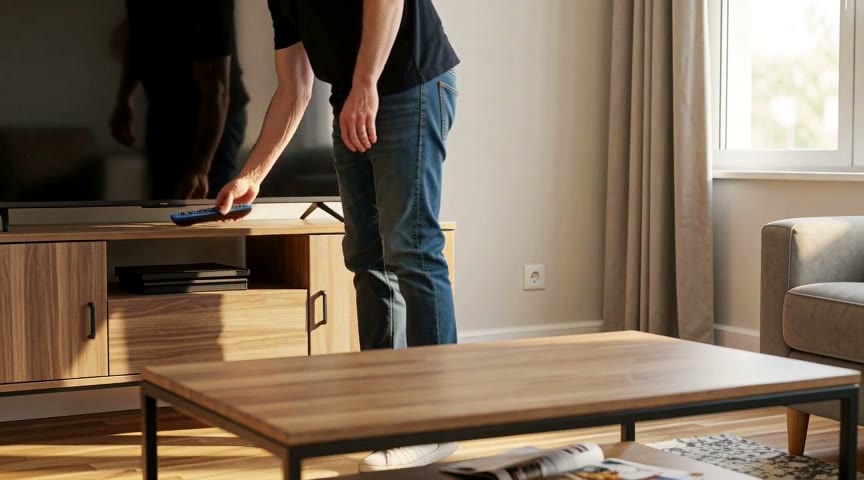 |  |
|---|---|
| Scène de salon, H3 de base | Scène de salon, H3 plus VBVR |
Le cas de la cuisine demande au modèle de rincer un poivron vert, de le couper en morceaux et de les déplacer dans une poêle, en conservant les mêmes morceaux tout au long de la séquence. Le cas du salon demande deux déplacements dans un ordre précis : d'abord le magazine sur l'étagère inférieure, puis la télécommande bleue à côté du téléviseur, tous les autres objets restant là où ils étaient. Les deux prompts décrivent l'action étape par étape et interdisent les objets supplémentaires, ce qui correspond au type d'instruction que le LoRA est censé réellement suivre.
MiniMax H3 de base sur le prompt de la cuisine.
Le même prompt et la même graine avec le LoRA VBVR chargé.
Ce que VBVR apporte au LoRA
VBVR (A Very Big Video Reasoning Suite) est une famille de jeux de données de raisonnement vidéo : des clips construits autour d'une tâche vérifiable, comme suivre un objet à travers une occlusion, ordonner des objets selon une règle ou poursuivre une séquence de formes, avec un prompt décrivant précisément la tâche. Le split SFT public (VBVR-Pro-SFT-Video) est un vaste ensemble de ces clips, et le code d'entraînement ainsi que le benchmark sont des projets distincts.
L'auteur a reconstruit ces données autour du pipeline propre à H3, en adaptant la préparation et le prétraitement à la façon dont H3 s'entraîne, plutôt qu'en entraînant sur le format d'un autre modèle. L'en-tête du LoRA indique 434 894 éléments d'entraînement sur 7 000 étapes en 1280x720, un rang 16, un taux d'apprentissage de 5e-05 avec décroissance cosinus, et ne cible que quatre projections par bloc : attn.qkv_proj, attn.out_proj, mlp.fc1 et mlp.fc2. La supervision est uniquement vidéo, avec un poids de perte audio fixé à zéro, de sorte que le LoRA ne touche pas à la branche audio que H3 génère en parallèle des frames.
L'adaptateur pèse 149 Mo, ce qui est peu pour H3 et cohérent avec la construction en rang 16. Ses métadonnées d'entraînement désignent minimax_h3_fl2va_bf16.safetensors comme checkpoint de base, il appartient donc à la base FL2VA plutôt qu'à la T2VA.
Utilisation dans ComfyUI
Rien n'est à installer. Placez H3-Licon-VBVR-I2V.safetensors dans ComfyUI/models/loras/ et sélectionnez-le dans le nœud LoraLoaderModelOnly d'un flux de travail image-to-video H3.
Le fichier utilise la nomenclature kohya (lora_unet_blocks_0_attn_qkv_proj.lora_up.weight, etc.), que le chargeur LoRA standard de ComfyUI fait correspondre directement aux noms de blocs H3 : aucun script de conversion ni nœud personnalisé n'est nécessaire. Le projet ne publie pas de JSON de flux de travail ; n'importe quel flux de travail H3 existant avec première frame fonctionne, et le LoRA est appliqué comme un simple correctif de modèle.
Limites
Les comparaisons sont qualitatives et proviennent de l'auteur. Il n'y a ni tableau de benchmark ni ablation sur la force du LoRA, la tenue de l'effet à une force plus faible n'est donc pas documentée. Les six clips de validation sont tous des scènes intérieures photoréalistes en 864x480 avec un ou deux objets manipulés, ce qui est plus étroit que le mélange de tâches de l'ensemble d'entraînement. Comme pour tout LoRA H3, la branche audio n'est pas touchée : le son est celui que produit le modèle de base.
Disponibilité
Le LoRA est disponible sur Hugging Face avec les six paires de validation et leurs prompts. Le même laboratoire a précédemment publié le LoRA VBVR pour LTX-2.3 et une version VBVR de Wan 2.2 prête pour ComfyUI, et a publié plus tôt cette année le LoRA de référence multi-sujets MSR-v2 présenté dans Licon MSR-v2.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.