Hy-Nomas : le modèle de monde interactif de Tencent Hunyuan
Tencent Hunyuan a publié Hy-Nomas, un modèle de monde interactif en 8 étapes qui génère de la vidéo 720p sous contrôle textuel et de caméra, avec un port ComfyUI déjà disponible.
Hy-Nomas est le modèle de monde interactif de Tencent Hunyuan : vous décrivez un monde, puis vous continuez à le piloter avec des instructions textuelles et des mouvements de caméra pendant que le modèle continue de générer. L'équipe a publié les poids, le code d'inférence, le code d'entraînement et d'annotation des données le 21 octobre 2026 (tencent/Hy-Nomas | GitHub), ainsi qu'une démo en ligne et un benchmark dédié. Un port communautaire pour ComfyUI a suivi un jour plus tard.
La publication est encore récente côté compteurs : 21 likes sur Hugging Face et 21 étoiles sur GitHub au moment de la rédaction. Tout ce qui suit provient de la fiche du modèle, du référentiel et de la galerie officielle, et non de tests tiers.
Un monde, généré par segments
Hy-Nomas est autorégressif sur les segments vidéo plutôt que sur les images. Chaque segment est débruité à partir d'un bruit gaussien dans l'espace latent compressé du modèle, tout en assistant à un cache clé/valeur de tous les segments produits auparavant. Le prompt du tour en cours, la trajectoire de caméra et ce cache sont les seules entrées, et l'attention est causale entre les segments, donc générer un segment n'exige jamais un segment futur.
La configuration distillée exécute 8 étapes de débruitage avec un solveur ODE Euler à un guidage texte et caméra de 1,0, et produit du 720 × 1280 à 24 FPS. La longueur des segments provient du fichier de prompt : une requête JSON liste des segments avec des horodatages de début et de fin, un visual_description_long pour l'ouverture, description_change pour chaque tour suivant, et contained_actions avec leurs propres horodatages. Définir inference.video_length=event dérive les longueurs de segments à partir de ces temps d'événement.
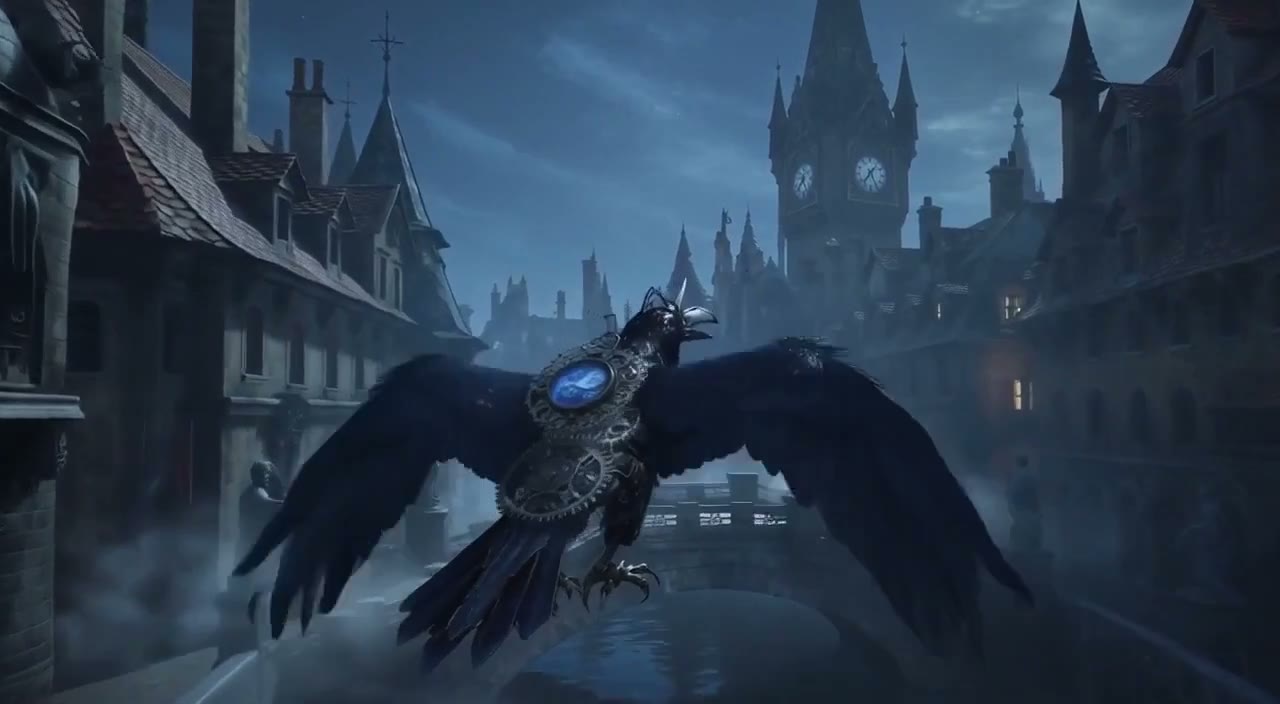
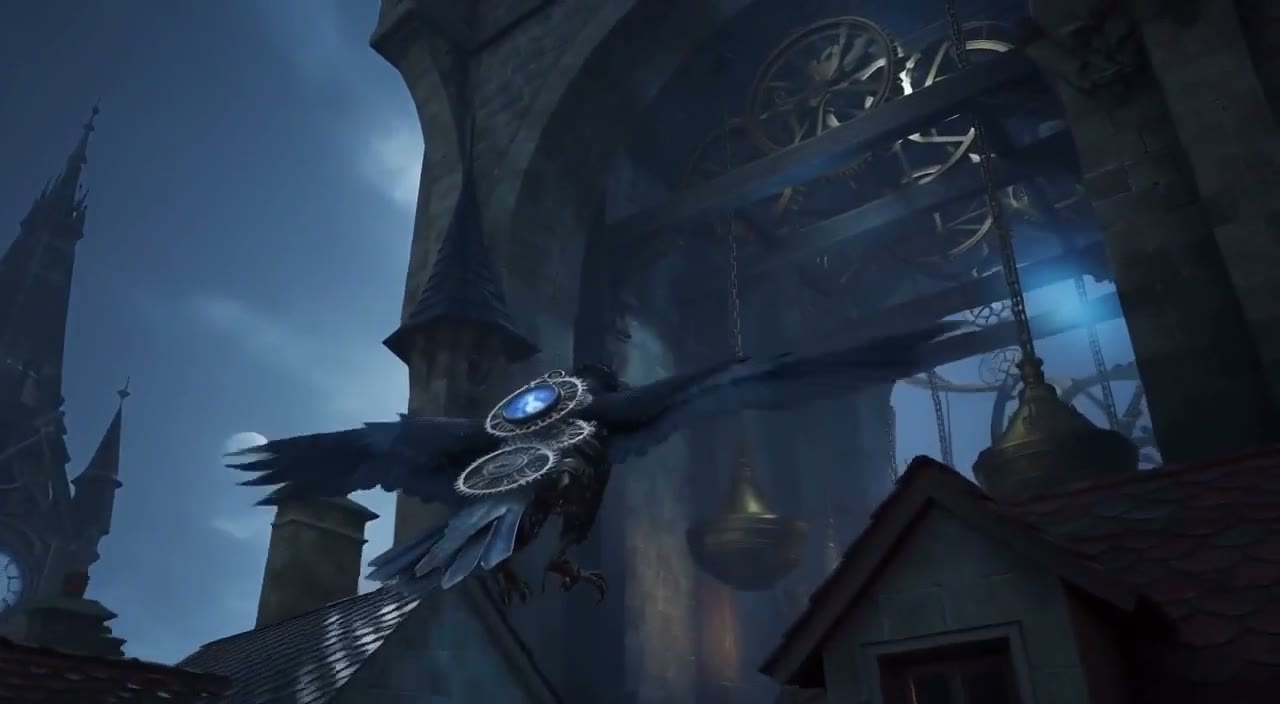
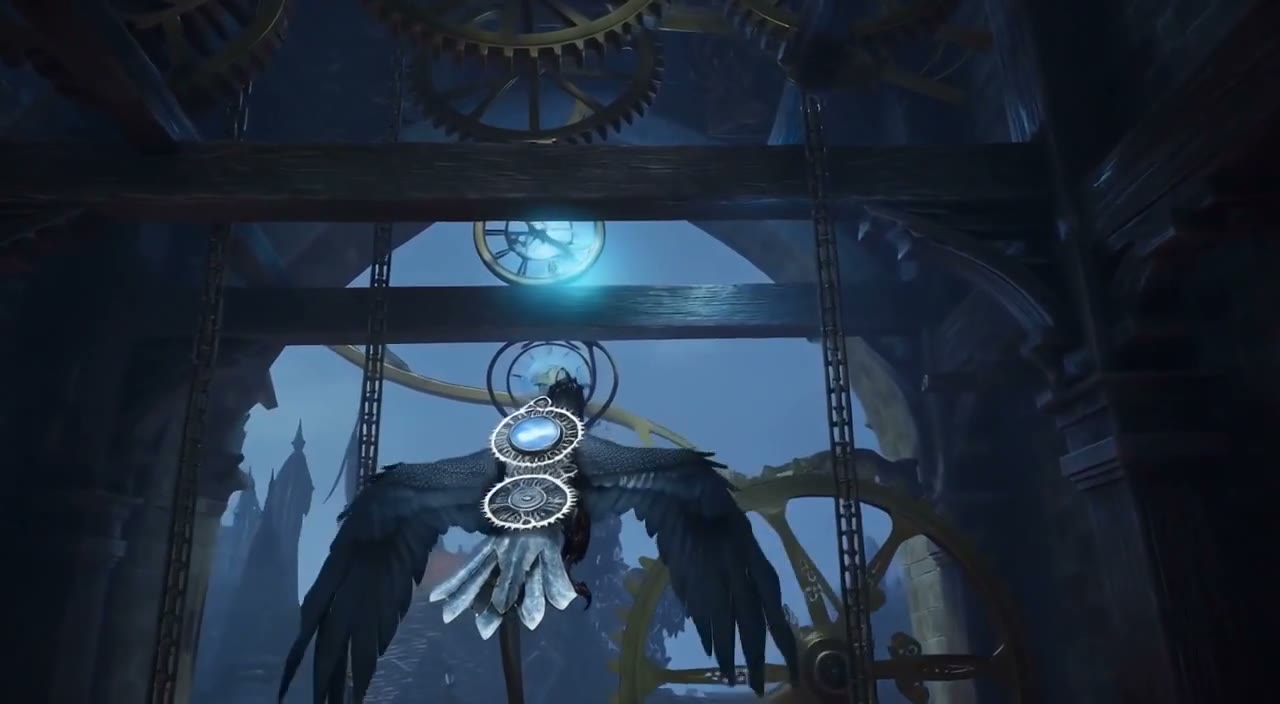
La galerie officielle montre comment cela se comporte sur une exécution plus longue. Il s'agit d'un seul clip de 60 secondes, clockwork-flight, construit à partir de cinq tours texte uniquement de 12 secondes chacun, avec une caméra de suivi à la troisième personne dans un style CG :
 |  |  |
|---|---|---|
| 1 s : « Un oiseau mécanique vole au-dessus des toits, avec de hautes flèches devant lui. » | 30 s : « Il vire devant une arche vers les engrenages et les structures à l'intérieur de la tour. » | 48 s : « L'oiseau se déplace sous les engrenages au-dessus de lui et une lumière bleue dans la tour. » |
Un extrait de six secondes du même clip, à partir du tour où l'oiseau entre dans la tour de l'horloge. Généré par Tencent Hunyuan, capturé depuis la galerie officielle.
Le contrôle de caméra comme entrée de premier ordre
Le mouvement de caméra n'est pas une suggestion dans le prompt mais un chemin de conditionnement séparé. Un fichier de trajectoire contient des matrices caméra-vers-monde c2ws de forme [N, 4, 4] et des paramètres intrinsèques de forme [N, 3, 3] ; le modèle normalise les extrinsèques, les regroupe sur quatre images vidéo et aplatit chaque groupe en une entrée de 64 dimensions, que les tokens vidéo interrogent via l'attention croisée dans chaque bloc double flux. Deux échelles exposent les contrôles : trajectory_translation_scale vaut 1,0 par défaut et trajectory_rotation_scale 2,5.
Le texte et la caméra peuvent aussi alterner au sein d'une même exécution. La galerie sépare ses échantillons par style (images réelles, CG, jeu vidéo, animation et anime) et par perspective (première personne, suivi à la troisième personne, observateur à la troisième personne), et la démo permet de maintenir WASD et les flèches ou de faire glisser la souris pour se déplacer dans un monde généré, le déplacement étant enregistré à 24 FPS et rejoué au tour suivant.
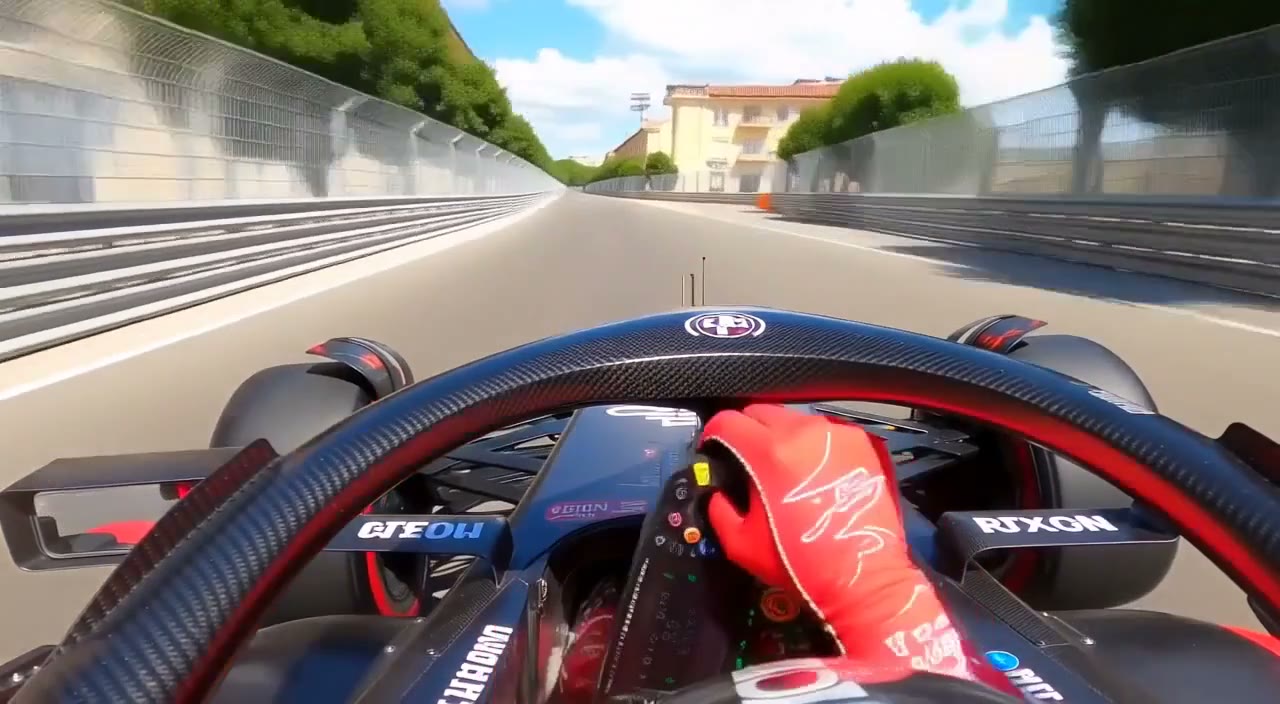
Un échantillon à la première personne de la galerie, circuit-drive : un circuit urbain vu de l'intérieur d'un cockpit de course. Généré par Tencent Hunyuan.
À l'intérieur du modèle
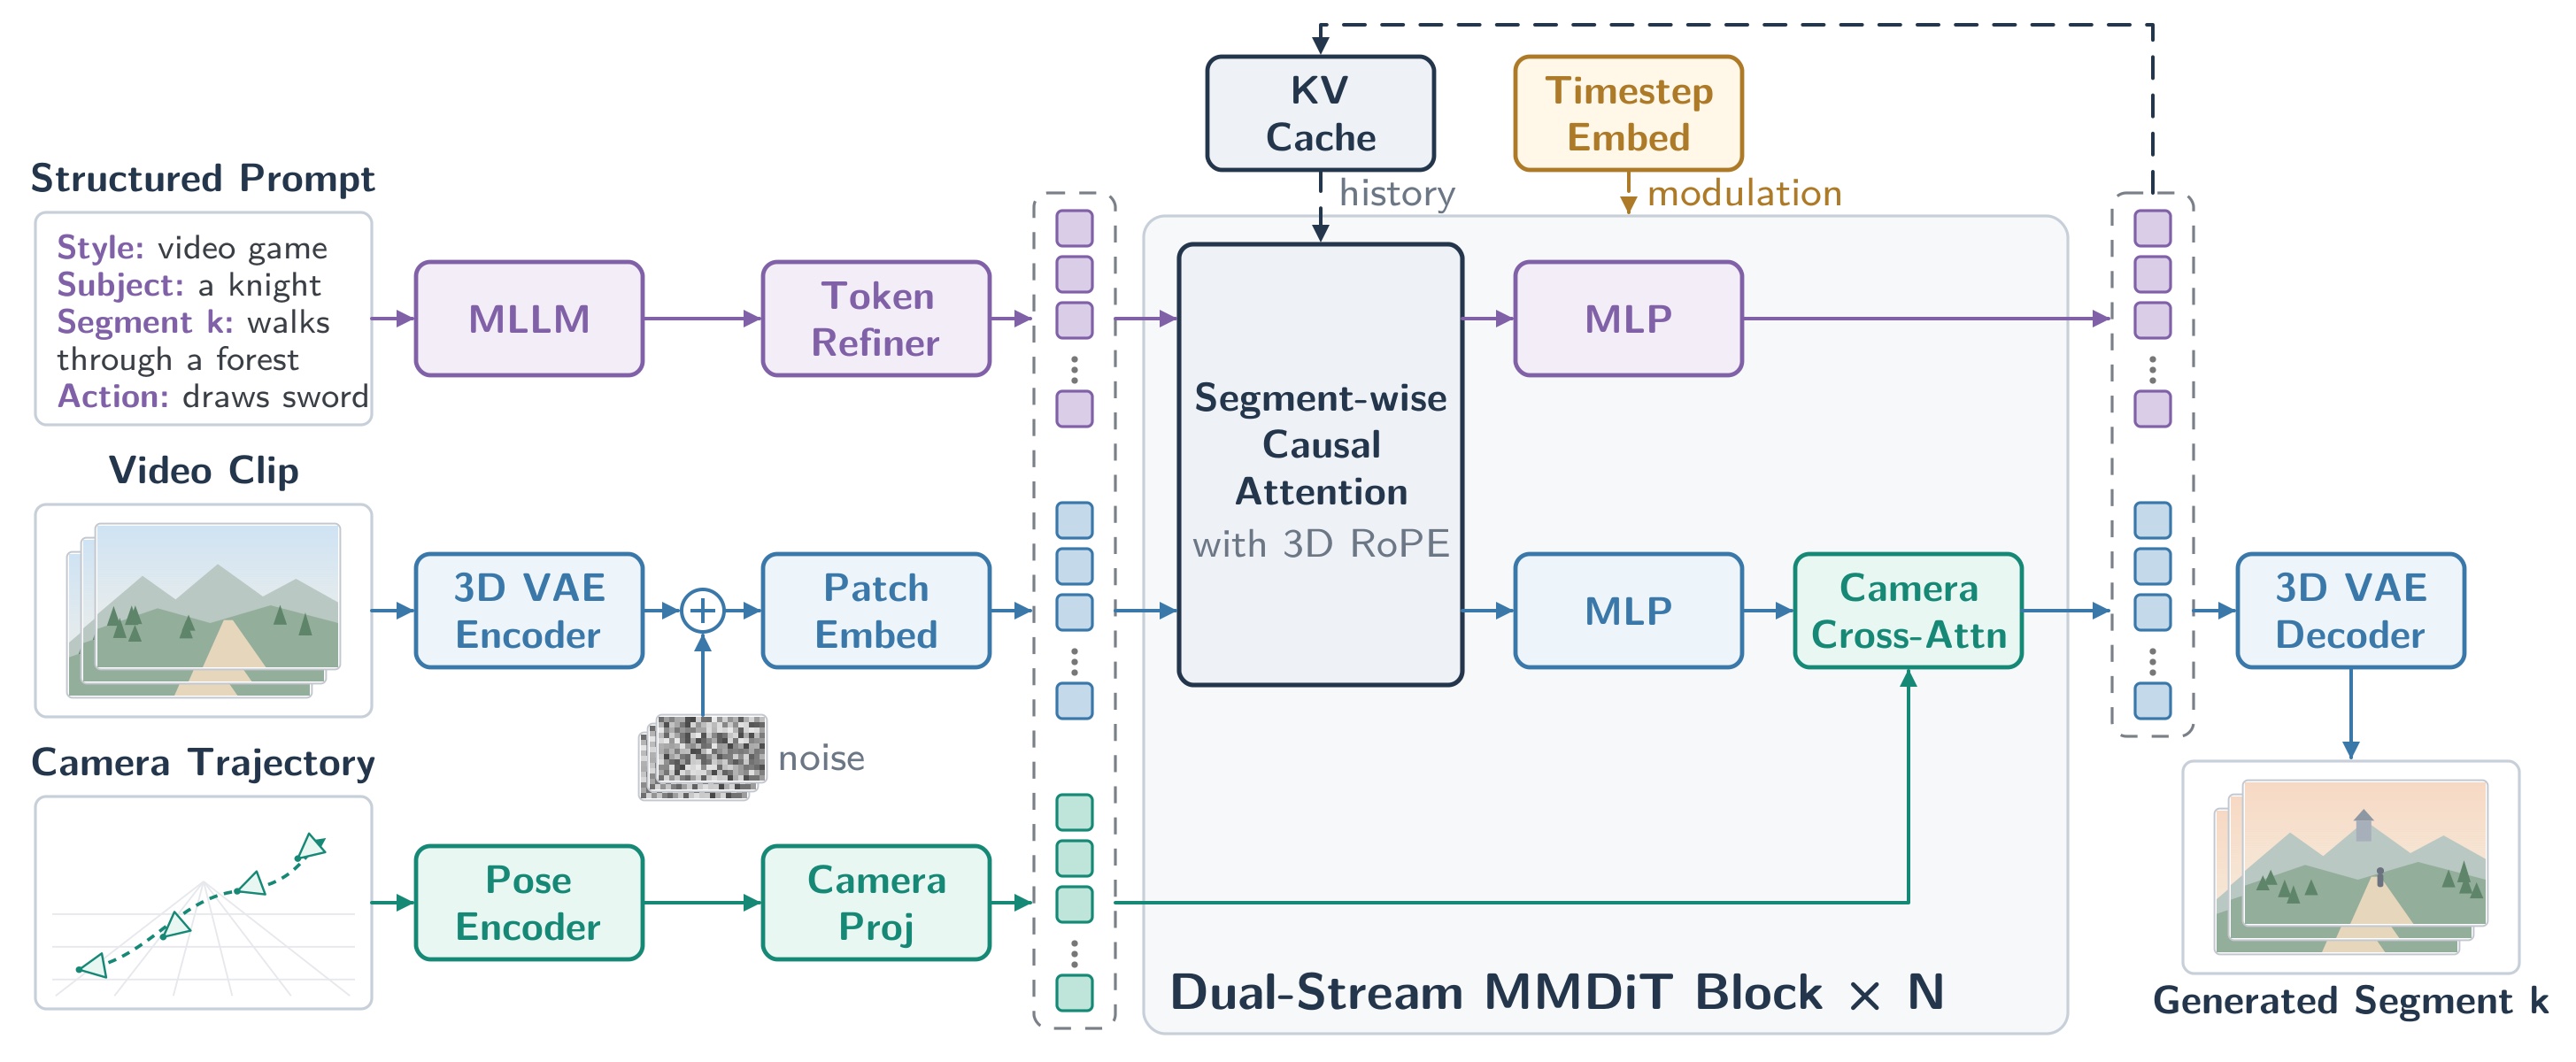
Le diagramme d'architecture du référentiel de publication : texte, latents vidéo et trajectoires de caméra alimentant des blocs MMDiT double flux.
| Propriété | Configuration |
|---|---|
| Backbone | 54 blocs MMDiT double flux, aucun bloc simple flux |
| Taille cachée | 2 048, avec 16 têtes de 128 dimensions |
| Feed-forward | expansion 4×, taille intermédiaire 8 192 |
| Latents | 32 canaux en entrée et en sortie, patch 1 × 1 × 1 |
| Encodage de position | RoPE 3D, dimensions [16, 56, 56], thêta 256 |
| Conditionnement texte | états cachés de Qwen2.5-VL-7B-Instruct en 3 584 dimensions, raffineur de tokens à deux couches |
| Conditionnement caméra | embeddings extrinsèques via attention croisée dans les blocs double flux |
| Prédiction | vélocité de flux, échantillonnage ODE Euler |
La vidéo vit dans des latents DCAE-V f32t4c32 : 32 canaux, une compression spatiale 32× dans chaque direction et une compression temporelle 4×. Le décodage est assuré par un décodeur PixelUMM affiné de 36 couches, une taille cachée de 4 096 dimensions, 32 têtes de requête et 8 têtes KV, qui reconstruit le RGB en tubelets 4 × 16 × 16 sur des fenêtres temporelles de 10 images latentes avec 5 images de chevauchement. Ce décodage est une étape unique et est distinct des 8 étapes de débruitage du DiT.
La configuration mono-4090
La configuration de référence répartit un groupe d'inférence sur huit GPU avec un parallélisme de séquence 8 voies et un décodage distribué. Une seconde configuration cible un seul RTX 4090, et les changements portent tous sur la gestion de la mémoire :
- Les poids du DiT et les clés et valeurs mises en cache sont stockés en INT8 tandis que les couches linéaires et l'attention calculent toujours en BF16.
- Le décodeur PixelUMM fonctionne en FP8 via des kernels CUTLASS, et le DiT utilise FlexAttention.
- L'encodeur de texte, le DiT et le décodeur sont déplacés sur le GPU pour leur propre étape puis déchargés vers le CPU ensuite.
- L'historique GPU est limité à 18 images latentes historiques échantillonnées par
temporal_context, l'historique plus ancien étant archivé dans la RAM système.
La fiche est explicite sur les compromis : la RAM système doit contenir les modèles déchargés et une archive d'historique croissante, les transferts CPU vers GPU ajoutent de la latence, et le budget d'historique ne plafonne pas la mémoire du segment en cours. Aucun chronométrage par segment n'est publié, donc la vitesse sur un 4090 n'est pas vérifiée au moment de la rédaction.
Affinage LoRA et service de prompt
Deux adaptateurs accompagnent la publication. Un LoRA Cinematic est proposé comme adaptateur optionnel de qualité visuelle pour un DiT en virgule flottante compatible, et un LoRA Robotics est entraîné sur le jeu de données RealSource-World de bras robotiques et est destiné à être fusionné dans le DiT distillé pour renforcer la manipulation simulée dans le monde généré. Le chargeur INT8 ne peut pas charger un LoRA séparé au moment de l'inférence, donc le travail sur les adaptateurs passe par les poids BF16 ou FP32.
Le référentiel contient aussi le parcours d'affinage : préparation des données SFT, packing hors ligne des séquences pour les longues séquences, puis entraînement et fusion. Pour la démo web, il existe une dépendance obligatoire, Nomas-PE, un service séparé qui transforme une instruction utilisateur en prompt de génération structuré ; l'inférence hors ligne peut lire des fichiers de prompt préparés et s'en passer. Une image Docker prête à l'emploi (hynomasoss/hynomasoss:cu130) embarque PyTorch, FlashAttention et MagiAttention, ce qui évite de compiler les kernels CUDA à la main.
Hy-Nomas-Bench
En plus du modèle, l'équipe a publié Hy-Nomas-Bench, quatre benchmarks avec 280 cas de test couvrant l'interaction textuelle libre multi-tours, la navigation caméra, le contrôle alterné texte et caméra, et la mémoire spatiale. Le jeu de données fournit des prompts structurés, des séquences d'interaction, des chronologies clavier et des trajectoires de caméra de référence, ce qui le rend utilisable pour évaluer la cohérence sur une longue génération plutôt que sur des clips isolés.
Disponibilité
Il n'y a pas de prise en charge native dans ComfyUI pour cette publication : pas de nœuds core, et pas de repack Comfy-Org. Les voies officielles sont le référentiel GitHub avec l'image Docker, et la démo interactive hébergée.
Pour ComfyUI, le port communautaire Nynxz/ComfyUI-HyNomas est apparu le 23 octobre avec des poids convertis dans nynxz/Hy-Nomas :
| Fichier | Dossier | Taille |
|---|---|---|
nomas_dit_distilled_int8_convrot.safetensors | models/diffusion_models | 9,0 Go, INT8 ConvRot |
nomas_dit_distilled_bf16.safetensors | models/diffusion_models | 17,1 Go, base pour les fusions LoRA |
nomas_pixelumm_vae_bf16.safetensors | models/vae | 15,8 Go, décodeur PixelUMM plus encodeur DCAE-V |
Le port charge le DiT via le nœud standard Charger Modèle Diffusion, l'encodeur de texte via Charger CLIP en utilisant le fichier qwen_2.5_vl_7b.safetensors de ComfyUI avec le type qwen_image provenant de Comfy-Org/Qwen-Image_ComfyUI, et le décodeur via Charger VAE, donc aucun kernel personnalisé n'est nécessaire. Son auteur rapporte environ 21 secondes pour un tour de 3 secondes sur une RTX 5090 avec le checkpoint INT8 en 1280 × 704, plus environ 4 secondes de décodage par fenêtre. Considérez ces chiffres comme la mesure d'un utilisateur sur un port vieux d'un jour, et gardez les cibles 4090 de la configuration officielle séparées de celles-ci.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.