MiniMax H3 Character Swap v1.1 : un LoRA de 80 Mo plus fidèle
Alissonerdx publie MiniMax H3 Character Swap v1.1, une extraction SVD à rang dynamique de 80 Mo plus fidèle, avec deux workflows ComfyUI, dont un en nœuds natifs.
Le référentiel est celui qui héberge déjà les LoRA de character swap et de fond d'écran animé H3, lequel couvrait la v1.0 plus tôt en octobre ; il compte environ 458 likes et 144 700 téléchargements au moment de la rédaction. Chaque adaptateur du pack est entraîné sur les poids ref2va de H3 et repose sur la même idée de conditionnement : le clip source est injecté via MiniMaxH3AddGuide sous forme de treillis guide aligné, plutôt que de référence vidéo libre.
La v1.1 ne change pas la tâche. Il s'agit du même body swap piloté par guide avec le déclencheur body_swap:, et toute la version répond à une seule critique formulée contre la v1.0 : le personnage remplacé ne ressemblait pas assez à l'image de référence.
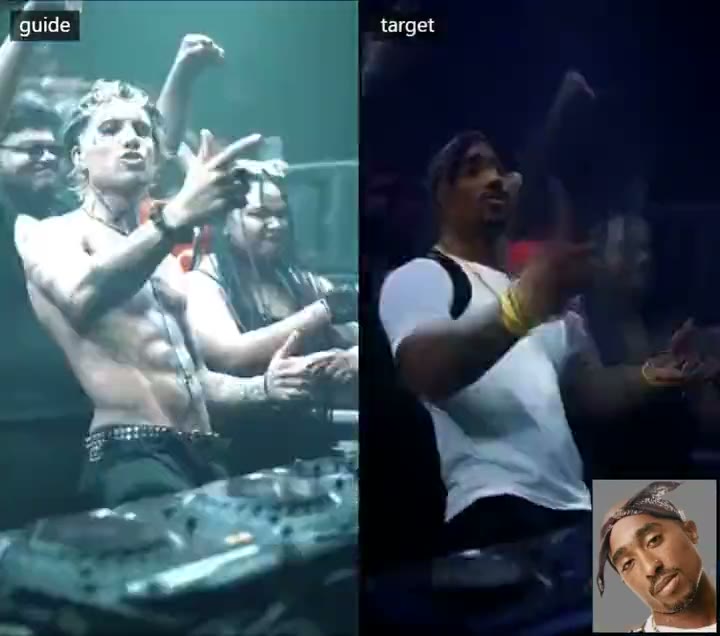
Une image extraite du clip de comparaison guide/cible des tests v1.1 de l'auteur.
Ce que change la v1.1
L'auteur n'a pas réentraîné de nouvel adaptateur pour cette version. La v1.1 est une extraction SVD de 80 Mo issue de l'entraînement v1.1, avec un rang dynamique choisi par calque grâce à une analyse d'énergie par norme de Frobenius : chacun des 208 calques conserve le plus petit rang qui retient 95 % de sa propre énergie, ce qui donne des valeurs entre le rang 4 et le rang 34, avec une médiane de 7. Le fichier est ainsi environ huit fois plus petit que le checkpoint rang 64 de la v1.0 tout en obtenant de meilleurs scores de ressemblance : la référence s'applique donc plus fidèlement au visage, aux cheveux, au corps et aux vêtements, tandis que le guide fournit toujours la scène, la caméra et le jeu d'acteur.
| Checkpoint | Taille | Ce que c'est |
|---|---|---|
minimax_h3_character_swap_v1.1_ref2va_fro | 80 Mo | Rang dynamique par calque (de 4 à 34, médiane 7), la version recommandée |
minimax_h3_character_swap_v1.0_ref2va_r64_gl | 620 Mo | Rang 64, la version précédente, conservée pour une comparaison côte à côte |
Le guide demande une force de 1.0, ce qui correspond aussi à la règle de publication énoncée par l'auteur : un LoRA qui ne fonctionne pas à 1.0 n'est pas publié.
L'auteur a publié trois des comparaisons de rangs alors que la version était encore en cours. La première utilise les rangs extraits par analyse d'énergie, la deuxième mélange les deux étapes d'entraînement qui alimentent la v1.1, et la troisième est la comparaison complète entre guide et cible.
Extraction des rangs par énergie de Frobenius, le schéma retenu dans la v1.1.
Un test à rangs mixtes qui combine les deux étapes d'entraînement derrière la v1.1.
Un clip de comparaison côte à côte entre le guide et la sortie remplacée.
Deux flux de travail v1.1
La v1.1 fournit une nouvelle paire de graphiques, et le choix entre les deux dépend surtout de la longueur du clip.
| Flux de travail | Ce qu'il utilise |
|---|---|
| Shot Planner | ComfyUI-BFSNodes 1.113.0 ou plus récent. Les vidéos longues sont découpées en plans, chaque plan est rendu puis assemblé, les références et {details} sont décrits dans le planner, et le graphique construit une comparaison côte à côte. |
| Nœuds natifs uniquement | Generate Text examine l'image de référence et rédige le prompt complet, puis MiniMax H3 Reference to Video et Add Guide rendent un clip. Aucun pack de nœuds communautaire n'est nécessaire. |
Les deux fonctionnent en 8 étapes avec un LoRA turbo DMD, et tous deux disposent d'une seconde passe optionnelle qui ajoute le LoRA de netteté LMS et l'upscaler latent en 1280×704. Chaque flux de travail contient une note avec le lien de téléchargement de chaque modèle qu'il charge, et les chargeurs de modèles conservent les noms de dossier avec lesquels ils ont été enregistrés : chaque chargeur doit donc être resélectionné si vos fichiers se trouvent dans un autre dossier.
Modèle de prompt
La description du personnage est l'élément qui décide de la part de la référence qui survit. Le guide fournit désormais un modèle fixe : utilisez-le sur une seule ligne et remplacez uniquement {details} par une description du personnage de référence séparée par des virgules, en commençant par le genre.
body_swap: subject_definitions: <Subject 1> is the {details} shown in <Picture 1>, whose identity, face, head, hair or fur, skin, body shape, proportions and clothing define the character in the target video. The guide video provides the scene and the performance: its background, environment, lighting, camera, framing, body pose, hand and arm movement, head rotation, gaze direction, lip movement and facial expression, frame by frame; only the main subject of the guide video is replaced: its face, hair, body and clothing become <Subject 1>. summary: [video generation + reference] Replace the guide subject with <Subject 1>, keeping the scene, camera and the complete motion and performance of the guide video. detailed_description: [Shot 1] <Subject 1> takes the exact place of the guide subject and moves with the same timing, body pose, gestures, head motion, gaze, speech and facial expressions, while keeping the complete identity from <Picture 1>: facial structure, hair or fur, skin, body shape and clothing stay stable in every frame. The background, lighting, colors and camera of the guide video are preserved. Prevent identity drift, clothing changes, texture crawling and flicker.{details} doit être rédigé de la tête aux pieds : genre, taille et carrure, forme du visage et teint, cheveux, vêtements du haut et du bas avec leurs couleurs et matières, chaussures, accessoires, et traits distinctifs comme les tatouages, cicatrices ou rides. Le guide interdit de décrire l'arrière-plan, la caméra ou l'éclairage dans cet emplacement.
Il existe deux façons de le remplir automatiquement. Dans le Shot Planner, {details} reste dans le prompt et l'action Describe refs du panneau rédige la description de chaque référence, ou bien le modèle de langue le fait lors de l'exécution du flux de travail. Dans le flux de travail natif, Generate Text reçoit l'image de référence et une instruction qui renvoie le prompt complet ; le guide recommande de régler max_length autour de 768 pour que la fin du prompt ne soit pas tronquée.
Disponibilité
Placez le LoRA dans ComfyUI/models/loras/, chargez l'un des flux de travail v1.1 et consultez la note intégrée au graphique pour connaître les modèles attendus. La configuration publiée charge un modèle de diffusion H3 ref2va (la version élaguée int8_convrot dans l'exemple de l'auteur), l'encodeur de texte H3, les VAE vidéo et audio ainsi qu'un LoRA turbo DMD en 8 étapes. Le modèle vision-langage optionnel qwen3.5_9b_w4a8_gptq ne sert qu'à décrire la référence.
L'ordre des entrées est important. Envoyez le clip original à MiniMaxH3AddGuide avec frame_idx = 0, car le LoRA a été entraîné sur les latents du guide, et envoyez l'image du personnage via le chemin de référence d'image natif de H3 en tant que <Picture 1>. Conservez le même ratio d'image et le même nombre d'images que le guide, en utilisant un nombre d'images H3 de 17n + 5 (5, 22, 39, 56, 73, 90, 107, 124, etc.), et testez sur une courte plage avant de lancer un long clip.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.