LoRAs few-step MOSS-Image : rapid-moss en 4 étapes et DMD en 8 étapes
Deux LoRAs de la communauté font passer MOSS-Image-SFT de 50 étapes à 4 ou 8 évaluations du réseau, avec un node ComfyUI pour l'adaptateur rapid-moss.
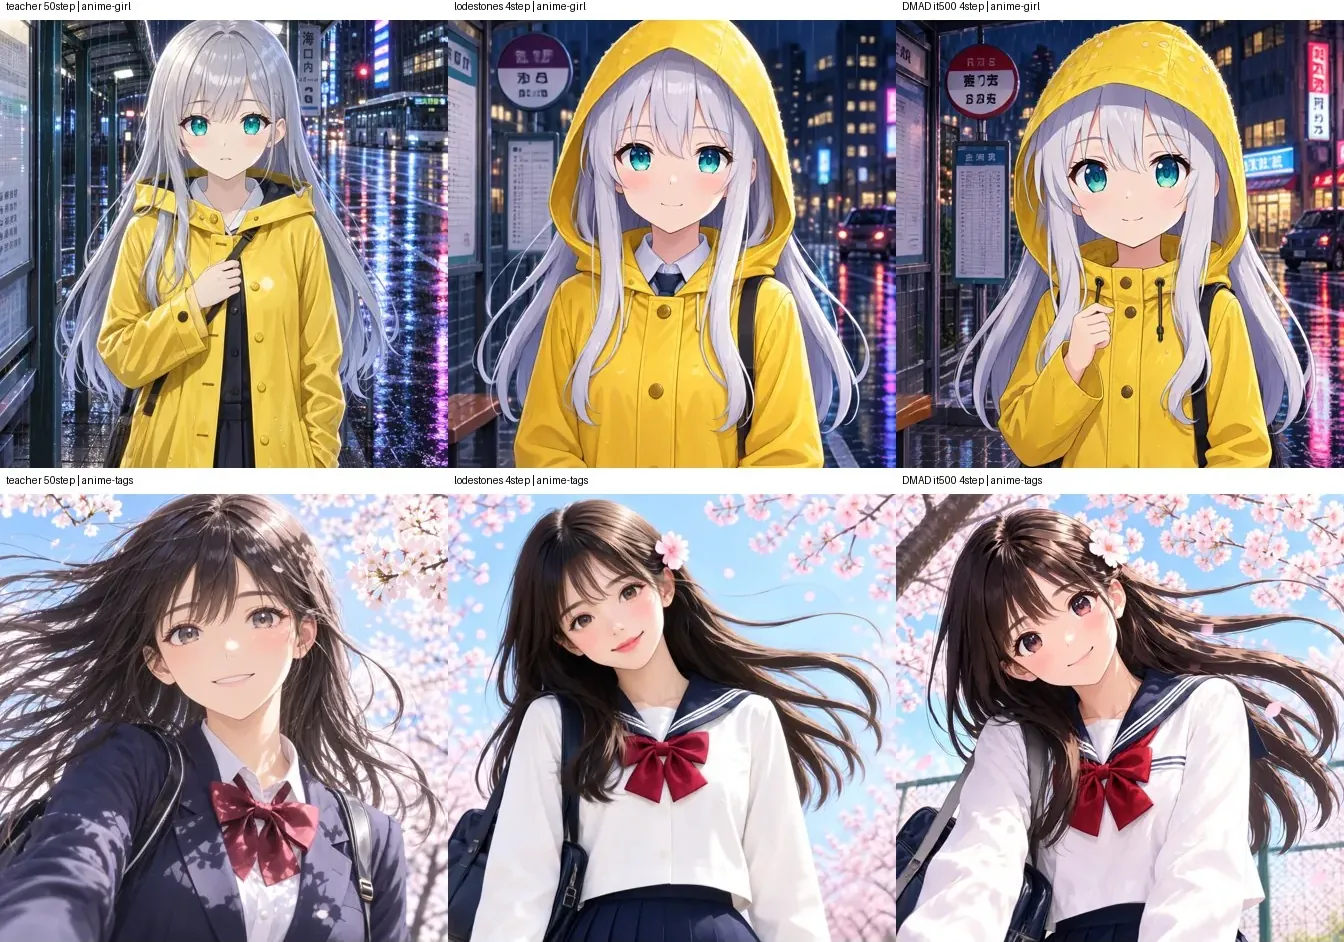
De gauche à droite : l'enseignant à 50 étapes, le checkpoint 8 étapes exécuté sur 4 étapes, et l'adaptateur rapid-moss en 4 étapes. Même graine, prompts d'évaluation jamais utilisés pendant l'entraînement. Source : darask0
Pourquoi la boucle d'échantillonnage se réduit
MOSS-Image-SFT produit une image en 50 étapes avec CFG 3, et le CFG double la passe avant : une seule image coûte donc environ 100 évaluations du DiT. Le checkpoint 8 étapes remplace cette boucle par DMD en espace de données (arXiv 2610.12102) : le générateur itère quatre à huit fois sur sa propre estimation propre à partir d'un tenseur de bruit fixe, sans CFG ni planification de timesteps.
L'adaptateur 4 étapes poursuit à partir de ce checkpoint et le limite à quatre itérations, entraîné avec DMAD (arXiv 2610.02188). Un critique LoRA s'appuyant sur l'enseignant gelé sépare les échantillons de l'enseignant de ceux de l'étudiant, et l'étudiant minimise le logit négatif du critique. L'auteur a entraîné sur 3 199 prompts avec un échantillon d'enseignant chacun, et a publié le checkpoint de 500 itérations avant que les itérations suivantes ne commencent à dégrader le respect des prompts.
Temps DiT par image 1024² sur un seul H100 :
| Checkpoint | Temps DiT | Évaluations DiT |
|---|---|---|
| MOSS-Image-SFT (50 étapes, CFG 3) | 16,2 s | 100 |
| lodestones 8 étapes DMD | 1,54 s | 8 |
| rapid-moss 4 étapes DMAD | 0,81 s | 4 |
Ces temps ne couvrent que le transformer, pas l'encodeur de texte Qwen3.5-9B ni le VAE. Dans ComfyUI sur une RTX PRO 6000, l'auteur a mesuré 4,5 à 6,9 secondes pour une image 1024², encodage et décodage du texte inclus.
Le node ComfyUI
Les deux adaptateurs sont des deltas LoRA fp32 dont l'amplitude est inférieure au pas d'arrondi du bf16 : les fusionner dans des poids bf16 efface donc l'essentiel de la distillation. Cela exclut LoraLoaderModelOnly, fuse_lora de diffusers et tout flux de travail qui charge des poids déjà fusionnés. Le node MOSS-Image Few-Step Adapter (rapid-moss) fourni ajoute au contraire la LoRA en fp32 à l'exécution, remplace le chemin temporel fp32 et renvoie un trio MODEL, SAMPLER et SIGMAS apparié.
Les sorties doivent être reliées ensemble : MODEL vers BasicGuider sans CFG, puis SAMPLER et SIGMAS vers SamplerCustomAdvanced, puis VAE Decode. Euler, sgm_uniform, ModelSamplingSD3 avec shift 5 et le saut de la couche 22 sont tous des paramètres de l'enseignant à 50 étapes et ne doivent pas être ajoutés ici. Les étapes vont de 1 à 4 pour rapid-moss et de 1 à 8 pour le checkpoint 8 étapes, et une force de 1.0 est la valeur par défaut recommandée.
Deux flux de travail sont inclus. Le natif utilise les chargeurs standard de ComfyUI : moss_image_sft_bf16.safetensors de Comfy-Org/MOSS-Image, CLIPLoader avec le type moss_image, et le VAE FLUX.2.
Le second flux de travail conserve le node HF Loader moss-image d'OpenMOSS et le pointe vers un répertoire Diffusers local :
comfyui/rapid-moss/ du référentiel du modèle vers ComfyUI/custom_nodes/rapid-moss/ et redémarrez.
2. Placez lora.safetensors, time_embedding.safetensors et dataspace.safetensors dans ComfyUI/models/rapid_moss/rapid-moss-4step/. Chaque sous-dossier de models/rapid_moss/ devient une entrée du menu adapter du node, donc les fichiers 8 étapes vont dans un second dossier.
3. Chargez un flux de travail, choisissez l'adaptateur et définissez le modèle de diffusion de base sur les poids SFT en bf16 ou fp32.
Résultats côte à côte
Sur 17 prompts d'évaluation, l'auteur signale plus de détails d'arrière-plan et une composition plus vivante que le checkpoint 8 étapes exécuté sur quatre étapes, ainsi qu'une correction d'un « 夏 » doublé sur une affiche verticale, le texte japonais sur les post-it, les panneaux et les bulles de dialogue restant exact.
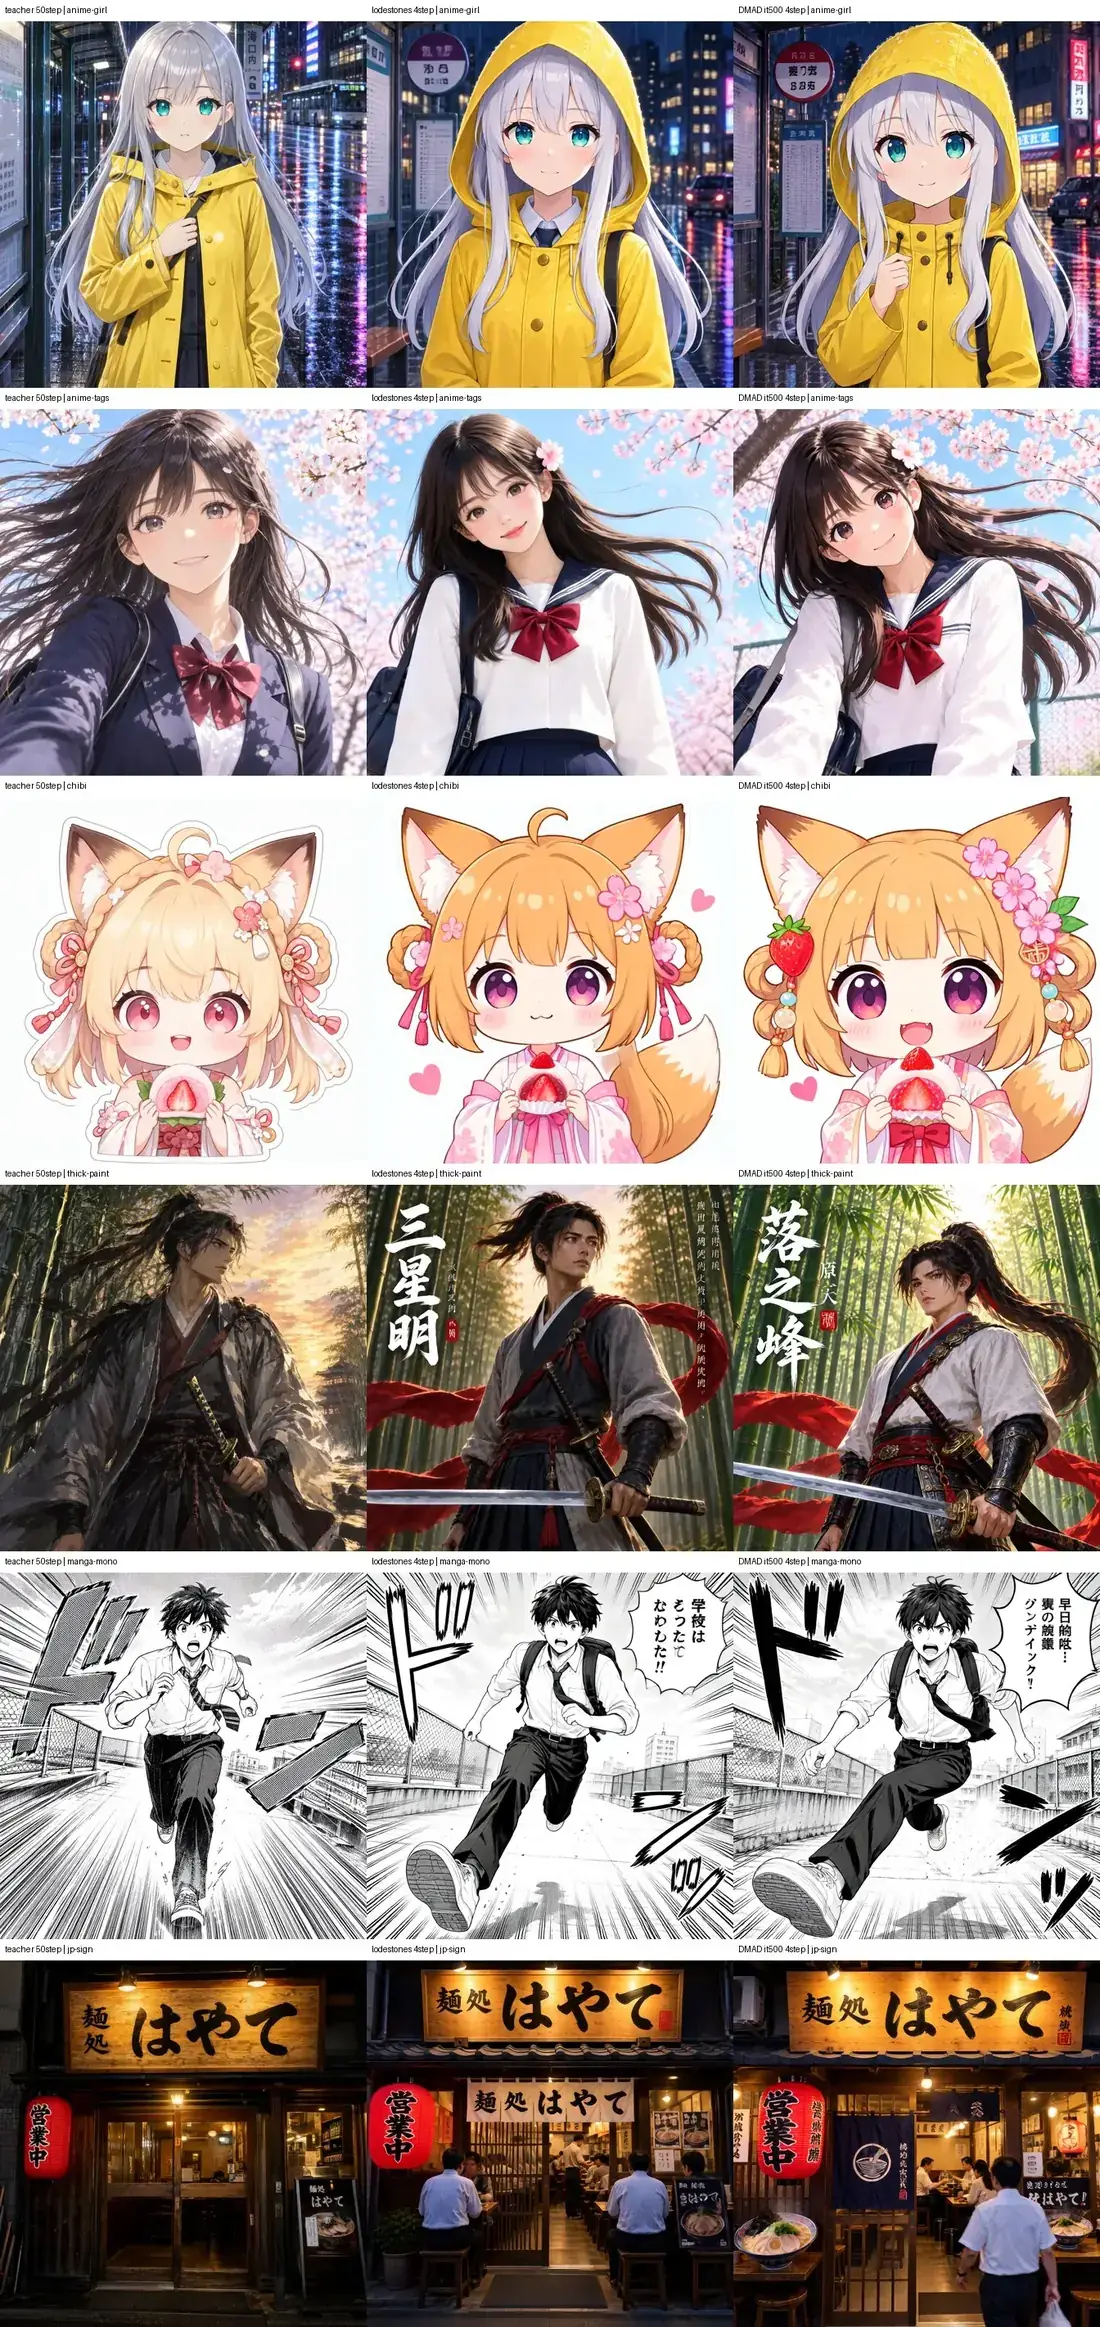
Enseignant, checkpoint 8 étapes sur 4 étapes, et l'adaptateur 4 étapes. Source : darask0
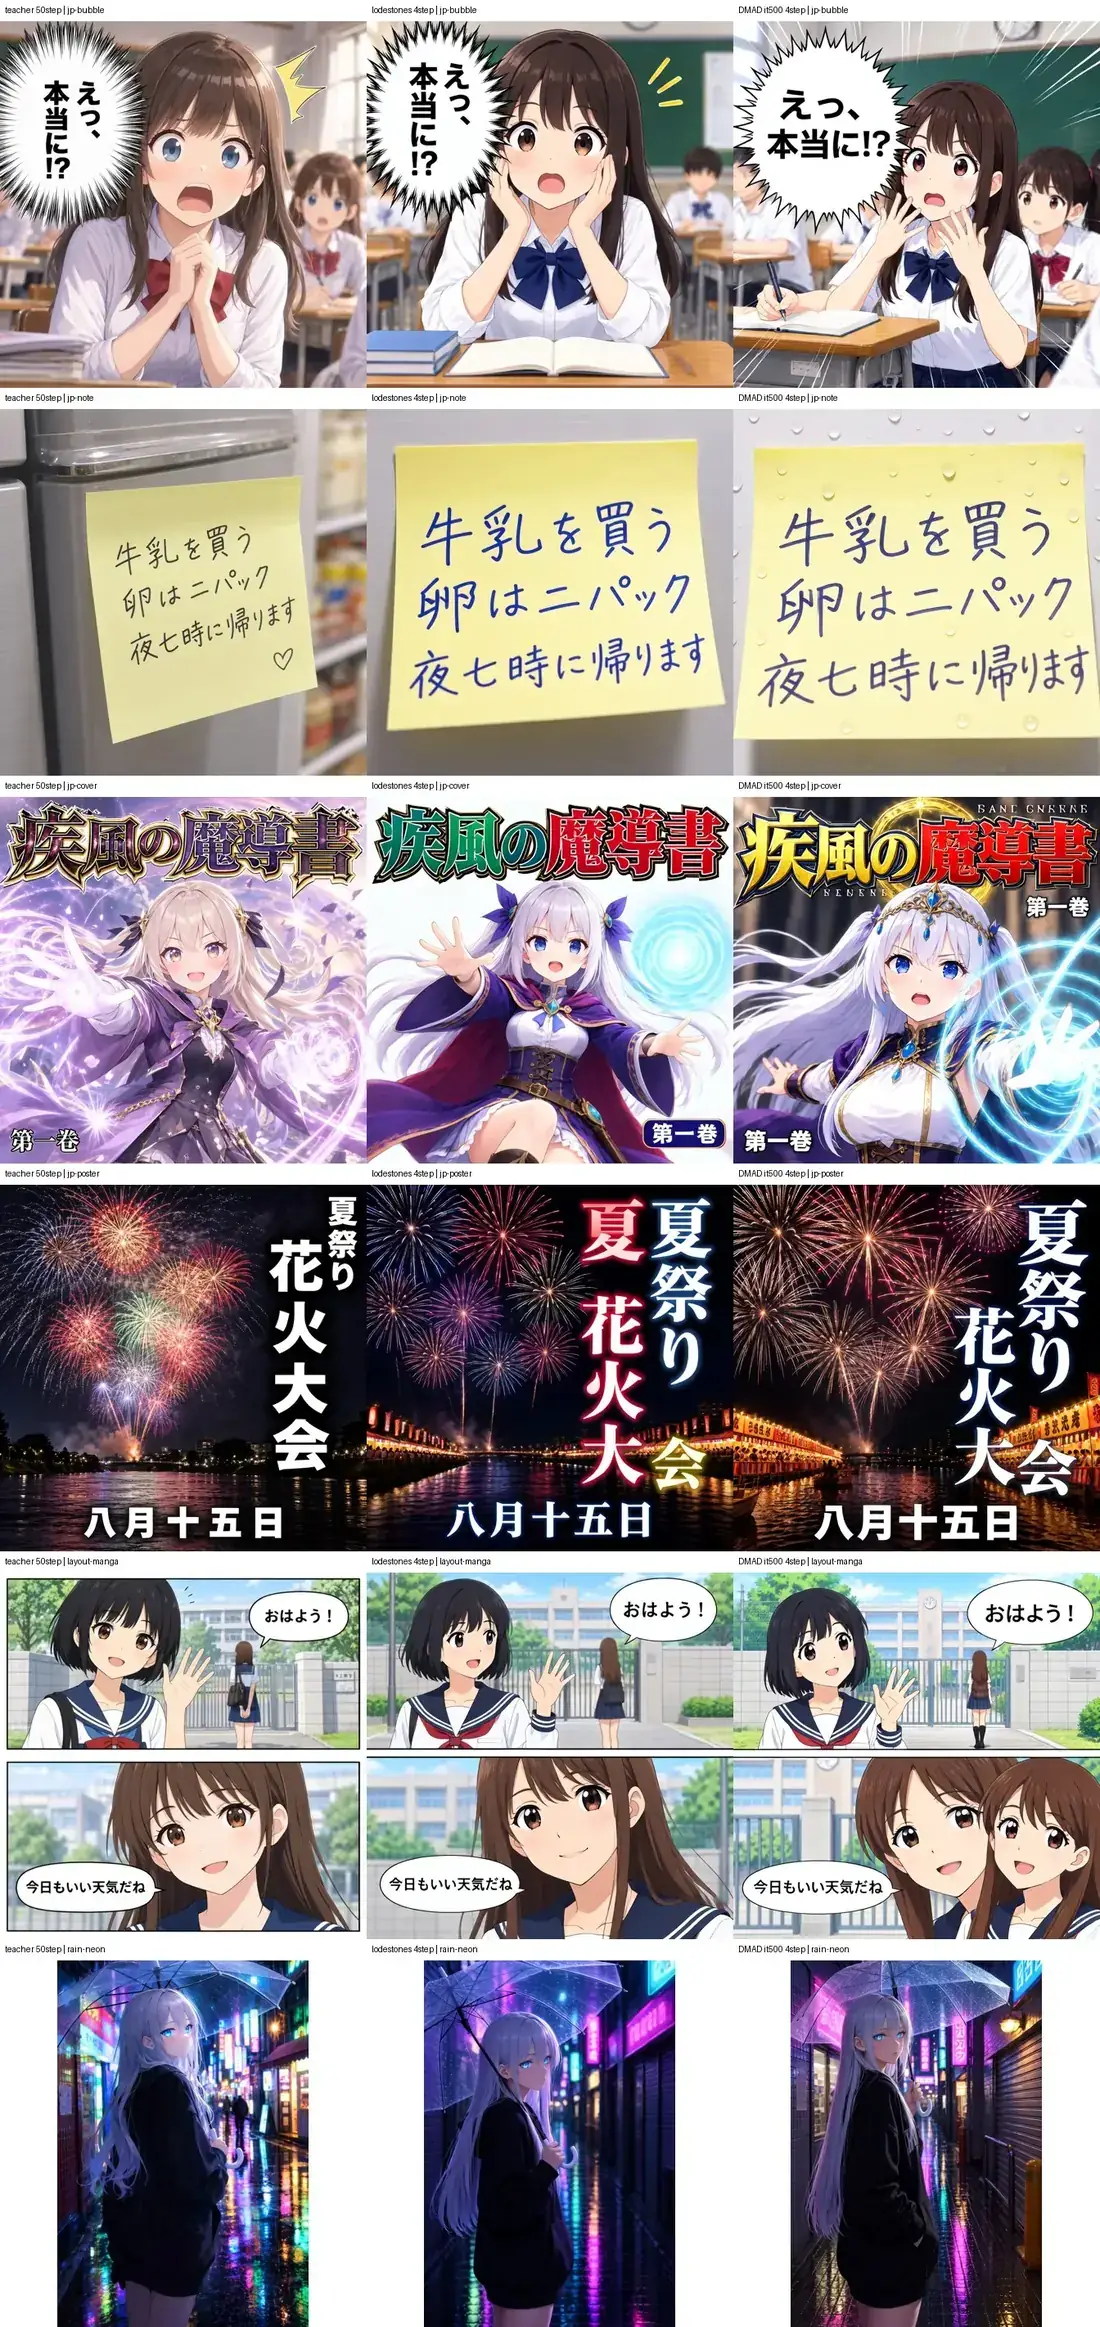
La même comparaison à trois sur un second prompt. Source : darask0
L'auteur liste aussi les régressions au lieu de les lisser : des lettres latines parasites apparaissent sur les couvertures de light novel, une requête de mise en page JSON pour un manga en deux cases a ajouté une seconde personne non demandée dans la case du bas, et le petit texte sur les rideaux de boutique et dans les bulles de manga échoue encore. La qualité reste inférieure à celle de l'enseignant à 50 étapes.
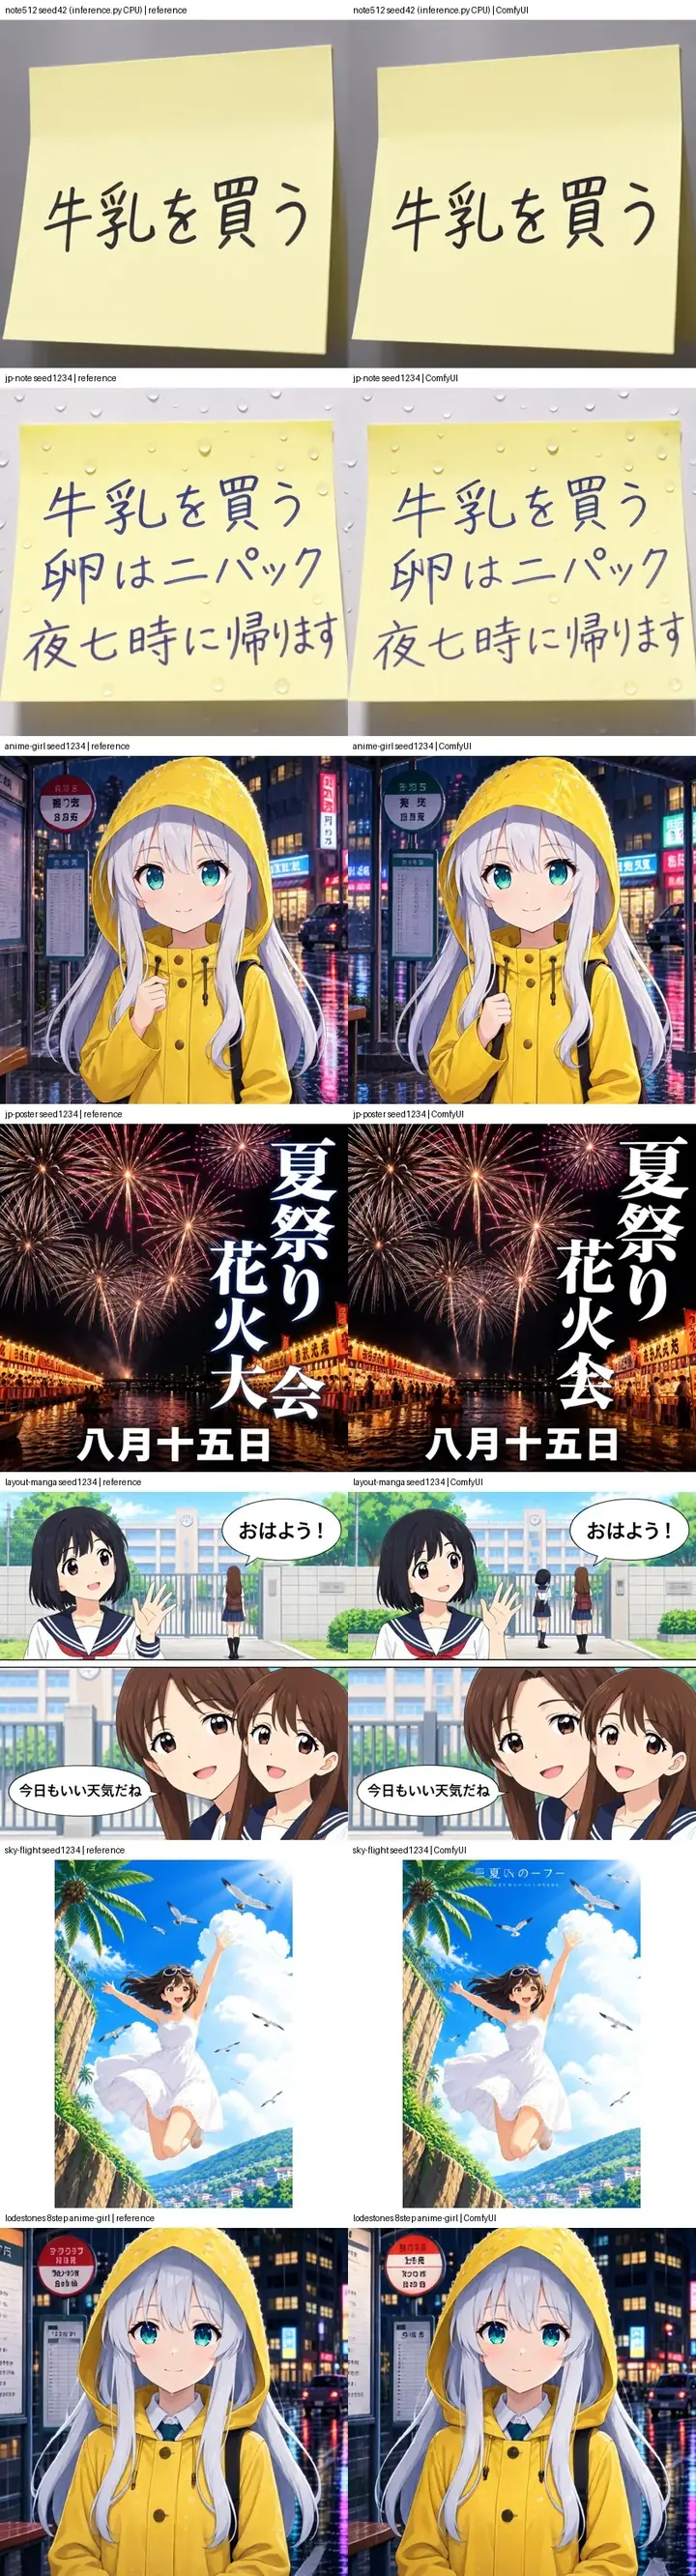
Le node rapid-moss dans ComfyUI, avec l'adaptateur fp32 relié à BasicGuider et SamplerCustomAdvanced. Source : darask0
Le checkpoint 8 étapes seul
lodestones a publié le checkpoint 8 étapes antérieur le 16 octobre en tant que travail en cours. Il ne contient que des fichiers : lora.safetensors à une force de 1.0, ou lora_latest.safetensors à 0.7, plus les mêmes time_embedding.safetensors et dataspace.safetensors. Sa propre fiche renvoie au chargeur LoRA standard de ComfyUI pour les poids 8 étapes, tandis que le node rapid-moss peut piloter les deux adaptateurs avec le chemin fp32 dont le delta 4 étapes a besoin.
Pour ceux qui exécutent les adaptateurs en dehors de ComfyUI, inference.py dans le référentiel 4 étapes reproduit directement l'échantillonneur : gardez le tenseur de bruit initial fixe, mélangez-le à l'estimation en cours via la matrice 128x128 de dataspace.safetensors, et lisez les codes d'étape dans le même fichier.
Disponibilité
- Adaptateur 4 étapes : darask0/MOSS-Image_4-step_adapter_lora avec le code d'entraînement, les logs, les prompts d'évaluation et le node ComfyUI.
- Checkpoint 8 étapes : lodestones/MOSS-Image-SFT-8-steps-dmd avec une démo publique Space.
- Modèle de base : OpenMOSS-Team/MOSS-Image-SFT et le repack ComfyUI dans Comfy-Org/MOSS-Image.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.