MOSS-Image : DiT 5B avec contrôle de mise en page et ComfyUI
OpenMOSS a publié MOSS-Image, un DiT texte-image de 5B avec contrôle de mise en page JSON et un bon rendu de texte, plus les checkpoints Base et SFT.
MOSS-Image est une nouvelle famille texte vers image de 5B issue d'OpenMOSS (GitHub | guide d'utilisation), publiée le 16 octobre avec deux checkpoints : MOSS-Image-Base, le checkpoint de pré-entraînement conservé pour le fine-tuning, et MOSS-Image-SFT, le modèle que la plupart des utilisateurs devraient exécuter. Il s'agit d'un transformer de diffusion à flux unique dans l'espace latent de FLUX.2, associé à un encodeur de texte Qwen3.5-9B standard, de sorte que le DiT est le seul nouveau composant que ComfyUI doit charger. La prise en charge dans le cœur a été fusionnée le jour même dans Comfy-Org/ComfyUI PR #17095 (par Kijai).
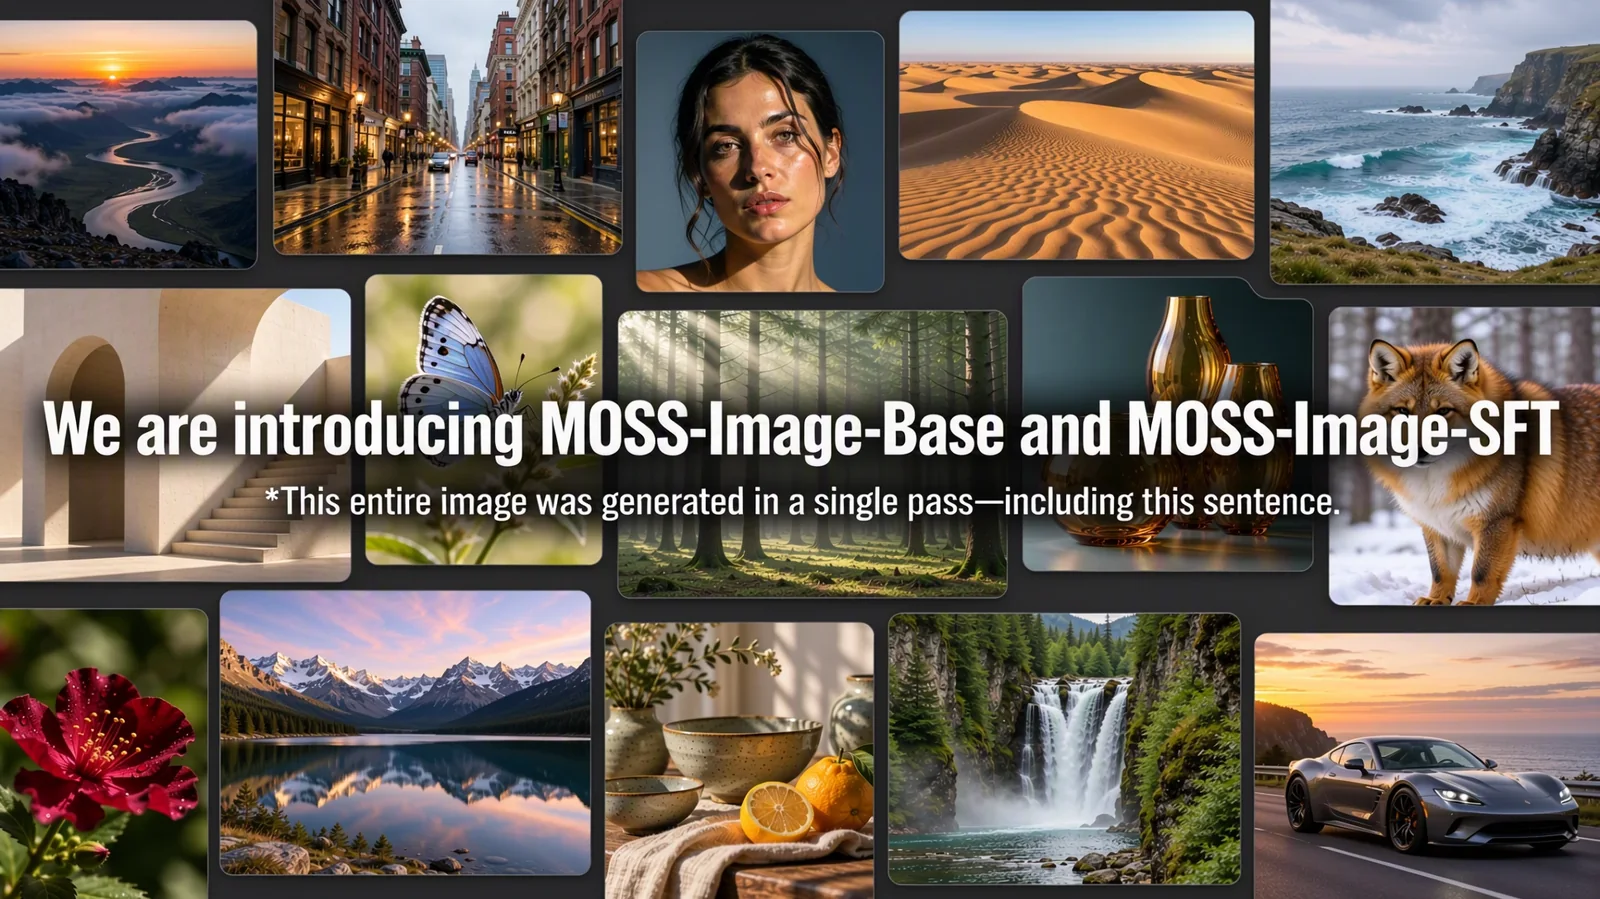
Échantillons de MOSS-Image-Base et MOSS-Image-SFT. Source : OpenMOSS
Le parti pris porte sur le texte et la structure plutôt que sur le photoréalisme brut : le modèle affiche du texte lisible en anglais et en chinois, accepte des prompts allant jusqu'à 4K tokens, et ajoute un mode de mise en page JSON où vous décrivez la scène puis placez les zones de texte et les objets par boîte englobante. OpenMOSS met également en avant le fine-tuning LoRA du modèle de base, et a entraîné cette famille sur des plateformes GPU mixtes.
Contrôle de mise en page
En mode mise en page, le prompt devient un document JSON avec un summary pour toute la scène et un tableau items pour les éléments individuels. Chaque élément porte un label (text, character ou object), un caption et un bbox, et les éléments de texte portent aussi la chaîne à afficher. Les boîtes englobantes utilisent bbox_format: "yxyx" dans les coordonnées bbox_coord_space: "abs_centralized", qui sont des décalages en pixels depuis le centre de la toile.
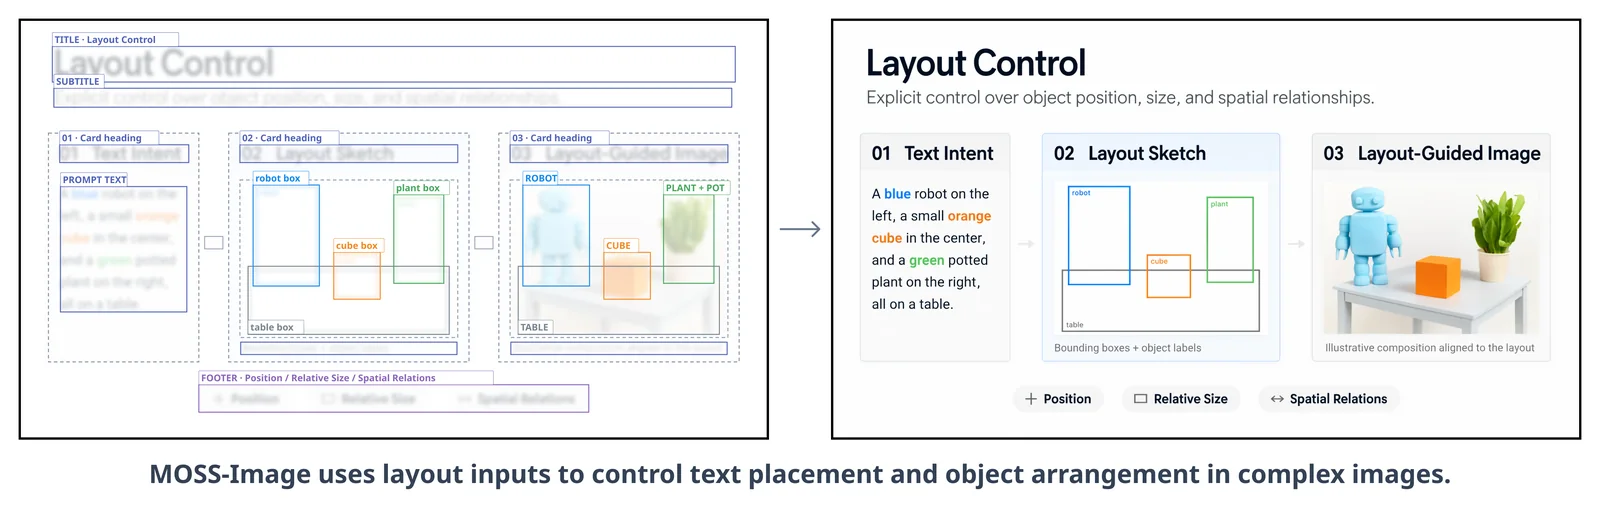
Une affiche générée à partir d'une description de mise en page, avec les boîtes dessinées par-dessus. Source : OpenMOSS
Comme la mise en page est une donnée, les modifications deviennent structurées : changez une légende ou déplacez une boîte, et seule cette partie de la composition change. ComfyUI expose cela via un nouveau nœud du cœur, MOSS-Image Layout Prompt, qui convertit les boîtes créées avec Créer des boîtes englobantes en JSON de mise en page du modèle.
Rendu de texte
Le rendu de texte en anglais et en chinois est la capacité phare, et le modèle insère lui-même des sauts de ligne lorsque le prompt ne les précise pas. Les prompts peuvent être en langage naturel, une séquence de tags de style booru ou le JSON de mise en page, et l'ordre de tags recommandé est Quality, Score, Meta, Year, Character, Series, Artist, General.
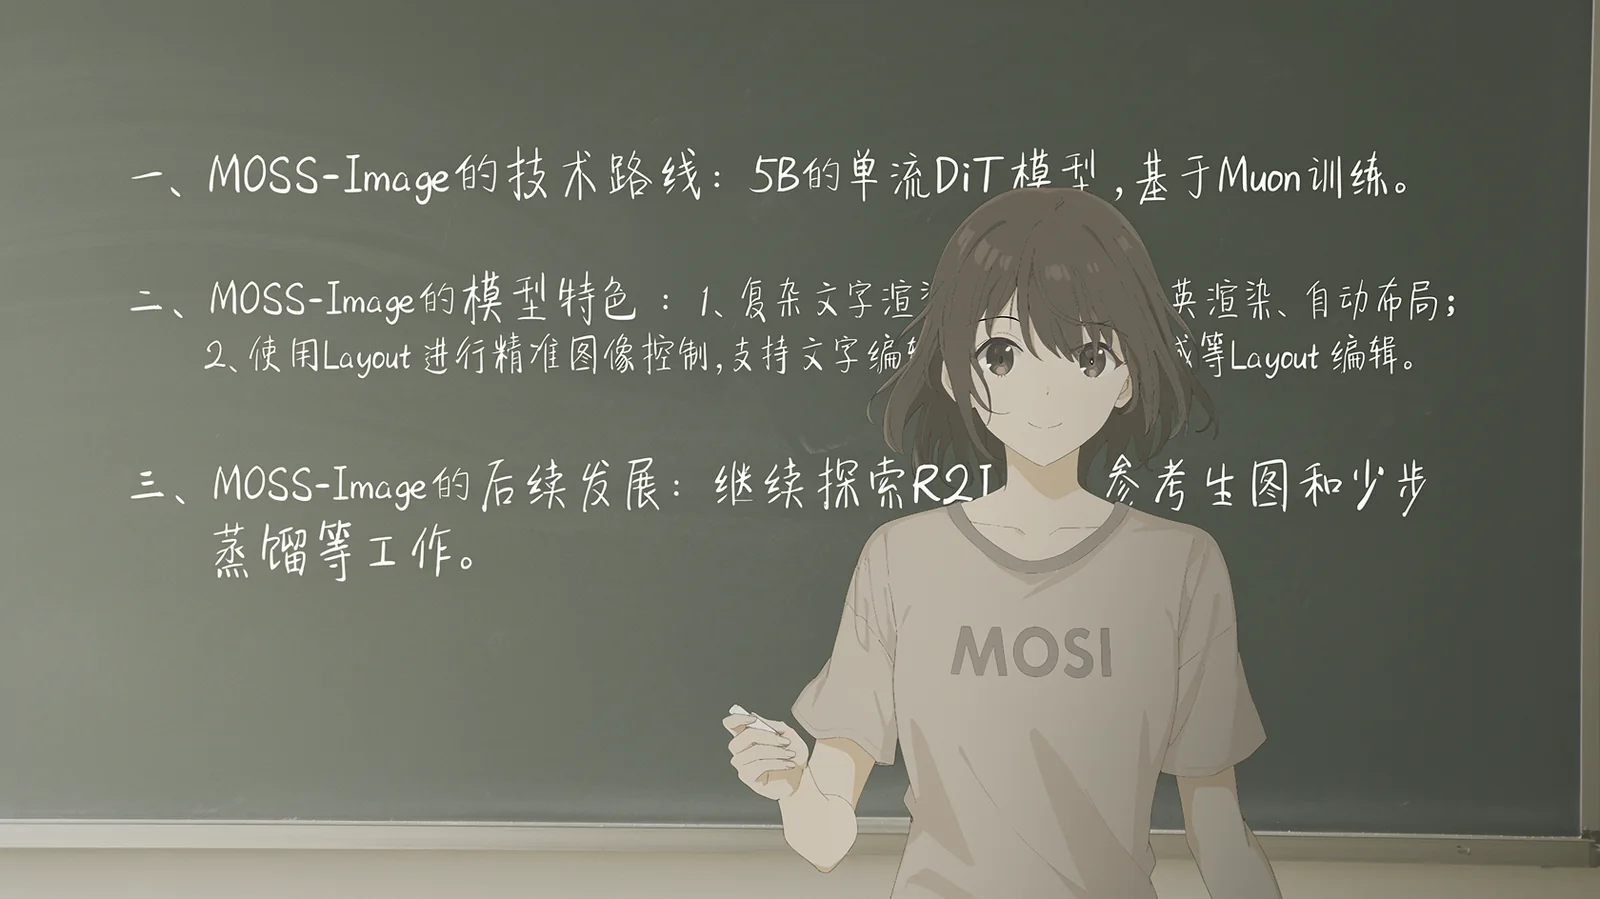
Des compositions à forte densité de texte générées à partir d'un seul prompt. Source : OpenMOSS
Base vs SFT
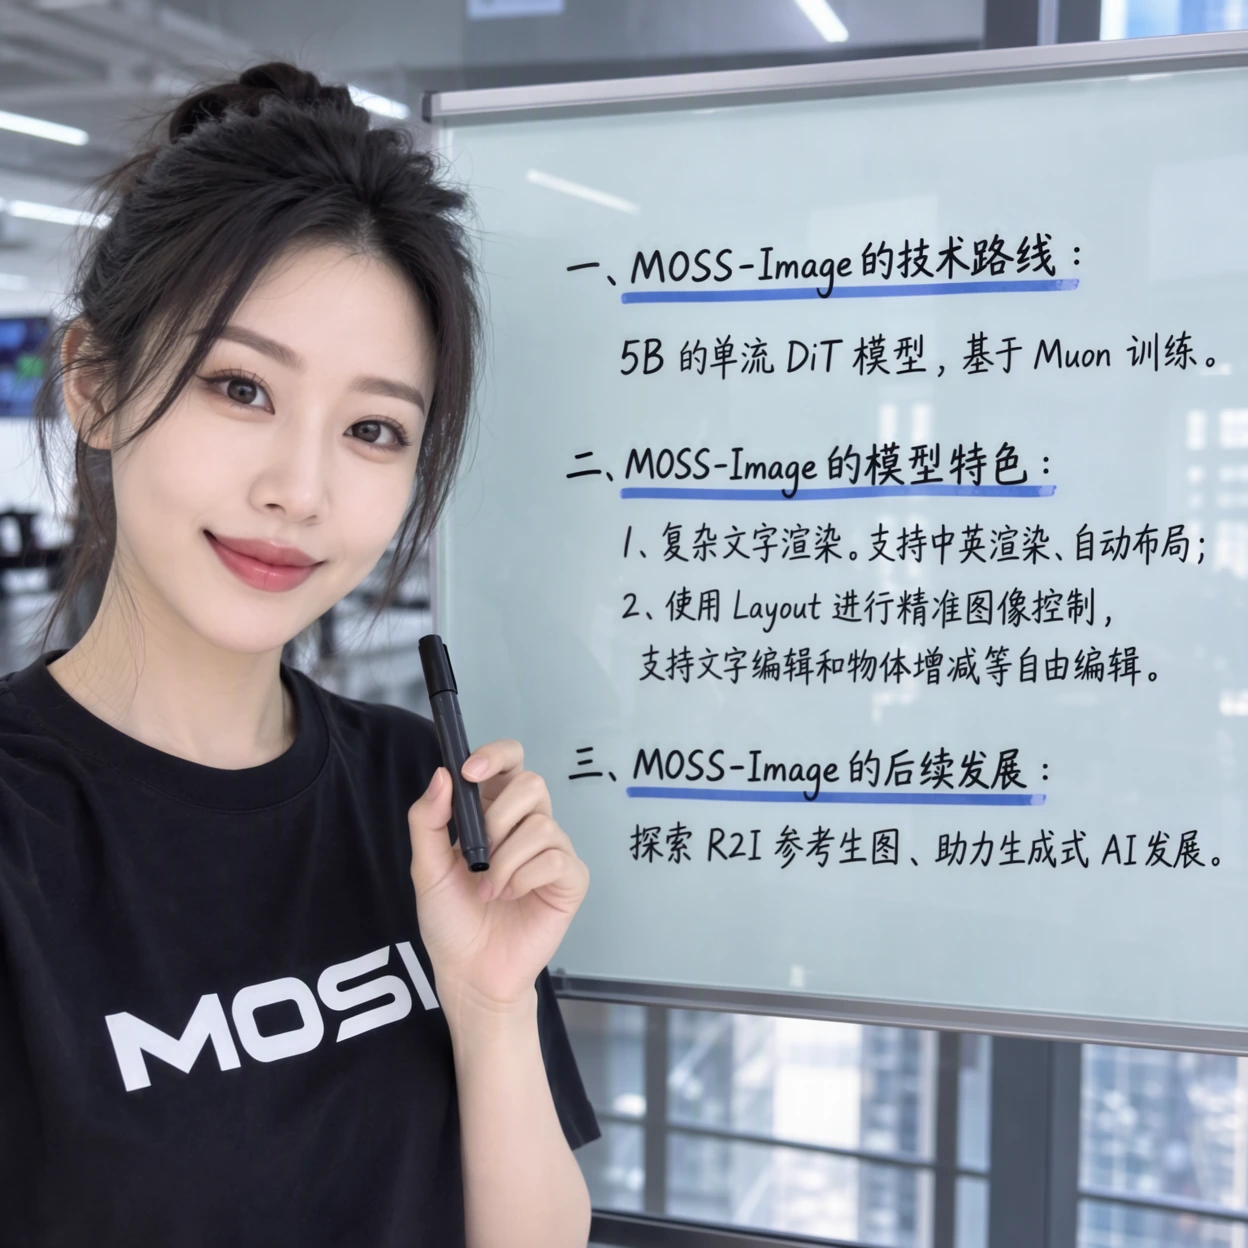
Les deux checkpoints partagent une architecture et un pipeline. Base préserve tout le signal d'entraînement et ne comporte aucune distillation des paramètres d'inférence, c'est pourquoi le guide d'utilisation recommande 50 étapes ou plus et un CFG de 3 ; le projet le recommande comme point de départ pour l'entraînement LoRA. SFT est affiné sur des données curatées, et OpenMOSS montre qu'il produit un regroupement de texte plus net et une mise en page plus organisée sur le même prompt.
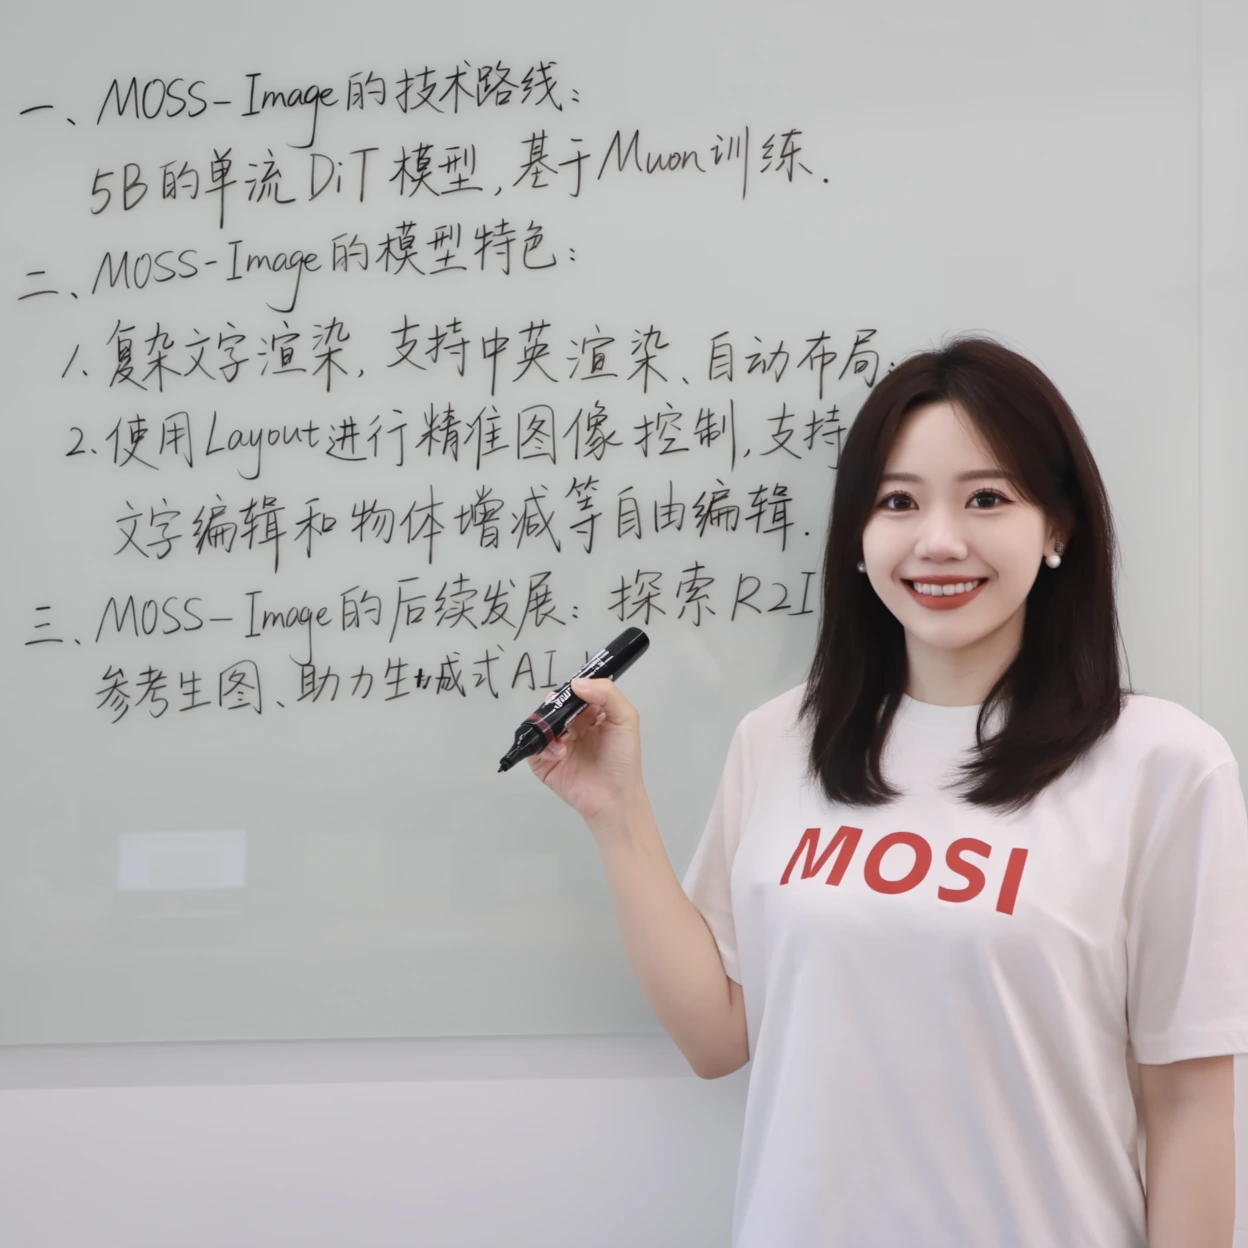 |  |
|---|---|
| MOSS-Image-Base | MOSS-Image-SFT |
Paramètres recommandés
| Paramètre | Recommandation |
|---|---|
| Échantillonneur | Flow-matching Euler |
| Étapes | 50 ou plus |
| CFG | 3 (plage de 3 à 6) |
| Shift | 5 |
| Saut de couches | Saut de branche négative à la couche 22 (22, 24 et 26 aident aussi) |
| Résolution | 1M, 1,5M ou 2M pixels recommandés ; de 0,25M (512×512) jusqu'à 4M pris en charge, multiples de 16 |
| Prompt négatif | nsfw, worst quality, bad anatomy, watermark, jpeg artifact |
Désactiver le saut de couches rend la sortie plus réaliste, mais peut réduire les détails fins, selon le guide d'utilisation.
Prise en charge de ComfyUI
La prise en charge dans le cœur est arrivée le jour de la sortie dans la PR #17095 : un DiT comfy/ldm/moss_image qui charge les clés du checkpoint Hugging Face telles quelles, le câblage de l'encodeur de texte Qwen3.5-9B, et le nœud de prompt de mise en page. La prise en charge a été fusionnée après le dernier tag de version, donc une installation existante doit être mise à jour pour l'exécuter.
Comfy-Org/MOSS-Image contient les poids repackagés en fichier unique que les chargeurs ComfyUI standard attendent :
| Dossier | Fichiers |
|---|---|
diffusion_models | moss_image_sft_bf16 (10.2 GB) · moss_image_sft_int8_convrot (5.4 GB) · moss_image_base_bf16 (10.2 GB) · moss_image_base_int8_convrot (5.4 GB) |
text_encoders | qwen3.5_9b_int8_convrot (9.8 GB) · qwen3.5_9b_w4a8_gptq (7.3 GB) |
vae | flux2-vae.safetensors (340 MB) |
Le référentiel du projet fournit aussi son propre plugin natif, moss-image, qui s'installe depuis le Gestionnaire ComfyUI et charge un répertoire Diffusers local via un nœud MOSS-Image HF Loader. Son flux de travail d'exemple tourne en 1024×1024 à 50 étapes, CFG 3, shift 5 et couche ignorée 22 :
moss-image. Les poids en fichier unique du repack Comfy-Org sont ceux à utiliser avec les nœuds du cœur.
Disponibilité
- Poids : MOSS-Image-Base et MOSS-Image-SFT sur Hugging Face, avec un miroir sur ModelScope.
- ComfyUI : prise en charge dans le cœur via la PR #17095, poids repackagés dans Comfy-Org/MOSS-Image, et le plugin propre au projet via le Gestionnaire ComfyUI.
- Essayez sans rien installer : Hugging Face Space.
- Documentation : page d'accueil du projet, guide d'utilisation et le rapport technique.
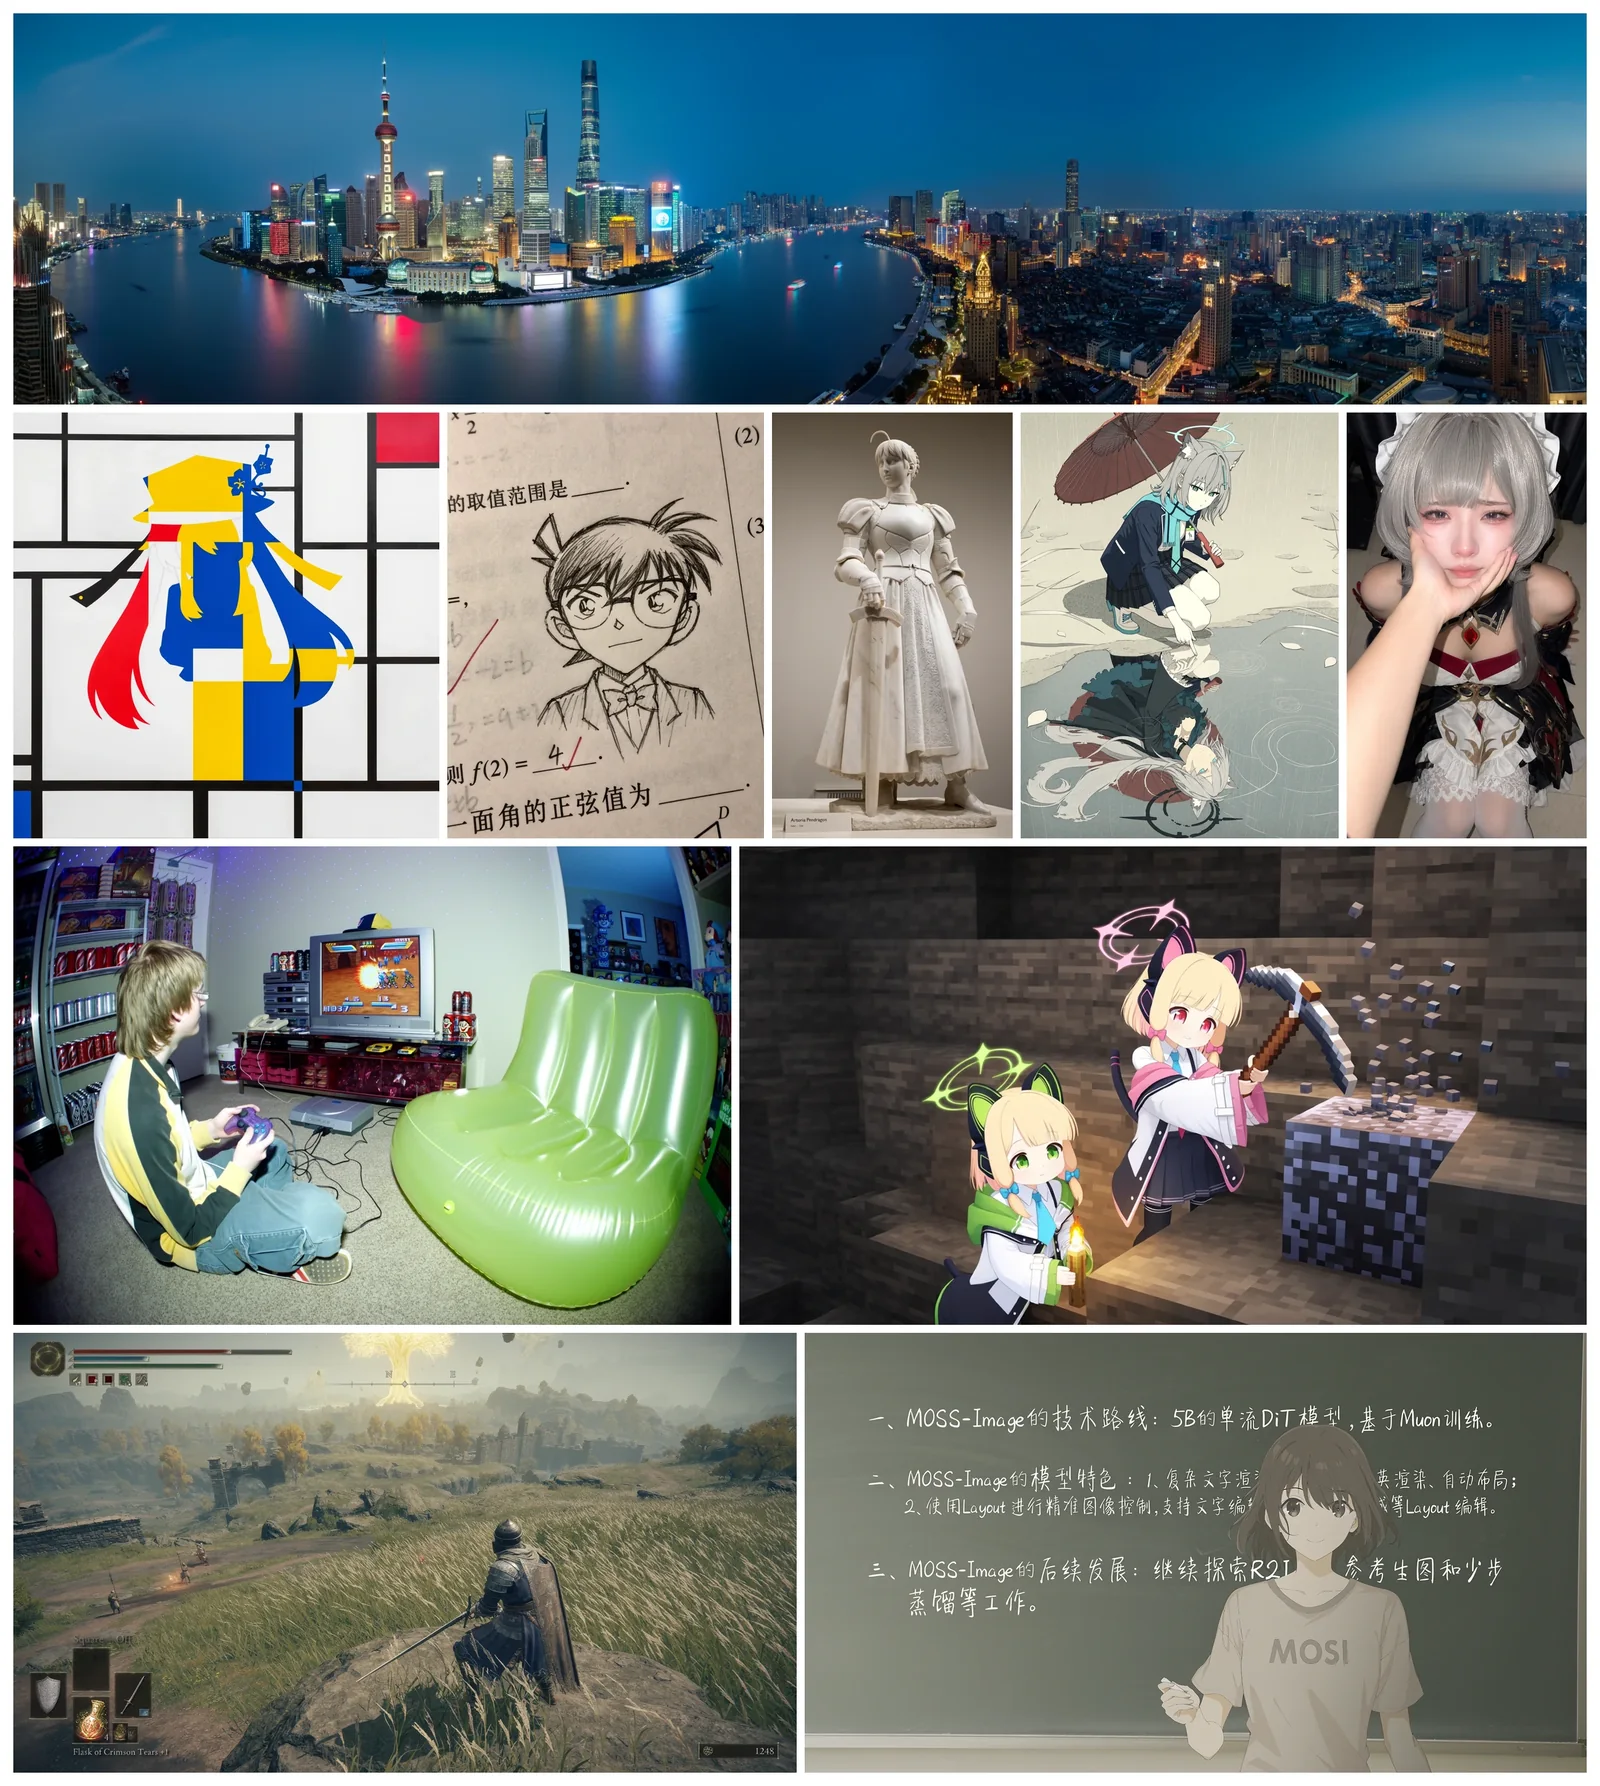
Un échantillon varié des sorties de MOSS-Image. Source : OpenMOSS
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.