SolarRenderer : rendu de structure en quatre étapes sur MiniMax H3
Deux LoRA SolarRenderer pour MiniMax H3 transforment boîtes grises, cartes sémantiques ou maillages SMPL en vidéo en quatre étapes, avec des nœuds ComfyUI.
SolarRenderer transforme une vidéo de structure en séquence terminée sur MiniMax H3 : une boîte grise issue d'un moteur de jeu, une carte de segmentation sémantique, un ensemble de squelettes, une passe de profondeur, un maillage corporel SMPL, ou un croquis que le modèle n'a jamais vu pendant l'entraînement. Deux LoRA de rang 384 font le travail : un LoRA de contrôle qui alimente la structure dans la propre voie de référence de H3 et un LoRA en quatre étapes qui rend le clip en quatre étapes d'échantillonnage.
Le projet est de Guian Fang, Shengju Qian, Dongyue Lu, Junchao Huang, Lutao Jiang, Xin Wang, Yiren Song, Li Jiang et Mike Zheng Shou, à travers NUS, LIGHTSPEED, CUHK(SZ), SLAI et HKUST(GZ). Les poids ont été publiés sur Hugging Face le 13 octobre 2026, le référentiel de code avec les données d'entraînement et le benchmark ont suivi le 15 octobre, et le papier est arXiv 2610.28630.
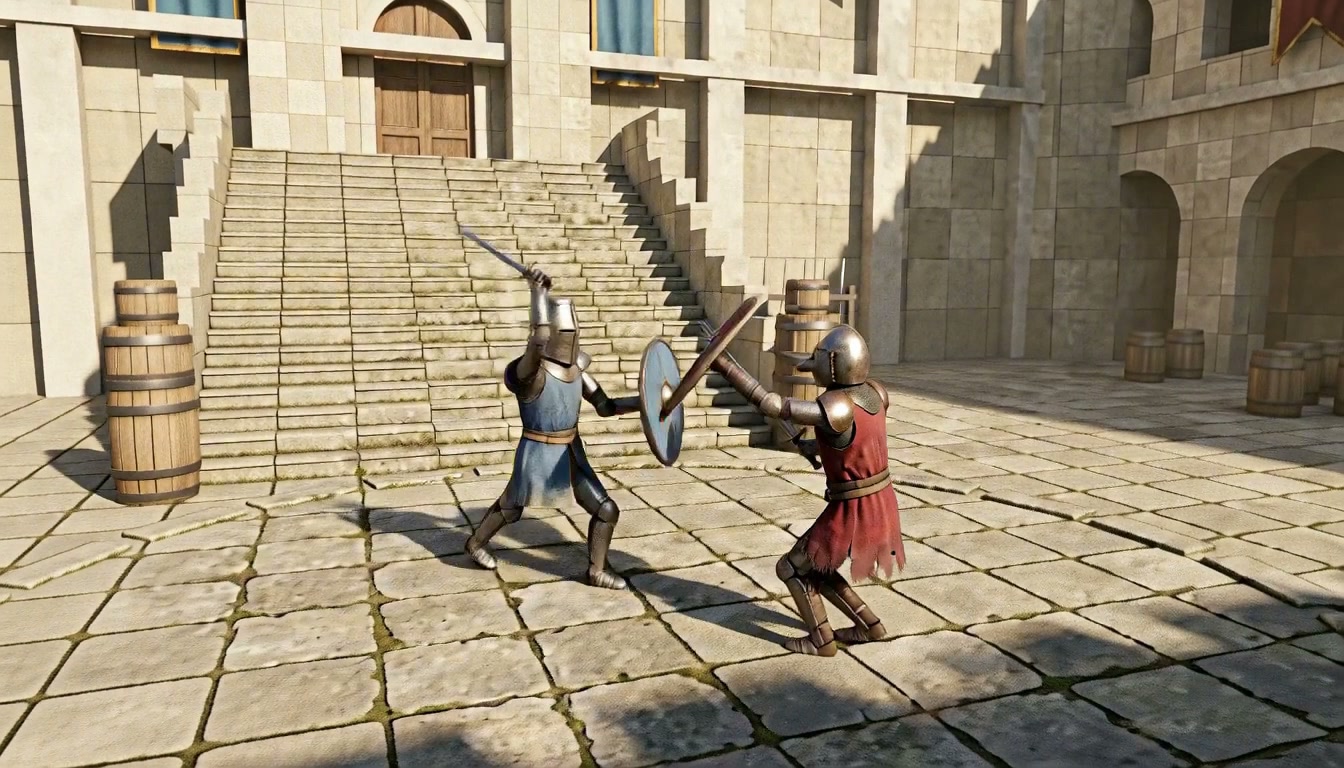
Une image du cas du château en boîte grise du benchmark, rendue à partir de la seule vidéo de structure, plus une première image et un prompt.
Ce qu'il exige et ce qu'il restitue
Les entrées sont une vidéo de structure à 24 fps comptant au moins 158 images, une première image optionnelle dans le rendu souhaité, et un prompt. La sortie est de 158 images à 24 fps, en paysage 1344x768 ou en portrait 768x1344, échantillonnées en quatre étapes. Les autres tailles de toile sont redimensionnées et recadrées. Le prompt n'est pas un texte libre : le modèle a été entraîné sur une forme unique en six parties (définitions du sujet, résumé, analyse de rétention, une description de 350 à 500 mots, paysage sonore, musique non diégétique), et le référentiel indique clairement qu'une courte phrase libre fonctionne bien moins bien.
Le LoRA de contrôle ne porte aucune étiquette de type de condition. Les images de structure entrent dans la voie de référence native de H3 aux positions des images qu'elles décrivent, et le prompt nomme la structure en mots, ce qui permet à un seul adaptateur de couvrir des représentations structurelles sur lesquelles il n'a jamais été entraîné. Le benchmark liste 16 types de structure, dont 11 invisibles à l'entraînement, et la galerie de l'article montre que les invisibles tiennent le coup : des storyboards au crayon, des nuages de points, des voxels, des wireframes, un dessin au crayon d'enfant.
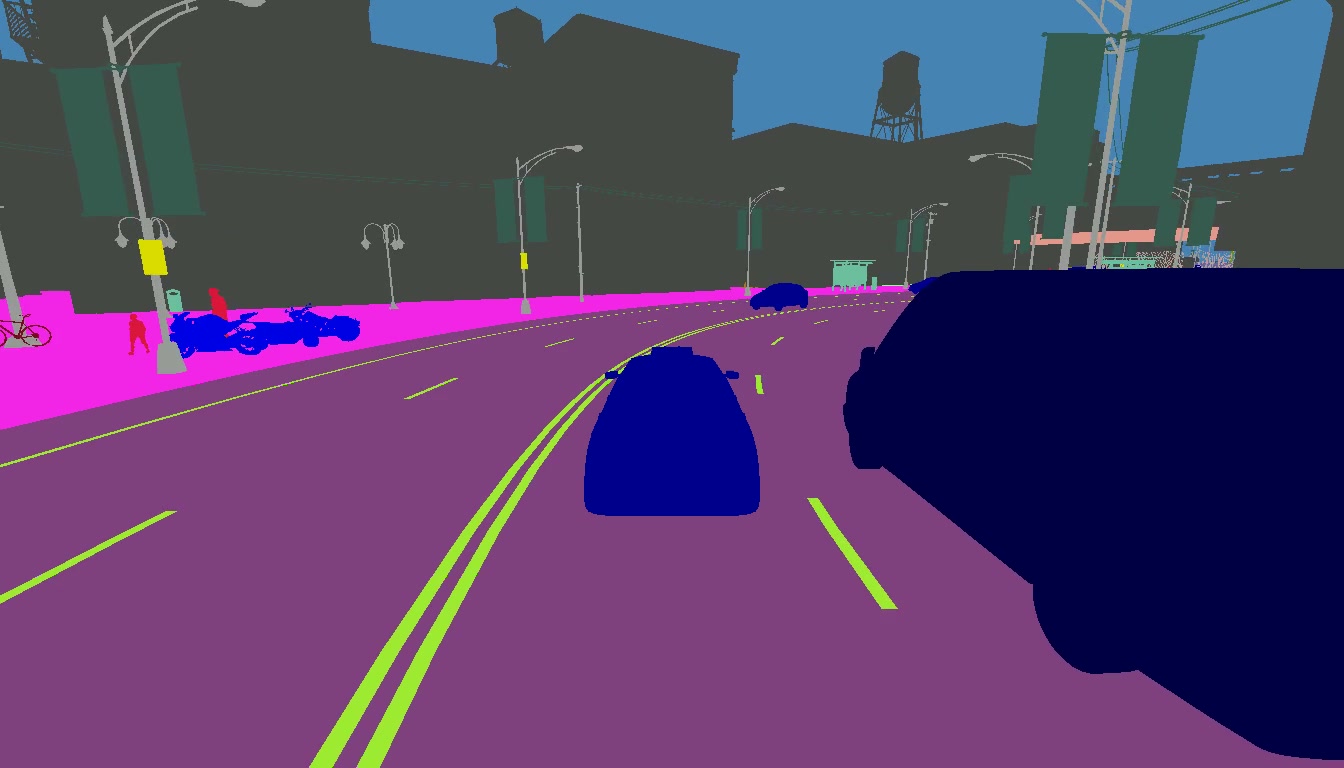 | 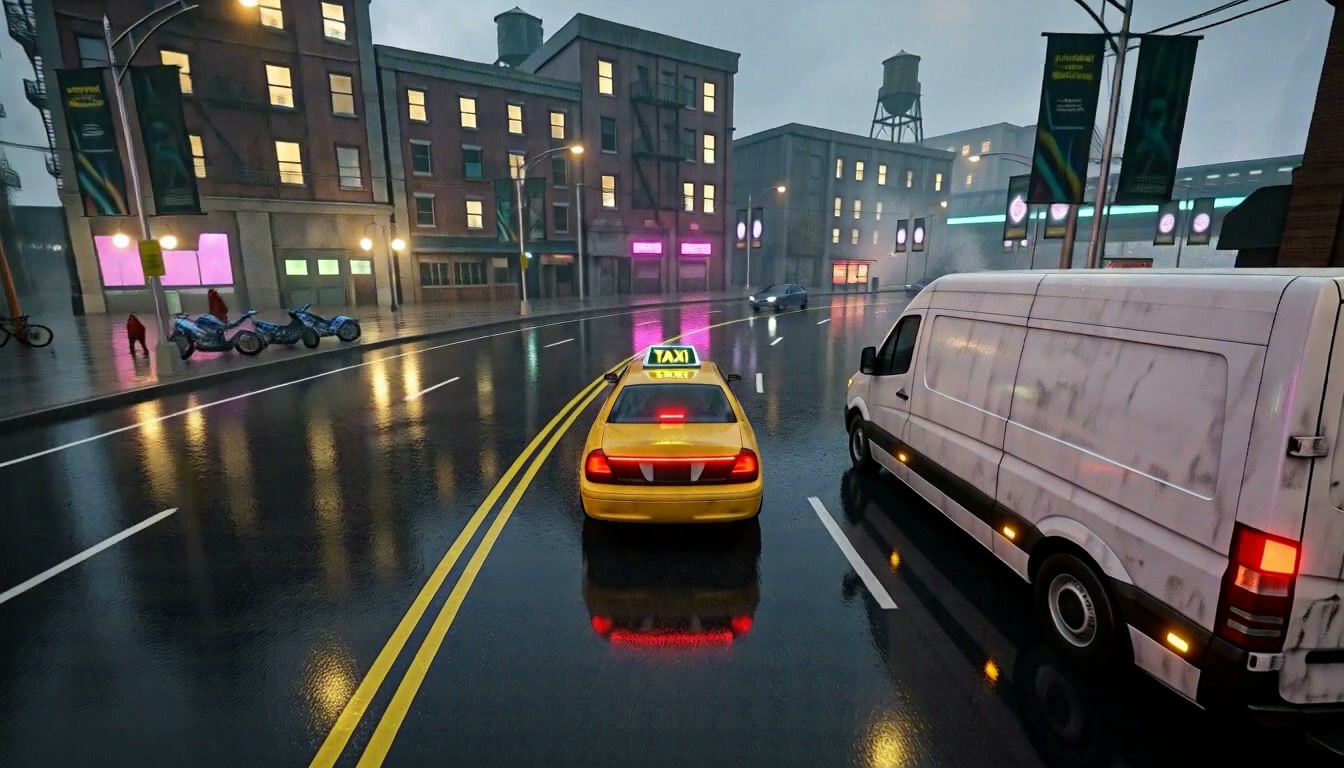 |
|---|---|
| Segmentation sémantique exportée depuis CARLA | Le rendu, étiqueté caméra rapide, nuit, plusieurs personnes |
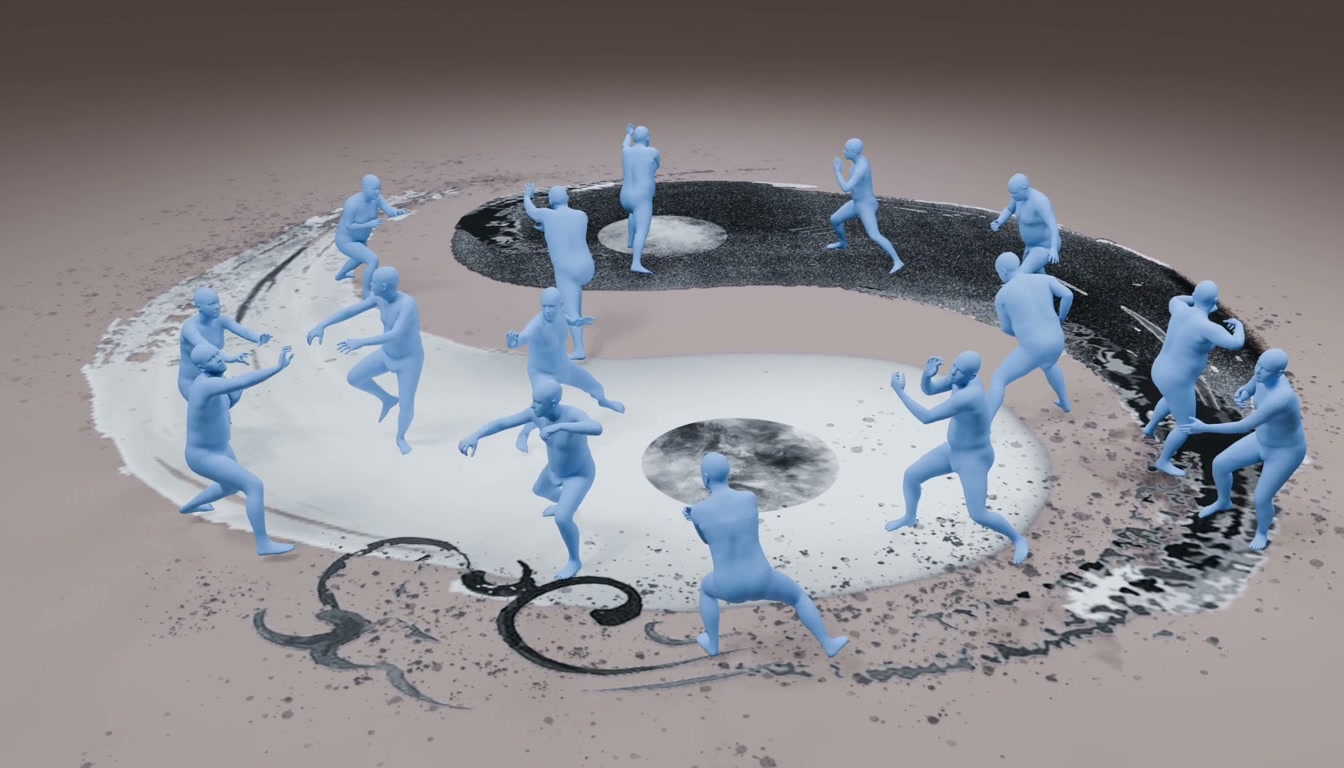 |  |
|---|---|
| Maillage corporel SMPL issu d'une vidéo DirtyMoCap, un type de condition hors de l'ensemble d'entraînement | Le même clip rendu dans un look anime |
Le rendu cyberpunk complet de 158 images, réencodé à partir de la sortie de benchmark publiée.
Deux LoRA, quatre étapes et une paire en streaming
Le LoRA de contrôle est de rang 384 et injecte la vidéo de structure alignée image par image. Le LoRA en quatre étapes est lui aussi de rang 384 et est affiné à partir de DMAD, la distillation H3 en quatre étapes que la communauté convertit pour ComfyUI depuis début octobre ; ici, la distillation est réentraînée avec un guidage de structure afin que l'étudiant en quatre étapes conserve le comportement de contrôle. L'article mesure cette approche comme 12,3 fois plus rapide que l'échantillonnage en 50 étapes.
Les deux LoRA existent aussi en une seconde version, causale par blocs. La paire causale rend le clip bloc par bloc : chaque bloc d'au plus cinq images latentes voit le prompt, la première image, la structure de ses six derniers blocs et les cinq blocs déjà rendus avant lui, jamais un bloc ultérieur. Chaque bloc fait quatre étapes, puis est inscrit dans un cache clé/valeur, si bien qu'un bloc peut être affiché dès qu'il est terminé, et --seconds étend un rendu à la longueur de la vidéo de structure grâce à la mémoire d'une fenêtre de six blocs.
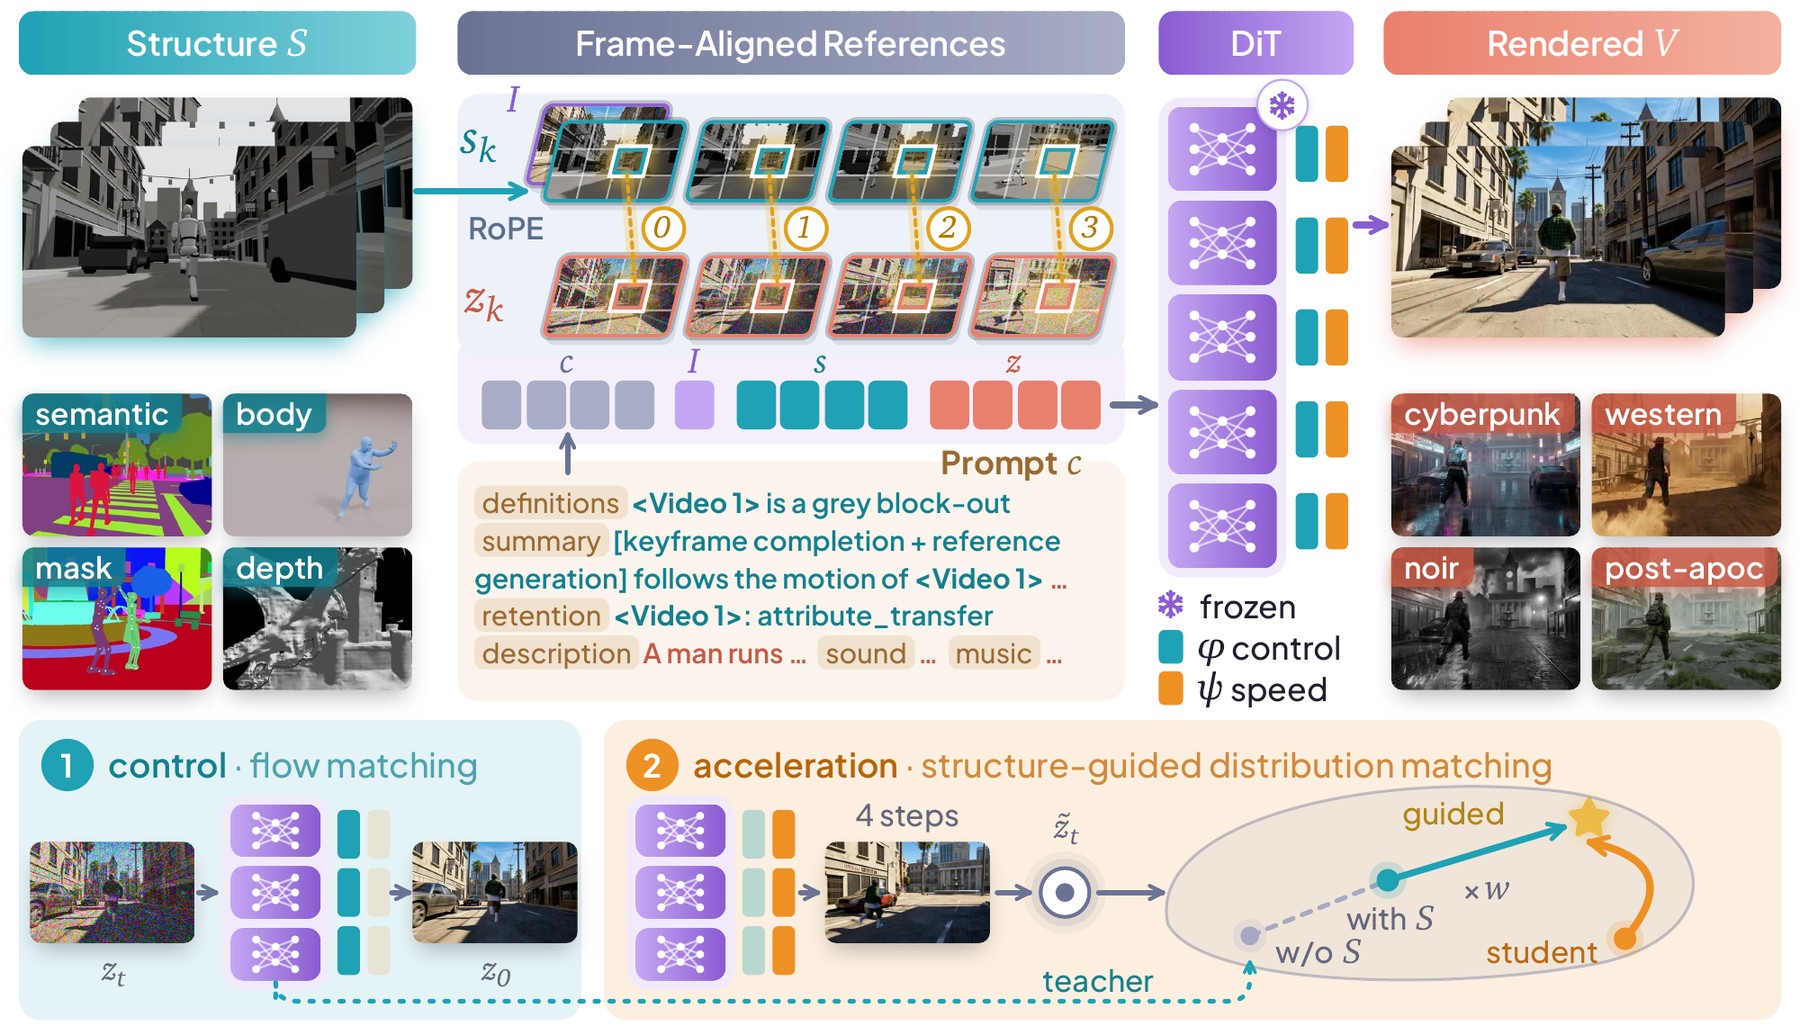
Le pipeline du projet : vidéo de structure en entrée, LoRA de contrôle et de quatre étapes sur un backbone H3 gelé, variante causale par blocs pour le streaming.
Exécution dans ComfyUI
Le référentiel fournit son propre pack de nœuds dans comfyui/, cloné dans custom_nodes/ de la manière habituelle ; il n'existe aucune entrée dans le registre, donc ComfyUI Manager ne le trouvera pas. Il s'exécute sur la prise en charge MiniMax H3 native de ComfyUI (v0.30.0 ou ultérieure) avec les poids Comfy-Org/MiniMax-H3, et les LoRA se chargent tels que publiés : le chargeur les associe aux noms de poids de ComfyUI, et deux sont chaînés, le LoRA en quatre étapes d'abord, puis le LoRA de contrôle.
| Nœud | Ce qu'il fait |
|---|---|
| SolarRenderer LoRA Loader | Charge un LoRA SolarRenderer publié, en chaîne deux |
| SolarRenderer Structure to Video | Vidéo de structure, première image et prompt en entrée ; conditionnement et un latent vide en sortie |
| SolarRenderer Model (silent soundtrack) | Maintient la bande sonore au silence pendant l'échantillonnage, comme le renderer a été entraîné |
| SolarRenderer Four-Step Sigmas | Le planning en quatre étapes, échantillonné avec SamplerCustomAdvanced |
| SolarRenderer Causal Sampler (long clips) | Effectue le rendu bloc par bloc, quelle que soit la longueur, avec la paire causale |
| SolarRenderer Fast Attention | Exécute l'attention sur un autre noyau, sortie identique |
| SolarRenderer Prompt | Construit le prompt en six parties à partir de ses parties libres |
| SolarRenderer Web Capture | Enregistre une page three.js ou WebGL en vidéo de structure, avec son audio |
Trois flux de travail l'accompagnent : pleine qualité, faible mémoire et le graphe causal pour longs clips. Le flux de travail faible mémoire est le plus intéressant pour les cartes locales. Le référentiel indique qu'il se termine avec ComfyUI limité à 14 Go de mémoire GPU et un pic à 14,5 Go, contexte CUDA inclus, sur une carte de 16 Go comme une RTX 4080 ou 4090, avec 64 Go de mémoire système. Sur une carte capable de contenir tous les modèles, ce chemin prend environ deux fois plus de temps que celui en pleine qualité.
Le pack sert également une page à http://127.0.0.1:8188/solarrenderer : choisissez un exemple ou déposez une vidéo de structure et une première image, écrivez le prompt, choisissez les modèles, et il effectue le rendu, en affichant les aperçus de l'échantillonneur au fur et à mesure et en lisant le résultat à côté de sa structure. Définissez --preview-method taesd avec taeh3.safetensors dans models/vae_approx pour observer chaque étape. Seul le nœud de capture web nécessite des installations supplémentaires (playwright et un téléchargement de Chromium).
Ce que dit le benchmark
L'article évalue 208 cas difficiles et 53 clips mis de côté (held-out) à l'aide d'un juge pairwise Gemini, en rapportant l'Elo par question, ainsi qu'un score automatique calculé par DOVER, LAION aesthetic, VideoScore2, flicker, DINOv2, CoTracker3 et edge F1. Sur le split mis de côté, la comparaison inclut DISTS, LPIPS, PSNR et SSIM par rapport au clip réel.
| Méthode | Étapes | Global (difficile) | Global (mis de côté) | Score auto (difficile) |
|---|---|---|---|---|
| SolarRenderer | 4 | 1441 | 1510 | 71,6 |
| SolarRenderer, causal | 4 | 1191 | 1199 | 71,2 |
| LynnReal-Omni | 4 | 1441 | 1410 | 70,0 |
| PAI ControlNet-Union | 40 | 1221 | 1189 | 69,4 |
| Backbone H3 officiel | 50 | 1075 | 651 | 69,8 |
| Streaming CWM | 4 | 1075 | 988 | 70,7 |
| Wan2.2-VACE-Fun | 50 | 389 | 651 | 65,2 |
| Cosmos-Transfer2.5 | 35 | 389 | 651 | 64,7 |
| StreamRender-H3 | 2 | 580 | 651 | 63,9 |
Les égalités sont bien réelles dans ce tableau : LynnReal-Omni égale SolarRenderer sur la note globale du split difficile et perd sur le split mis de côté. La variante causale n'est évaluée que face à la version bidirectionnelle, ce qui explique qu'elle se situe en dessous. Les verdicts du juge et les 522 rendus qui sous-tendent ces chiffres sont publiés avec le benchmark, afin que la comparaison puisse être re-notée plutôt qu'acceptée sur parole.
L'article affirme également que la variante causale rend du 768p en temps réel. L'intégration Reactor propre au référentiel, un aperçu de développement fourni par l'équipe Reactor, est plus prudente : sur quatre GPU B200, un bloc stable de 17 images prenait environ 1,8 à 2,1 secondes, en dessous de la timeline native à 24 fps, et la préparation d'une nouvelle vidéo pouvait prendre plus d'une minute.
Ce que la communauté a découvert
Sur le Discord Banodoco, la sortie a eu droit à une prise en main le jour même de son apparition. Kijai a testé le LoRA en quatre étapes face au DMAD d'origine et a constaté que le latent guide doit être utilisé pour correspondre à la configuration d'entraînement avant que le résultat ne s'aligne ; ensuite, selon lui, les nœuds H3 natifs peuvent le prendre en charge : « tu dois bien utiliser le latent guide pour correspondre à leur entraînement, ça marche mieux ensuite, on peut le faire avec des nœuds natifs ». Ses remarques sur les sorties étaient mitigées mais précises : le suivi du mouvement est exact au point d'être un peu trop littéral, et supprimer la première image coûte en qualité.
La forme du prompt a suscité le plus de plaintes, Kijai jugeant le prompt d'exemple officiel très compliqué et RuneX suggérant un prompt système. RuneX a également rencontré une erreur de buffer hôte en lançant la page du pack, et considère la majeure partie du pack comme remplaçable si le modèle est déjà chargé nativement : « les autres, c'est juste un nœud flash attention et un nœud sigma manuel ». Alisson, dont le correctif TARA a suivi la même voie de référence native pour le transfert de mouvement H3, a remis l'échelle d'entraînement en perspective : 136 000 clips contre ses propres 700.
Les réactions proviennent de #minimax_h3_chatter le 25 octobre, à partir d'ici.
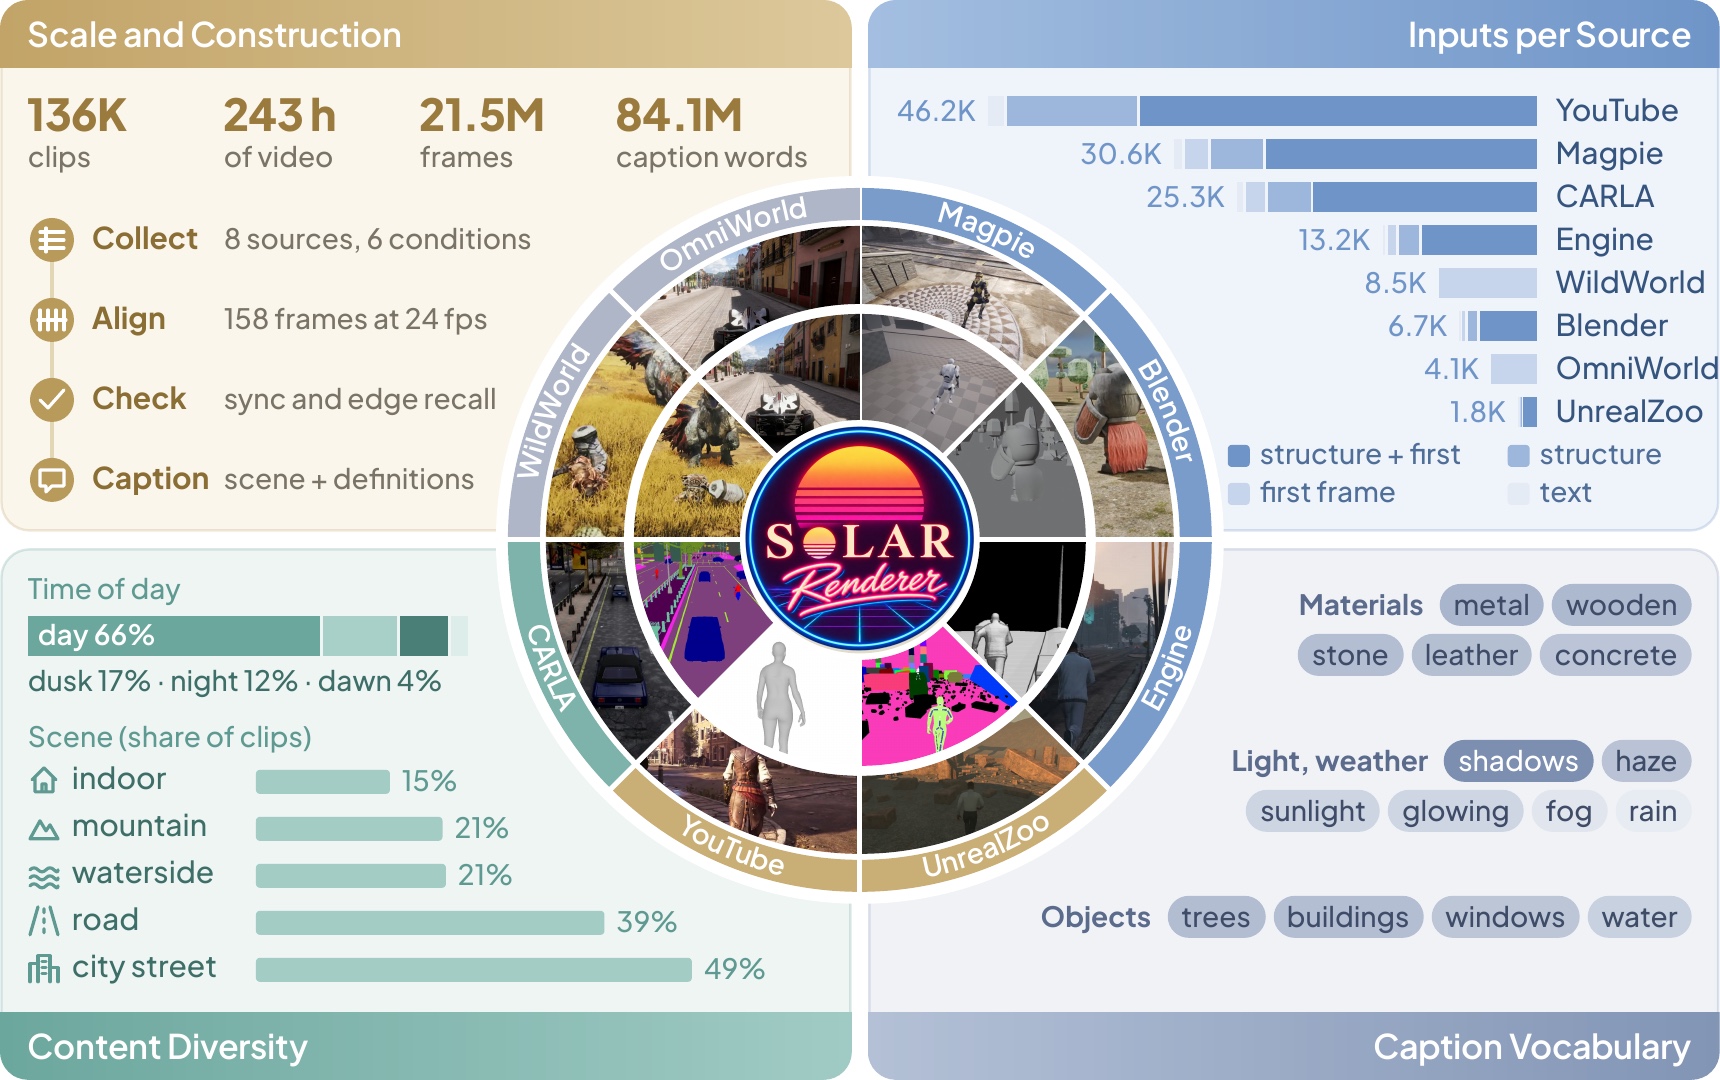
Les sources d'entraînement publiées : des clips Magpie, CARLA et UnrealZoo, 57 738 des 136 000 que décrit l'article.
Limites à connaître
- Le clip entraîné dure 6,6 secondes. Les vidéos plus longues nécessitent la paire causale, et l'échantillonneur causal conserve son cache clé/valeur autour de 80 Go en 1344x768, débordant vers la mémoire système lorsqu'il ne tient pas.
- Le chemin de référence représente 135 Go de poids H3 plus 8 Go de LoRAs pour la paire bidirectionnelle ; c'est la voie à faible mémoire de ComfyUI qui rend une carte de 16 Go exploitable.
- La forme du prompt est une contrainte stricte, pas une suggestion de style. Le texte libre fait perdre le contrôle pour lequel le LoRA a été entraîné.
- Le tableau Elo provient d'un seul juge, et les premières images du split difficile sont produites par un modèle d'image plutôt que capturées comme des photographies.
- Le chemin de streaming Reactor est un aperçu, non identique bit à bit à l'inférence native, et l'exécution Docker n'est pas encore validée.
Disponibilité
Les poids, la paire causale, la configuration et les conditions de licence sont disponibles sur Enderfga/SolarRenderer ; le code, le pack de nœuds ComfyUI, trois flux de travail, la compétence de prompt et l'intégration Reactor se trouvent dans le référentiel GitHub ; les données d'entraînement et le benchmark sont hébergés dans Enderfga/SolarRenderer-Data. Une démo en ligne est disponible sur Hugging Face Spaces pour réaliser un rendu sans installation.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.