Le LoRA H3 Anti-Burn stoppe la brûlure des visages en clips chaînés
Un LoRA de rang 32 pour les clips de continuation MiniMax H3 ramène la brûlure des visages de +44 % à 0 % sur les chaînes lightx2v 8 étapes, et de +61 % à +4 % sur un turbo inédit.
diffusion_model.*), donc aucun nœud personnalisé n'est nécessaire.
Le problème visé
Une longue vidéo H3 se construit généralement par chaînage : le clip 2 continue à partir des dernières images du clip 1, le clip 3 à partir du clip 2, et ainsi de suite. Chaque continuation copie la fin qu'on lui a transmise et y ajoute un peu de sa propre erreur. Après quelques clips, les visages brûlent : la peau et les traits deviennent granuleux et gravés, et l'image entière se durcit.
Le LoRA est chargé uniquement sur les passes de continuation et les maintient proches de l'aspect du premier clip, généré normalement. Il n'est explicitement pas prévu pour le clip 1, qui n'a rien à brûler.
Comment l'utiliser
- Chargez-le avec
LoraLoaderModelOnlysur le modèle qui rend uniquement les clips de continuation : du clip 2 et au-delà. - Commencez à une force de 0,5. Augmentez-la si les visages deviennent encore plus granuleux clip après clip, diminuez-la si les visages deviennent mous ou cireux.
- La force dépend du turbo et du pipeline. Fusionner le LoRA dans un checkpoint 8 bits l'affaiblit : il est donc recommandé d'essayer plusieurs valeurs sur une chaîne de 4 à 5 clips avant de se fixer.
Ce qui a été mesuré
Des chaînes de 10 clips, d'environ 37 secondes chacun, sur quatre scènes (une cuisine, la même cuisine avec une seconde graine, un parc et un porche), en faisant la moyenne de toutes les chaînes pour chaque réglage. La « brûlure du visage » mesure à quel point la texture fine du visage a changé entre le clip 1 et le clip 10 : zéro signifie que le clip 10 est aussi propre que le clip 1, une valeur positive qu'il a brûlé, une valeur négative qu'il est devenu plus doux que le clip 1.
| Turbo | Sans LoRA | 0,4 | 0,5 | 0,6 | 0,8 |
|---|---|---|---|---|---|
| Modèle inédit (jamais vu à l'entraînement) | +61 % | +29 % | +4 % | −13 % | |
| HyperFlow 8 étapes | +25 % | +4 % | −1 % | −14 % | |
| lightx2v 8 étapes v1.0 768p | +44 % | +14 % | 0 % | −7 % | −37 % |
| Larry Turbo v4 (step 600 EMA) | +261 % | +212 % | +159 % | +57 % |
La colonne du modèle inédit est la plus importante : le LoRA a été entraîné sur Larry Turbo v4, HyperFlow et lightx2v, et il a malgré tout maintenu un quatrième turbo qu'il n'avait jamais vu à +4 % avec 0,6.
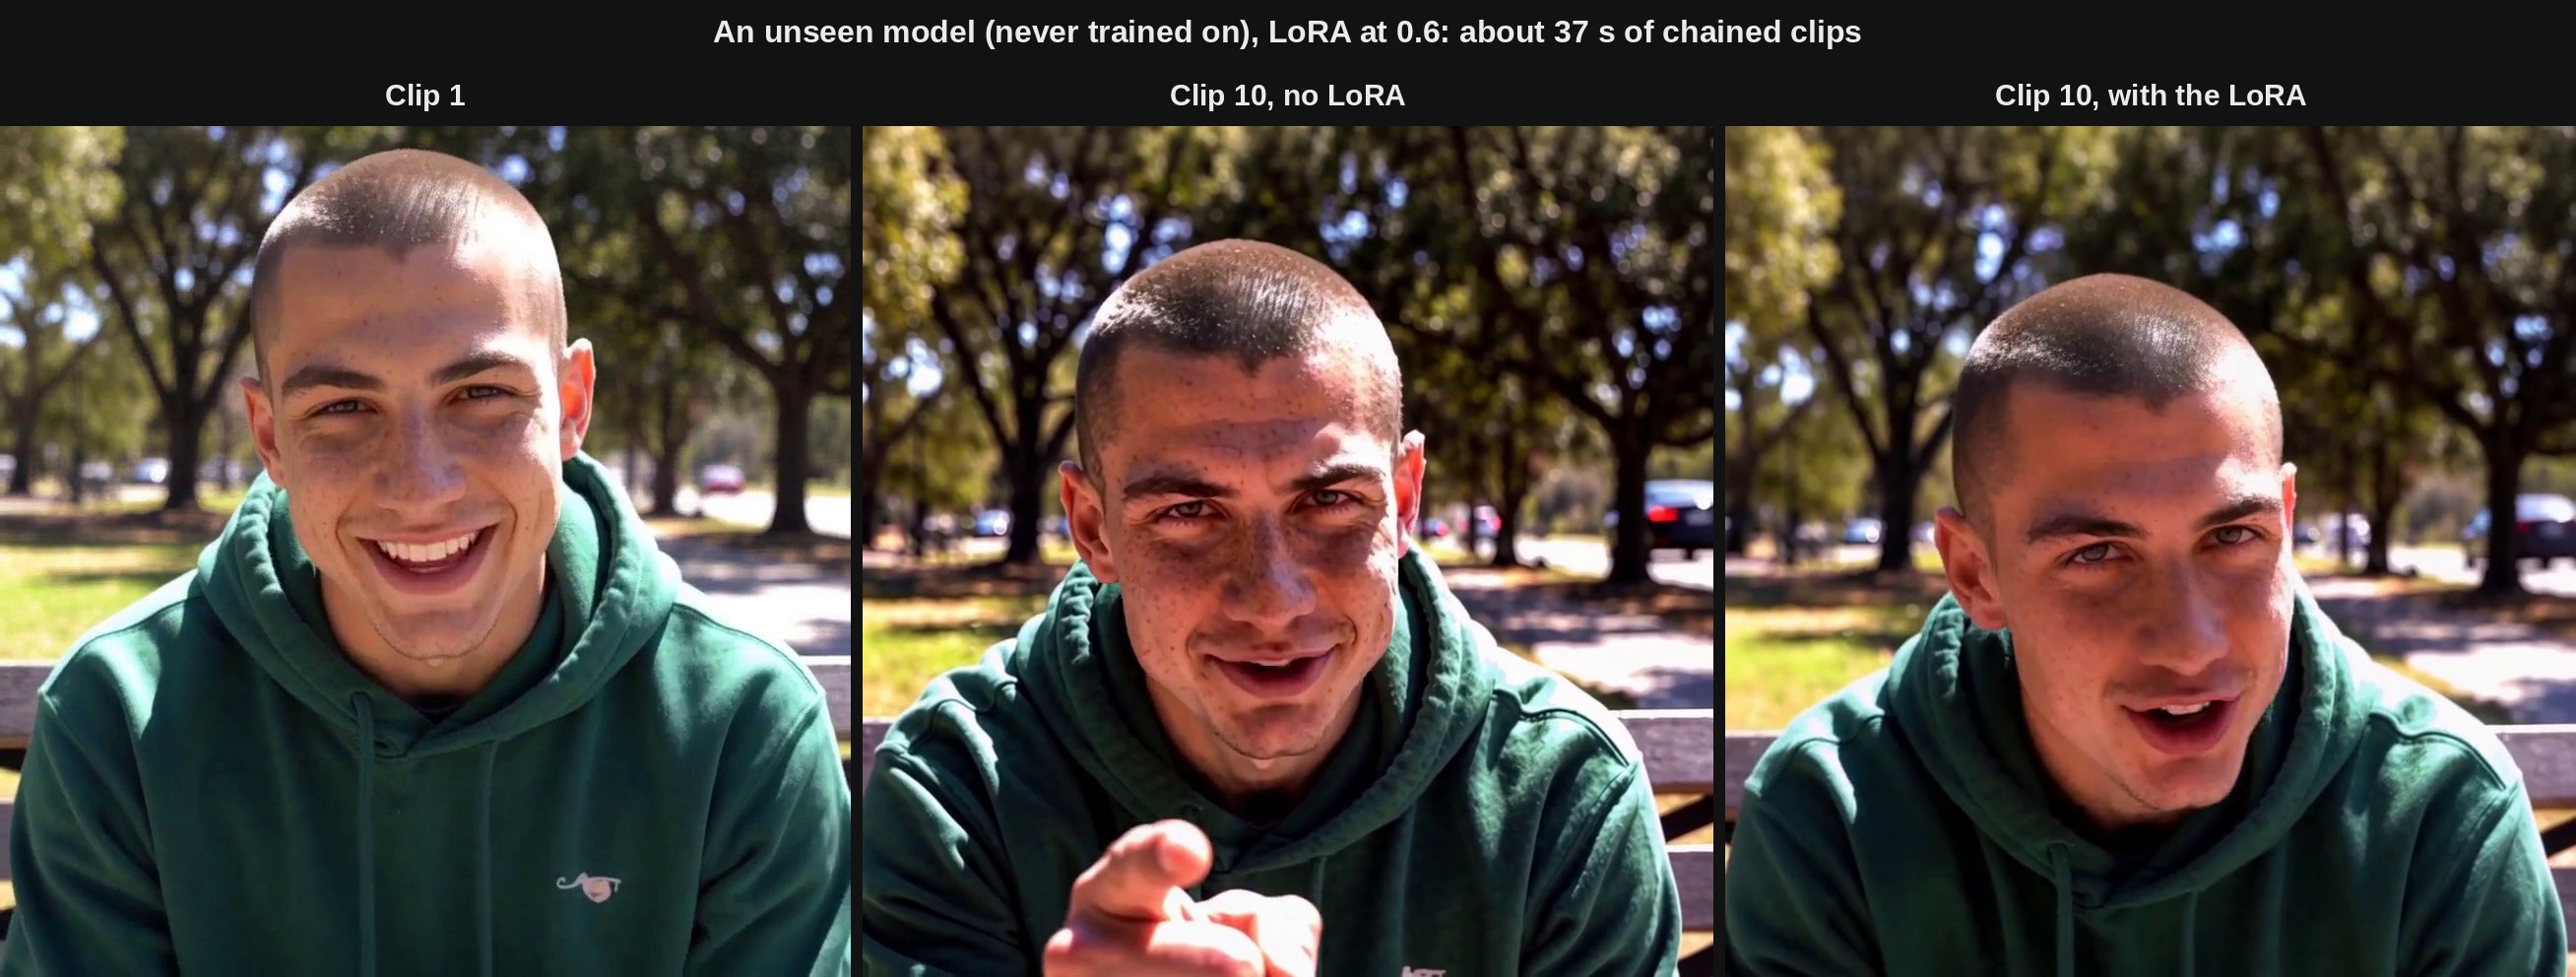
Un turbo sur lequel le LoRA n'a jamais été entraîné. Clip 1, puis clip 10 sans le LoRA, puis clip 10 avec le LoRA à 0,6. Dans cette scène, la brûlure du visage passe de +51 % à −4 %.
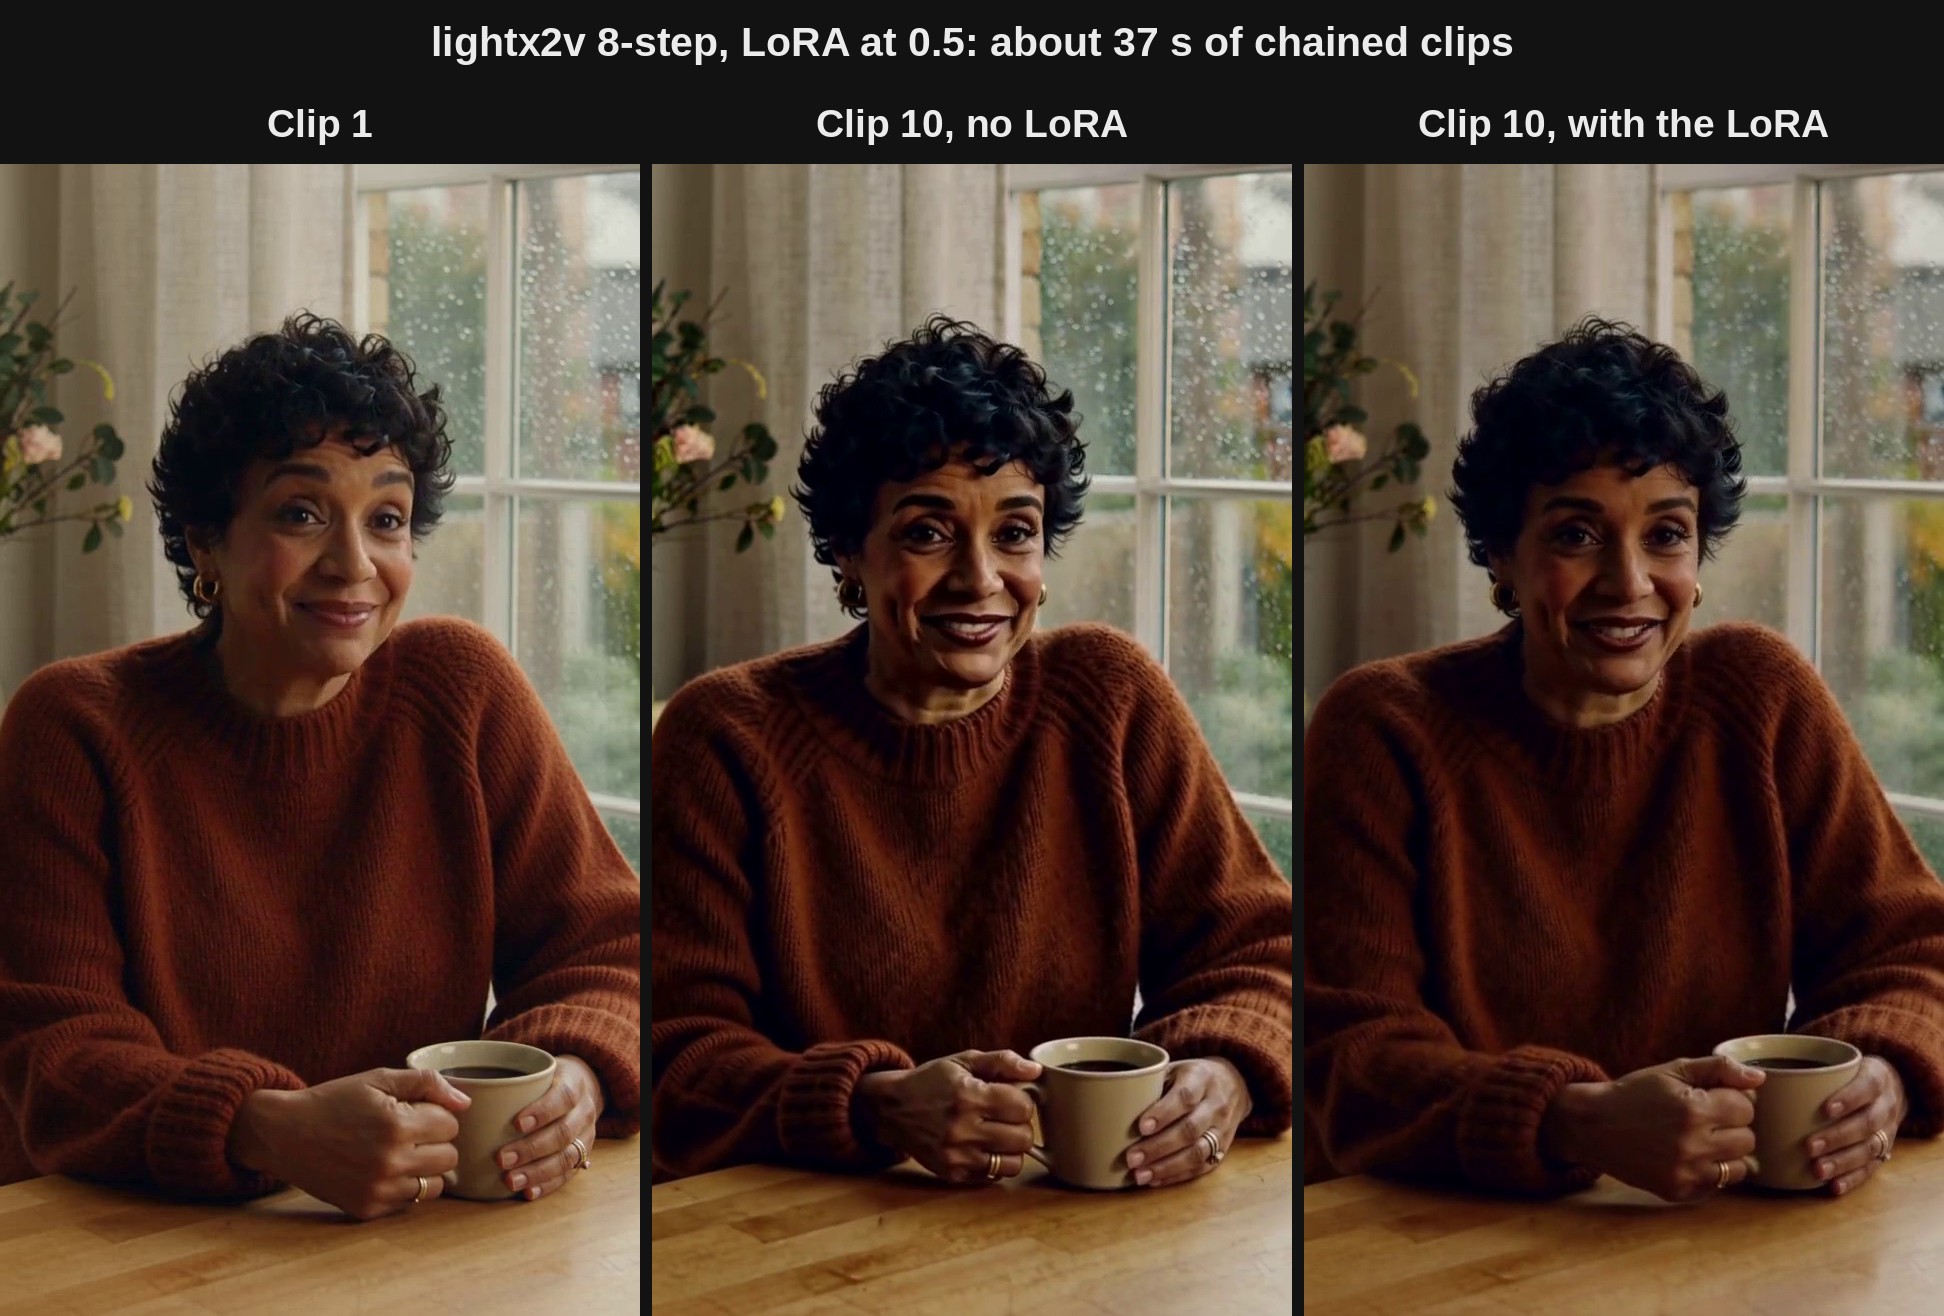
lightx2v 8 étapes v1.0 768p sur la scène de la cuisine : +52 % sans le LoRA, +6 % avec à 0,5.
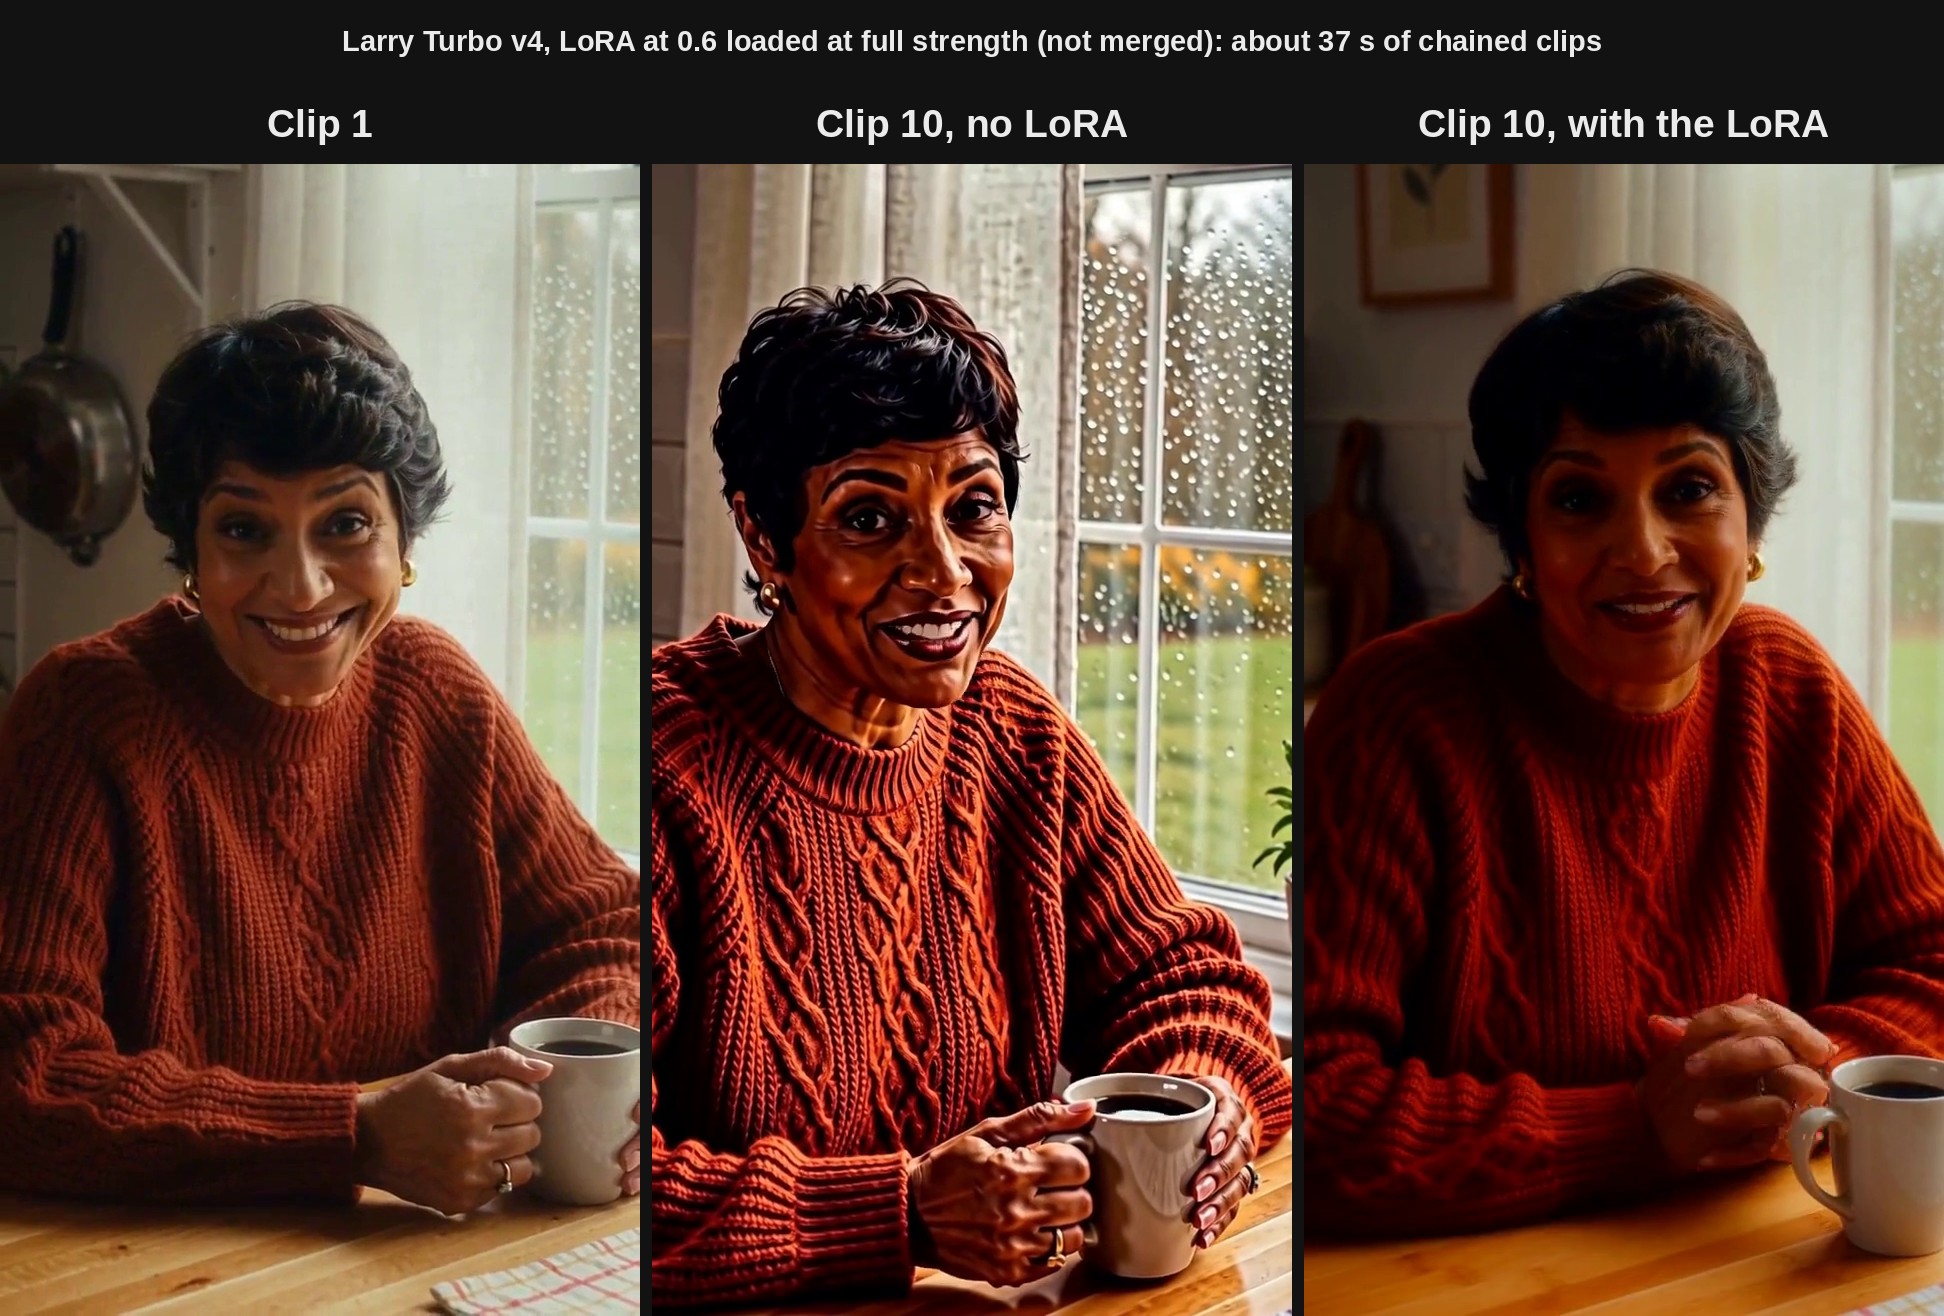
Larry Turbo v4, le pire cas de brûlure du test : +189 % sans le LoRA, −15 % avec à 0,6 chargé à pleine force. Larry adoucit encore l'image et dérive vers des tons plus chauds et plus sombres.
Larry a besoin de plus de 0,8 dans la configuration fusionnée. À 1,0, la brûlure du visage avait disparu (−19 %, deux chaînes), mais le cadrage de la caméra commençait à changer ; chargé à pleine force plutôt que fusionné, 0,6 le faisait passer de +261 % à −5 %.
La saturation, la rougeur de la peau et la synchronisation labiale restent identiques à ce qu'elles sont sans le LoRA. Le détail fin baisse légèrement : de 4 à 14 % sous le clip 1, contre 3 à 18 % au-dessus sans le LoRA. Une force trop élevée se voit à des visages mous et cireux.
La configuration derrière ces chiffres
- Les checkpoints MiniMax H3 int8 ConvRot élagués de ComfyUI proviennent de Comfy-Org/MiniMax-H3 ; le clip 1 utilise
fl2va, les continuations utilisentref2va. - Le LoRA est fusionné avec
LoraLoaderModelOnlyavant le LoRA du turbo. - Chaque continuation embarque les 39 dernières images du clip précédent et leur audio comme contexte masqué protégé.
- 8 étapes, CFG 1, en 640×1152, 1152×640 et 864×864.
D'autres checkpoints (bf16, fp8, GGUF), d'autres nombres d'étapes et d'autres façons de continuer demanderont une force différente.
Limites
La carte du modèle est claire sur son périmètre. Quatre scènes par réglage, c'est un test réduit, et une seule chaîne de 10 clips peut varier de ±15 points. Le LoRA empêche la brûlure mais ne répare pas une vidéo déjà brûlée. Il n'a été testé que sur des continuations à partir d'un contexte masqué, pas sur d'autres façons de prolonger une vidéo, et uniquement sur des personnes qui parlent, avec des visages à distance moyenne ou rapprochée.
Comment il a été entraîné
L'entraînement repose sur l'auto-distillation de trajectoire. L'auteur a enregistré ce que chaque turbo fait réellement lors d'une génération fraîche en 8 étapes, soit 150 exécutions en pleine résolution au total, 50 chacune avec Larry, HyperFlow et lightx2v. Le LoRA a ensuite été entraîné en mode continuation, avec le début de la même vidéo épinglé comme contexte protégé et la propre exécution fraîche du turbo comme cible, afin qu'une continuation apprenne à ressembler à une génération fraîche plutôt qu'à amplifier ce qui se trouvait dans son contexte. Il n'y a eu ni brûlure synthétique ni perte sur bruit frais ; les versions antérieures qui les utilisaient adoucissaient tout.
Les paramètres d'exécution étaient 300 étapes, rang 32, taux d'apprentissage 1e-4, poids de réseau 0,6, résolution 864, 124 images, sur une seule RTX PRO 6000.
Disponibilité
L'adaptateur est h3_antiburn_universal_v1.safetensors dans le référentiel Hugging Face : 416 tenseurs, bf16, couvrant les calques d'attention et MLP des 50 blocs DiT et des 2 blocs token-refiner, sans adaLN. Placez-le dans ComfyUI/models/loras/. Le code d'entraînement, les configurations ainsi que les scripts d'enregistrement et de scoring se trouvent dans la branche h3-antiburn d'un fork d'ai-toolkit.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.