ComfyUI-Drama3 : Drama 3 de Fish Audio en local sur 8 Go
ComfyUI-Drama3 est un pack de nœuds qui exécute Fish Audio Drama 3 dans ComfyUI dès 8 Go de VRAM, avec clonage vocal, dialogue à 16 locuteurs, indications en ligne et Qwen3-ASR.
ComfyUI-Drama3 : Drama 3 et Qwen3-ASR sous forme de nœuds ComfyUI, sans paquet supplémentaire à installer.
Drama 3 est un modèle de synthèse vocale mixture-of-experts de 35B, avec 3B de paramètres actifs par token. Le paquet de Fish Audio se compose de huit fragments safetensors plus un codec, soit environ 40 Go sur disque, et le nœud partenaire ComfyUI y accède via l'API. Ce pack est la voie locale : il charge lui-même les checkpoints publiés, génère les codes audio dans ComfyUI et les décode en 44,1 kHz sur le même graphique.
Un modèle de 35B sur une carte de 8 Go
Drama 3 est un mixture of experts de style Qwen3.5 : 40 couches, chacune avec 256 experts routés dont 8 s'exécutent par trame audio, plus de l'attention ou DeltaNet, un expert partagé et un décodeur de codebook à 13 couches. Tout sauf les experts routés représente environ 6 Go et reste sur le GPU. Avec les experts en RAM, les 32 Go de poids d'experts résident dans de la mémoire système épinglée : chaque trame copie les huit experts par couche dont elle a besoin, et un cache à éviction du moins récemment utilisé, placé dans la VRAM laissée libre, conserve ceux qui reviennent, avec 85 à 95 % des lectures qui touchent un cache de 13 Go.
Le pack fournit quatre versions du checkpoint et vous laisse choisir selon la machine :
| Fichier | Taille | Experts | RAM avec les experts en RAM |
|---|---|---|---|
drama3_fp8experts_bf16 | 38,6 Go | FP8, tels que livrés par Fish Audio | ~48 Go |
drama3_int8experts_bf16 | 38,7 Go | int8 ConvRot | ~48 Go |
drama3_w6a8experts_bf16 | 32,7 Go | W6A8 | ~40 Go |
drama3_w4a8experts_bf16 | 24,6 Go | W4A8 | ~32 Go |
FP8 conserve les poids d'experts de Fish Audio octet pour octet. int8 fait la même taille et s'est montré 14 à 17 % plus rapide sur une RTX 3090, car les experts int8 s'exécutent en int8 tandis que les experts FP8 sont convertis en bf16 à chaque passe. Les fichiers plus petits s'adressent aux machines qui n'ont pas les ~48 Go de RAM exigés par le fichier FP8. Un second GPU peut prendre en charge les poids d'experts lorsque experts est réglé sur VRAM au lieu de RAM.
Voix, dialogue et indications
Le pack respecte la syntaxe de prompt propre à Drama 3, celle que documente le rapport technique :
| Contrôle | Comment l'écrire | Exemple |
|---|---|---|
| Locuteur | <|speaker:N|> au début d'une ligne, N de 0 à 15 | <|speaker:0|> Ready? |
| Balise ponctuelle | [tag] à l'endroit où le son doit tomber | Well [sighs] fine, you win. |
| Balise délimitée | <tag>...</tag> autour des mots qu'elle module | Promise me <whisper>you won't tell her</whisper>. |
| Préfixe de style | [style] au début d'une ligne | [with bright eager excitement] We won! |
| Note du directeur | Direction: puis Line: à la ligne suivante | Direction: icy calm. |
| Indication de langue | [language: xx] après une ligne, non prononcée | Welcome back. [language: en] |
Jusqu'à 16 locuteurs peuvent partager un même texte, et chacun obtient un emplacement de voix. Les textes longs sont découpés en segments d'environ 300 octets sans couper une balise. La génération de prises propose quatre modes : une prise par ligne, une prise par ligne qui entend la ligne précédente, une prise par locuteur, ou tout le script ensemble afin que chaque ligne entende les autres. Le décodage relie les prises séparées par 0,3 seconde de silence et peut raccourcir les longues pauses.
Une voix est encodée une seule fois à partir d'un extrait audio et de sa transcription, puis peut être enregistrée sous forme de fichier de quelques kilo-octets dans output/drama3_voices, si bien que les exécutions suivantes n'ont besoin ni de l'extrait ni du codec. Les prises générées peuvent être enregistrées de la même façon dans output/drama3_codes et redécodées ou modifiées sans générer à nouveau.
Transcrire et monter les prises
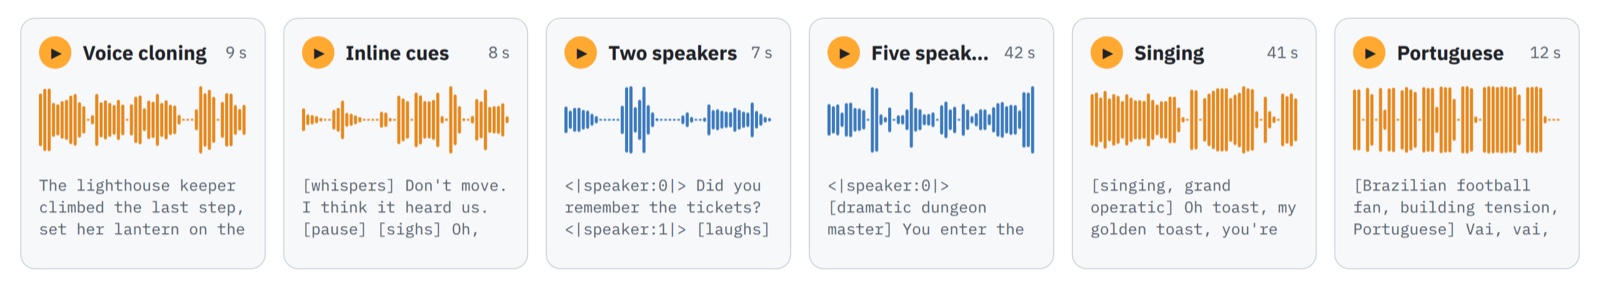
Six exemples issus de la page d'exemples du pack : clonage, indications, une scène à deux locuteurs, une scène à cinq locuteurs, du chant et du portugais. Chacun a été généré sur une RTX 3090 ou une RTX 4090 avec la version FP8.
Le clonage vocal part d'une transcription, et le pack en fournit une : Load Qwen3-ASR et Qwen3-ASR Transcribe exécutent un modèle de reconnaissance vocale de 1,7B ou 0,6B, ainsi qu'un aligneur forcé, en 30 langues sans paquet supplémentaire. Sur une RTX 3090, un extrait de 6,6 secondes se transcrit en environ 2 secondes avec le modèle 1,7B et en environ une seconde avec le 0,6B, chargement du modèle compris. Le même aligneur alimente Drama 3 Editor, qui s'ouvre par-dessus la toile ComfyUI : les sous-titres suivent la voix mot à mot, une piste par voix, et l'éditeur découpe, ajoute des silences, nomme les voix et règle leur volume. Appuyer sur Use these edits relance le nœud avec ces modifications, qui restent dans le flux de travail.
Vitesse
Drama 3 produit 21,5 trames audio par seconde de parole, donc 46 ms par trame correspond au temps réel. Décoder une trame à la fois est limité par le CPU, car un seul cœur lance de nombreux petits kernels GPU ; la taille du cache d'experts influe donc moins sur la vitesse que prévu. Mesures effectuées avec une voix clonée et environ 9 secondes de parole sur un Intel Core i9-14900K, passe de prompt comprise :
| GPU | Fichier | Cache d'experts | ms par trame | VRAM de pointe |
|---|---|---|---|---|
| RTX 4090 | W4A8 | 16 Go | 52 | 21,3 Go |
| RTX 4090 | W4A8 | 4 Go | 67 | 11,7 Go |
| RTX 4090 | int8 | 16 Go | 69 | 21,5 Go |
| RTX 3090 | int8 | 16 Go | 69 | 21,6 Go |
| RTX 3090 | FP8 | 16 Go | 84 | 21,6 Go |
| RTX 3090 | FP8 | 4 Go | 119 | 11,9 Go |
| RTX 3090 limitée à 12 Go | FP8 | automatique | 137 | 9,8 Go |
| RTX 3090 limitée à 8 Go | FP8 | automatique | 214 | 6,5 Go |
Les deux dernières lignes ont été exécutées avec le reste de la mémoire de la 3090 occupé par un autre processus, pour simuler une carte de 12 Go ou de 8 Go. L'auteur avertit aussi que le serveur de Fish Audio envoie top_k 30, ce qui fait taire les prises lors des pauses ; les nœuds utilisent donc par défaut les paramètres propres au Space : température 1.0, top_p 0.9 et aucun plafond top_k.
Commencer
ComfyUI/custom_nodes/ et redémarrez ComfyUI. Aucun pip install n'est nécessaire : les nœuds utilisent uniquement ce que ComfyUI fournit déjà.
cd ComfyUI/custom_nodes
git clone https://github.com/PedroMarinhoDev/ComfyUI-Drama3
Télécharger les poids
Les checkpoints vont dans models/diffusion_models, le codec dans models/vae, et les fichiers ASR et d'alignement dans models/asr :
hf download PedroMarinhoDev/Drama-3-ComfyUI drama3_fp8experts_bf16.safetensors --local-dir ComfyUI/models/diffusion_models
hf download PedroMarinhoDev/Drama-3-ComfyUI drama3_codec.safetensors --local-dir ComfyUI/models/vae
hf download PedroMarinhoDev/Qwen3-ASR-ComfyUI qwen3_asr_0.6b_bf16.safetensors --local-dir ComfyUI/models/asr
Lancer un flux de travail
Glissez un flux de travail d'exemple dans ComfyUI, choisissez quelques secondes de parole propre dans Load Audio, écrivez le texte dans Drama 3 Generate et lancez la file d'attente.
Disponibilité
Pack de nœuds : PedroMarinhoDev/ComfyUI-Drama3
Poids : PedroMarinhoDev/Drama-3-ComfyUI · PedroMarinhoDev/Qwen3-ASR-ComfyUI
Exemples : pedromarinhodev.github.io/ComfyUI-Drama3
Modèle de base : fishaudio/drama-3 · l'actualité Drama 3
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.