SMD : distillation en 4 pasos pour image, vidéo, 3D et H3
SMD est une recette de distillation par régression pour générer en 4 pas, avec des étudiants pour FLUX, Qwen-Image, Wan2.1, MiniMax H3 et la 3D, et des workflows ComfyUI pour H3.
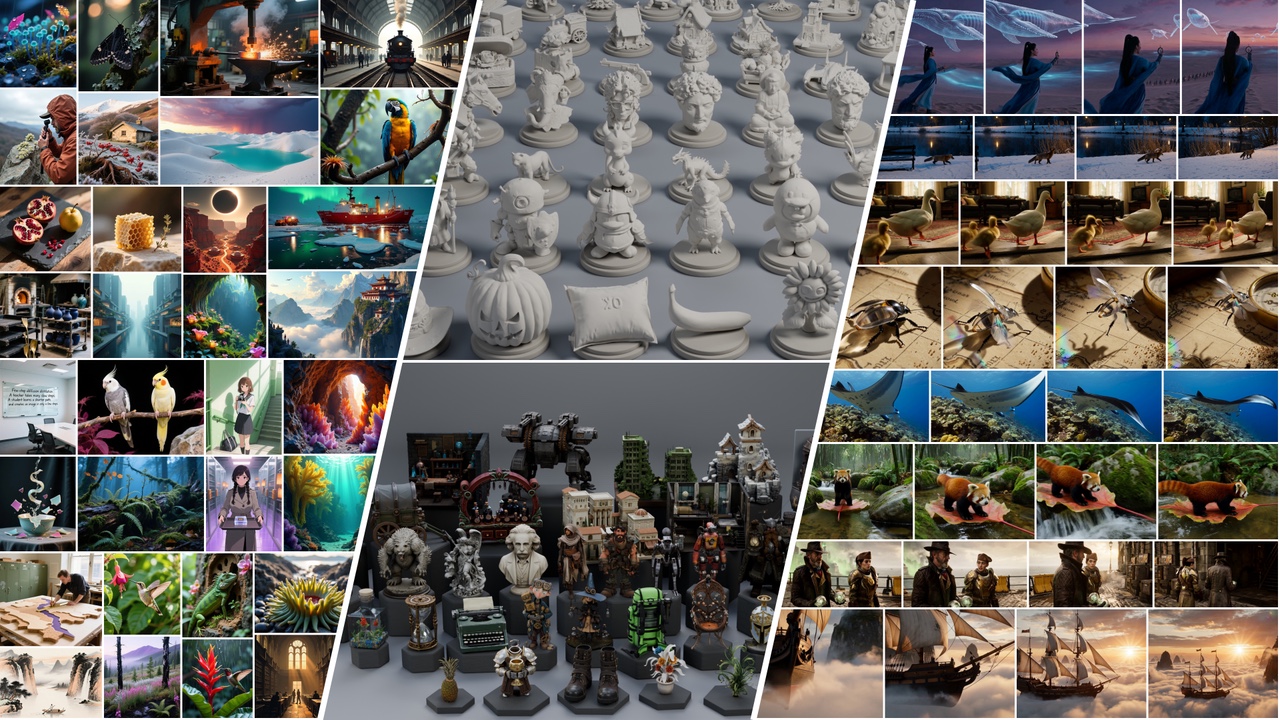
Sorties des étudiants SMD publiés : génération et édition d'images, ressources 3D, et vidéo avec audio synchronisé.
Ce que SMD change
SMD part d'une simple régression de vélocité on-policy : l'étudiant est entraîné sur sa propre trajectoire plutôt que sur des échantillons du professeur. Deux ajouts portent le reste de la méthode. Pivot est un proxy résiduel utilisé uniquement à l'entraînement, qui garde les corrections locales qu'un professeur applique à l'intérieur d'une transition grossière distinctes de la prédiction de moyenne d'intervalle de l'étudiant, afin qu'un étudiant à 4 étapes puisse exprimer une variation de vélocité du professeur qu'il ne pourrait pas représenter seul. Le second est un terme de répulsion qui éloigne l'étudiant des prédictions plus faibles du professeur, ce que l'article décrit comme un moyen léger d'éviter les modes indésirables.
Rien n'est ajouté à l'inférence : pas d'estimation de score en ligne, pas de modèle de faux score, pas de discriminateur adversarial, et le générateur déployé conserve son architecture. C'est ce qui permet à la même méthode d'être livrée sous forme de LoRA au-dessus d'un checkpoint existant, ou de modèle de débruitage complet, dans la même publication. L'article rapporte une montée en échelle jusqu'à 33 milliards de paramètres et la prise en charge de la distillation inter-modèles, multi-professeurs et pour vidéo causale.
Ce qui a été publié
| Tâche | Étudiants | Format |
|---|---|---|
| Texte vers image | FLUX.1-dev, Qwen-Image, SD3.5-Medium, FLUX.2 Klein 4B, Lens | LoRA, SD3.5 en plus comme transformer complet |
| Édition d'image | Qwen-Image-Edit-2511 | LoRA |
| Texte vers vidéo | Wan2.1 1.3B, Wan2.1 14B, Wan2.1 1.3B causal | LoRA |
| Audio-vidéo | MiniMax H3 T2VA 4 étapes et 8 étapes, H3 Ref2VA 4 étapes et 8 étapes | Adaptateurs LoRA |
| Image vers 3D | Hunyuan3D-2.1 Shape, TRELLIS.2 shape et texture | LoRA par étape distillée |
Deux branches annexes dépassent la distillation à professeur unique. FLUX.2 9B sert de professeur à la fois pour Klein 4B et Lens, et SD3.5-Medium existe en six variantes, self, clipscore, geneval, ocr, pickscore et multi, où chaque spécialiste optimise une récompense différente.
Chaque référentiel de la collection contient les poids ainsi qu'un exemple détaillé avec son prompt ou ses entrées de référence, sa graine et ses paramètres d'échantillonnage. Les paquets LoRA nécessitent le modèle de base et la révision correspondants, et un transformer complet tire toujours ses encodeurs et décodeurs de la base.
Exemples à travers la publication
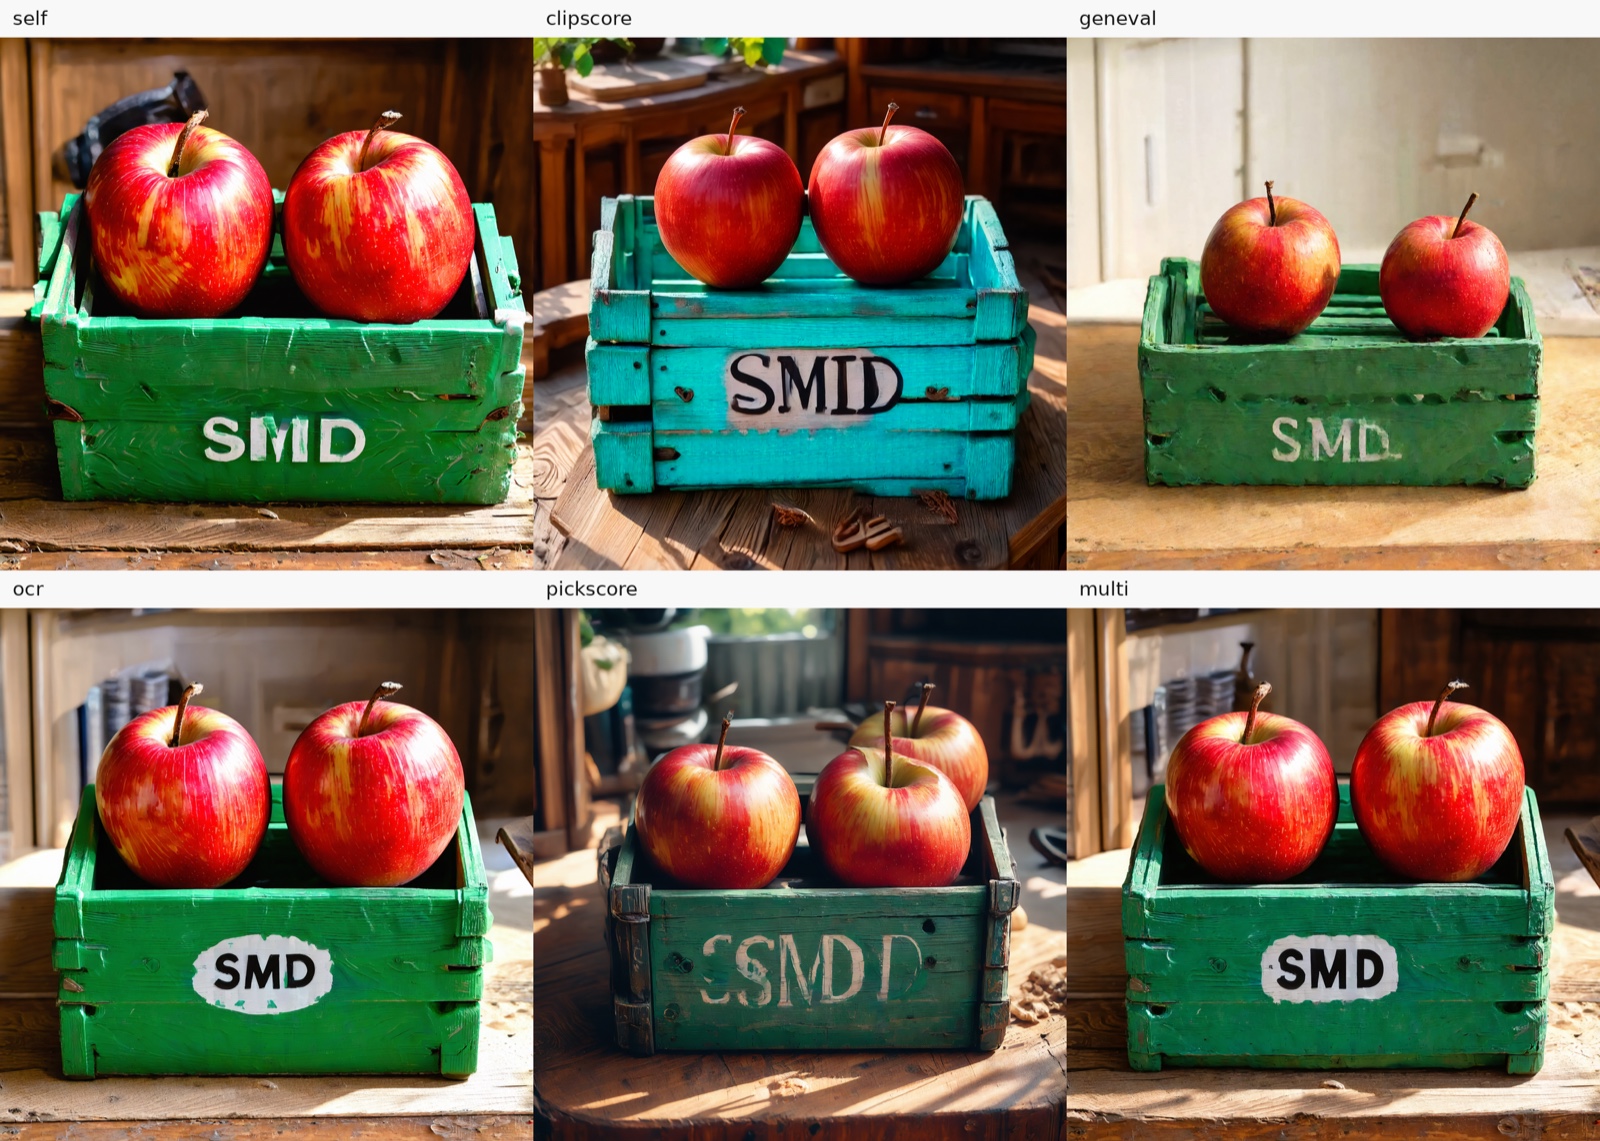
Les six étudiants SD3.5-Medium comparés côte à côte, y compris la variante multi-professeurs multi.
Les étudiants image utilisent chacun quatre étapes d'échantillonnage, et les fiches de modèle indiquent les paramètres qui les ont produits : un tote bag en toile pour FLUX.1-dev, un thé de l'après-midi pour Qwen-Image, une paire source et éditée pour Qwen-Image-Edit-2511, et des comparaisons à deux professeurs pour FLUX.2 Klein 4B et Lens. Le volet vidéo tourne à quatre étapes sur Wan2.1 14B et sur le modèle causal 1.3B, et le volet 3D livre des LoRA à quatre étapes pour Hunyuan3D-2.1 Shape et pour les deux étapes de TRELLIS.2, avec une vidéo de plateau tournant pour chacun.
MiniMax H3 dans ComfyUI
Les quatre étudiants H3 disposent de leurs propres paquets qui fonctionnent sur les nœuds ComfyUI standard, sans pack de nœuds personnalisé et sans cloner le référentiel d'entraînement SMD :
| Paquet | Étapes | Clip d'exemple |
|---|---|---|
| SMD-MiniMax-H3-T2VA-4step-ComfyUI | 4 | texte vers audio-vidéo |
| SMD-MiniMax-H3-T2VA-8step-ComfyUI | 8 | texte vers audio-vidéo |
| SMD-MiniMax-H3-Ref2VA-4step-ComfyUI | 4 | images de référence vers audio-vidéo |
| SMD-MiniMax-H3-Ref2VA-8step-ComfyUI | 8 | images de référence vers audio-vidéo |
Chaque paquet contient la LoRA convertie, un flux de travail complet et les entrées d'exemple. Son download_models.py vérifie les fichiers de modèle, copie les entrées d'exemple et ajoute le flux de travail à la bibliothèque utilisateur par défaut de ComfyUI, de sorte qu'il apparaît sous SMD dans la barre latérale Workflows ; le JSON du flux de travail peut aussi être glissé sur la toile. Les graphes conditionnés par référence utilisent UNETLoader, LoraLoaderModelOnly, MiniMaxH3SigmaShift, MiniMaxH3ReferenceToVideo et ManualSigmas : c'est donc la LoRA qui fait le travail et le programme d'échantillonnage vient du paquet. Passer de 4 à 8 étapes revient à ouvrir le flux de travail et la LoRA du paquet correspondant.
Une séquence H3 de référence vers audio-vidéo de cinq secondes issue du paquet Ref2VA à 4 étapes, générée avec les deux images de référence fournies dans le référentiel.
Les paquets avertissent d'un piège : substituer les poids H3 dans le template d'image par défaut de ComfyUI peut échouer avec une erreur audio_scale manquante, il faut donc plutôt utiliser le flux de travail complet fourni par le paquet.
Entraîner votre propre étudiant
Le code d'entraînement se trouve dans le même référentiel que les exemples d'inférence. Il s'exécute sous Linux x86_64 avec Conda : environments/setup_conda.sh construit un environnement avec Python 3.12, PyTorch 2.7.1 et les wheels CUDA 12.6, et FlashAttention est compilé depuis les sources. Une exécution est un appel torchrun vers l'une des configurations d'entraînement avec un chemin de données, par exemple deux GPU avec un fichier Parquet contenant une colonne prompt pour Qwen-Image, et --download-resources récupère ce dont la configuration a besoin.
L'entraînement s'appuie sur NVIDIA FastGen pour l'infrastructure d'entraînement et utilise les implémentations de modèles de Hugging Face Diffusers ; le chemin d'exportation H3 écrit un adaptateur LoRA avec ses métadonnées d'échantillonnage, donc aucun checkpoint de base fusionné n'est nécessaire. Le référentiel fournit aussi des compétences d'agent pour la configuration de l'environnement, l'entraînement et l'inférence, ainsi que pour l'intégration d'un nouveau modèle.
Limites
- Les nombres d'étapes et les affirmations de qualité sont ceux des auteurs : à 4 NFE, SMD surpasserait de solides baselines few-step et dépasserait les professeurs multi-étapes sur plusieurs benchmarks. Ces chiffres viennent de l'article, pas d'une reproduction indépendante réalisée ici.
- Les étudiants distillés sont liés aux révisions de base et aux paramètres d'échantillonnage de leur propre paquet. Les étudiants H3, en particulier, sont des adaptateurs LoRA avec des conditions mises en cache.
- Le référentiel d'entraînement cible Linux avec Conda et un pilote NVIDIA compatible CUDA 12.6 ; les étapes 3D nécessitent un second environnement.
- Parmi les étudiants publiés, les deux paquets H3 conditionnés par référence totalisent le plus de téléchargements à ce jour (environ 1 500 et 1 200 au moment de la rédaction), tandis que les référentiels image et 3D restent à un ou deux chiffres.
Disponibilité
Code : zjwfufu/SMD
Page du projet : zjwfufu.github.io/SMD-Page
Article : arXiv 2610.18472
Poids : Collection Hugging Face
Jeux de données : zjwfufu/smd-data
Paquets H3 : T2VA 4 étapes · T2VA 8 étapes · Ref2VA 4 étapes · Ref2VA 8 étapes
Modèle de base : MiniMax H3
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.