Spark-H3 : l'attention creuse accélère MiniMax-H3 dans ComfyUI
Spark-H3 apporte l'attention creuse par blocs Spark-Attn à MiniMax-H3 dans ComfyUI, avec des nœuds pour les séries RTX 40 et 50 et un DiT 1.73x plus rapide à 10 % de densité.
Extrait du référentiel du projet : la même invite, la même graine et le même planning rendus avec l'attention dense, Spark-H3 à 10 % de densité et Sol-H3.
Ce que change Spark-Attn
L'attention creuse par blocs divise une passe d'attention vidéo en deux branches : une branche exacte qui calcule intégralement les blocs clé/valeur les mieux classés, et une branche compressée qui couvre tout le reste à moindre coût. Spark-Attn remanie ces deux moitiés, et Spark-H3 en est l'implémentation pour MiniMax-H3. Le blog technique a été publié le 2026-09-23 et sa dernière mise à jour date du 2026-10-08.
- Spark-Reblock remplace les tuiles spatio-temporelles fixes par une partition adaptative. Deux requêtes sont considérées comme similaires lorsqu'elles produisent des schémas de scores d'attention similaires sur les clés, mesurés par une distance cosinus de Mahalanobis induite par le second moment du côté opposé. Un partitionneur hiérarchique continue de subdiviser les groupes jusqu'à ce que chaque feuille contienne la taille de bloc cible, en temps
O(N log N), de sorte que la disposition des blocs suit l'entrée, la couche et la tête plutôt qu'un voisinage fixe. - Spark-Reweight remplace le résumé clé/valeur issu du mean pooling de la branche compressée par des résumés pondérés accompagnés d'un biais de masse logarithmique. Le mean pooling sous-estime la masse d'attention, car l'attention exponentie les logits avant de normaliser : il substitue
exp(E[x])àE[exp(x)]. Le biais rétablit la masse manquante, et le scoring utilise la moyenne des requêtes vidéo comme point d'ancrage unique par tête, de sorte que le coût supplémentaire reste linéaire.
Les deux parties sont mesurées séparément, avec un budget Top-K de 10 % :
| Ablation | Rappel de masse d'attention | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| Partition en blocs fixe | 68.66% | 18.61 | 0.68 | 0.26 |
| + Spark-Reblock | 81.54% | 22.41 | 0.80 | 0.14 |
Et pour la branche compressée :
| Ablation | Erreur absolue de masse logarithmique (nats) | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| Mean pooling | 3.86 | 18.61 | 0.68 | 0.26 |
| + Spark-Reweight | 2.78 | 19.17 | 0.70 | 0.24 |
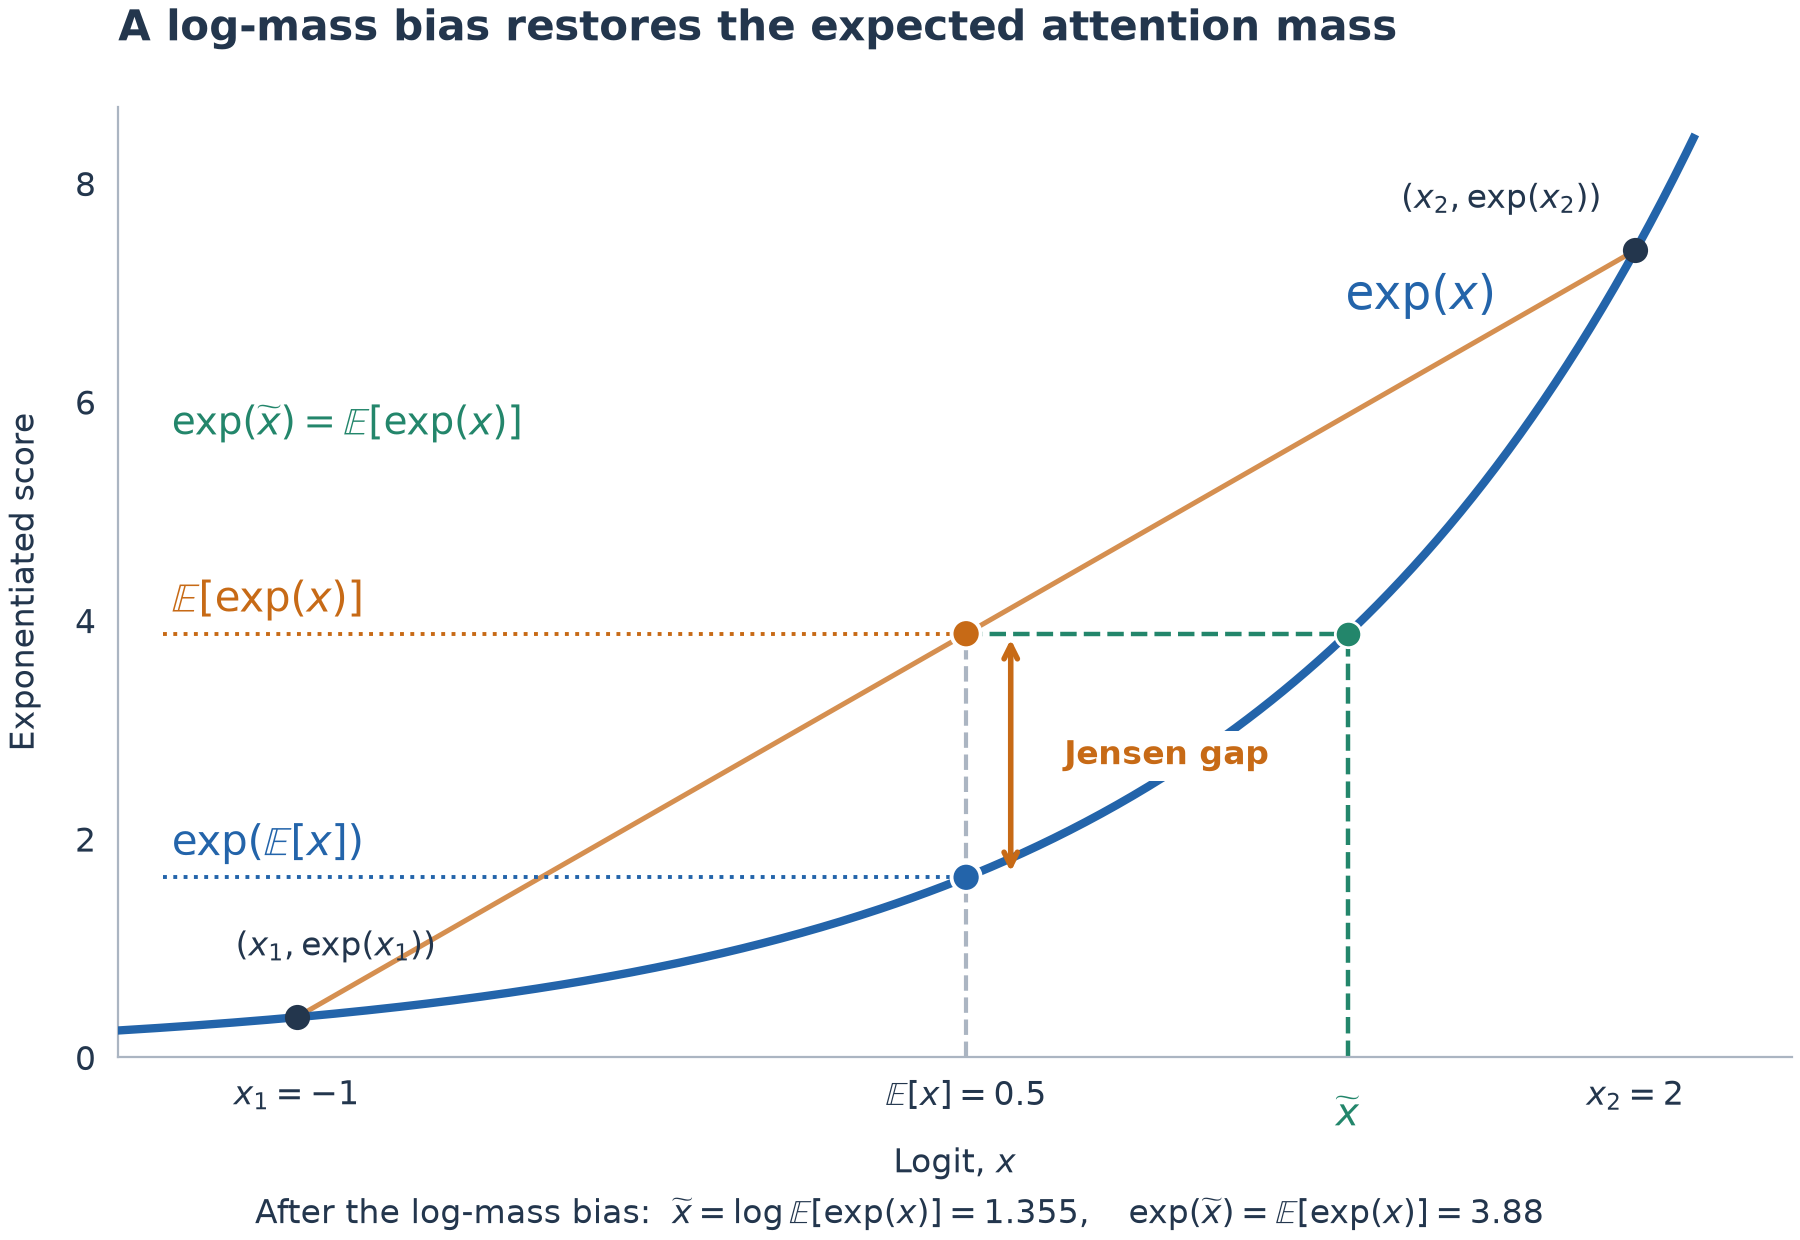
Le mean pooling produit exp(E[x]), en bleu, en dessous de l'exponentielle attendue E[exp(x)], en orange. Le point vert est le logit mutualisé effectif après l'application du biais de masse logarithmique, dont l'exponentielle correspond à l'exponentielle attendue.
Benchmarks
Les chiffres en comparaison directe utilisent des invites VBench en 1344x768, 240 images à 24 fps et un planning MiniMax-H3 en 19 étapes sur une seule RTX PRO 6000 Blackwell. Toutes les méthodes creuses présentées ici partagent un échauffement dense de 20 %, conservent la première couche Transformer en dense du début à la fin, et sont comparées aux sorties denses issues des mêmes invites et graines.
| Méthode | Densité | Latence DiT | Accélération DiT | PSNR | SSIM | LPIPS | Accélération ATTN |
|---|---|---|---|---|---|---|---|
| Dense | 100% | 583.3 s | 1.00x | référence | 1.00 | 0.00 | 1.00x |
| Sol-H3 | dynamique | 355.4 s | 1.64x | 20.36 | 0.71 | 0.20 | 2.19x |
| Spark-H3, Speed | 10% | 337.4 s | 1.73x | 23.30 | 0.80 | 0.14 | 2.33x |
| Spark-H3, Balanced | 20% | 371.1 s | 1.57x | 25.38 | 0.85 | 0.09 | 1.96x |
| Spark-H3, Fidelity | 30% | 404.1 s | 1.44x | 27.07 | 0.88 | 0.07 | 1.76x |
| Spark-H3-Lite, Speed | 10% | 330.2 s | 1.77x | 23.34 | 0.80 | 0.14 | n/d |
À 10 % de densité, Spark-H3 gagne 2.94 dB de PSNR sur Sol-H3 tout en étant légèrement plus rapide, et augmenter la densité échange de façon monotone de la vitesse contre de la fidélité. Spark-H3-Lite est une variante moins coûteuse qui divise par deux la latence de reblocking, au prix d'une légère perte de fidélité à 20 % et 30 %. Sur les dimensions VBench, toutes les variantes de Spark-H3 restent à environ 0.3 point du dense pour la cohérence du sujet et de l'arrière-plan, la fluidité du mouvement, la qualité d'image et la qualité esthétique.
Les nœuds ComfyUI
Le paquet ajoute deux nœuds d'attention à l'implémentation MiniMax-H3 propre à ComfyUI : MiniMax H3 Spark Attention (SM89) et MiniMax H3 Spark Attention (SM120). L'un d'eux se place sur le lien MODEL entre le chargeur de modèle et BasicGuider, et un seul correctif d'attention doit être appliqué par modèle. Tout le reste du graphique reste inchangé, ce qui permet de le cumuler avec les LoRA de la communauté utilisées dans les exemples.
| Prérequis | Valeur |
|---|---|
| ComfyUI | 0.38.x ou 0.39.x |
| Python | 3.12+ |
| PyTorch / CUDA | CUDA 13.0, BF16 |
| Système d'exploitation | Linux ou Windows x86_64 |
| SM89 | Série GeForce RTX 40 |
| SM120 | Série GeForce RTX 50, RTX PRO 5000 / 6000 Blackwell |
L'installateur choisit le backend correspondant à votre version de ComfyUI : comfy-kitchen 0.2.36 sur 0.38.x et 0.2.37 sur 0.39.x. La version v0.1.2 ajoute des paquets Windows vérifiés et met à jour les flux de travail fournis et la documentation d'installation ; CUDA 12.8 n'est accessible que via la compilation depuis les sources. Les fichiers de modèle proviennent toujours du référentiel MiniMax-H3 de Comfy-Org, et le guide ComfyUI renvoie également vers un guide d'installation en chinois.
De bout en bout dans ComfyUI, sur la même RTX PRO 6000 Blackwell, pour un clip de 14.4 secondes en 1344x768 :
| Variante | Dense | Fidelity (20 %, échauffement) | Speed (20 %, sans échauffement) |
|---|---|---|---|
| MiniMax-H3, 20 étapes | 1018.5 s | 461.7 s · 2.21x | 323.3 s · 3.15x |
| MiniMax-H3 + LightX2V 8 étapes | 408.0 s | 199.5 s · 2.05x | 129.6 s · 3.15x |
Attention Dense, Fidelity et Speed dans un même clip, généré avec le flux de travail MiniMax-H3 natif dans ComfyUI. L'invite provient du jeu d'invites de Video DeltaNet.
Flux de travail
Cinq flux de travail d'exemple accompagnent la version, et chacun fixe topk_mode=topk_ratio et reblock_layout=q_reuse_k. Les exemples natif, LightX2V, Larryvrh et DMAD utilisent topk_ratio=0.2 ; l'exemple LBH en deux passes utilise 0.1 pour correspondre au chemin h3_lbh de Diffusers.
| Exemple | Configuration |
|---|---|
| MiniMax-H3 natif | Exemple de base : 20 étapes, aucune LoRA, aucun nœud supplémentaire |
| LoRA LightX2V 8 étapes | Nécessite la LightX2V Turbo LoRA dans models/loras |
| LoRA Larryvrh 8 étapes | Nécessite la LoRA convertie, chargeable avec le LoraLoaderModelOnly propre à ComfyUI |
| LoRA DMAD 4 étapes | Utilise l'échantillonneur DMAD re-noise |
| LBH deux passes + LightX2V 4 étapes | Nécessite le nœud d'upscale LBH officiel et son modèle d'upscaler latent |
Le paquet n'installe jamais les LoRA supplémentaires en silence : elles restent dans models/loras et leur installation vous appartient. Un script de conversion pour les poids Larryvrh conserve 208 LoRA de backbone et projette 51 mises à jour AdaLN sur la courbe de pas de temps à huit dimensions du modèle élagué.
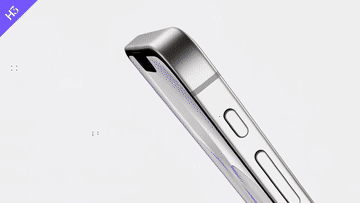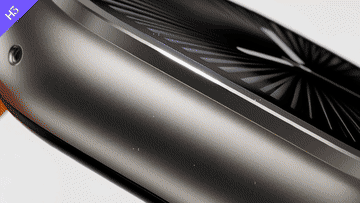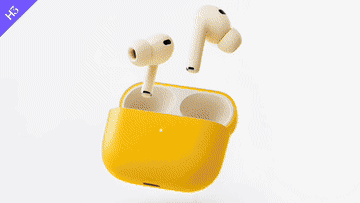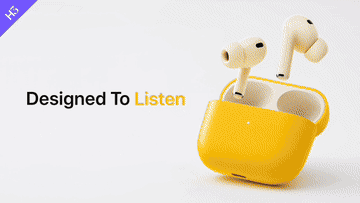
Une invite minimaliste de publicité produit rendue avec le backend Spark-H3, issue du jeu d'exemples du référentiel du projet.
Disponibilité
Spark-H3 se trouve sur github.com/zechengtang/Spark-H3, avec un miroir contenant uniquement le code sur Aazeus/Spark-H3 et l'article de présentation sur zechengtang.github.io/Spark-H3. Il s'agit d'un backend d'inférence et non d'un checkpoint : aucun poids de modèle n'est redistribué et Spark-H3 peut être combiné avec les LoRA H3 existantes. La feuille de route du projet indique la validation SM120 comme en cours, une version autonome sans la dépendance comfy-kitchen et des kernels pour SM90 et SM100 comme prévues, et le rapport technique comme pas encore publié. La première version ComfyUI est elle aussi récente, attendez-vous donc à ce que le packaging et les détails de routage continuent d'évoluer.
Si vous avez déjà essayé l'attention creuse Veda sur MiniMax-H3, le blog contient une discussion sur les différences entre Spark-Attn, Sol-Attn, Veda et l'attention creuse par blocs classique : Veda apprend un scoreur pour la sélection Top-K, Sol-Attn utilise un seuil adaptatif au contenu, et Spark-Attn modifie la disposition des blocs ainsi que le traitement des blocs non sélectionnés.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.