Qwen-Image-2.1-Turbo : le Turbo officiel en 8 étapes dans ComfyUI
Le checkpoint officiel Qwen-Image-2.1-Turbo d'Alibaba exécute le générateur et l'éditeur 7B en 8 étapes de denoising à CFG 1, avec les poids reconditionnés par Comfy-Org pour ComfyUI.
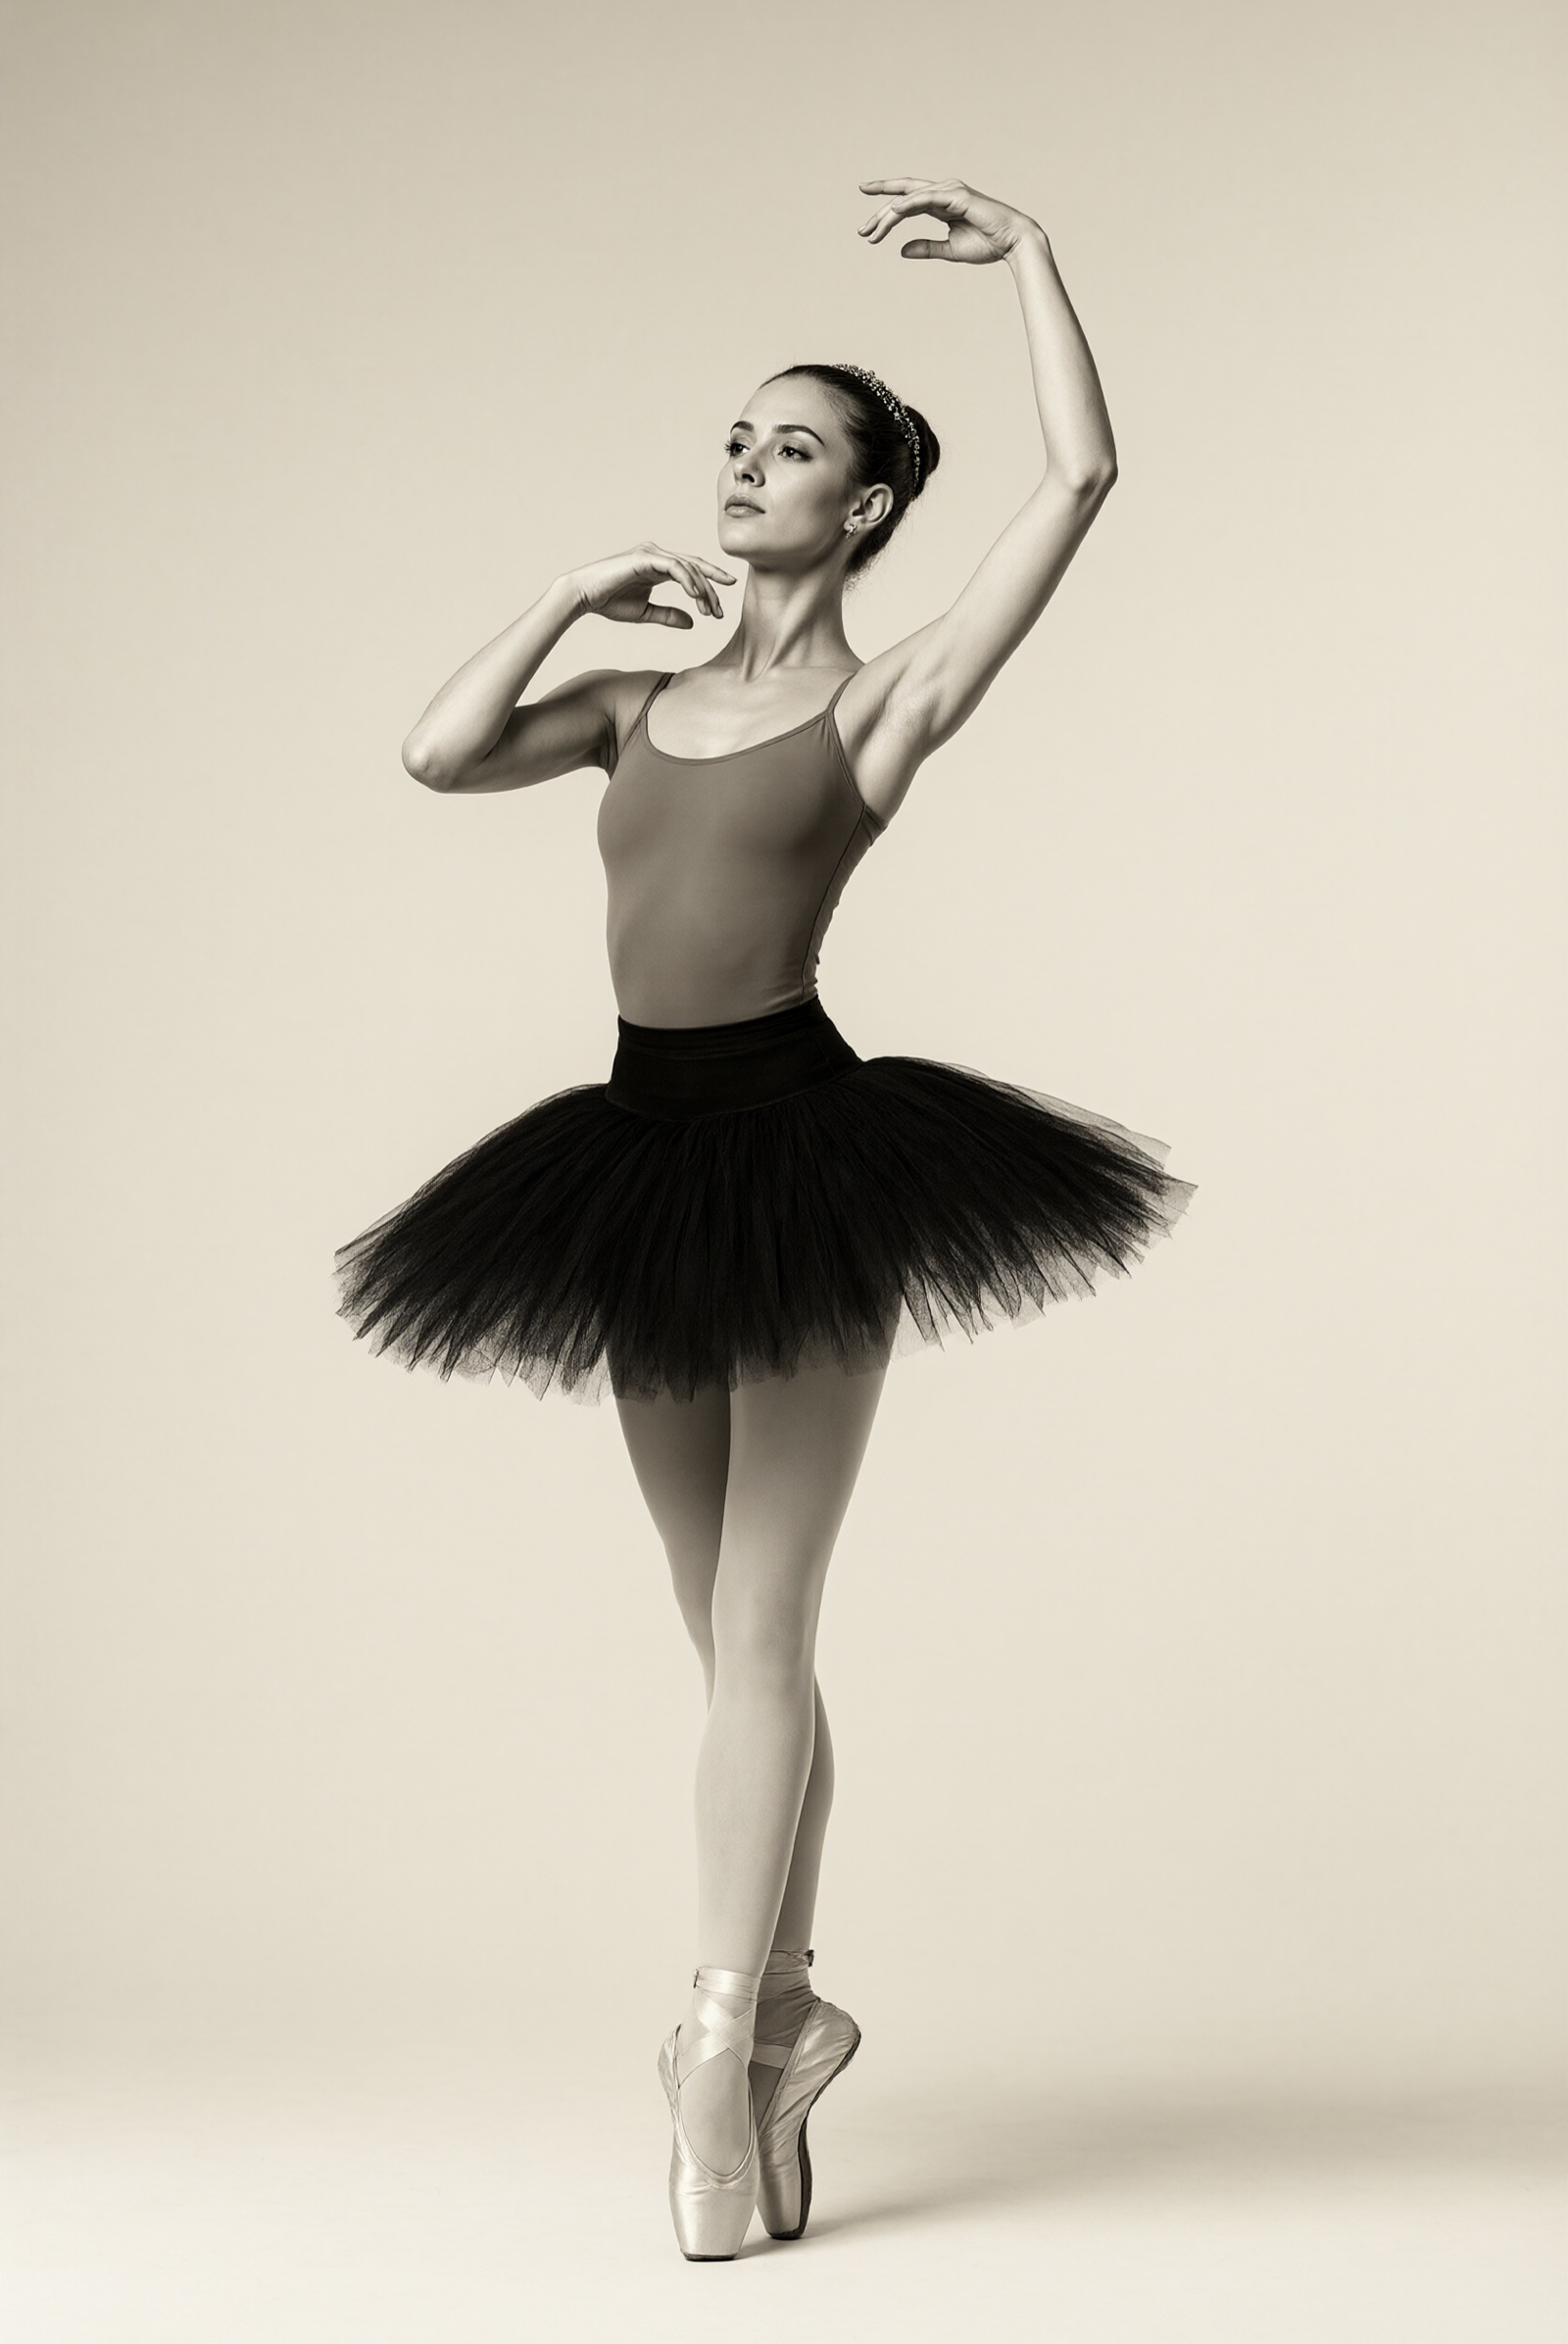
Poses humaines et mouvement, l'une des catégories en 8 étapes de la vitrine Turbo d'Alibaba.
Ce que change le checkpoint Turbo
Turbo n'est pas une nouvelle architecture. C'est un second checkpoint de Qwen-Image 2.1 avec son planning d'échantillonnage intégré, de sorte que les mêmes poids du transformer servent comme avant à la génération, à l'édition par instruction, à la transparence RGBA et à l'extraction de sujet. Les différences qui comptent lors de la mise en place :
- 8 étapes de denoising au lieu de 40. Le planning recommandé en 8 étapes est fourni dans le checkpoint. La carte du modèle précise explicitement que passer
num_inference_stepsseul ne le remplace pas, et que d'autres plannings n'ont pas été évalués pour ce checkpoint. - CFG 1 par défaut. Le classifier-free guidance est désactivé, chaque étape n'exécute donc qu'une seule passe avant.
- Le cache KV de préfixe réutilise le contexte du texte et des images de référence d'une étape de denoising à l'autre, ce que le pipeline active avec
use_kv_cache=True. - Les mêmes préréglages de résolution que le modèle de base, de 2048x2048 (1:1) jusqu'à 2752x1536 (16:9) et les ratios portrait correspondants.
- Basé sur diffusers pour l'instant. Il se charge avec
QwenImage21Pipelineet nécessite une version de diffusers prenant en charge les sigmas d'échantillonnage configurés par le pipeline.
Le planning enregistré est 1.0, 0.978453, 0.95418, 0.926626, 0.89508, 0.845148, 0.704534, 0.414568, se terminant sur une étape 0 vide. Dans le canal #qwen-image de Banodoco, Kijai a noté qu'il est proche du scheduler linear_quadratic de ComfyUI sans shift appliqué, et qu'il n'a jamais vu un planning Euler fixe battre un échantillonneur stochastique sur les checkpoints turbo en général.
Démonstration
La carte du modèle regroupe ses sorties en 8 étapes selon ce que les gens demandent réellement au modèle. La photographie de portrait et la typographie d'affiche sortent du même checkpoint que les cas d'édition :
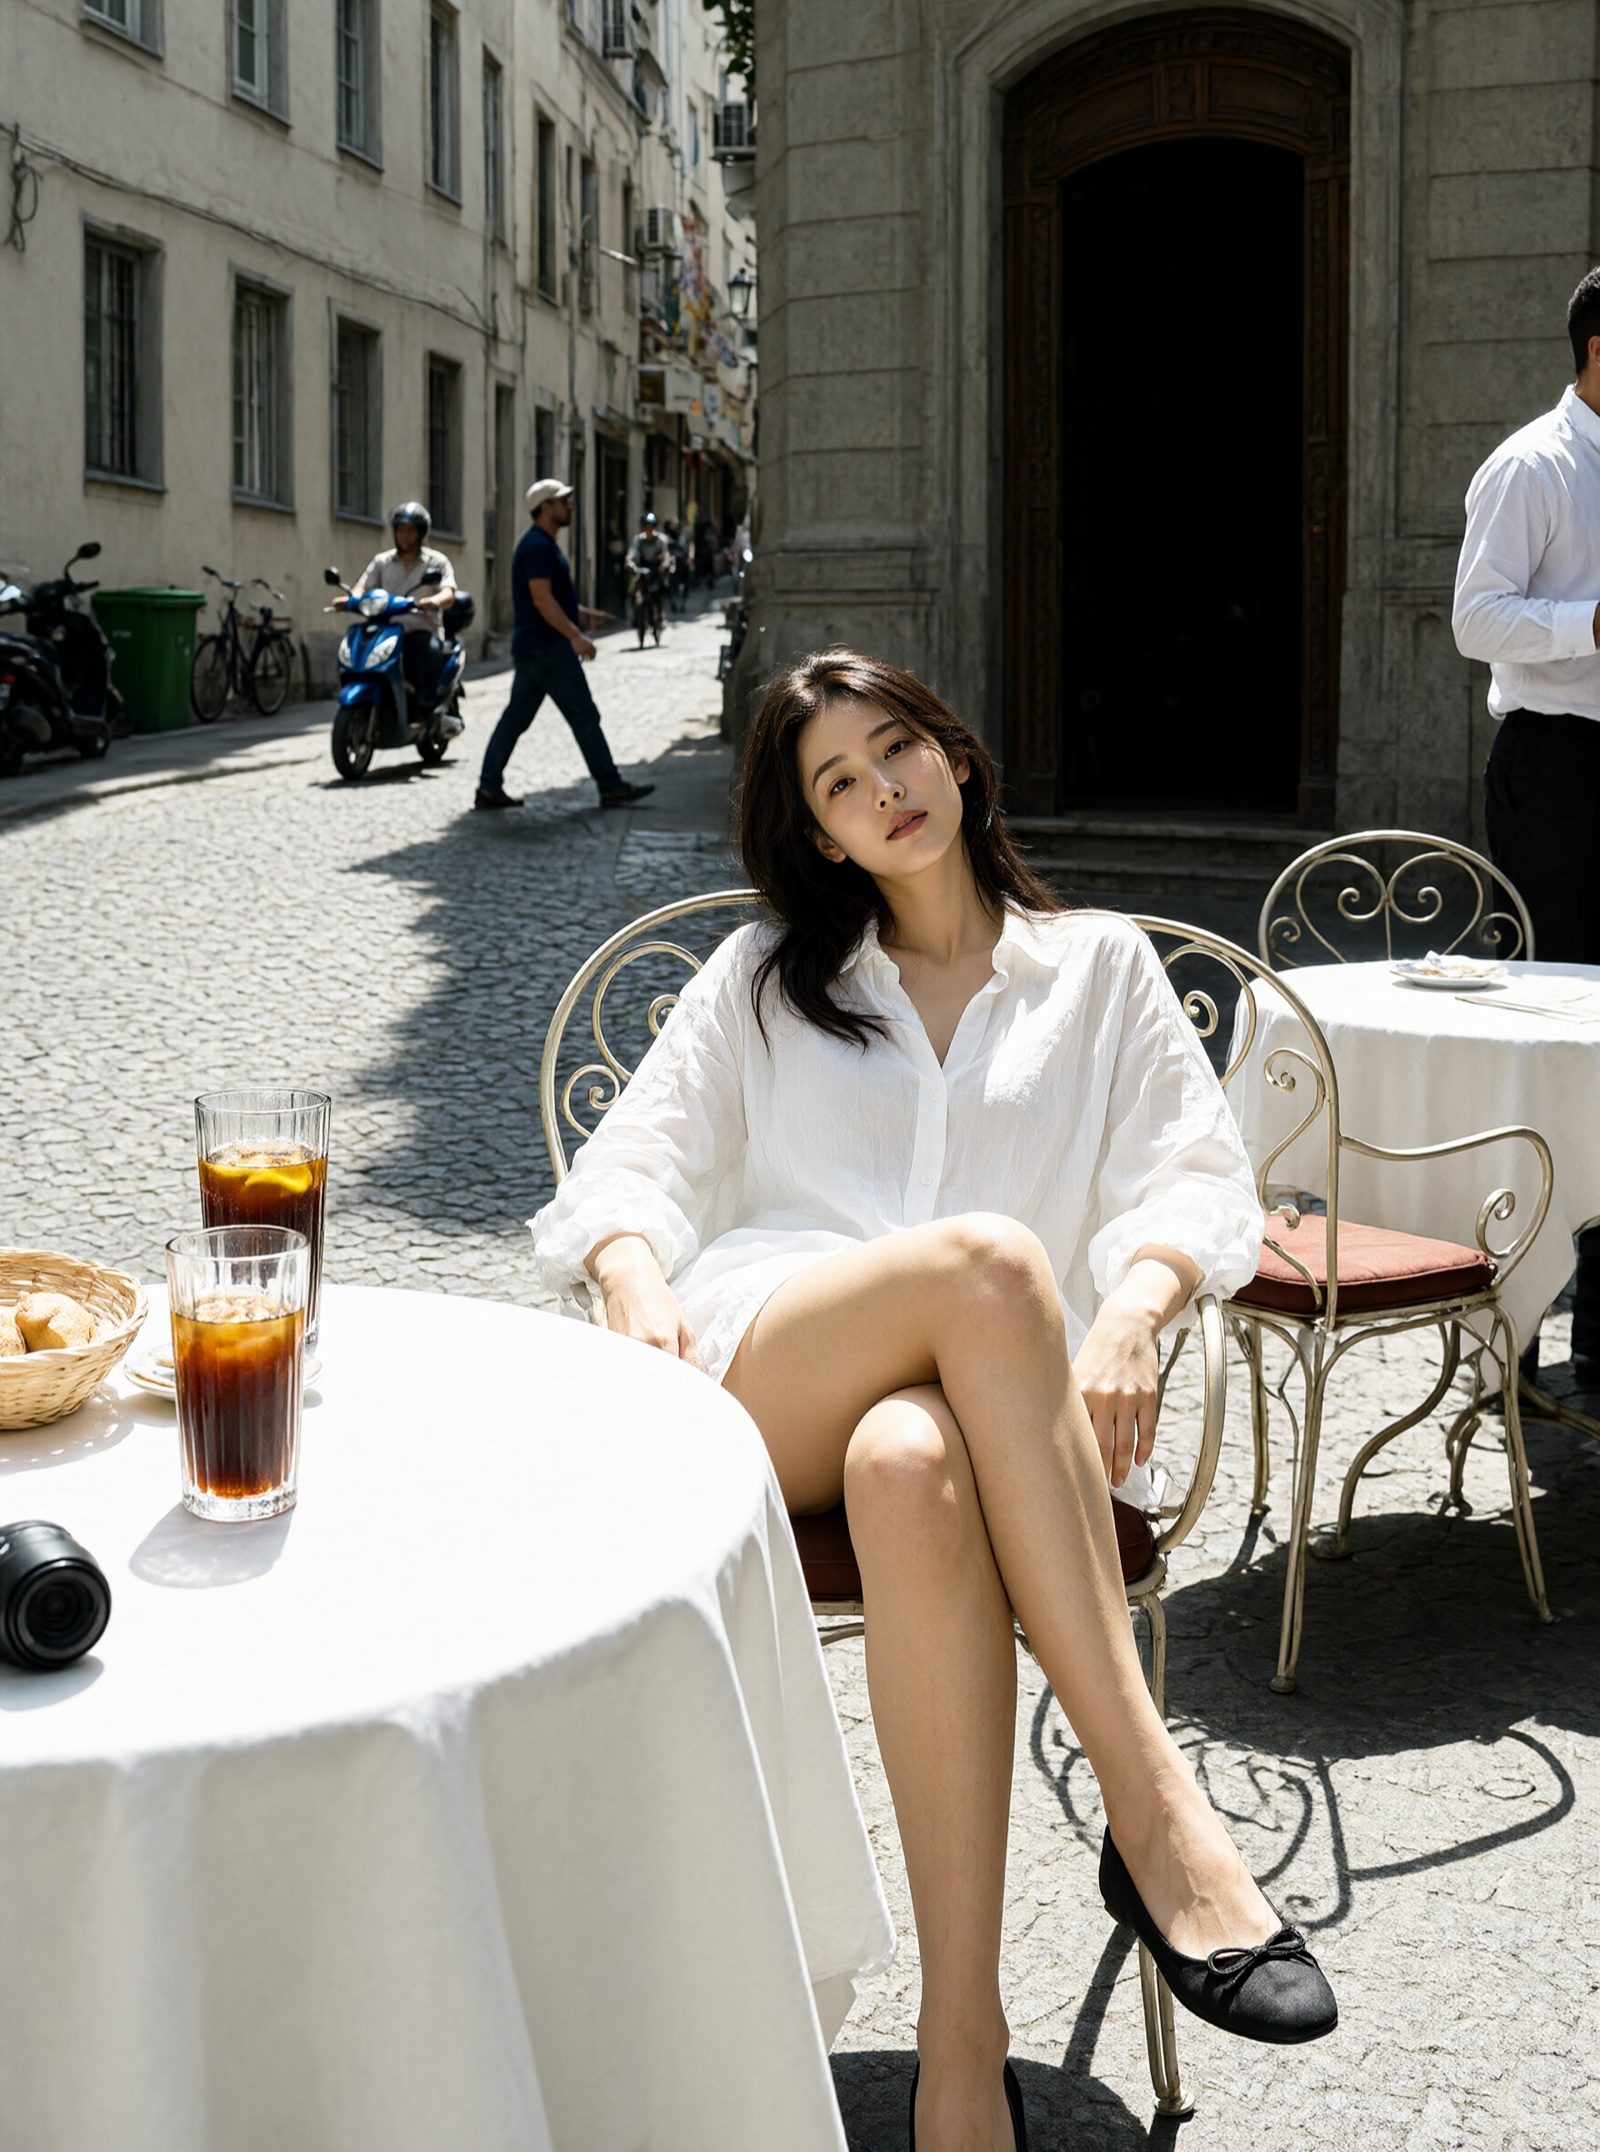
Un portrait, généré en 8 étapes à 1680x2512.
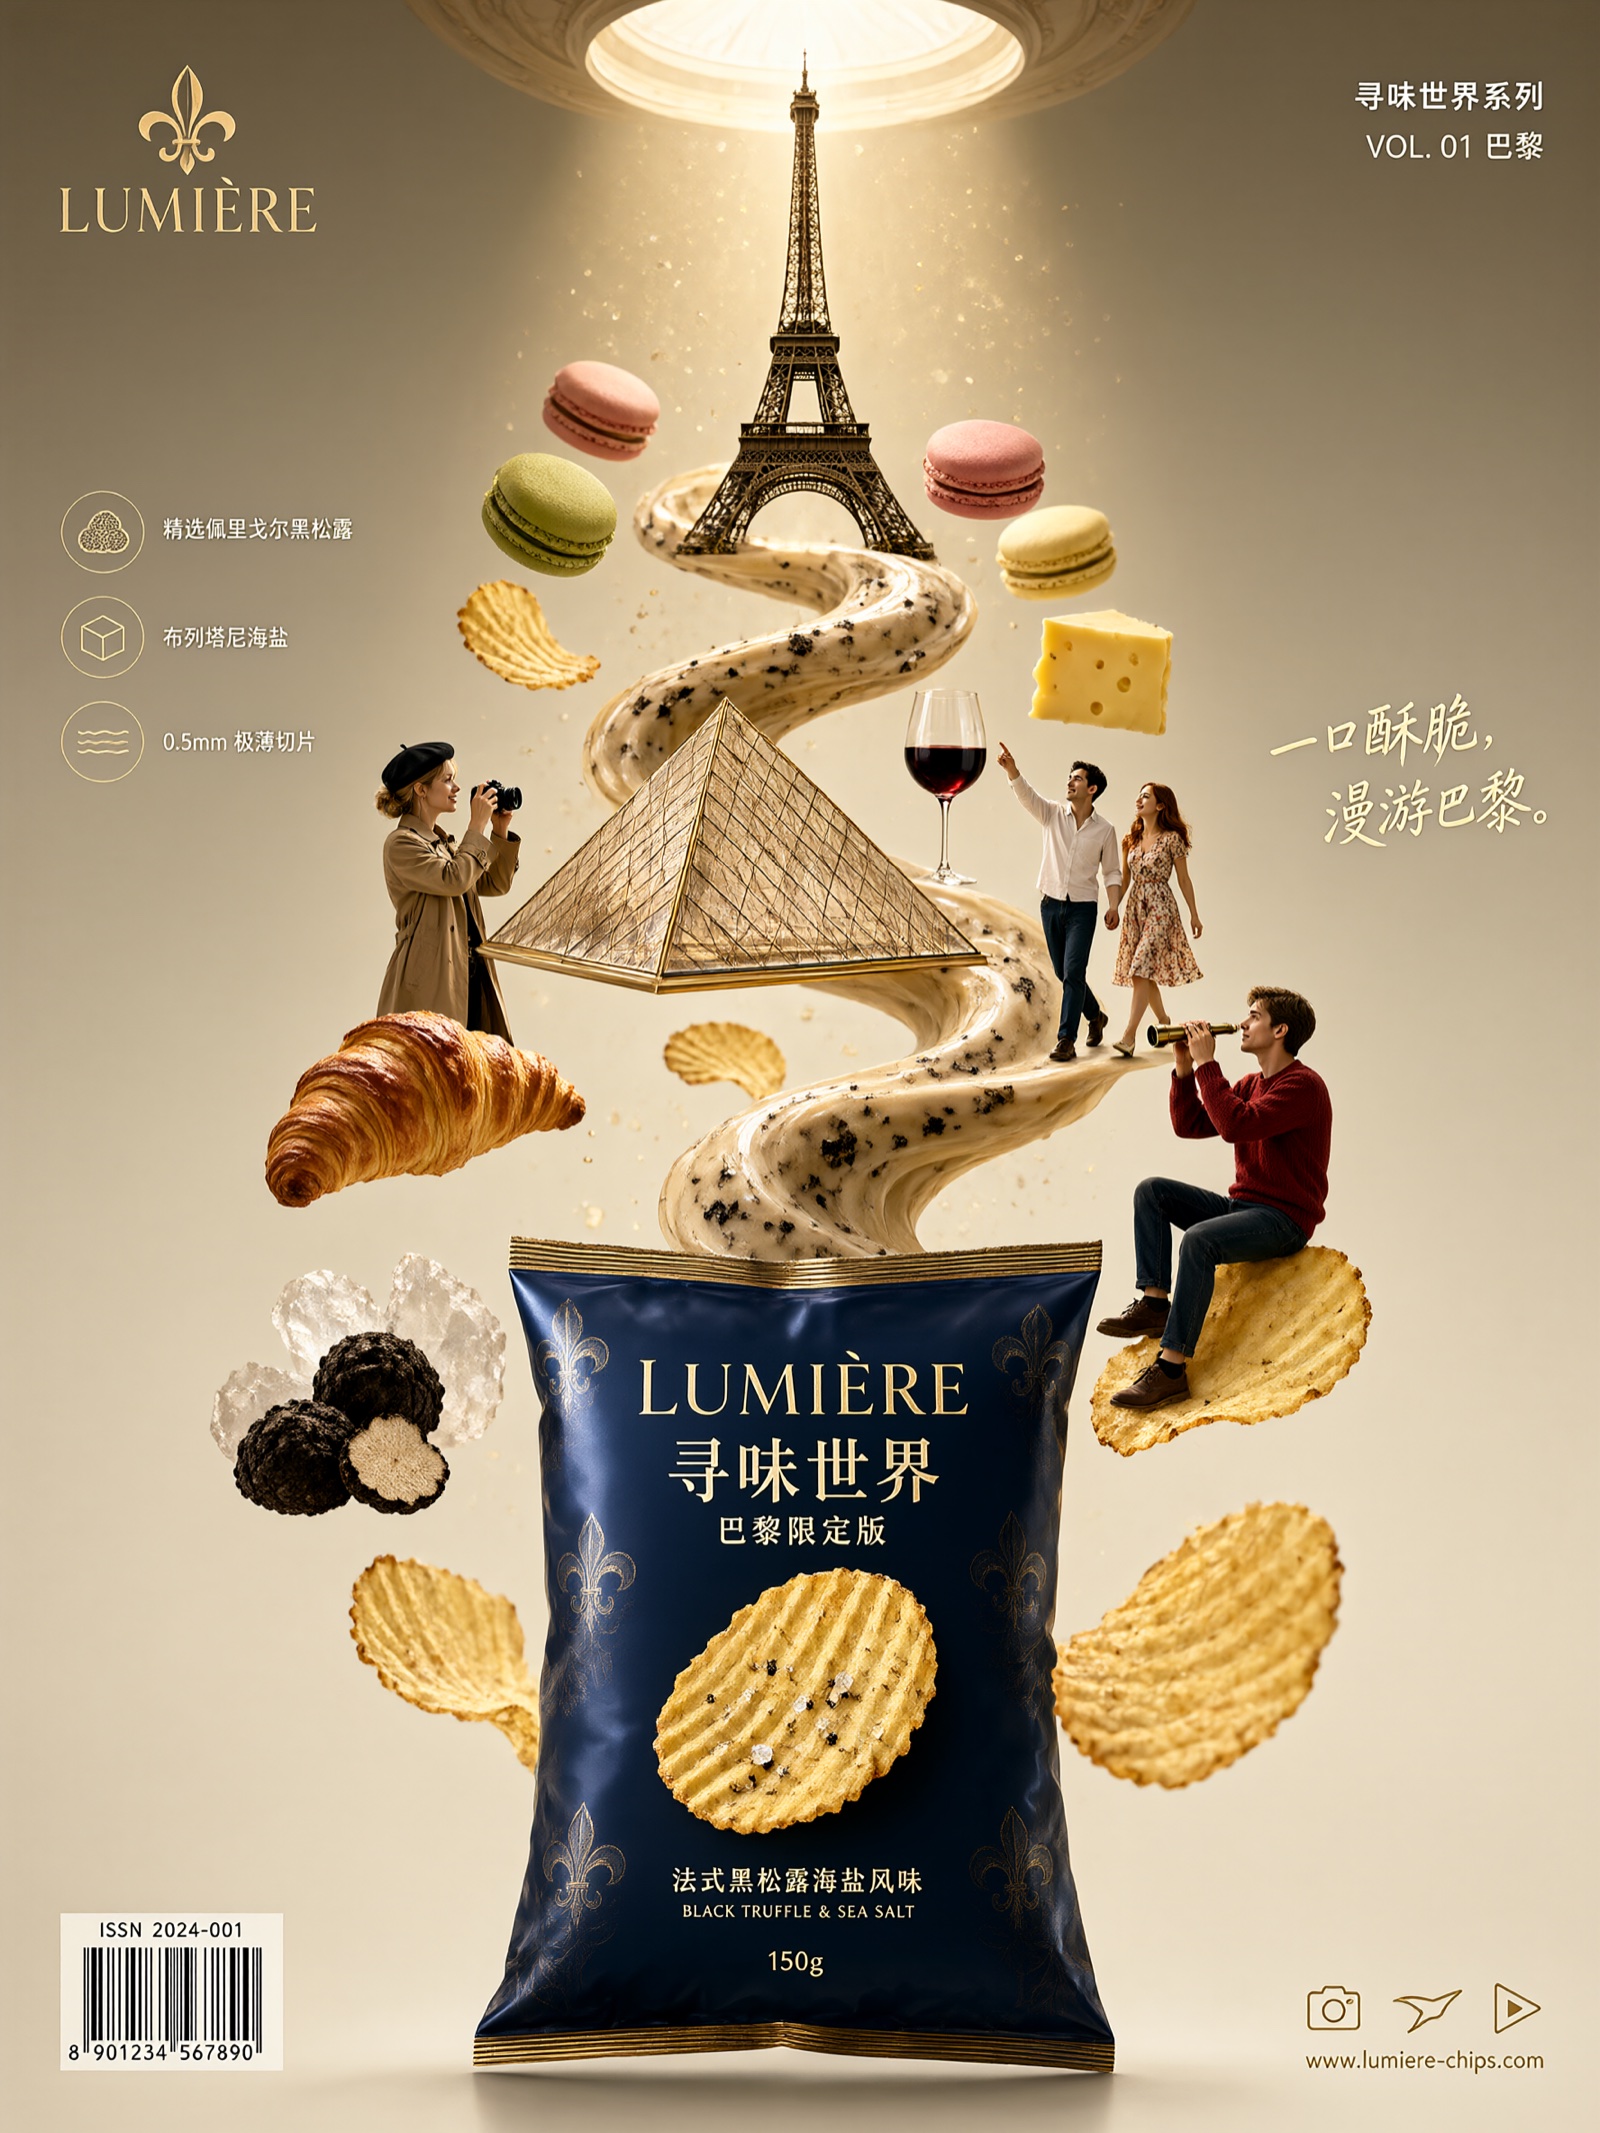
Typographie et design d'affiche, une catégorie qui nécessitait auparavant la totalité des 40 étapes.
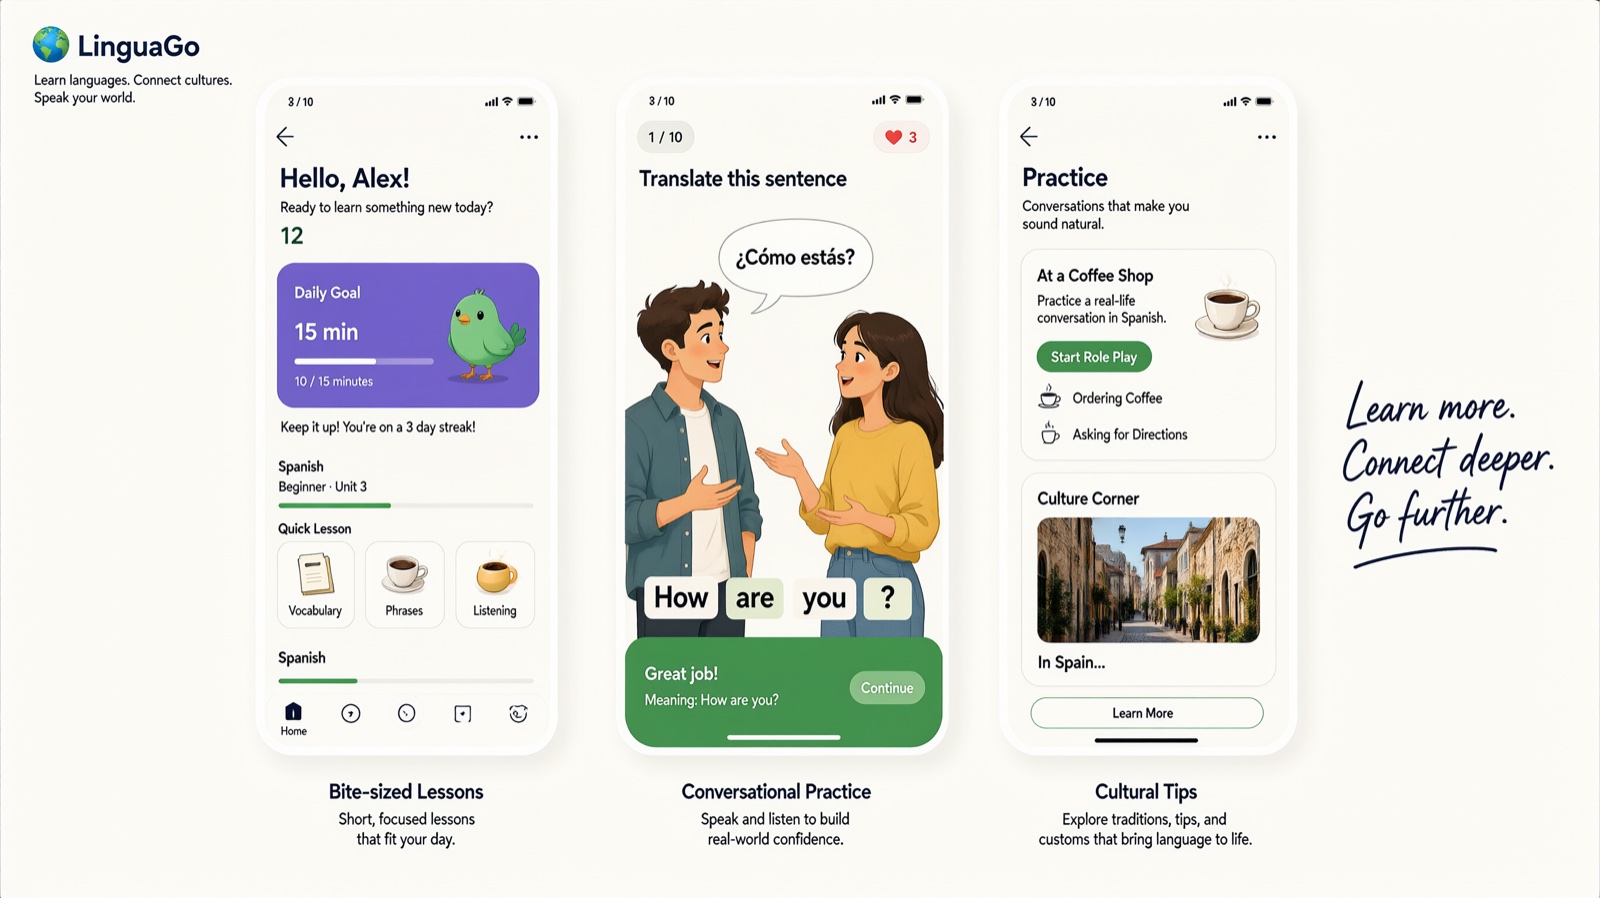
Interface et mise en page d'informations, l'un des cas de sortie structurée les plus difficiles.
La transparence survit à l'accélération : le canal alpha est écrit par le modèle, les stickers et les ressources produit sortent donc toujours prêts à être composités.
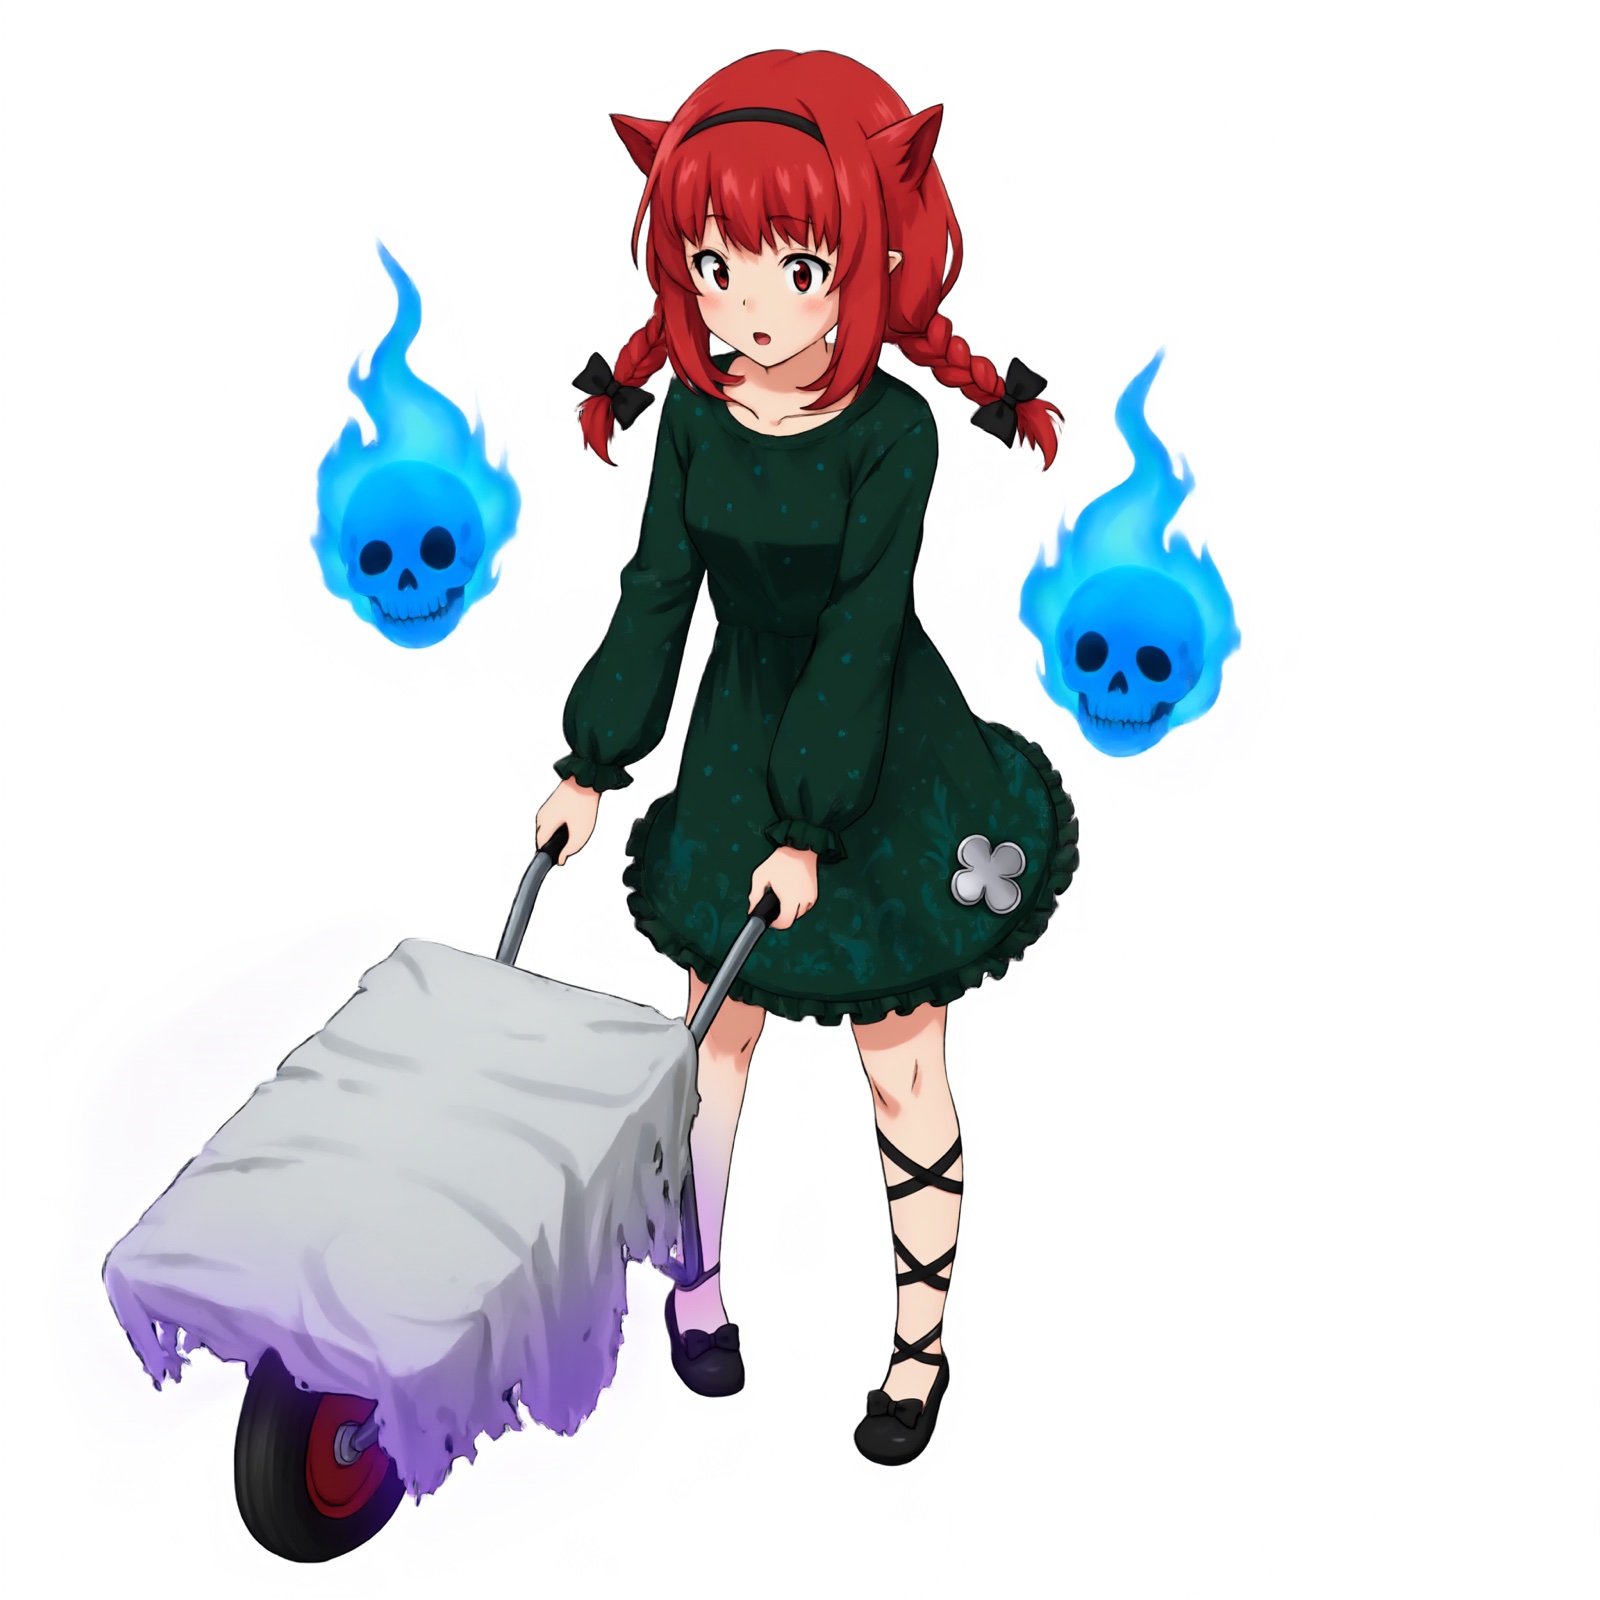
Génération d'images transparentes avec le checkpoint Turbo.
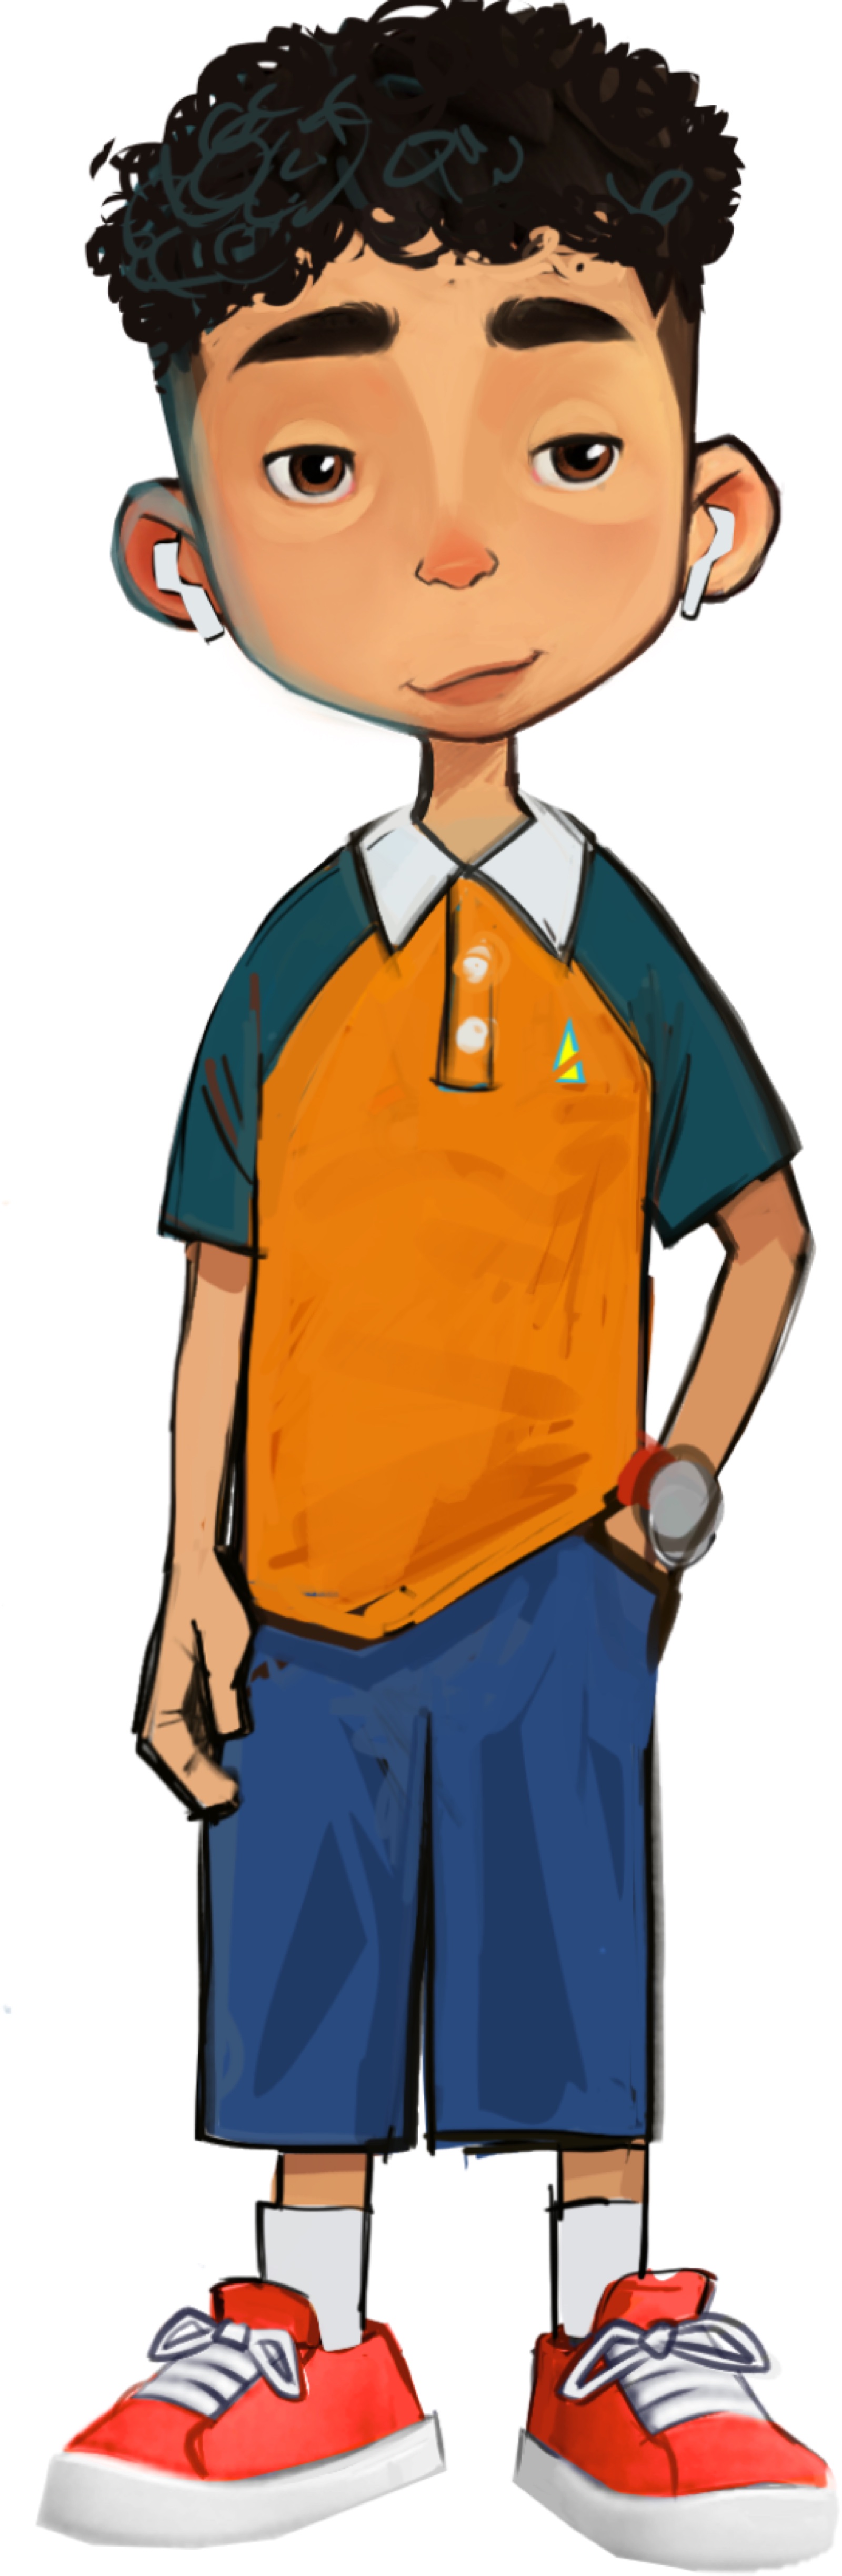
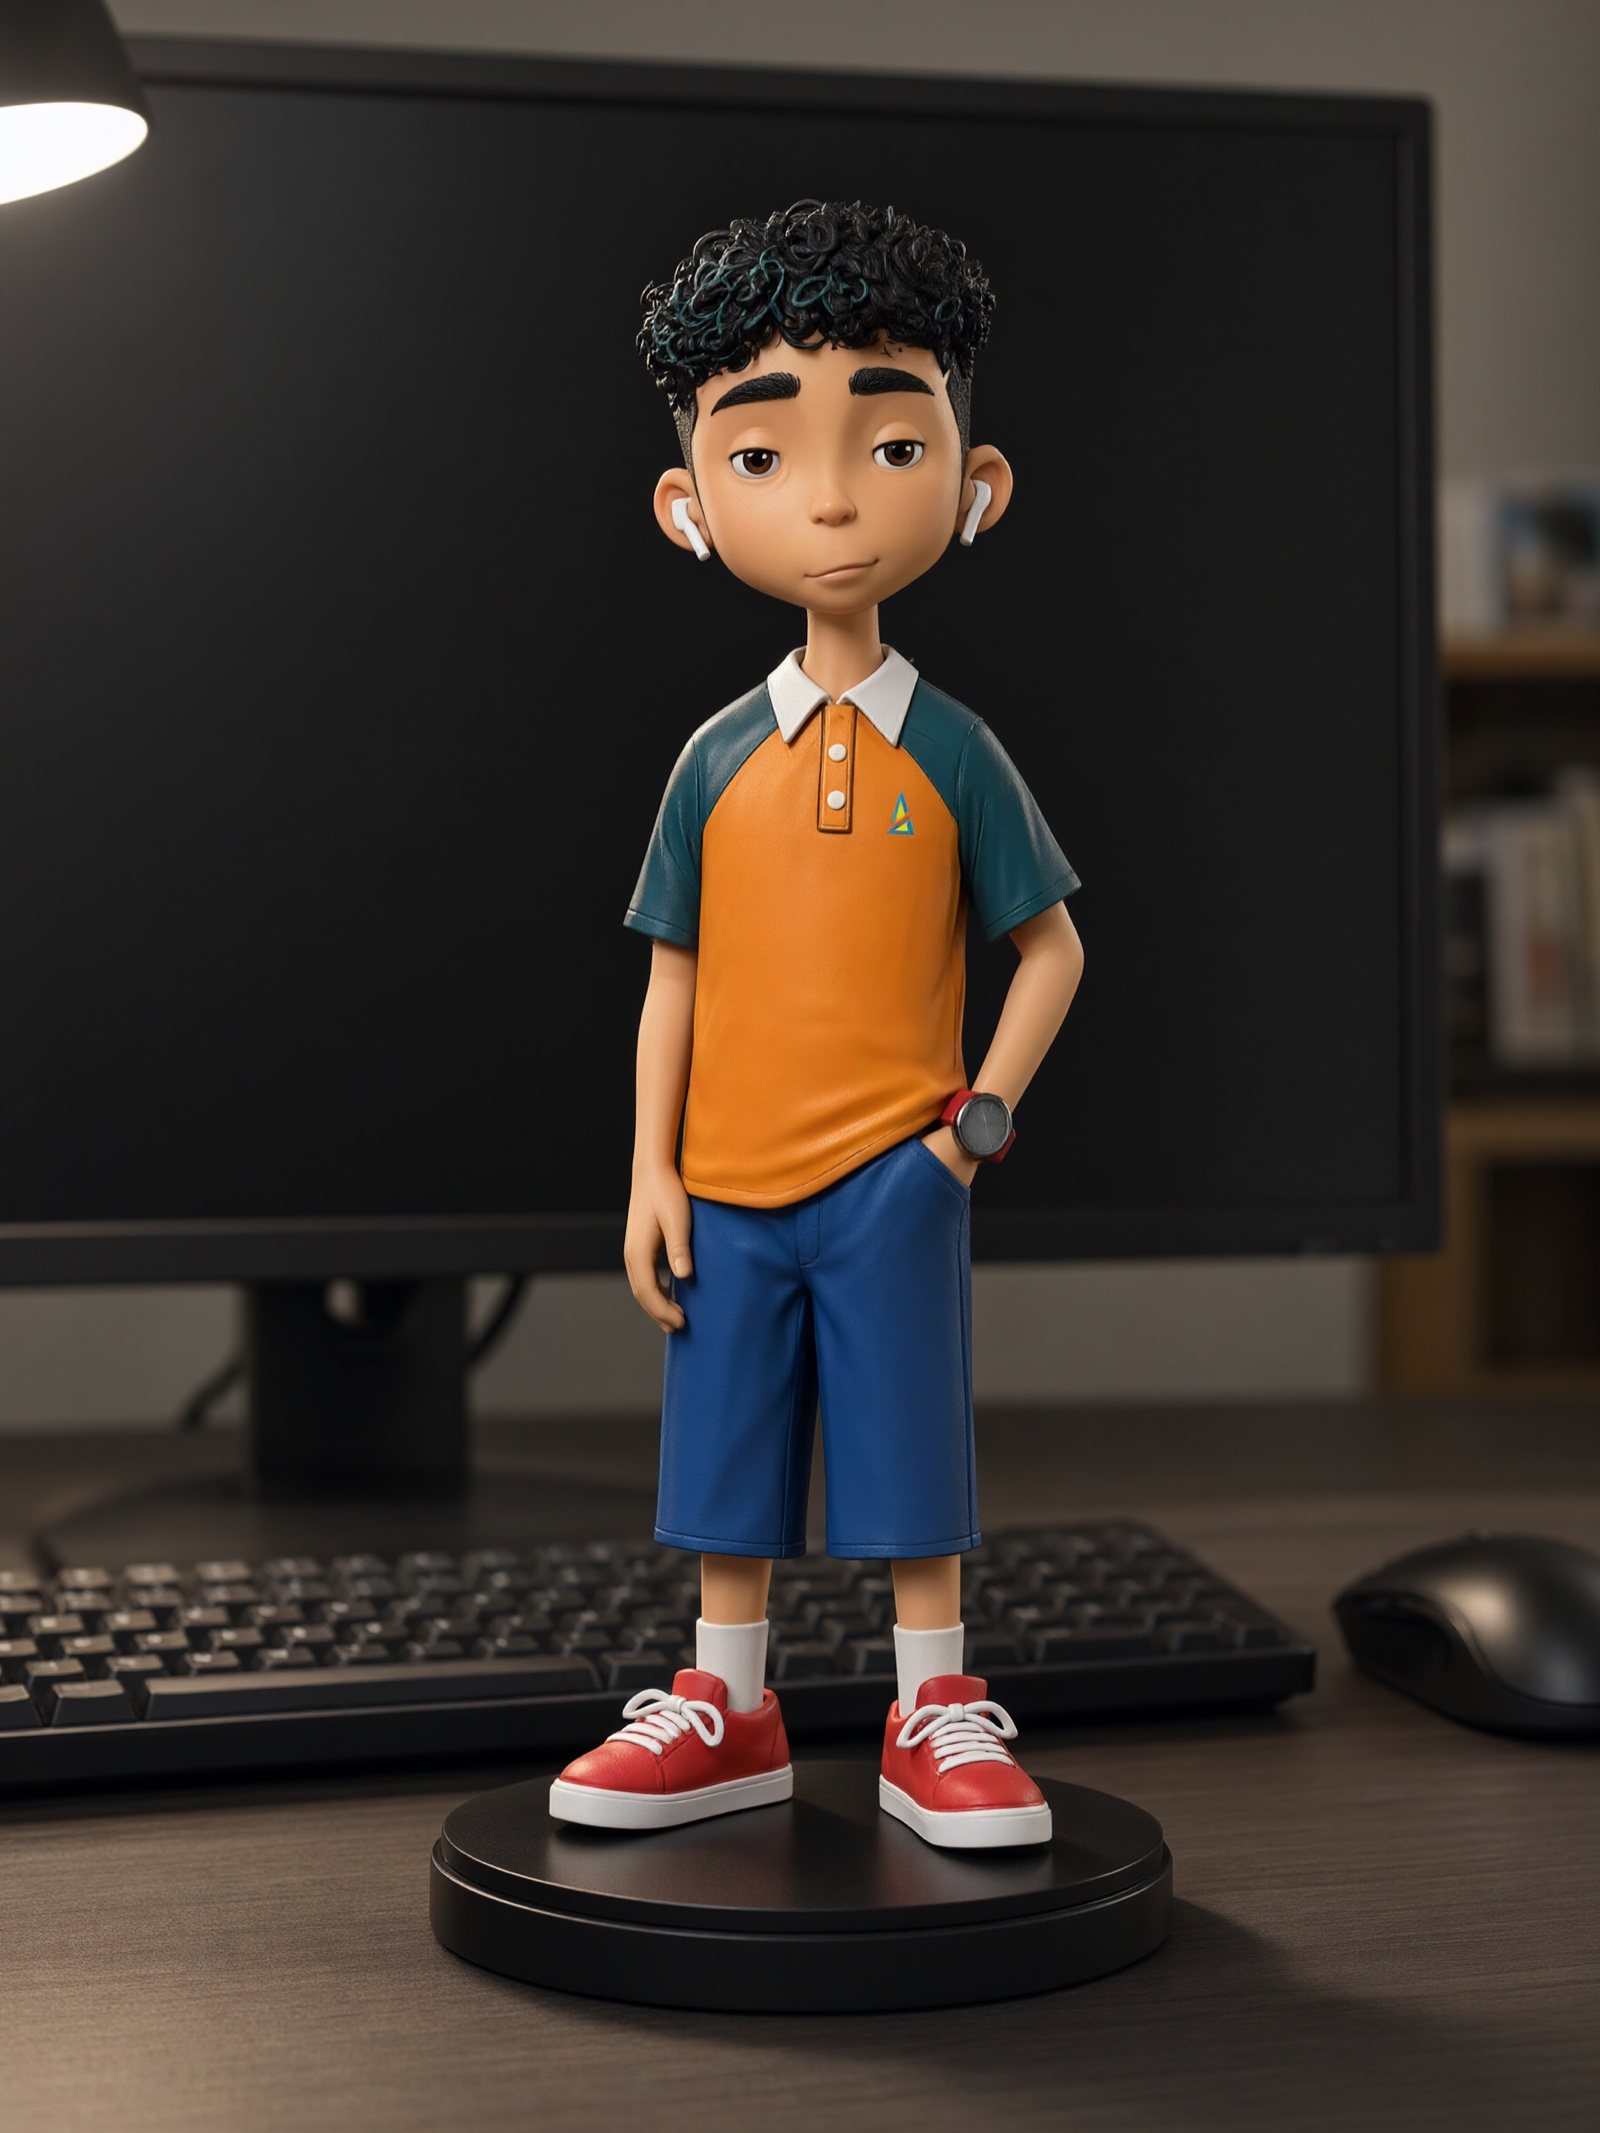
L'édition fonctionne de la même manière que sur le modèle de base, y compris la transformation d'une seule image :
 |  |
|---|---|
| Référence d'entrée | Sortie d'édition en 8 étapes (2048x2048) |
Disponibilité dans ComfyUI
Comfy-Org/Qwen-Image-2.1 a ajouté Turbo quelques heures après la sortie, sous les trois mêmes formes que le modèle de base :
diffusion_models/qwen_image_2.1_turbo_bf16.safetensors, le checkpoint complet en 8 étapes en BF16.diffusion_models/qwen_image_2.1_turbo_int8_convrot.safetensors, la quantification INT8 convrot pour une VRAM réduite.loras/qwen_image_2.1_turbo_lora_avg_rank_178_bf16.safetensors, une extraction LoRA de la même distillation, que vous chargez par-dessus le transformer de base au lieu de changer de checkpoint.
Le text encoder et le VAE sont partagés avec Qwen-Image 2.1, une installation qui fait déjà tourner le modèle de base n'a donc besoin que du nouveau transformer ou du LoRA. Les poids Turbo s'intègrent directement dans le flux de travail officiel Qwen-Image 2.1 existant : réglez l'échantillonneur sur 8 étapes et CFG 1, puis choisissez soit le modèle de diffusion turbo, soit le modèle de base plus le LoRA turbo.
Premiers retours
La sortie est arrivée dans #qwen-image le jour même et a été testée sur-le-champ. RuneX a rapporté que « le turbo officiel fonctionne très bien » et qu'il semblait nettement meilleur qu'au moins un LoRA Turbo tiers sur le même prompt. Corza a comparé les sigmas fournis à un planning Euler personnalisé et a jugé la différence mineure, essentiellement un peu plus d'accentuation et de détail de peau lorsque des LoRA ou LoKR sont empilés par-dessus, ce qui correspond au même problème de lissage excessif signalé pour les adaptateurs empilés sur le modèle de base. Kijai n'a pas été convaincu par un nœud de la communauté qui prétendait de meilleurs résultats turbo, remarquant que sur les modèles flow-matching, l'échantillonneur Euler de ComfyUI est déjà un Euler flow-match, ces nœuds ne font donc surtout que changer les sigmas.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.