H3 Person Remover LoRA : supprimer une personne d'une vidéo
Le LoRA Person Remover d'Akatz Labs suit une personne avec SAM 3.1, remplit le masque en vert et reconstruit l'arrière-plan par fenêtres superposées, avec un flux ComfyUI prêt.
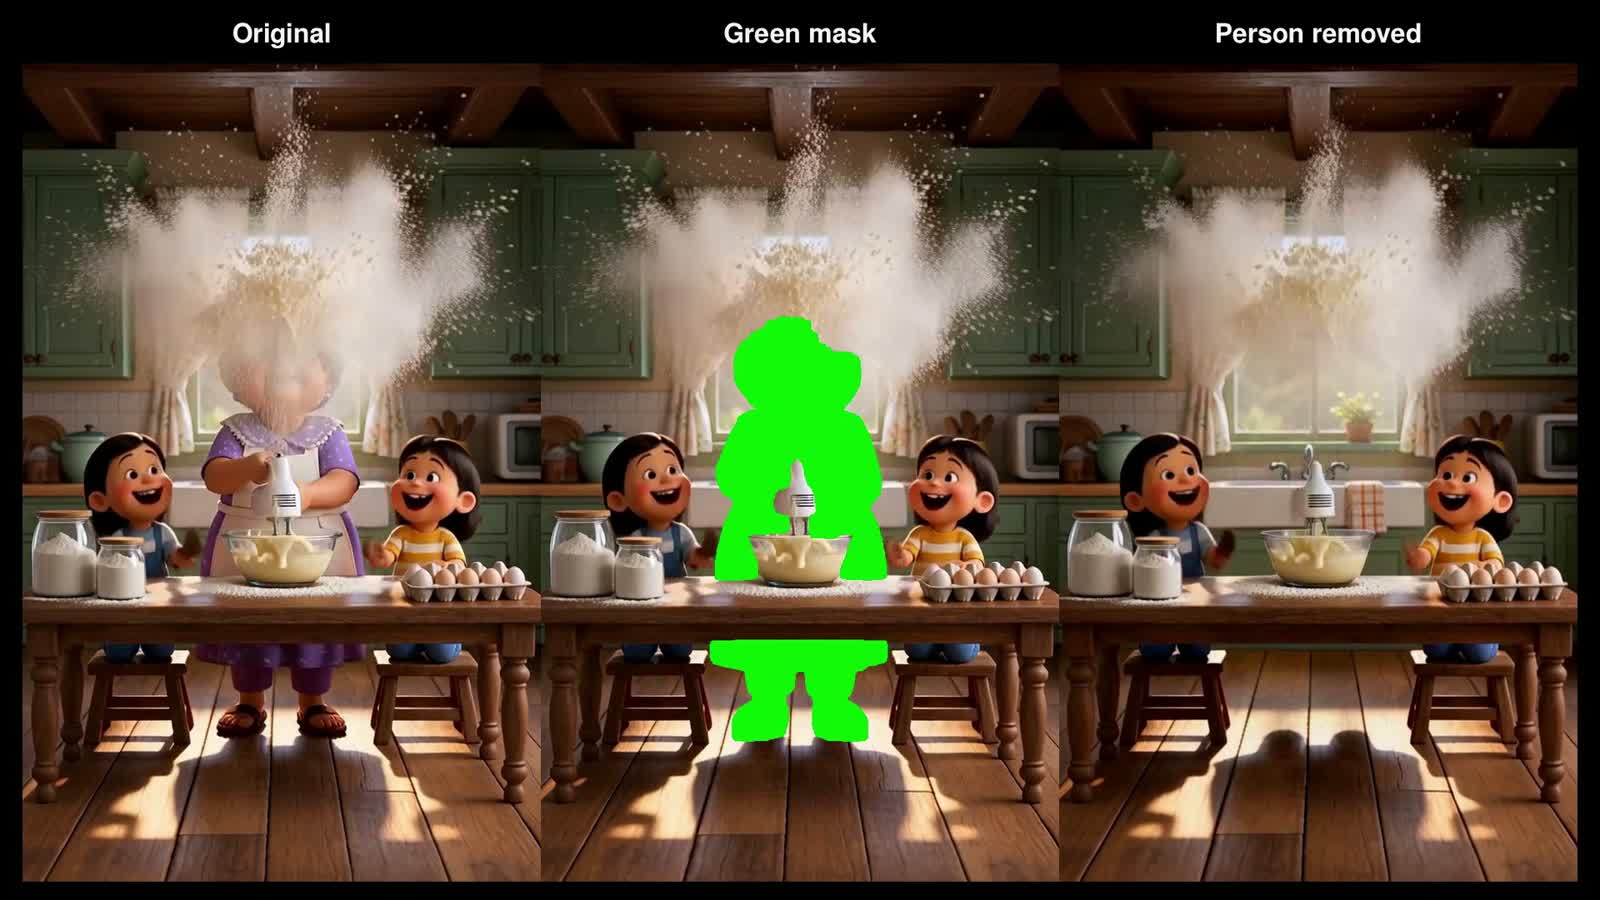
Extrait de la démonstration en huit exemples : clip original, masque vert, arrière-plan reconstruit.
La démonstration avant/après de l'auteur, réencodée en 1280 pixels de large.
Ce que fait l'adaptateur, et ce qu'il ne fait pas
Le LoRA ne segmente pas les personnes et n'invente pas l'arrière-plan propre de lui-même. SAM 3.1 fournit le masque de suivi à partir d'une description textuelle telle que man in gray shirt, et vous devez toujours fournir une version propre de la première image de la vidéo avec la personne déjà absente, soit depuis un éditeur d'images, soit depuis un modèle d'édition d'images. Ensuite, le flux de travail de relance par fenêtres fait le reste : les images masquées en vert entrent, H3 régénère la région couverte, et l'image de limite reconstruite porte la continuation dans la fenêtre suivante.
Invite de suppression par défaut :
Supprimez la personne masquée en vert et reconstruisez l'arrière-plan. Préservez le reste de la vidéo, y compris son mouvement de caméra et sa cadence d'images.
La relance par fenêtres, en chiffres
Le flux de travail est réglé précisément plutôt que générique, et les paramètres enregistrés valent la peine d'être copiés :
| Paramètre | Valeur |
|---|---|
| Scheduler | beta / simple |
| CFG | 1 |
| Décalage sigma vidéo / audio | 12 / 3 |
| Expansion du masque | 5 pixels |
| Fréquence d'images | 24 fps |
| Graine | 904234 |
Aucun LoRA Turbo ou VFX n'est requis. Le flux de travail utilise des longueurs de séquence H3 de la forme 17n + 5 (22, 39, 56, 73 ...) et recommande de commencer à 22 images, car une fenêtre plus longue coûte plus de mémoire sans améliorer automatiquement le résultat. Chaque continuation utilise l'image de limite générée comme référence suivante et transporte 18 images d'historique vidéo et audio généré, puis le relais supprime le chevauchement et recadre le résultat au nombre d'images de la source. La sortie est silencieuse par défaut ; vous connectez l'audio d'origine depuis le nœud Obtenir les composants vidéo au nœud Créer une vidéo final pour conserver la bande sonore.
Les exigences d'entrée sont précises : une vidéo à 24 fps, une largeur et une hauteur divisibles par 32, et idéalement un plan continu court d'environ cinq secondes.
Journal d'entraînement
V1 est un adaptateur de rang 16 sur le modèle Ref2VA élagué, entraîné pendant 2 000 mises à jour de l'optimiseur, après 250 mises à jour initiales sur des paires statiques de cinq images et une régularisation de préservation.
| Paramètre | Valeur enregistrée |
|---|---|
| Architecture | minimax_h3_ref2va, élagué |
| Rang / alpha | 16 / 16, en excluant adaln_proj |
| Tenseurs | BF16, 416 tenseurs répartis sur 208 cibles d'adaptateur |
| Optimiseur / taux d'apprentissage | AdamW8bit / 5e-5 |
| Encodeur de texte | NVFP4 Qwen3VL |
| Résolution de tâche / de régularisation | 1152 / 256, compartiments de ratio d'aspect |
| Longueurs de séquence de tâche | 5, 56, 73, 90, 124 à 24 fps |
| Longueur de régularisation | 107 images à 24 fps, avec audio |
| Environnement d'exécution | AI Toolkit 0.13.23 plus un correctif aligned-video-guide enregistré |
Le pool d'entraînement de la phase mixte contient 128 paires statiques, 80 extraits de masque en mouvement issus de 20 scènes, et six clips de préservation. La fiche du jeu de données documente la construction, la répartition et le statut de révision, et training/ contient les configurations, les planifications, les hachages de modèle et le correctif d'environnement d'exécution.
Limitations
Akatz Labs est direct sur ce qui échoue encore :
- H3 régénère toute la scène, donc les zones non masquées ne sont pas verrouillées au pixel près sur l'original, même si les paires d'entraînement préservent les pixels en dehors de leurs masques.
- Une main manquée, un bord de cheveux, une ombre, un reflet ou une partie du corps occultée peuvent subsister, et un masque plus grand demande au modèle d'inventer davantage d'arrière-plan.
- Une première image propre de mauvaise qualité se propage dans les fenêtres suivantes, et un fort mouvement de caméra ou des coupes franches peuvent briser la continuité.
- Relancer une fenêtre modifie sa continuation, le suffixe reconstruit doit donc aussi être inspecté.
- L'indicateur d'acceptation du jeu de données enregistré reste faux : réussir les contrôles techniques n'équivaut pas à une approbation humaine de chaque exemple.
Disponibilité
Le flux de travail nécessite une version en cours de ComfyUI avec prise en charge native de MiniMax H3 et SAM 3.1, plus H3-Person-Remover-V1.safetensors dans models/loras/. Le flux de travail publié épingle le transformer H3 ref2va pruned INT8 ConvRot, l'encodeur de texte NVFP4 Qwen3VL, les VAE vidéo et audio H3, et SAM 3.1 multiplex ; la validation précédente a tourné sur une RTX 4090 avec ComfyUI 0.37.0, que l'auteur décrit comme une configuration testée plutôt qu'une spécification minimale. H3 Relay fournit l'aperçu de fenêtre et les contrôles de relance qu'utilise le flux de travail.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.