Qwen-Image 2.1 Restore LoRA : agrandir sans deriver
Un LoRA communautaire pour Qwen-Image 2.1 garde la photo restauree ou agrandie sur son cadre d'origine : 0,3 px contre 2,2 px sans lui, avec workflow ComfyUI.
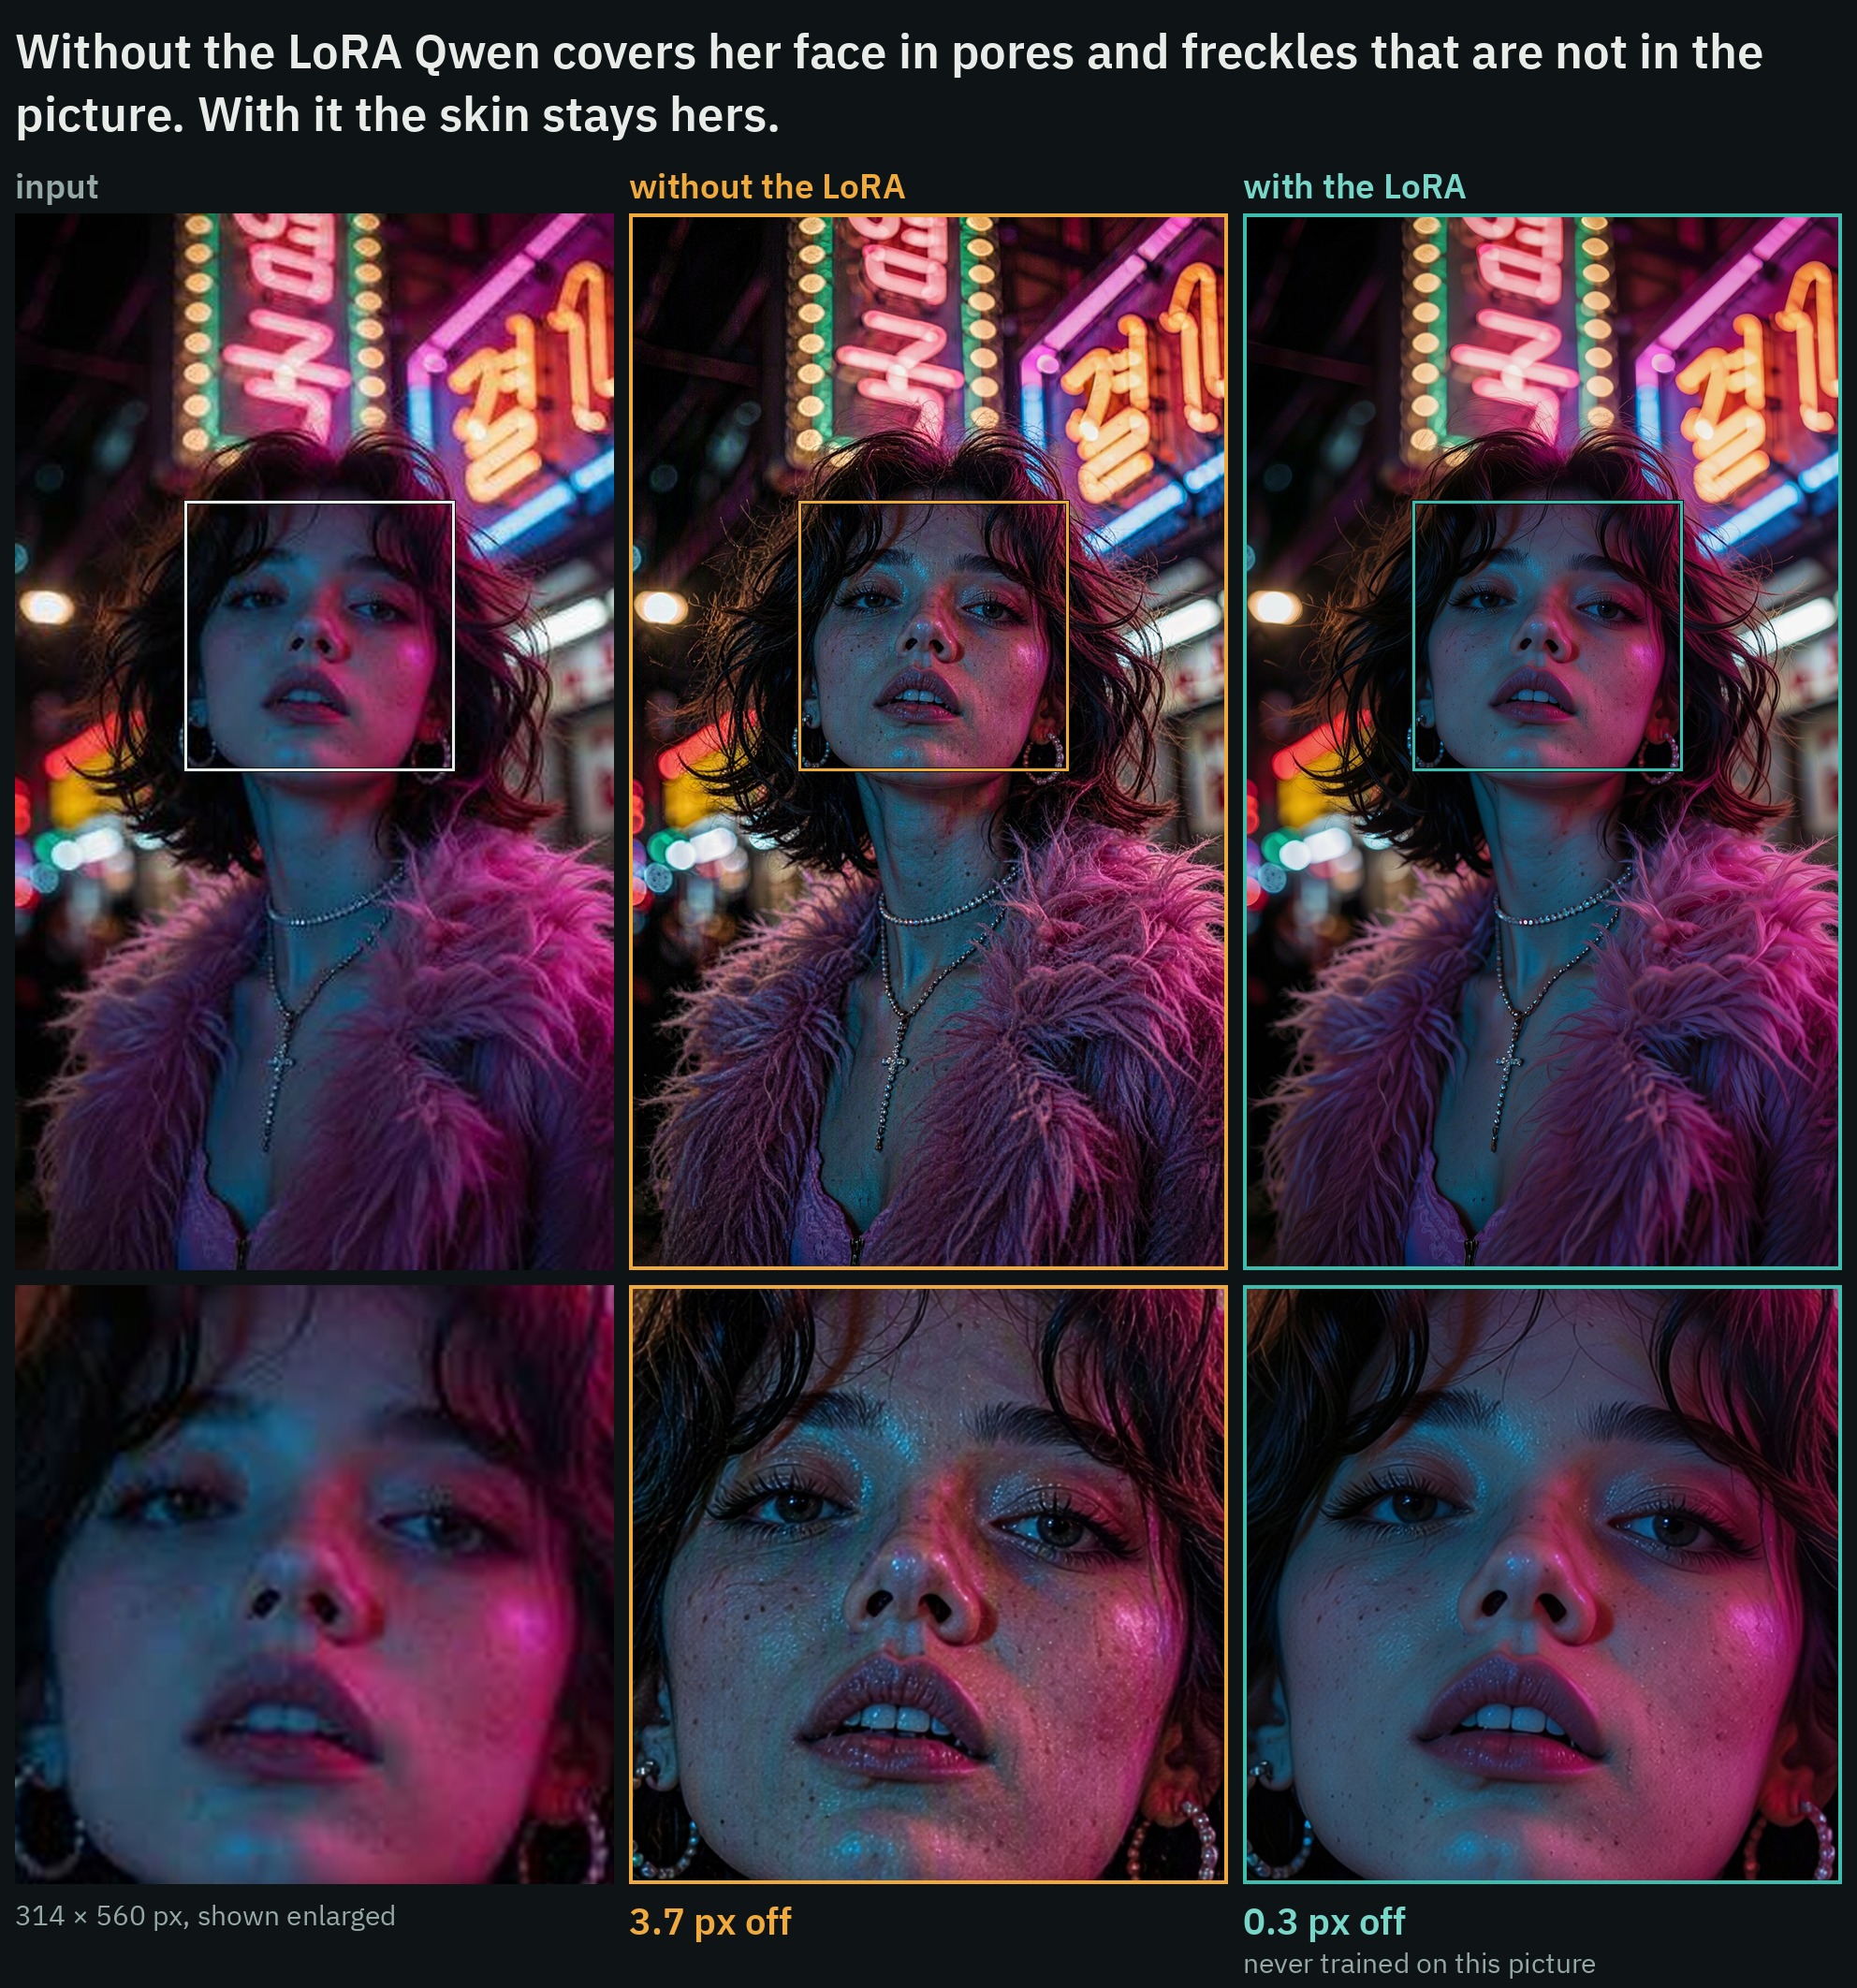
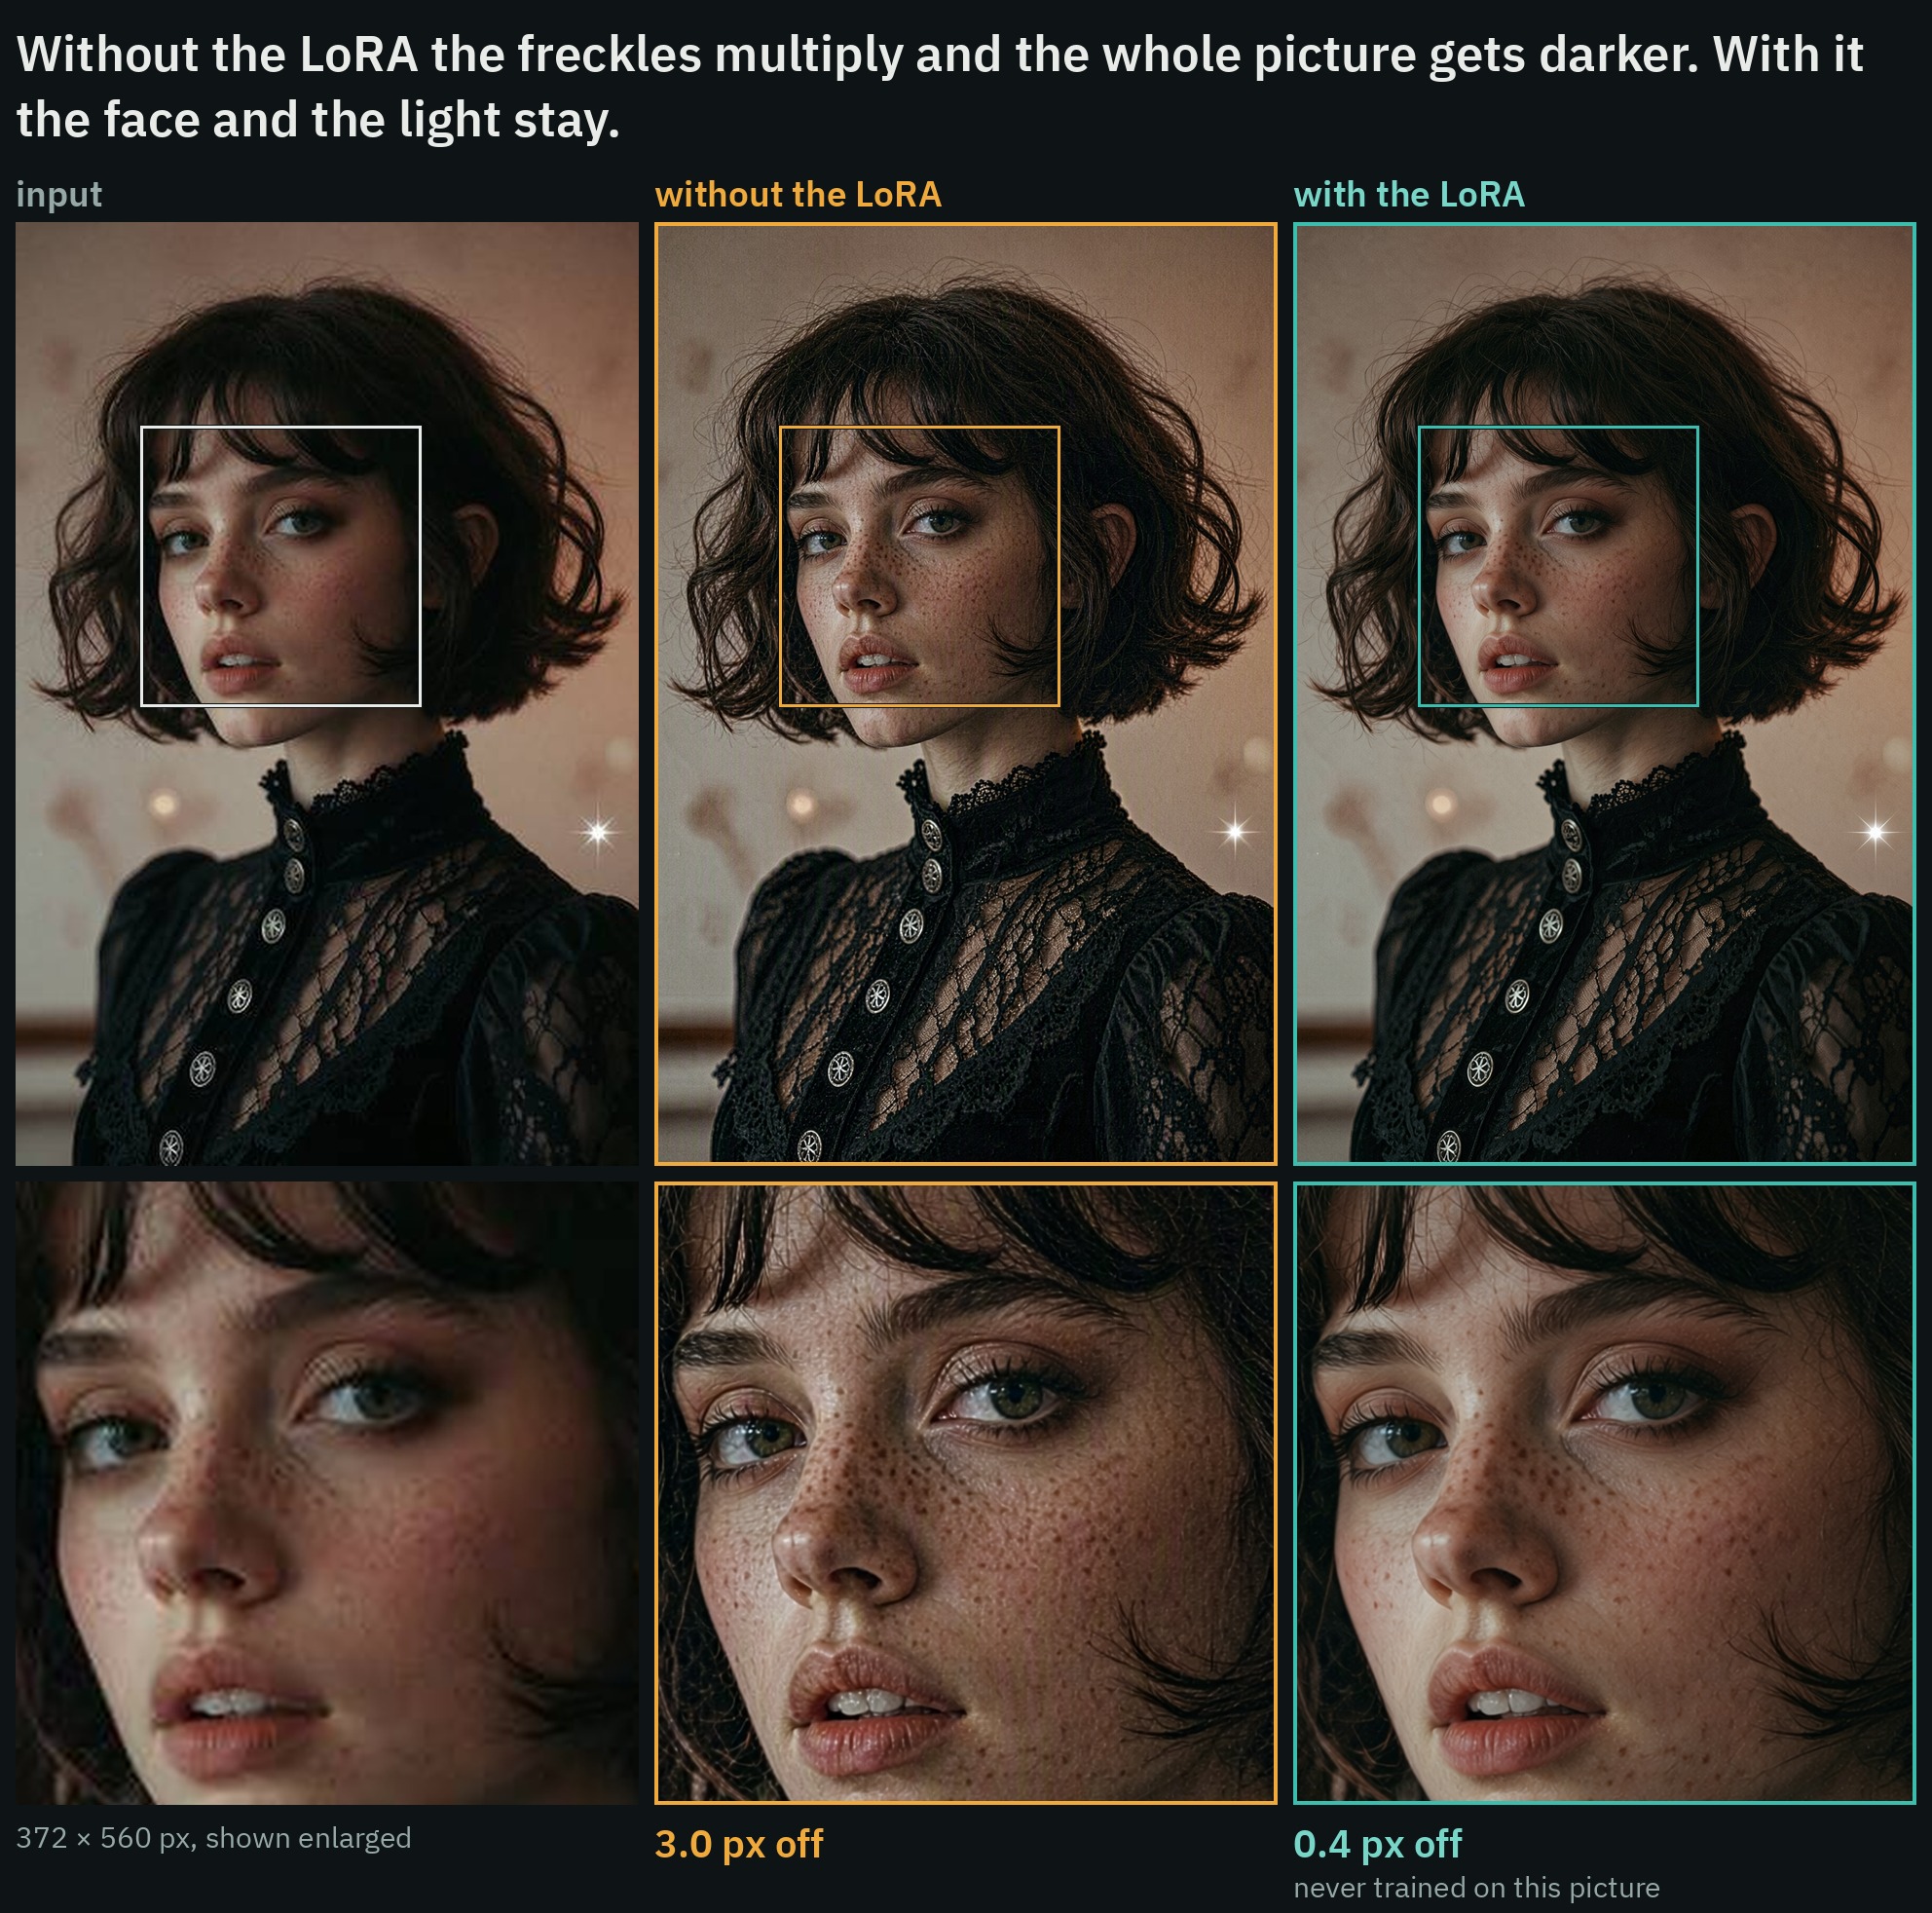
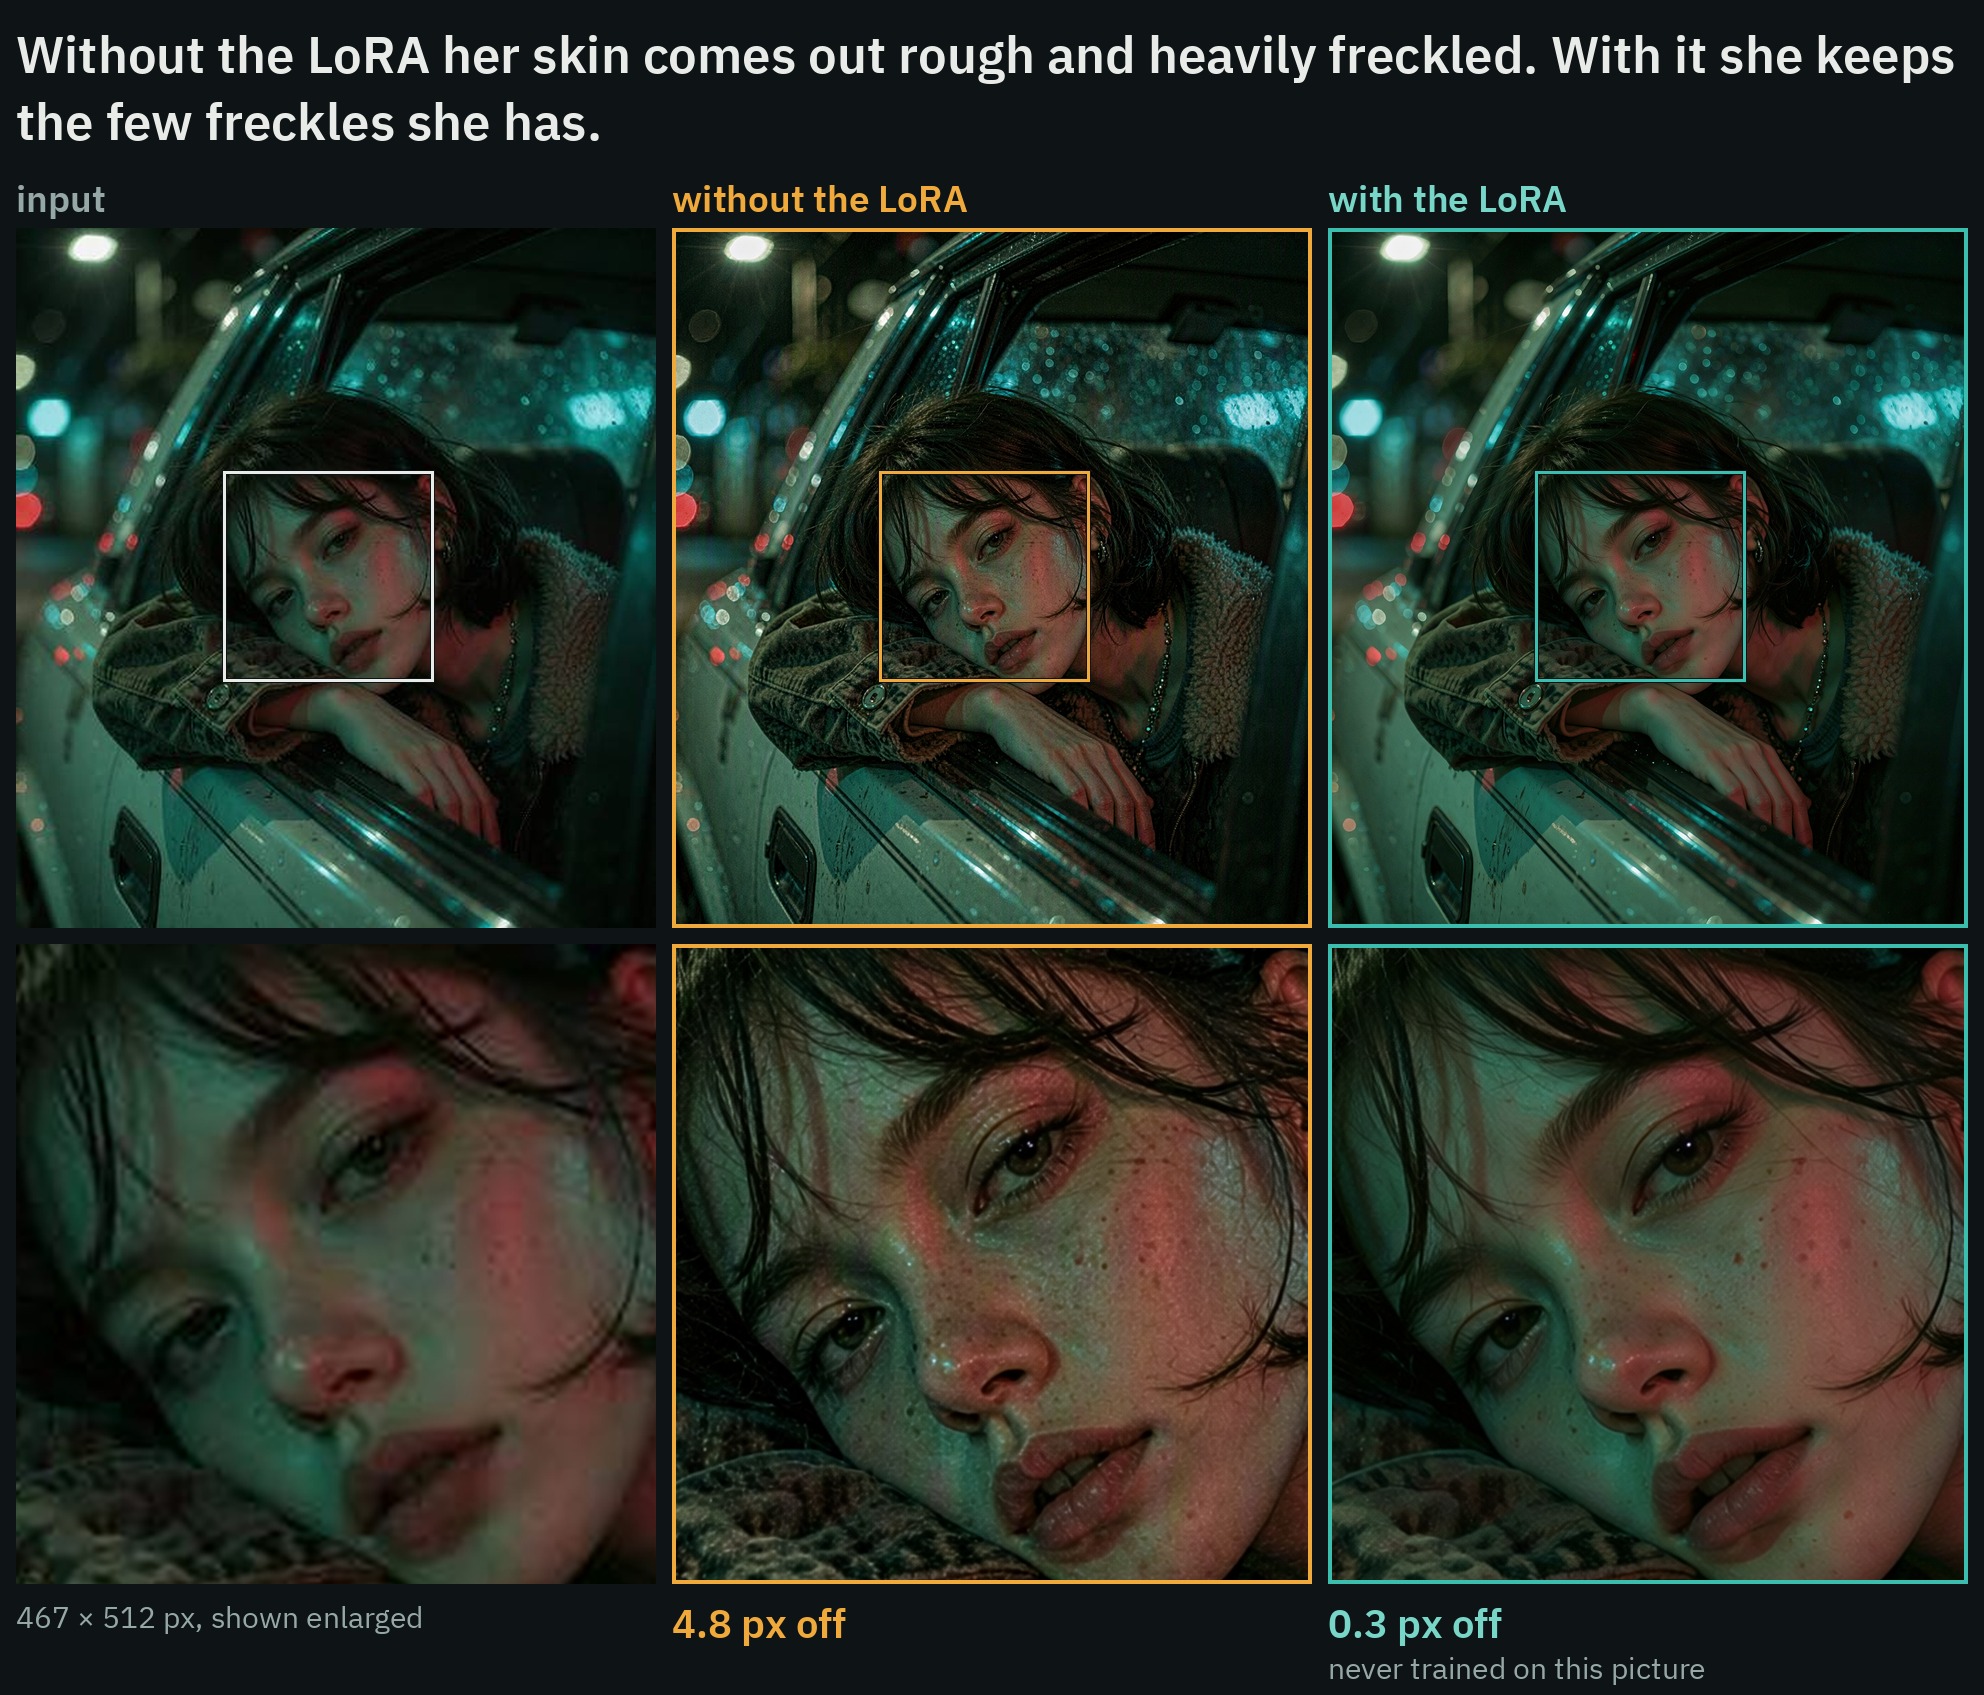
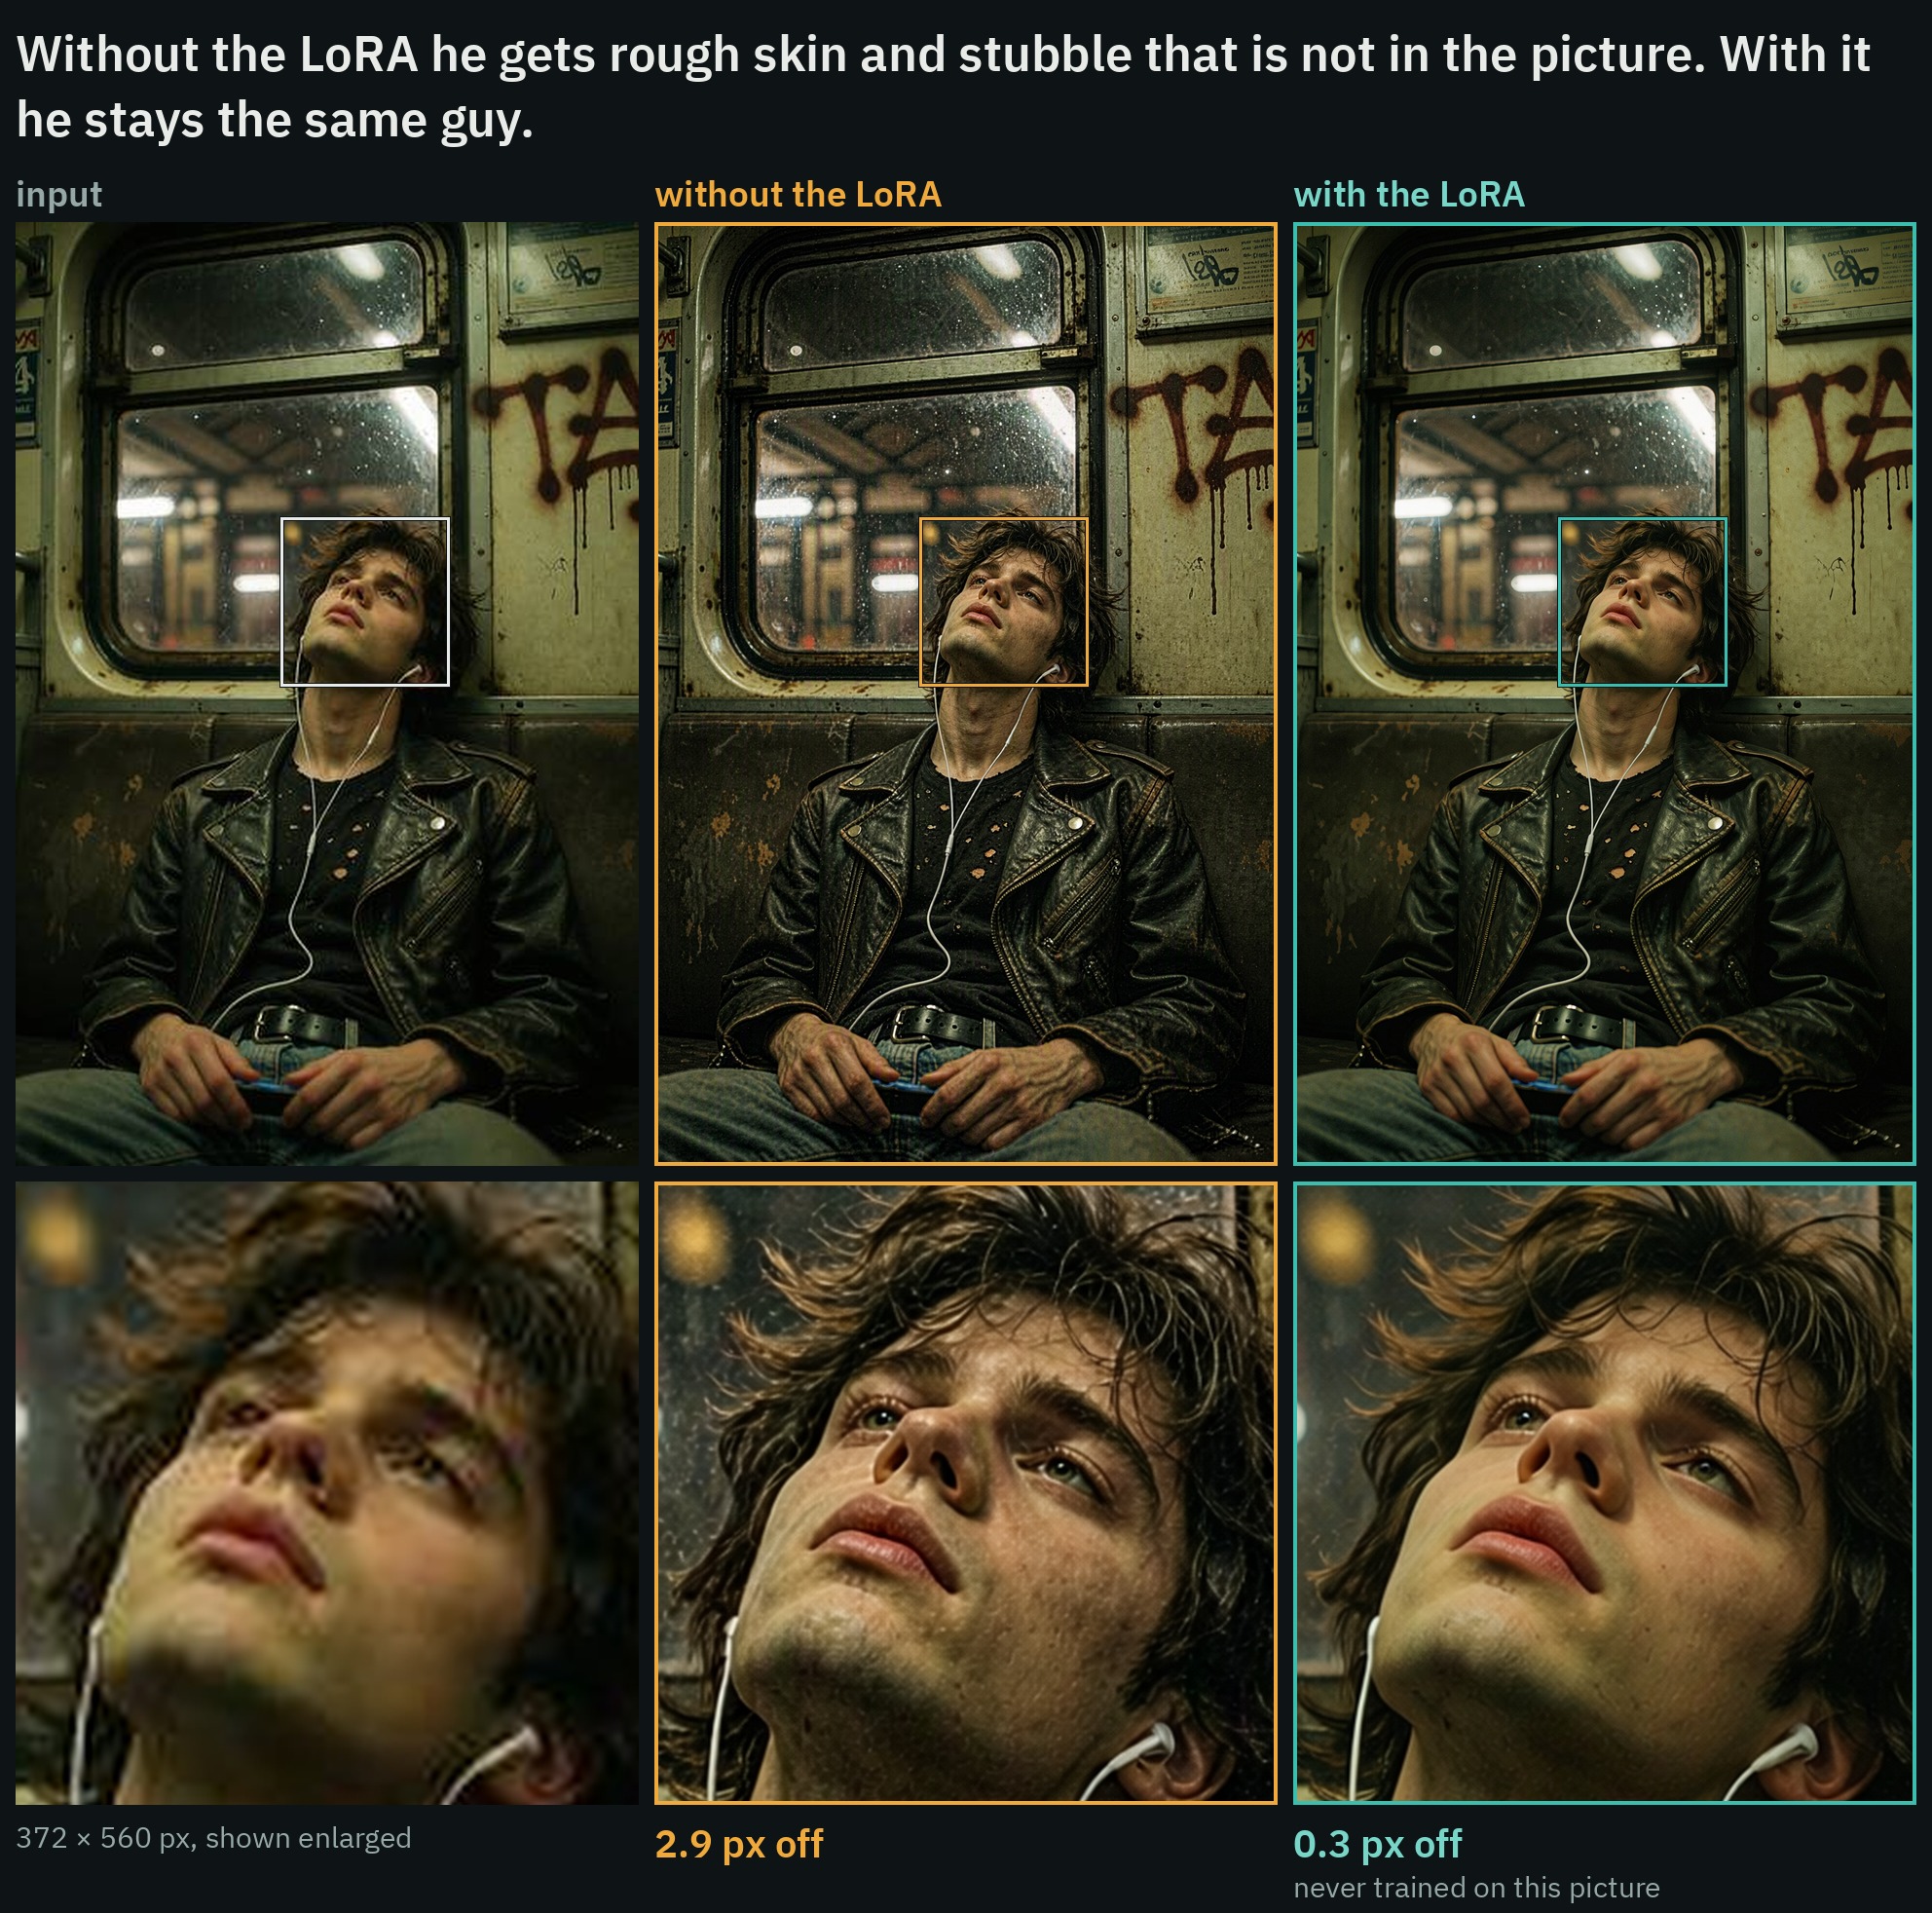
Dans chaque comparaison : la petite entrée, le résultat sans le LoRA, le résultat avec, et la section marquée agrandie en dessous. Toutes passent par le flux de travail du dépôt avec le même prompt et la même graine, 8 étapes avec Viggle Turbo, environ 2 MP. « px off » indique à quelle distance le résultat se situe de l'image pleine taille dont l'entrée a été réduite. Aucune de ces images ne fait partie du jeu d'entraînement.
Ce que Qwen-Image 2.1 seul fait à une petite image
Qwen-Image 2.1 est déjà un bon outil de restauration de photos à lui seul, et son mode d'échec est l'inverse du flou. Lorsqu'on lui demande d'agrandir une photo compressée ou de faible résolution, il invente des détails : pores, taches de rousseur, barbe naissante et grain que l'original n'a jamais eus, et il redessine les visages avec quelques années de plus que la personne sur la photo. Il déplace aussi les éléments. Sur le jeu de test de l'auteur, le pire coin d'un résultat de Qwen-Image 2.1 seul se trouvait à 2,35 px de l'original en pleine résolution, ce qui est peu à l'écran mais suffisant pour que le résultat ne puisse pas être superposé à la source.
Le LoRA a été entraîné à échanger une partie de cette texture inventée contre une meilleure fidélité à la photo. Il s'agit d'un redessin, pas d'une restauration : les détails fins restent inventés, simplement en moindre quantité, et la Carte le dit clairement.
- Aucun mot déclencheur. Agrandissez d'abord la photo à environ 2 MP (les deux côtés divisibles par 32), fournissez-la comme image 1, puis demandez.
- Force 1.0 pour une petite photo ou une photo compressée qui est nette.
- Force 0.75 pour un peu plus de la texture propre à Qwen.
- Force 0.5 pour une photo floue, une prise de vue tremblée ou une image de vidéo.
Restore the photo: remove blur, noise and compression artifacts and recover sharp, natural detail, keeping the same composition, people and colors.Pour un tirage rayé ou délavé, la Carte utilise une seconde requête, qui restaure aussi les couleurs :
Restore the old photo: remove scratches, dust, fading and grain and recover sharp, natural detail and color, keeping the same composition and people.Mesure sur un jeu d'images tenu à l'écart
Huit des propres images de l'auteur, réduites à 512 ou 560 px sur le grand côté et enregistrées en JPEG qualité 70, puis agrandies à environ 2 MP et restaurées avec la même graine, LoRA à 1.0, CFG 1, euler / simple. Chaque chiffre est mesuré par rapport à l'original en pleine taille, que le modèle ne voit jamais. Les colonnes à 8 étapes utilisent Viggle Turbo ; les colonnes à 25 étapes non :
| huit images tenues à l'écart | sans LoRA, 8 étapes | avec, 8 étapes | sans LoRA, 25 étapes | avec, 25 étapes |
|---|---|---|---|---|
| distance à l'original, médiane du pire coin | 2,35 px | 0,26 px | 1,59 px | 0,15 px |
| idem, pire des huit | 3,83 px | 0,38 px | 3,25 px | 0,26 px |
| proximité avec l'original (SSIM, 1 = identique) | 0,578 | 0,766 | 0,743 | 0,812 |
| PSNR | 23,2 dB | 28,0 dB | 26,3 dB | 29,3 dB |
| dérive de couleur et de luminosité | 2,05 % | 0,97 % | 1,72 % | 1,04 % |
| même visage (reconnaissance faciale, 1 = identique) | 0,821 | 0,905 | 0,837 | 0,901 |
| détails fins, par rapport à l'original | 121 % | 78 % | 58 % | 36 % |
La ligne des détails fins résume le compromis en un seul chiffre. Au-dessus de 100 %, cela signifie des détails inventés : à 8 étapes, Qwen-Image 2.1 seul dessine plus de grain que l'original n'en contient, et à 25 étapes il en dessine environ la moitié de l'original. Avec le LoRA, les deux valeurs sont inférieures à l'original : les résultats paraissent donc un peu lisses. L'auteur a aussi fait passer 29 autres images par le même test à 8 étapes : 0,28 px d'écart avec le LoRA contre 2,16 px sans, même visage 0,88 contre 0,79, SSIM 0,777 contre 0,611.
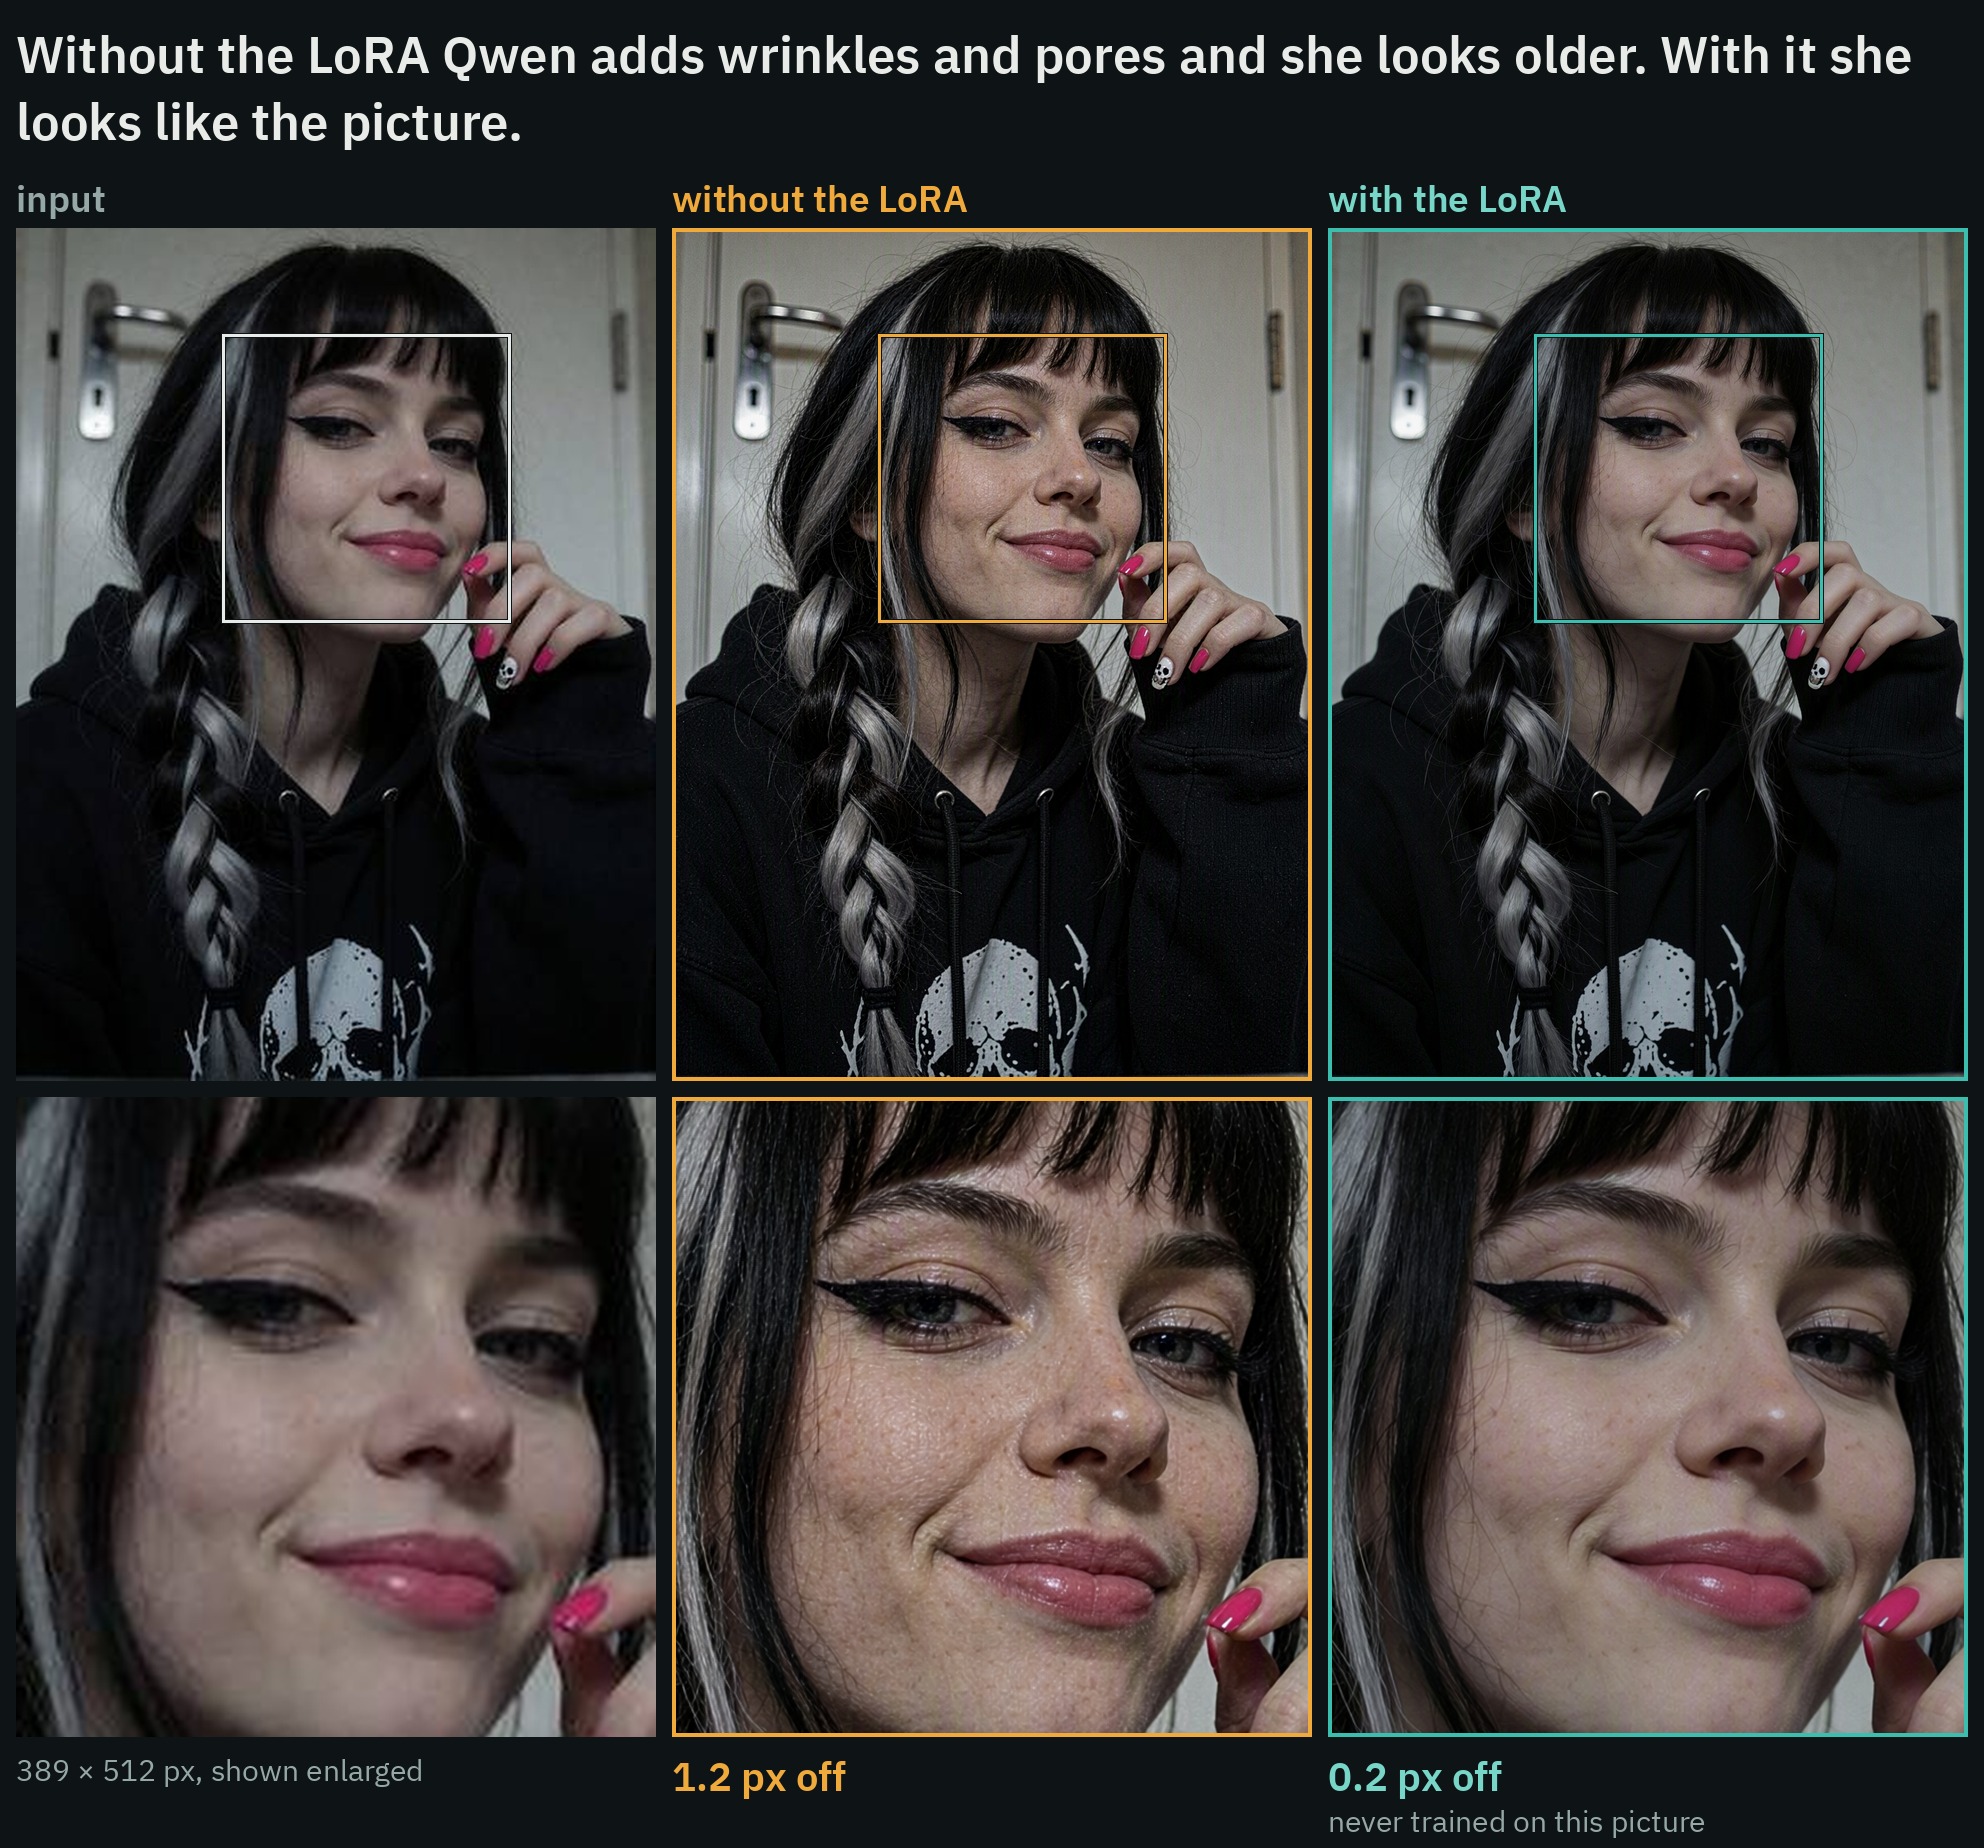
Un JPEG de 389 px agrandi à 2 MP. Aucune de ces images ne fait partie du jeu d'entraînement.
Tous les types de dégradation
La publication rapporte également 57 paires mises de côté, dégradées de la même manière que les paires d'entraînement, en une passe à 8 étapes avec la requête normale. Le SSIM est mesuré par rapport à l'image propre, et « px d'écart » correspond à la médiane :
| type de dégradation | images | SSIM, entrée dégradée | SSIM, sans LoRA | SSIM, avec | px d'écart, sans LoRA | px d'écart, avec |
|---|---|---|---|---|---|---|
| petite image web | 15 | 0.772 | 0.524 | 0.716 | 2.53 | 0.31 |
| lissage téléphone | 5 | 0.836 | 0.565 | 0.857 | 2.65 | 0.17 |
| image extraite de vidéo | 5 | 0.771 | 0.578 | 0.745 | 2.77 | 0.50 |
| enregistrée et réenregistrée | 5 | 0.816 | 0.560 | 0.794 | 2.21 | 0.24 |
| flou et bruit | 5 | 0.496 | 0.521 | 0.678 | 2.48 | 0.24 |
| JPEG de faible résolution | 5 | 0.777 | 0.531 | 0.763 | 3.16 | 0.23 |
| mélange lourd | 5 | 0.735 | 0.646 | 0.746 | 1.28 | 0.25 |
| tirage ancien | 4 | 0.551 | 0.437 | 0.749 | 2.46 | 0.19 |
| banding | 4 | 0.915 | 0.463 | 0.843 | 2.34 | 0.17 |
| PNG de faible résolution | 4 | 0.873 | 0.636 | 0.847 | 3.39 | 0.15 |
| tous | 57 | 0.756 | 0.544 | 0.762 | 2.70 | 0.23 |
Avec le LoRA, le résultat était plus proche de l'image propre sur les 57, et il a moins bougé sur les 57. Sur plusieurs types, l'image dégradée elle-même obtient un meilleur score que n'importe quelle restauration, car une image douce est proche en moyenne.
Les tirages anciens ont leurs propres chiffres sur quatre exemples mis de côté : la couleur et la luminosité s'écartaient de 15 % de l'image propre avant la restauration, de 7 % après celle-ci avec la requête normale, et de 4 % avec la requête pour photos anciennes. Les rayures, la poussière et le grain disparaissaient avec l'une ou l'autre requête. Un type de décoloration que le modèle n'a pas vu peut subsister : dans un second test avec une décoloration différente, les rayures ont disparu et la couleur décolorée est restée.
L'intensité est un curseur
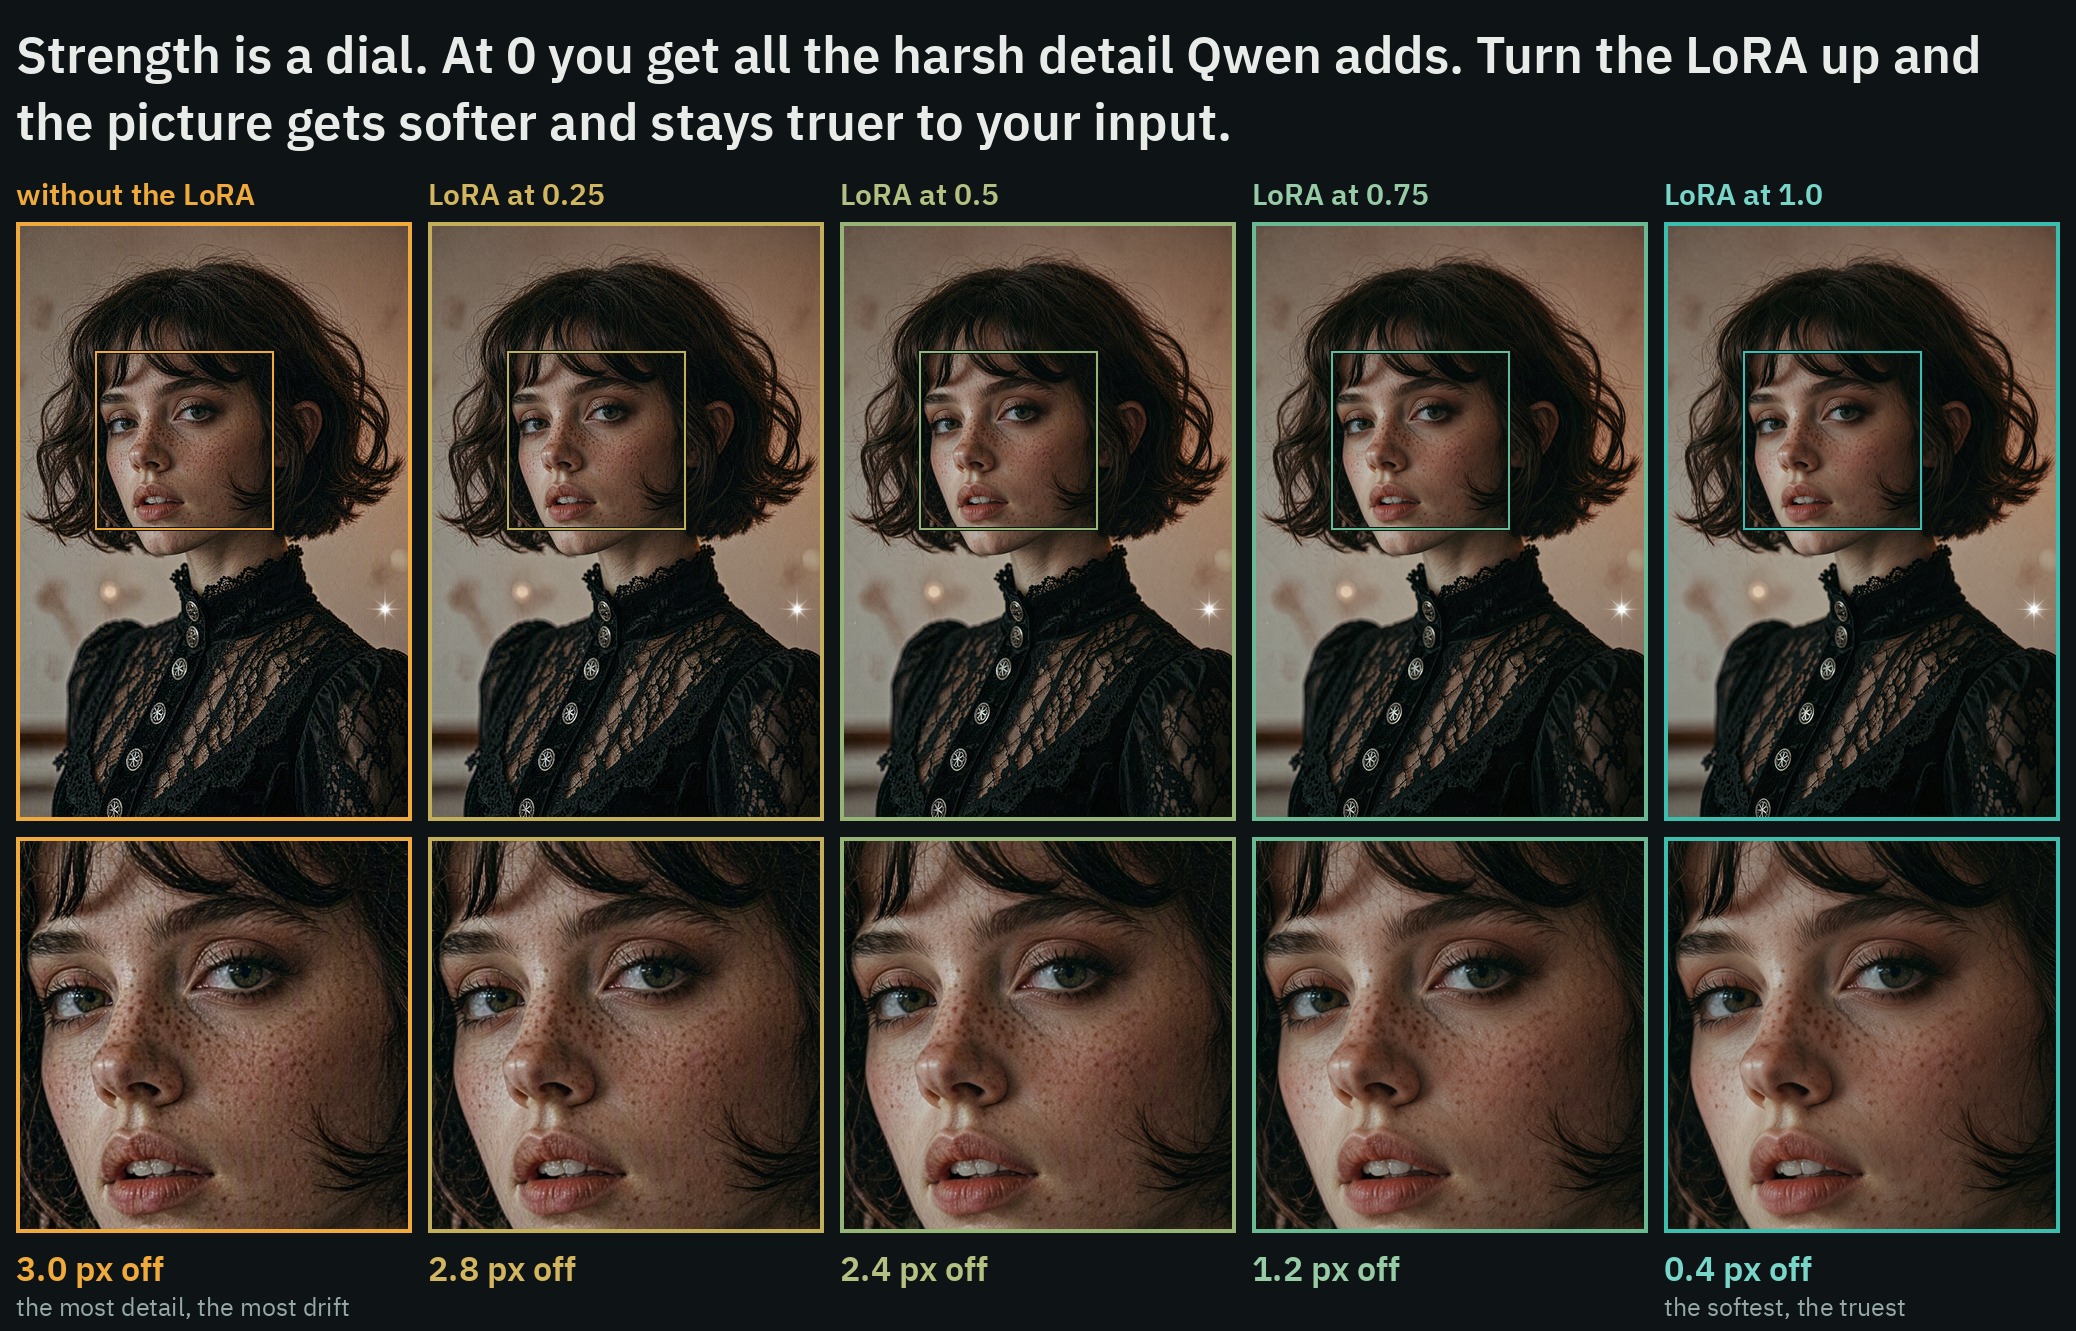
Sur l'ensemble des 29 images, toute l'échelle va du Qwen brut à 0 au résultat le plus fidèle à 1,0 :
| intensité | désactivé / 0,5 / 0,75 / 1,0 |
|---|---|
| distance par rapport à l'original | 2,16 px / 1,31 px / 0,37 px / 0,28 px |
| même visage | 0,794 / 0,858 / 0,875 / 0,880 |
| écart de couleur et de luminosité | 1,88 % / 1,26 % / 1,05 % / 0,94 % |
| détail fin, par rapport à celui de l'original | 102 % / 81 % / 77 % / 72 % |
C'est sur les photos floues que ce curseur compte le plus. L'auteur a traité 26 vraies photos à basse résolution (d'anciens selfies et des photos prises au téléphone) à 1,0, 0,75 et 0,5. Sur les six plus floues, 1,0 est revenu doux, 0,75 n'a presque rien apporté et 0,5 est revenu net ; sur les vingt autres, les trois réglages ont fonctionné et 1,0 était le plus lisse. L'agrandissement par tuiles d'une photo douce jusqu'à 8 MP est lui aussi revenu net à 1,0 sur les trois images testées de cette façon.
Le LoRA a été entraîné sur des photos et tient aussi sur les dessins. Sur six dessins de test (anime, une affiche avec du lettrage, de l'aquarelle, un dessin animé 3D, un manga, une peinture à l'huile), il a conservé le style et le lettrage : SSIM 0,714 contre 0,491 sans lui, et 0,27 px d'écart contre 2,65 px.
Face aux autres outils
La carte compare cette version avec les autres outils qu'elle a pu trouver pour la même tâche, sur les mêmes 29 images, avec les mêmes mesures, le tout exécuté à 1.0. Ils ne sont pas tous conçus pour la même chose : certains sont faits pour ajouter du détail, alors que ce LoRA est fait pour rester fidèle à l'image. Le tableau répond donc à une seule question : à quel point le résultat reste proche de l'original.
| 29 petites images | écart par rapport à l'original | même visage | décalage de couleur et de luminosité | SSIM |
|---|---|---|---|---|
| Qwen Image 2.1 seul | 2,16 px | 0,79 | 1,88 % | 0,611 |
| SeedVR2 (3B), les nœuds de ComfyUI | 0,42 px | 0,82 | 0,44 % | 0,771 |
| Deblur anything | 0,39 px | 0,85 | 1,42 % | 0,702 |
| Detail Enhancer, dans le même graphique | 2,07 px | 0,76 | 2,94 % | 0,673 |
| Detail Enhancer, son propre flux de travail, 25 étapes | 12,45 px | 0,71 | 4,16 % | 0,590 |
| ce LoRA | 0,28 px | 0,88 | 0,94 % | 0,777 |
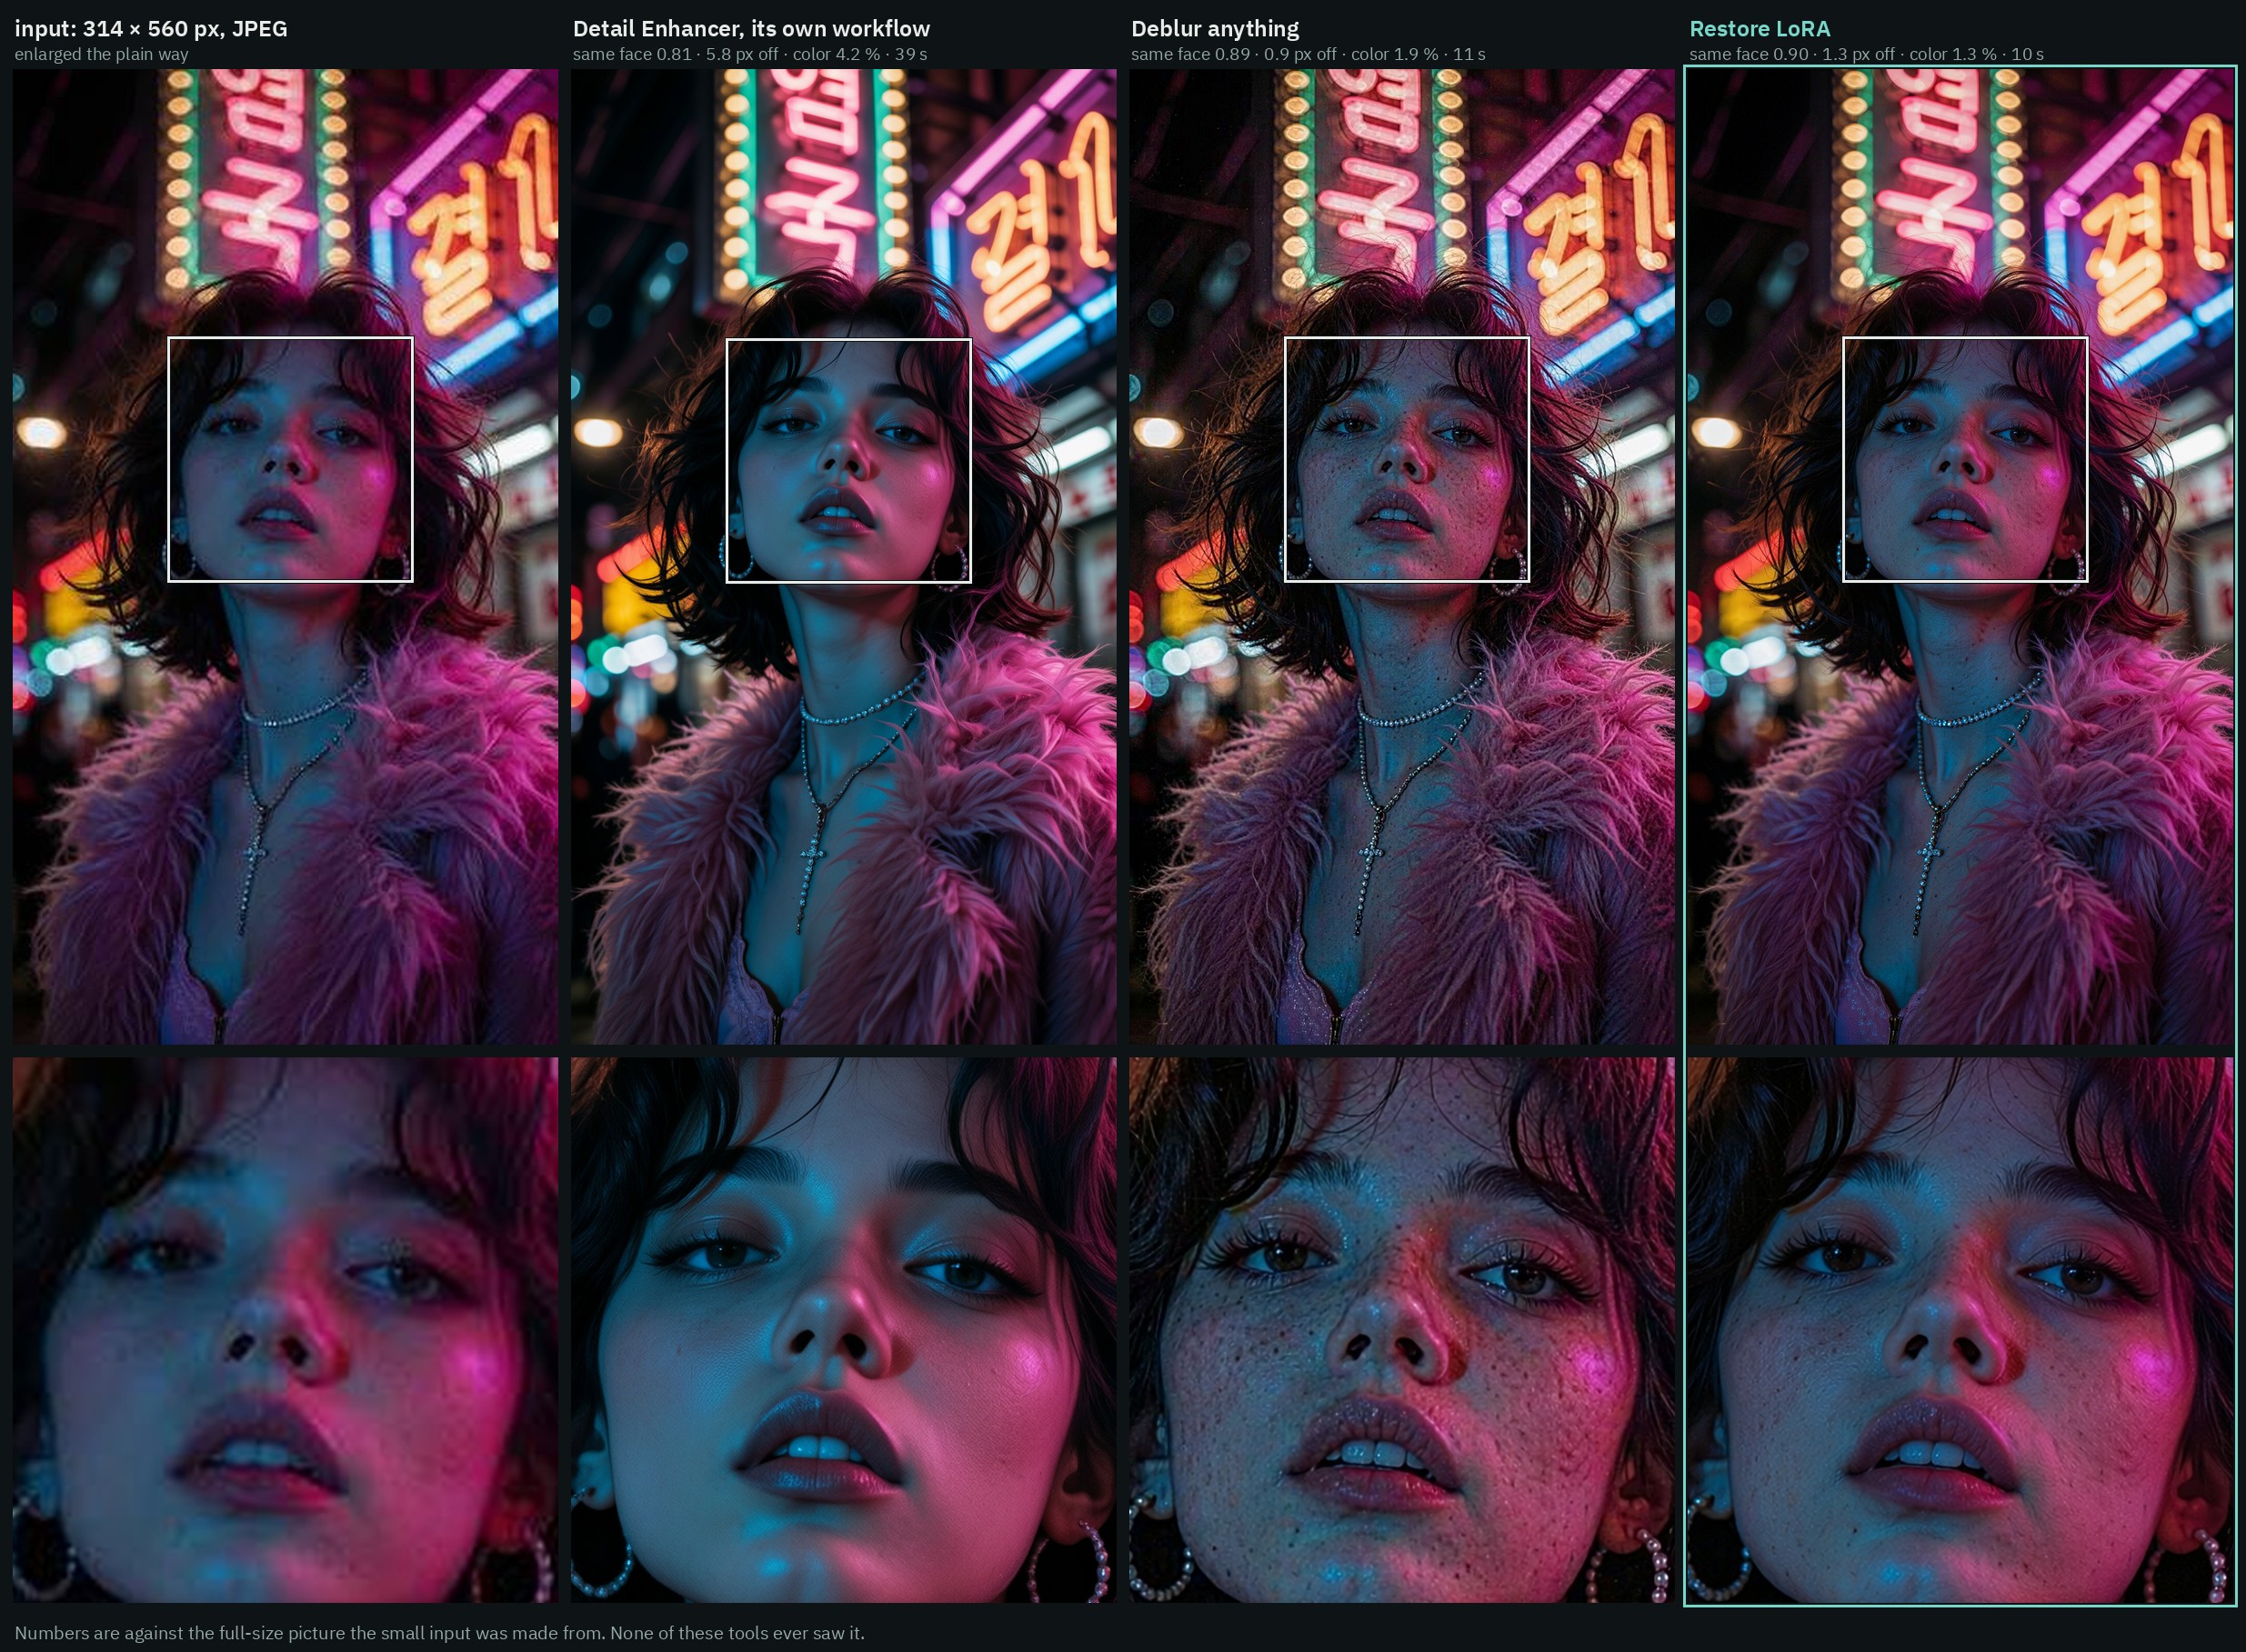
En SSIM, le LoRA est resté plus proche de l'original que le Detail Enhancer sur les 29 images (28 sur 29 quand le Detail Enhancer utilise son propre flux de travail), que Deblur anything, et que SeedVR2 sur 18 des 29. Il a mieux préservé le visage que le Detail Enhancer sur 28 sur 28, que Deblur anything sur 26 sur 28 et que SeedVR2 sur 27 sur 28. SeedVR2 est de loin le plus rapide, environ 3 secondes contre 11, et c'est lui qui tient le mieux les couleurs.
Quel fichier utiliser
| fichier | remarques |
|---|---|
qwen-image-2.1-restore.safetensors | étape 1 500, commencez ici. Le plus proche des deux sur les images de test de l'auteur. La peau ressort un peu lisse. |
qwen-image-2.1-restore-1250.safetensors | étape 1 250. Restitue davantage de détails fins et conserve plus de texture de peau sur les photos de téléphone bruitées. Un peu moins proche. |
Les deux sont de rang 32 et utilisent le nommage des clés ComfyUI, ils se chargent donc sur les poids Comfy-Org Qwen-Image 2.1 sans conversion.
Exécuter dans ComfyUI
L'adaptateur est un LoRA de type modèle uniquement, donc aucun nœud personnalisé n'est nécessaire pour la restauration elle-même. Placez le fichier .safetensors dans ComfyUI/models/loras/ et ajoutez un nœud LoraLoaderModelOnly après le chargeur de modèle, avec une force de 1.0, puis donnez à Qwen-Image 2.1 la petite image comme image 1 et la requête ci-dessus comme prompt. La configuration indiquée sur la carte est de 8 étapes avec Viggle Turbo à CFG 1, ou de 25 étapes sans lui.
Un flux de travail prêt à l'emploi est fourni dans le dossier workflows/ du dépôt, construit avec les nœuds ComfyUI-AusBoss de l'auteur, le même pack que celui utilisé par ses versions antérieures.
Limites
- C'est un redessin, pas une récupération. Les détails fins sont inventés pour s'ajuster, et le Qwen-Image 2.1 seul en dessine davantage.
- Rester fidèle à l'image est tout l'enjeu : un résultat qui nécessite du nouveau contenu ne l'obtiendra pas.
- Une entrée floue à pleine puissance revient tout en douceur. Descendez à 0.5, ou agrandissez en mosaïque.
- Les chiffres proviennent des propres images de test de l'auteur et de 25 étapes sans Turbo sur une partie de l'ensemble de comparaison.
- Pour des résultats supérieurs à 2 MP, l'auteur l'associe à son propre flux de travail d'upscale en mosaïque sur Civitai.
Disponibilité
- Poids LoRA : ausboss/Qwen-Image-2.1-Restore-LoRA
- Nombres par image : comparison_numbers.csv
- Repackage du Modèle de base : Comfy-Org/Qwen-Image-2.1
- Pack de Nœuds de l'Auteur : ausboss/ComfyUI-AusBoss
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.