Qwen-Image 2.1 Outfit Swap LoRA : cadre constant en ComfyUI
Un LoRA pour Qwen-Image 2.1 applique l'échange de tenue sur l'image d'origine : cadrage, visage et arrière-plan restent, seuls les vêtements changent, avec un flux ComfyUI.
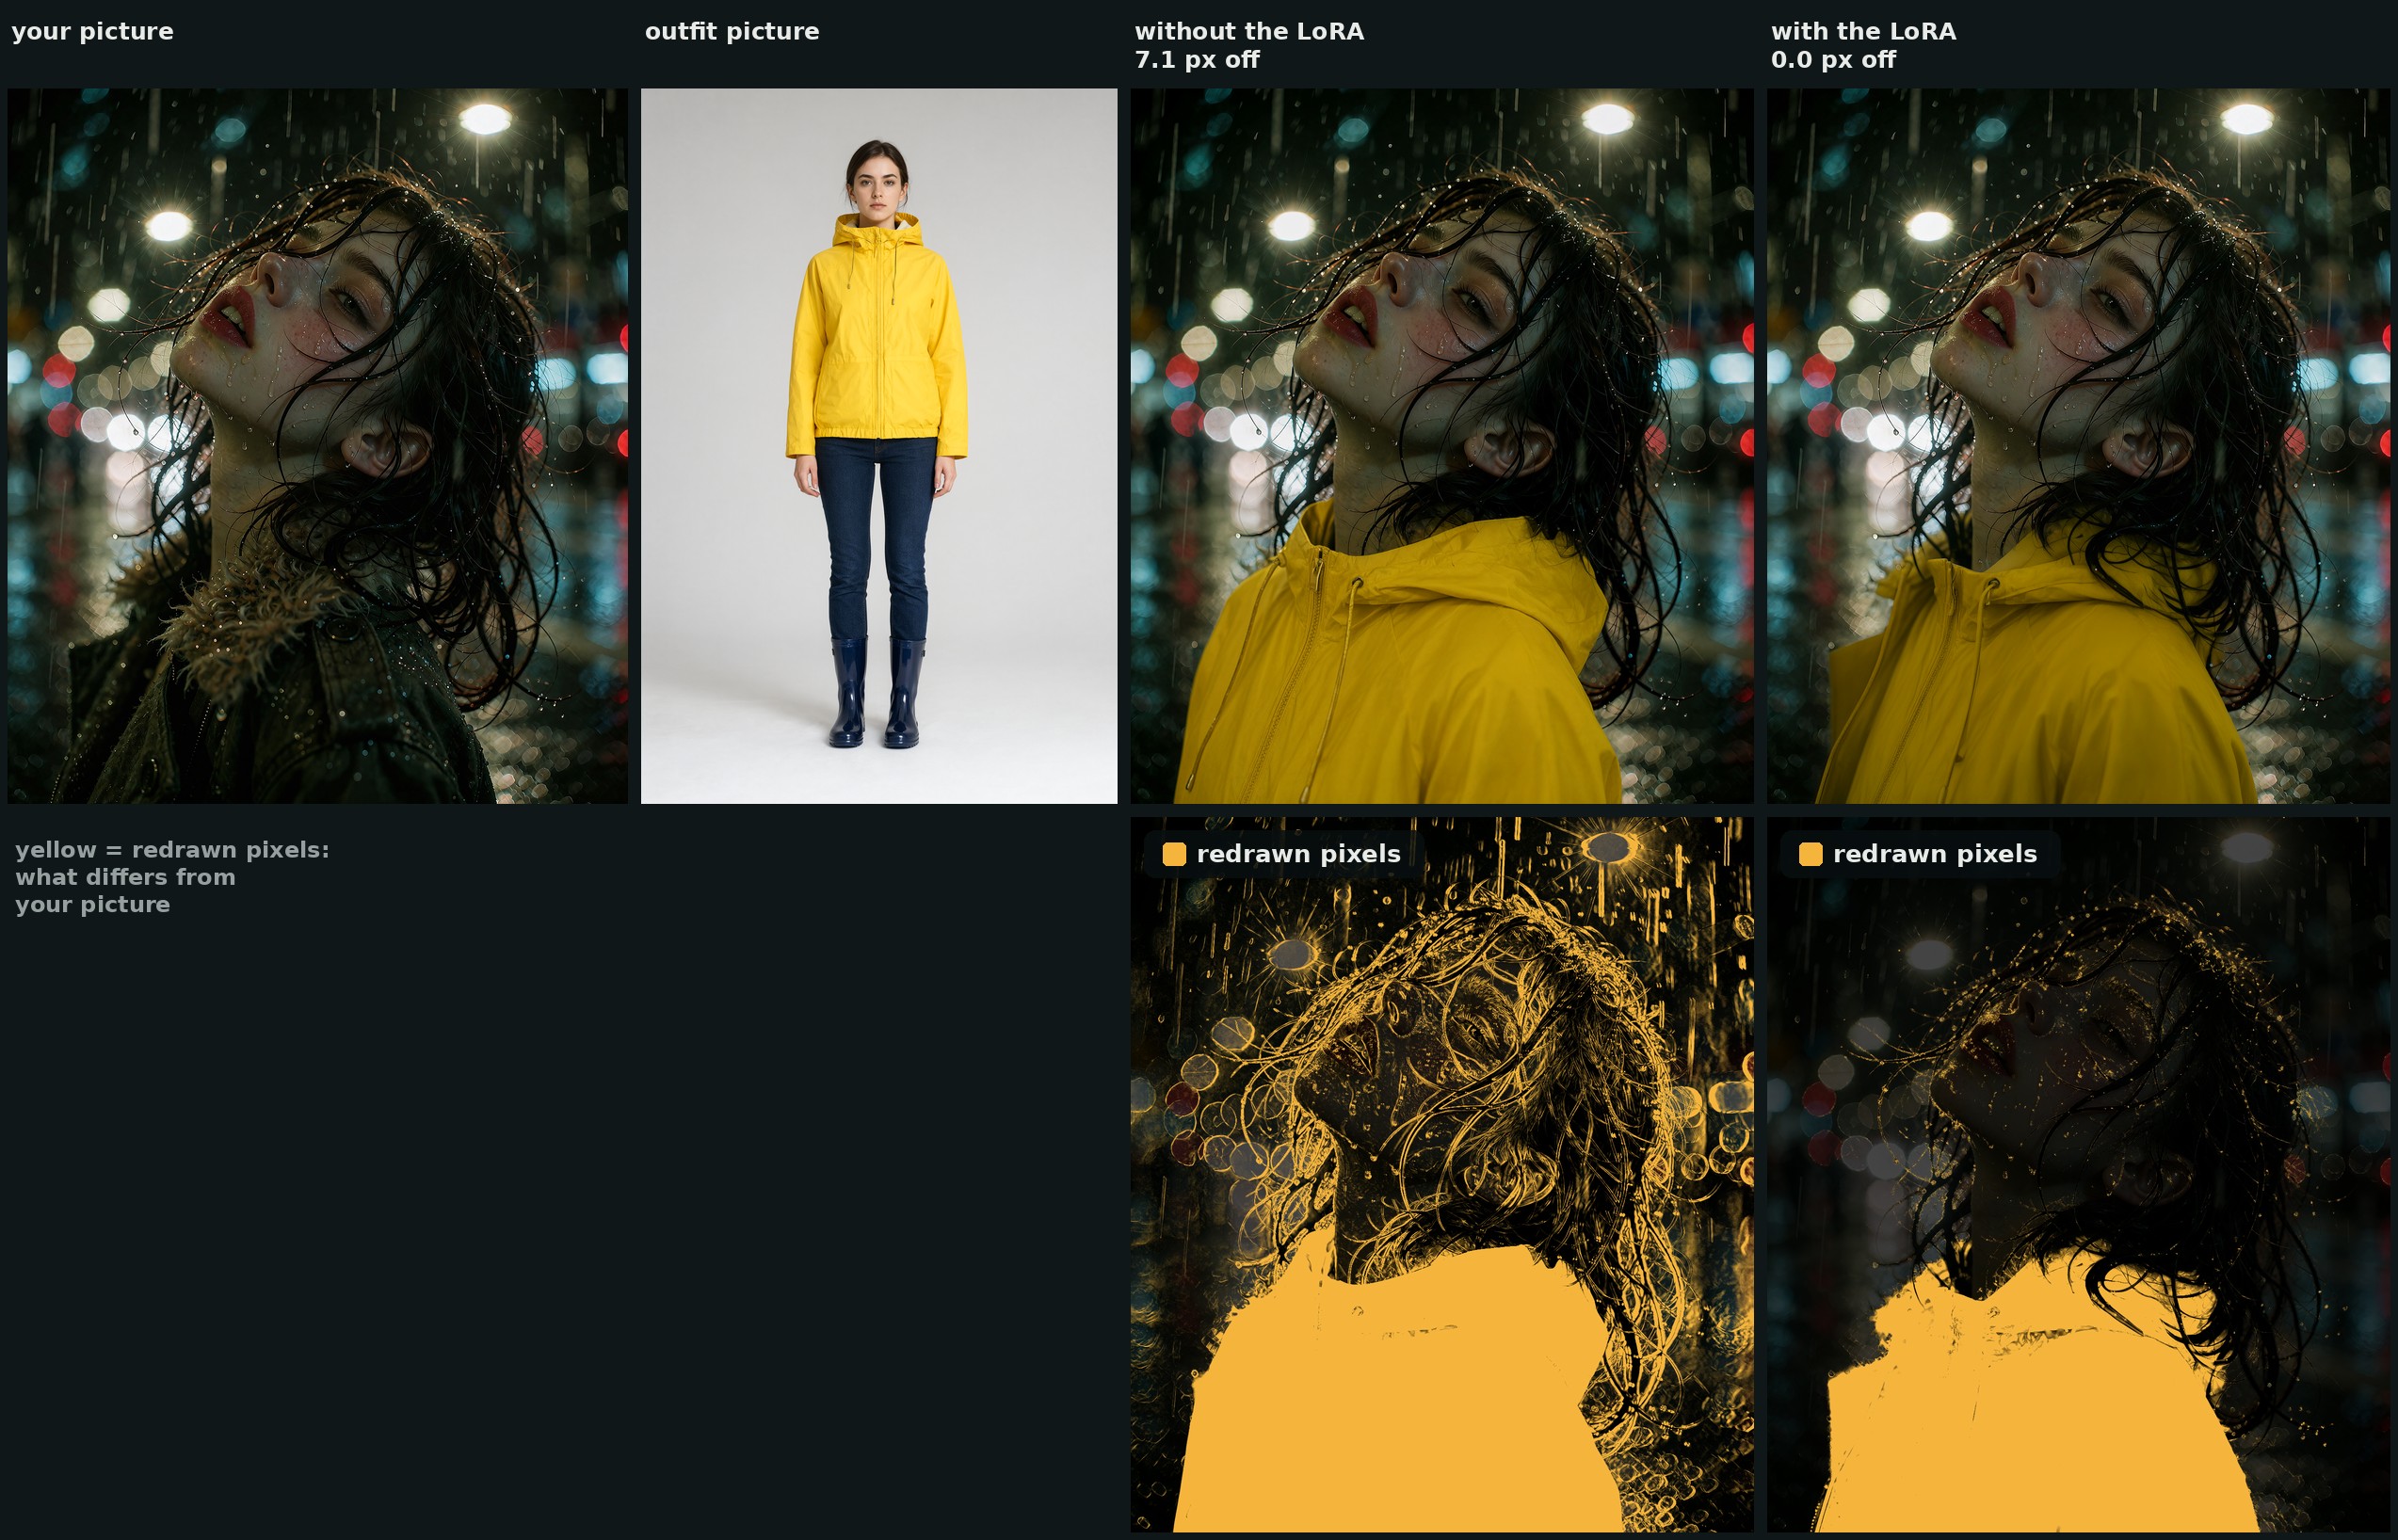
Ligne du haut : l'échange, même requête et même graine. Ligne du bas : les pixels redessinés en jaune. Sans le LoRA, le visage, la fenêtre et le mur s'allument ; avec lui, seul le manteau diffère. Ni cette personne ni ce manteau ne figurent dans le jeu d'entraînement.
Ce que Qwen-Image 2.1 standard rate
Chaque édition avec Qwen-Image 2.1 est une génération complète, donc un échange de tenue recompose bien plus que les vêtements. L'auteur a réalisé 47 échanges avec Qwen-Image 2.1 standard et les a tous jugés à l'œil : 24 étaient utilisables, et les 23 autres présentaient un défaut. Le plus souvent, le problème ne venait pas de la tenue elle-même :
- la caméra reculait pour faire tenir toute la tenue dans le cadre,
- un pantalon était ajouté à une prise de vue qui ne contenait aucune jambe,
- le corps ou la pose était redessiné pour porter les nouveaux vêtements,
- ou tout était simplement décalé de quelques pixels.
Comparé à la photo de la personne, le résultat standard s'écartait d'environ 3,4 px au pire coin. C'est peu, mais cela signifie que le résultat ne peut pas être superposé à l'original : le visage est redessiné un peu plus doux et l'arrière-plan est repeint même là où rien n'a été demandé. Maintenir la pose avec un ControlNet gardait la scène en place, mais la tenue ne s'appliquait pas dans environ un échange sur cinq, donc cette approche a été abandonnée.
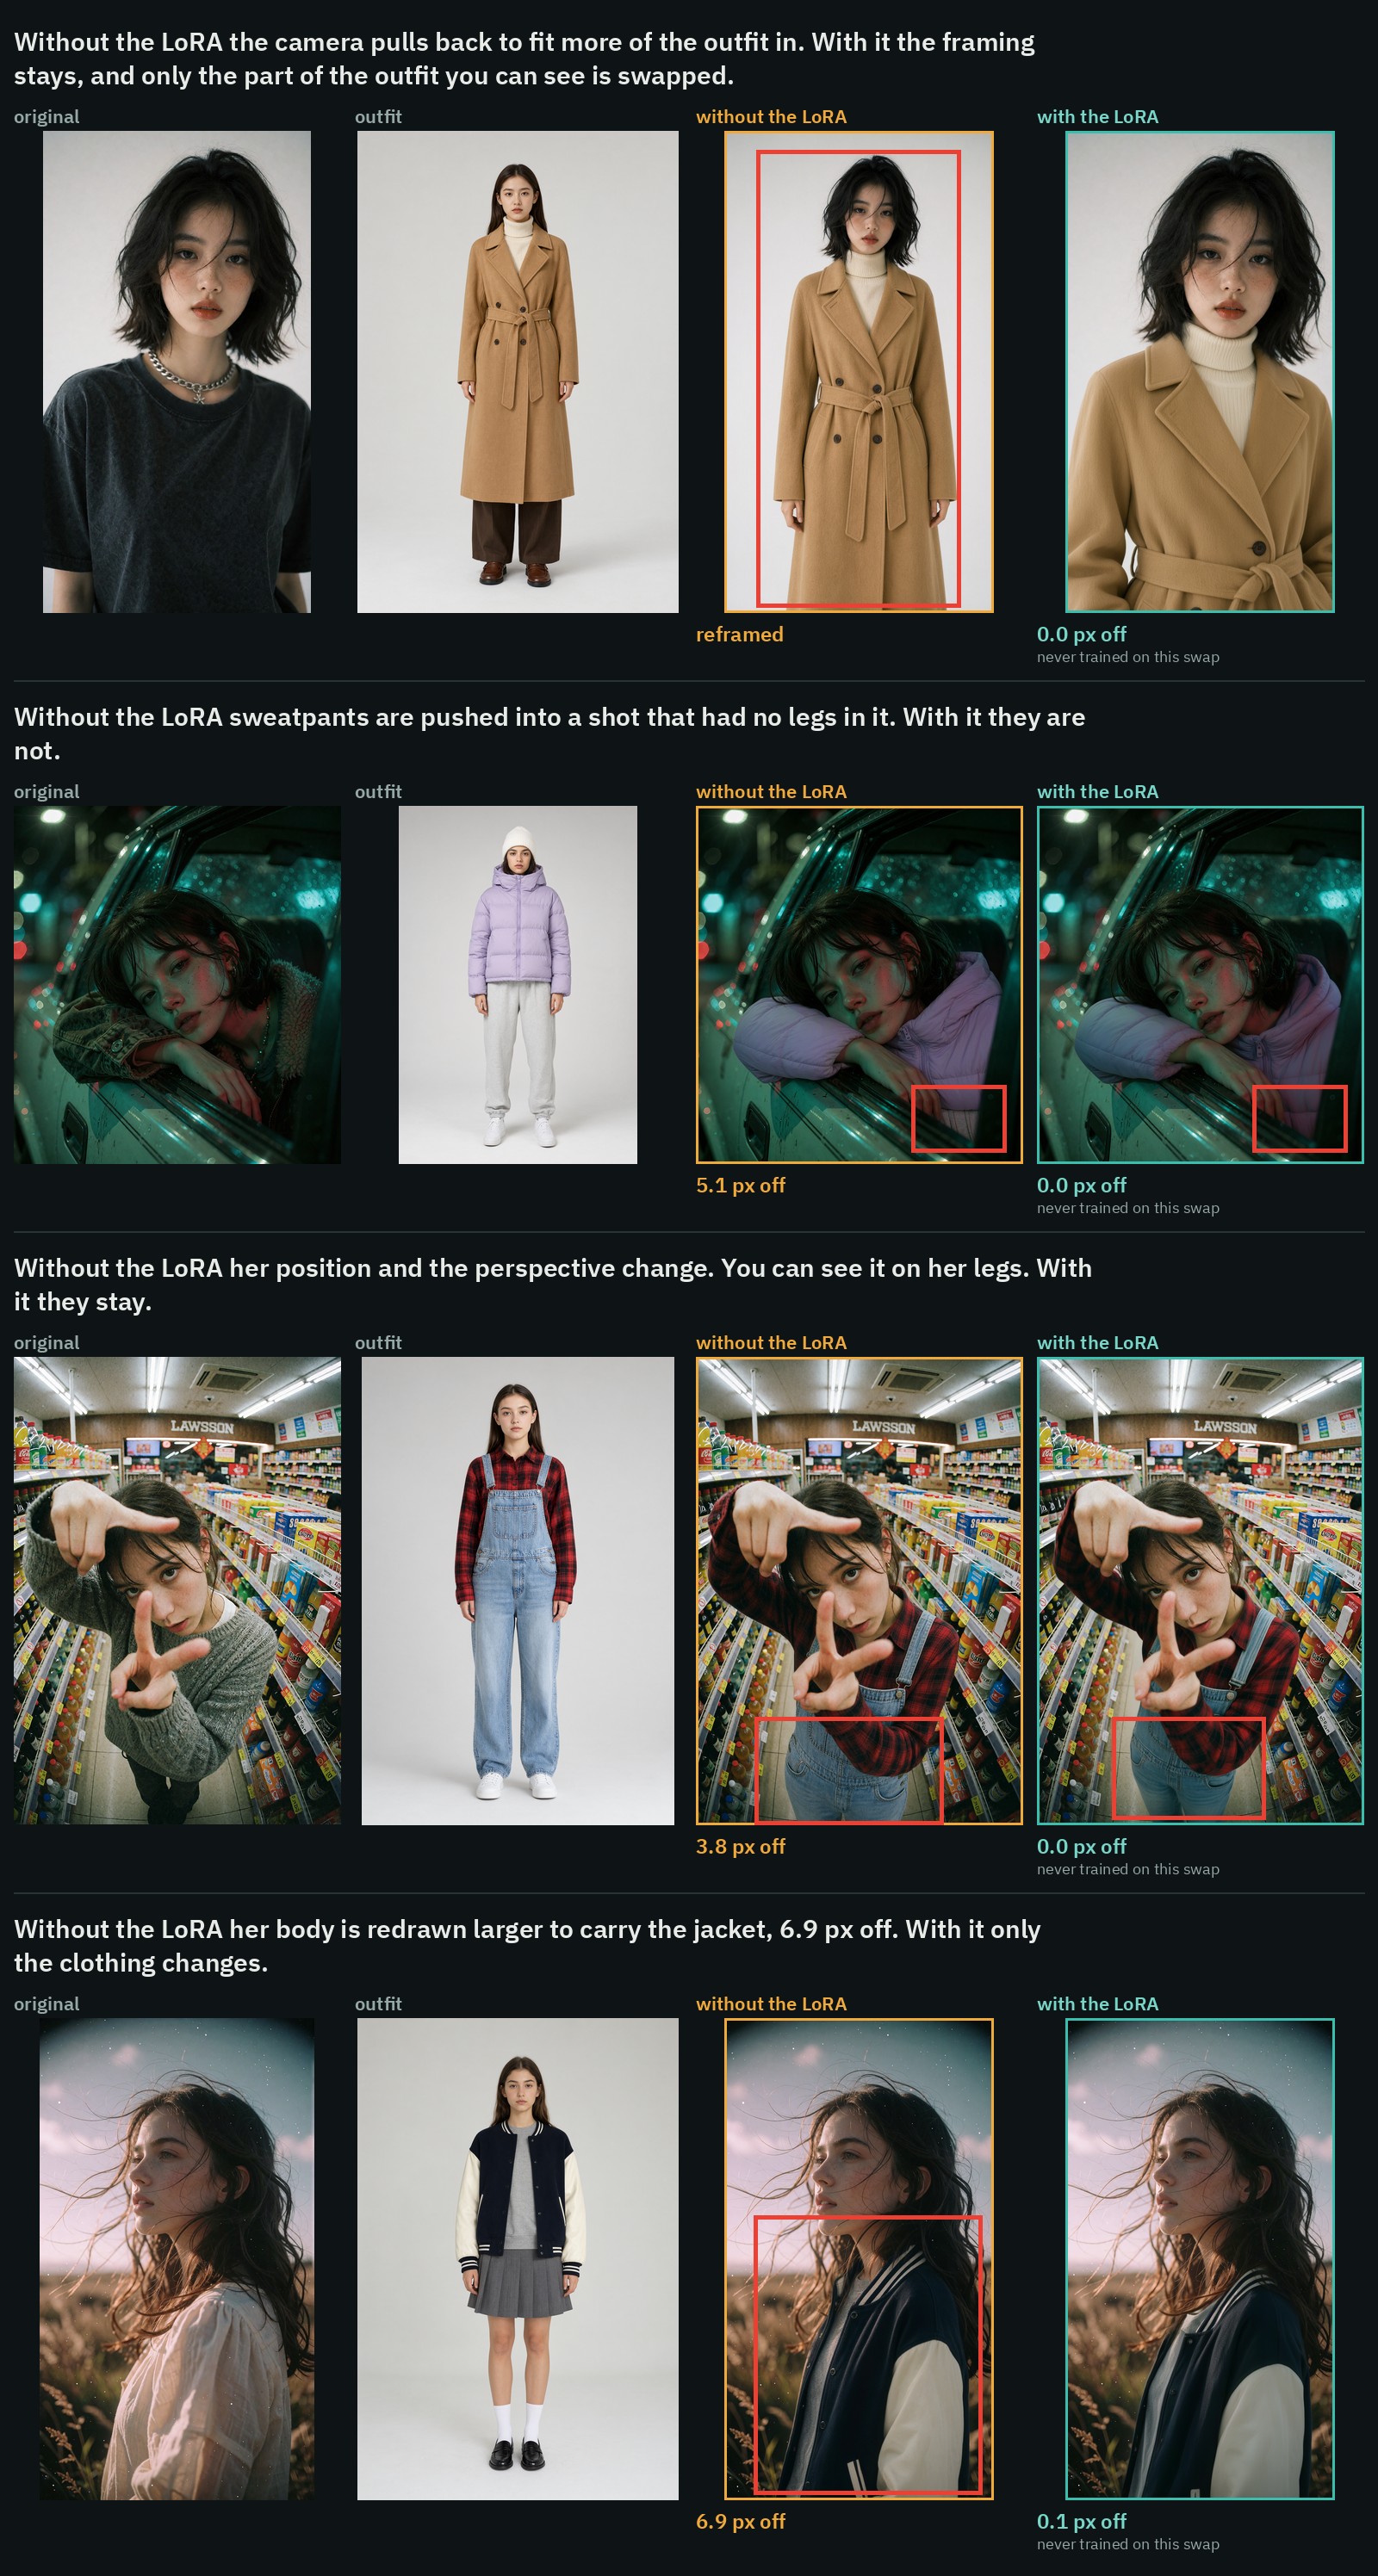
Quatre de ces 47 échanges, avec le même flux de travail et la même graine, sans le LoRA puis avec. Aucun d'eux ne figure dans l'ensemble d'entraînement.
Maintien mesuré
Seize échanges de tenue que la LoRA n'a jamais vus à l'entraînement, tous exécutés via le même flux de travail à environ 2 MP avec la même graine, 25 étapes, CFG 1, euler / simple, adapter à 1.0. « Off » correspond à la distance entre le coin le plus mal placé du résultat et la photo de la personne. Les valeurs du visage et de l'arrière-plan sont relevées après alignement du résultat sur la photo de la personne ; elles mesurent donc le repaint, et non la dérive :
| seize échanges tenus à l'écart | sans LoRA | étape 1,000 | étape 1,250 | étape 1,500 |
|---|---|---|---|---|
| écart du pire coin, médiane | 3.6 px | 0.1 px | 0.1 px | 0.1 px |
| écart du pire coin, pire des seize | 7.0 px | 0.2 px | 0.2 px | 0.2 px |
| pixels du visage ayant nettement changé | 14.1 % | 1.7 % | 1.8 % | 2.0 % |
| visage, PSNR par rapport à la photo de la personne | 29.8 dB | 37.8 dB | 37.7 dB | 37.1 dB |
| pixels de l'arrière-plan ayant nettement changé | 10.8 % | 0.9 % | 0.9 % | 1.2 % |
| arrière-plan, PSNR | 27.6 dB | 40.5 dB | 40.4 dB | 40.0 dB |
La force compte : l'étape 500 à 0.5 présentait un écart de 1.8 px, contre 0.1 px à 1.0 ; la moitié de la force rend donc environ la moitié de la dérive. À partir de 500, toutes les étapes maintiennent l'image de la même manière d'après les chiffres. Ce qui les distingue, c'est ce qui advient des vêtements que la nouvelle tenue ne couvre pas.
Pour référence, les quatre comparaisons simples ci-dessus présentaient un écart de 4.8, 7.1, 5.2 et 7.2 px sans la LoRA, et de 0.1, 0.0, 0.0 et 0.1 px avec elle.
Que deviennent les anciens vêtements
Le Qwen-Image 2.1 seul laisse souvent en place tout ce que la nouvelle tenue ne couvre pas : des bottes sous un bikini, un jean déchiré sous une jupe. L'étape détermine la majeure partie de cela. Deux échanges, trois seeds chacun, requête simple :
| jean retiré sous la nouvelle jupe | bottes retirées avec le bikini | |
|---|---|---|
| sans LoRA | 0 sur 3 | 0 sur 3 |
| étape 500 | 0 sur 3 | 0 sur 3 |
| étape 1 000 | 2 sur 3 | 2 sur 3 |
| étape 1 250 | 0 sur 3 | 0 sur 3 |
Une phrase à la fin de la requête oriente davantage le résultat à l'étape 1 000. Replace everything they wear. a retiré les collants sous un maillot de bain (les chaussures sont restées), et Keep their own shoes and legwear. a conservé des bottes que la requête simple avait retirées. Aucune de ces phrases ne figurait dans les légendes d'entraînement, donc c'est le modèle de base qui écoute pendant que le LoRA maintient le reste de l'image fixe. Aux étapes 1 250 et 1 500, les mêmes phrases ont fait peu ou pas de différence, ce qui constitue l'autre raison pour laquelle la version publiée indique l'étape 1 000. Le Flux de travail livré ajoute Replace everything they wear. par défaut, dans une boîte que vous pouvez modifier.
Quel fichier utiliser
| fichier | notes |
|---|---|
qwen-image-2.1-outfit-swap.safetensors | étape 1 000, commencez ici. Celui qui supprime le plus souvent l'ancienne tenue au lieu d'en laisser des morceaux. |
qwen-image-2.1-outfit-swap-1250.safetensors | étape 1 250. Préserve l'image tout aussi bien. Conserve davantage de ce que la personne porte déjà (bottes, jean sous une jupe). |
qwen-image-2.1-outfit-swap-1500.safetensors | étape 1 500, la fin de l'entraînement. La même rétention, avec un peu plus de changement sur le visage et l'arrière-plan. |
Les trois sont en rank 32 et utilisent le nommage des clés de ComfyUI, ils se chargent donc sur les poids Qwen-Image 2.1 de Comfy-Org sans conversion.
L'exécuter dans ComfyUI
L'adaptateur est un LoRA de type model-only : aucun nœud personnalisé n'est nécessaire pour l'échange lui-même. Rédigez la requête en une seule phrase, avec la personne comme image 1 et la tenue comme image 2 :
Dress the person in image 1 in the <outfit, in a few words> shown in image 2. Keep their face, hair, hands, pose and the background exactly the same.Pour l'ajouter à n'importe quel graphique d'édition Qwen-Image 2.1 à deux images :
- Placez le fichier
.safetensorsdansComfyUI/models/loras/et ajoutez un nœud LoraLoaderModelOnly juste APRÈS le chargeur de modèle, avec une force de 1.0. - Utilisez un nœud Text Encode Qwen Image 2.1 avec la personne en
image_1, la tenue enimage_2, laresolutionà 0 et la requête comme prompt. - Échantillonnez à partir de la sortie
latentde l'encodeur avec KSampler à 25 étapes, CFG 1,euler/simple, denoise 1. - Décodez avec VAE Decode puis Diviser l'image avec Alpha, car le VAE de Qwen-Image 2.1 décode en RGBA.
Un flux de travail prêt à l'emploi est fourni avec le dépôt. Il a été construit avec les nœuds ComfyUI-AusBoss de l'auteur (2.5.1 ou plus récent) et nécessite ComfyUI 0.38 ou plus récent ; la carte précise que tout nœud équivalent convient.
Une comparaison côte à côte des mêmes échanges sans et avec le LoRA, issue de la carte du modèle.
Plus de comparaisons
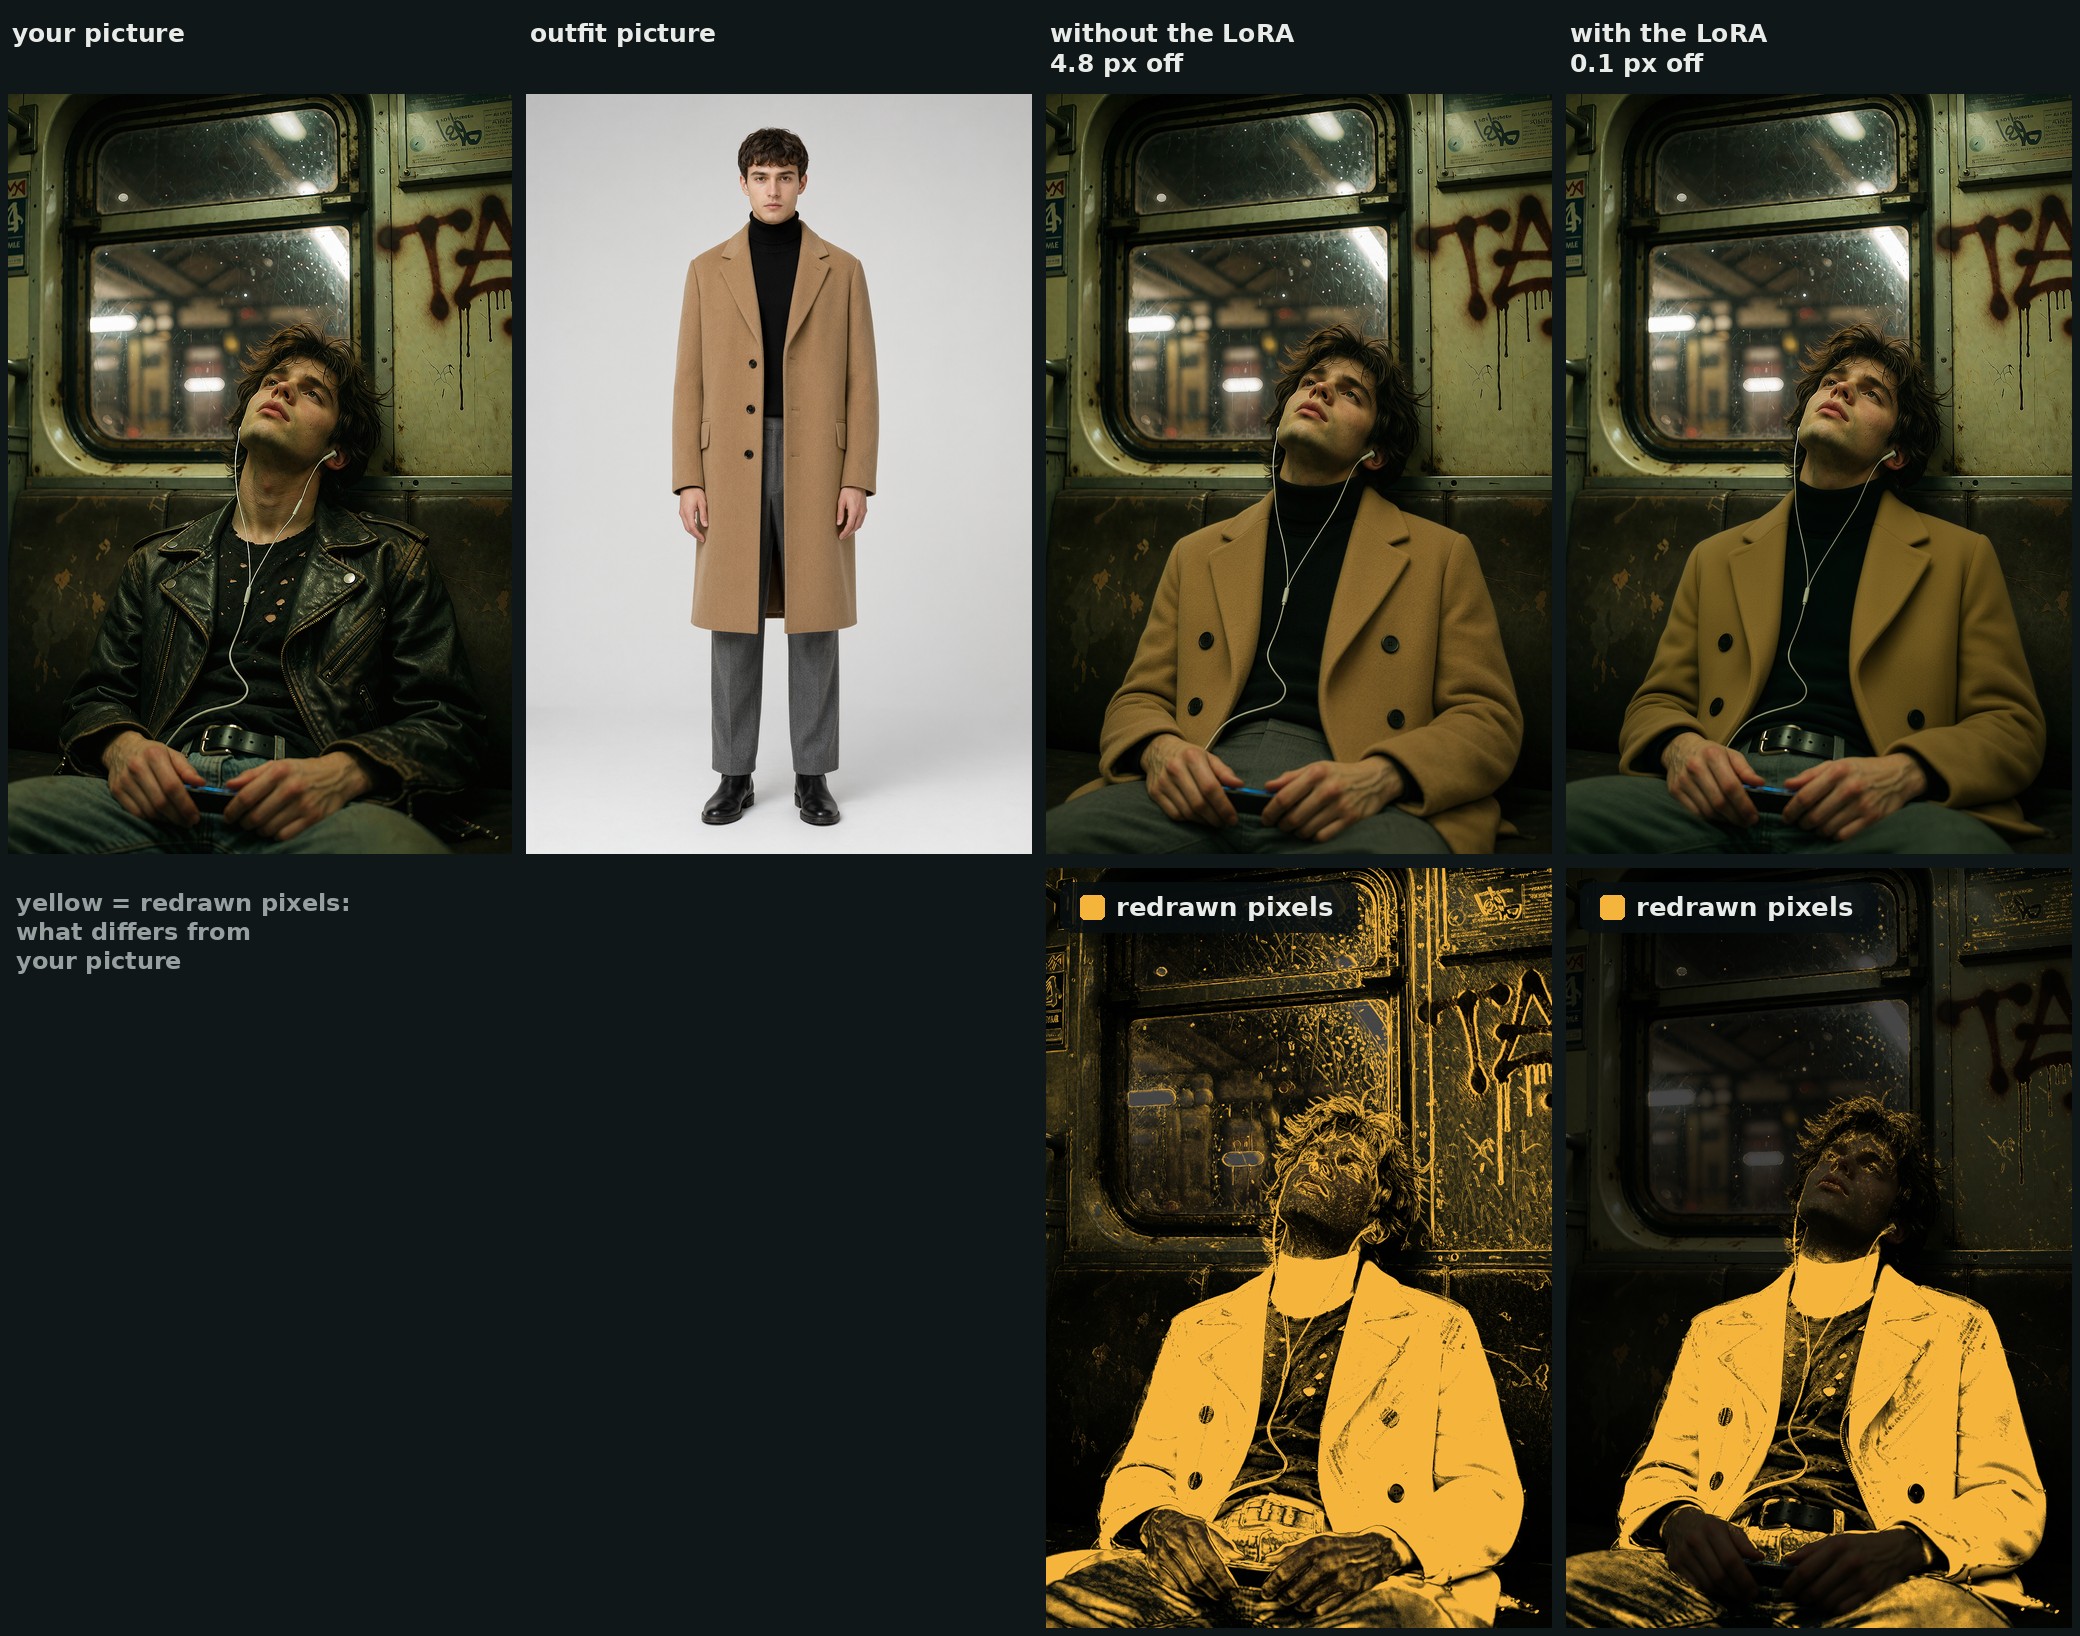
La même comparaison sous la pluie. Cette personne ne fait pas partie de l'ensemble d'entraînement.
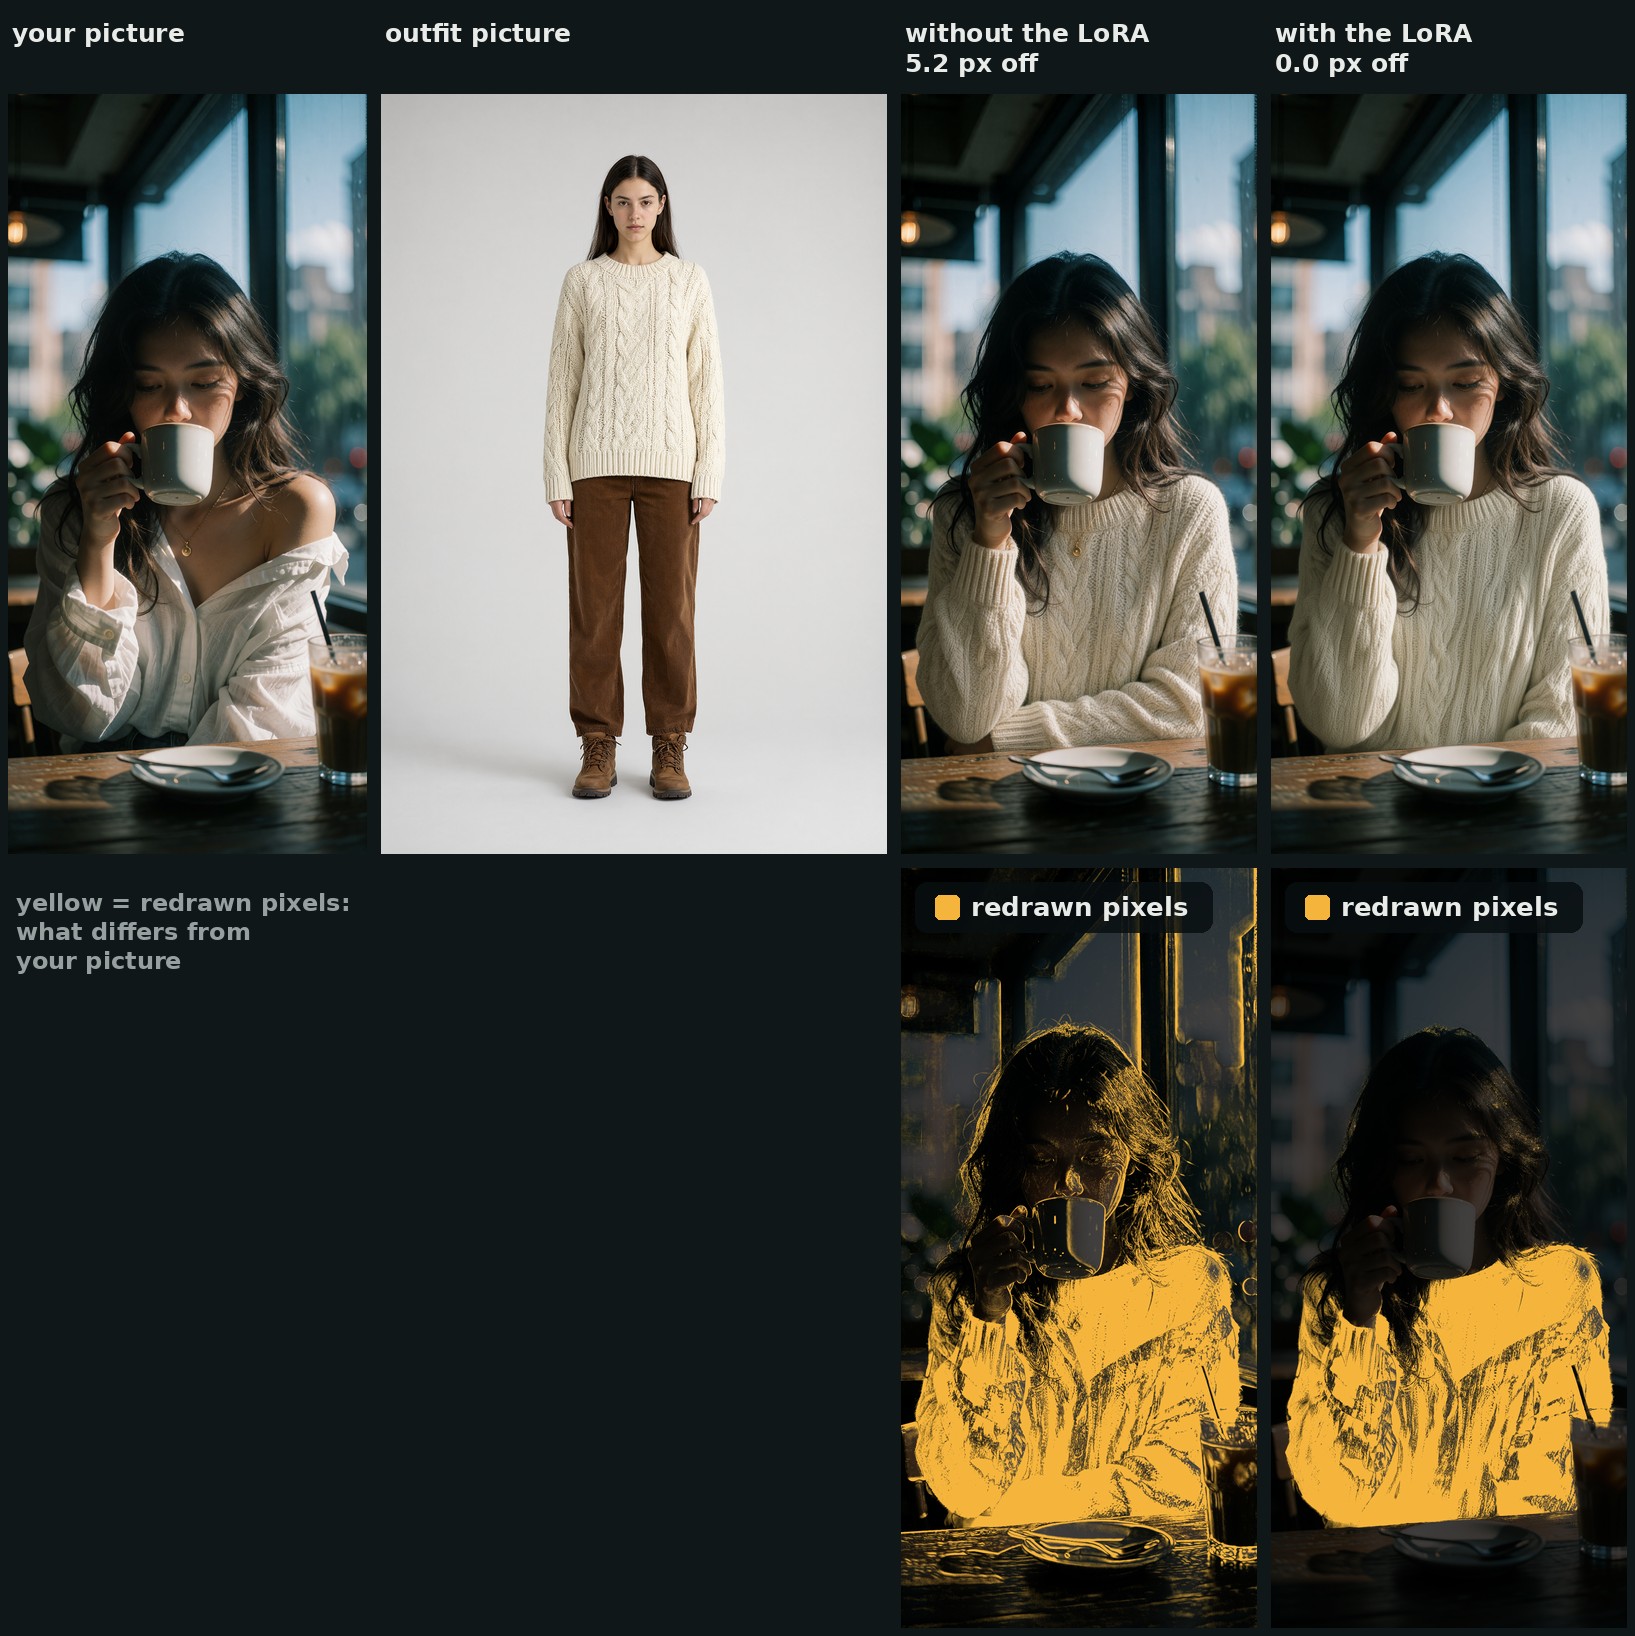
Cette personne ne fait pas non plus partie de l'ensemble d'entraînement.
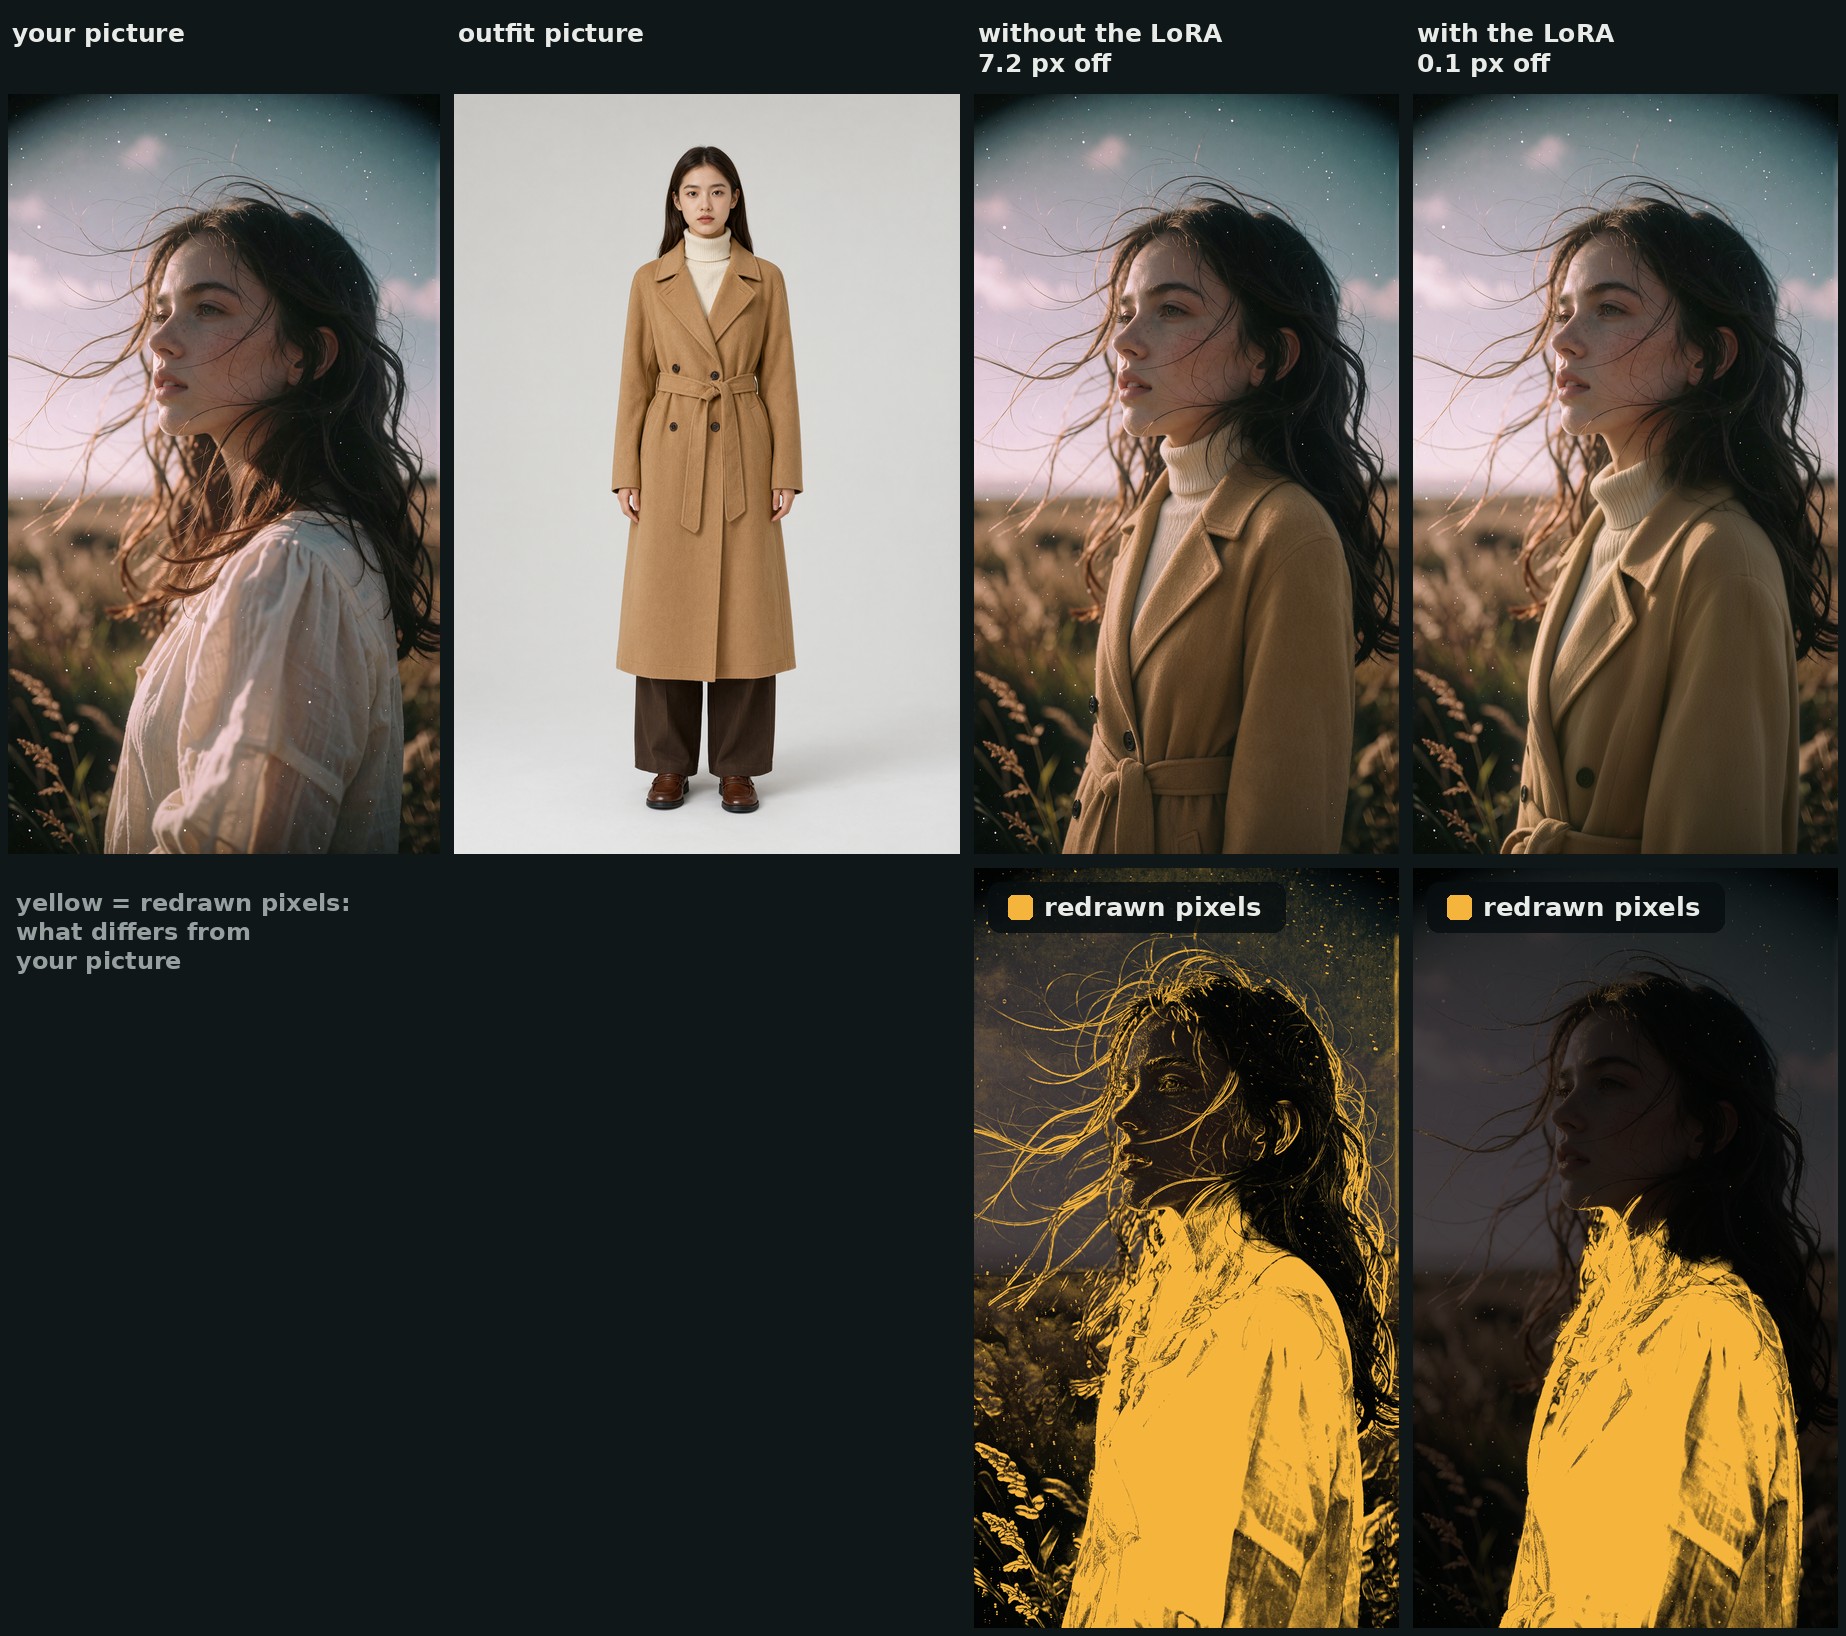
Le LoRA n'a jamais été entraîné sur un échange concernant cette personne, et ce manteau ne fait pas partie de l'ensemble d'entraînement.
Comment il a été entraîné
Le jeu de données est construit à partir de vrais swaps Qwen-Image 2.1, puis corrigé afin que chaque cible d'entraînement repose sur le cadre de sa source. Un swap brut n'est pas une bonne cible : il porte la dérive, le visage adouci et l'arrière-plan repeint, et un LoRA entraîné dessus les apprend. Chaque résultat est replacé sur l'image de la personne au pixel entier près (jamais rééchantillonné), et seuls les vêtements proviennent du swap. Le visage, les cheveux, les mains et l'arrière-plan sont de nouveau les pixels propres de l'image de la personne. Sur les 66 cibles d'entraînement, 40 provenaient de swaps réalisés avec le LoRA Consistency antérieur de l'auteur activé et 26 de swaps ordinaires ; 22 ont nécessité un déplacement en pixels entiers, et la cible médiane tire 27 % de ses pixels du swap.
- 66 paires d'entraînement utilisant 45 personnes différentes et 31 tenues différentes (portées, à plat, photos produit), quatre paires mises de côté pour les tests.
- Entraînement : ostris/ai-toolkit avec
arch: qwen_image_2sur la base INT8 ConvRot de Comfy-Org, deux références par exemple (personne et tenue), légendes à dropout 0. Rank 32, alpha 32, AdamW8bit à lr 1e-4, lot 1, timestepsshift, 1 500 étapes avec des checkpoints tous les 250, sur une RTX PRO 6000 à environ 4,5 s par étape.
Un détail du trainer a coûté un run et est documenté dans le RESEARCH.md du dépôt. AI-Toolkit fait tenir une cible d'entraînement dans un bucket de taille en la redimensionnant et en la recadrant, mais charge une image de référence entière et la comprime sur la grille de 32 px. Quand la forme de l'image n'est pas celle d'un bucket, les deux cessent de s'aligner : à resolution: 1024, les paires 1056 x 1888 aboutissent sur du 768 x 1344, si bien que la cible perd 2 % de sa hauteur tandis que la référence est comprimée de 2 % à la place. Le premier run s'est entraîné correctement d'après sa loss et a produit un LoRA qui rendait chaque image 1,6 % plus haute. Le correctif se trouve dans l'exportation plutôt que dans le trainer : écrire la cible et la référence qui doivent s'aligner à la même taille, les deux côtés étant un multiple de 32.
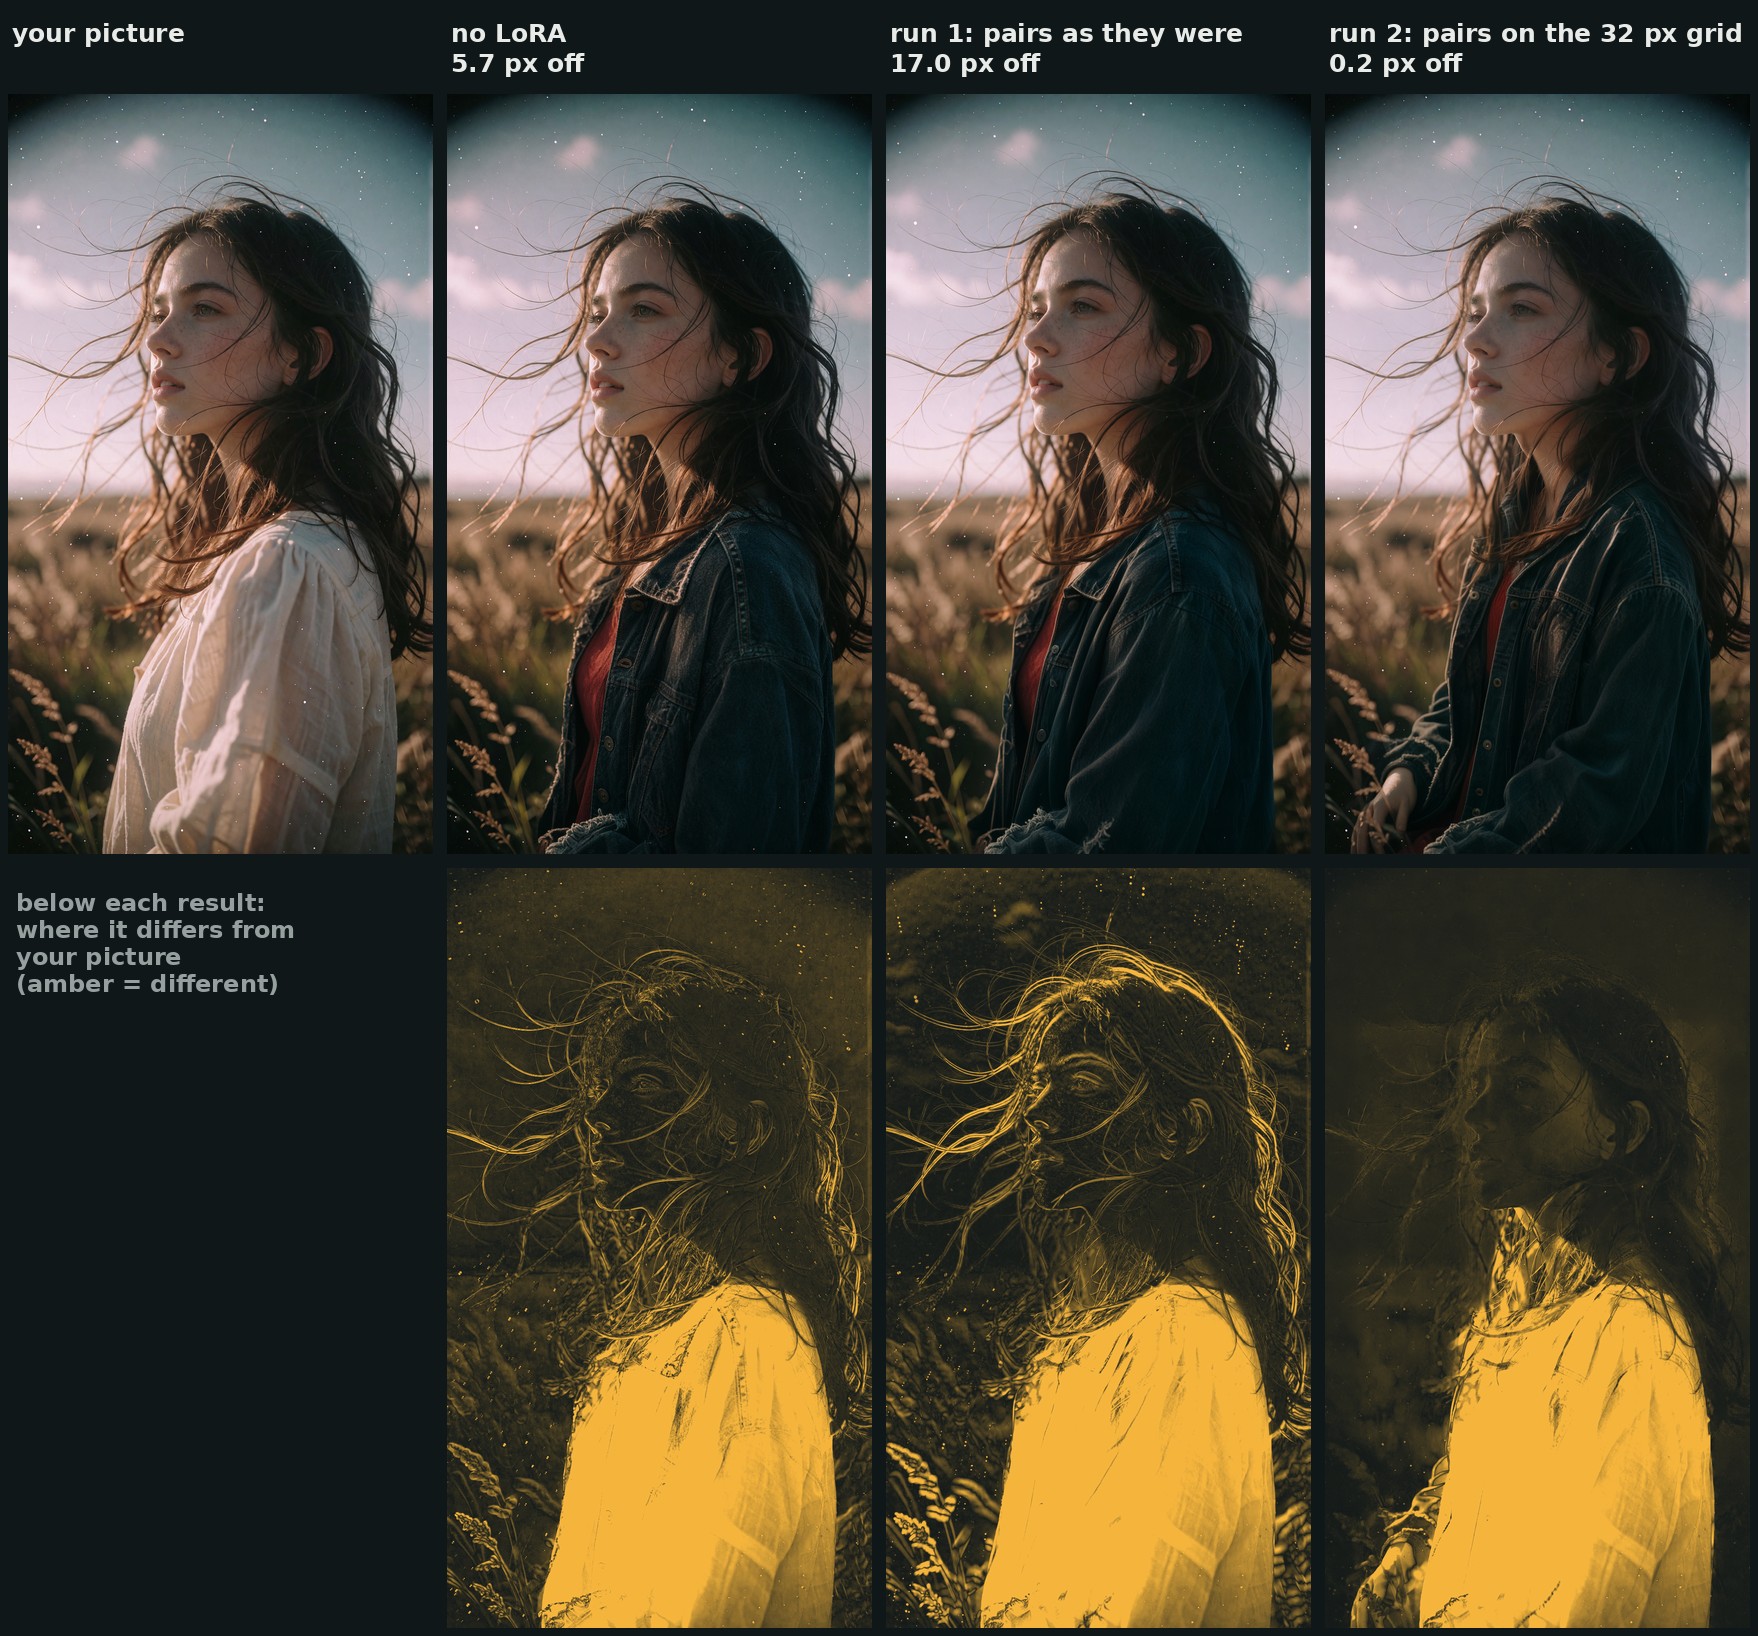
À l'étape 250, le premier run étire l'image, donc tout diffère de l'original. Le run corrigé, non.
Limites
La carte est directe sur le périmètre restreint de cette publication :
- Il ne dessine pas mieux la tenue que Qwen-Image 2.1 seul. Les boutons, les ceintures et les motifs sortent comme ils sortiraient de toute façon, et Qwen seul copie parfois davantage la tenue : dans la première comparaison ci-dessus, il a aussi remplacé le pantalon, là où le LoRA a conservé l'ancien jean et la ceinture.
- Il s'accroche à ce qui était là, donc il conserve aussi la pose. Une tenue qui demanderait une pose différente n'en obtiendra pas.
- Les chaussures sont la partie récalcitrante. Même avec
Replace everything they wear., une paire de chaussures est restée en place lors d'un des trois remplacements testés. - Un checkpoint précoce (étape 250) a dessiné une main qui n'était pas sur l'image lors d'un remplacement. Les étapes 500 à 1 500 ne l'ont fait sur aucun des seize, mais seuls seize ont été vérifiés.
- Entraîné à environ 1 MP et testé à environ 2 MP, 25 étapes, CFG 1.
- Avec le LoRA Viggle Turbo à 8 étapes, il tient toujours l'image (0,05 à 0,24 px sur cinq remplacements), même si un tissu uni peut sortir un peu granuleux.
- Les éléments qui passent par-dessus les vêtements peuvent partir avec l'ancienne tenue ou se poser bizarrement sur la nouvelle : un câble d'écouteurs par-dessus une veste a été supprimé, et une bandoulière de sac rendait mal par-dessus une nouvelle veste.
Disponibilité
- Poids LoRA : ausboss/Qwen-Image-2.1-Outfit-Swap-Consistency-LoRA
- Repack du Modèle de base : Comfy-Org/Qwen-Image-2.1
- Pack de Nœuds de l'Auteur : ausboss/ComfyUI-AusBoss
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.