Zen Image Edit : Qwen-Image 2.1 sur un encodeur 0.8B dans ComfyUI
Zen Image Edit fait tourner Qwen-Image 2.1 sur un encodeur Qwen3.5-0.8B plus un adaptateur de fusion de 158M, l'encodeur passant de 17,5 Go à 1,7 Go, avec deux méthodes ComfyUI.
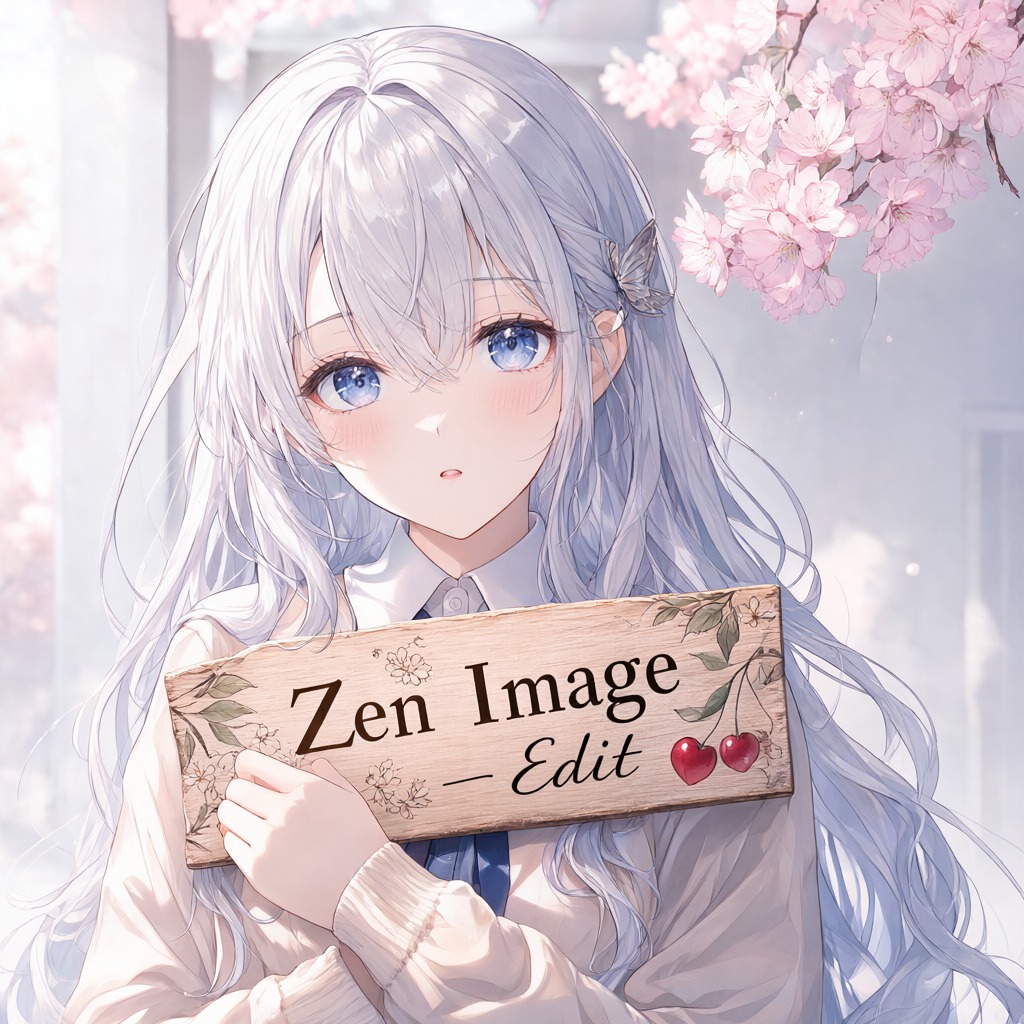
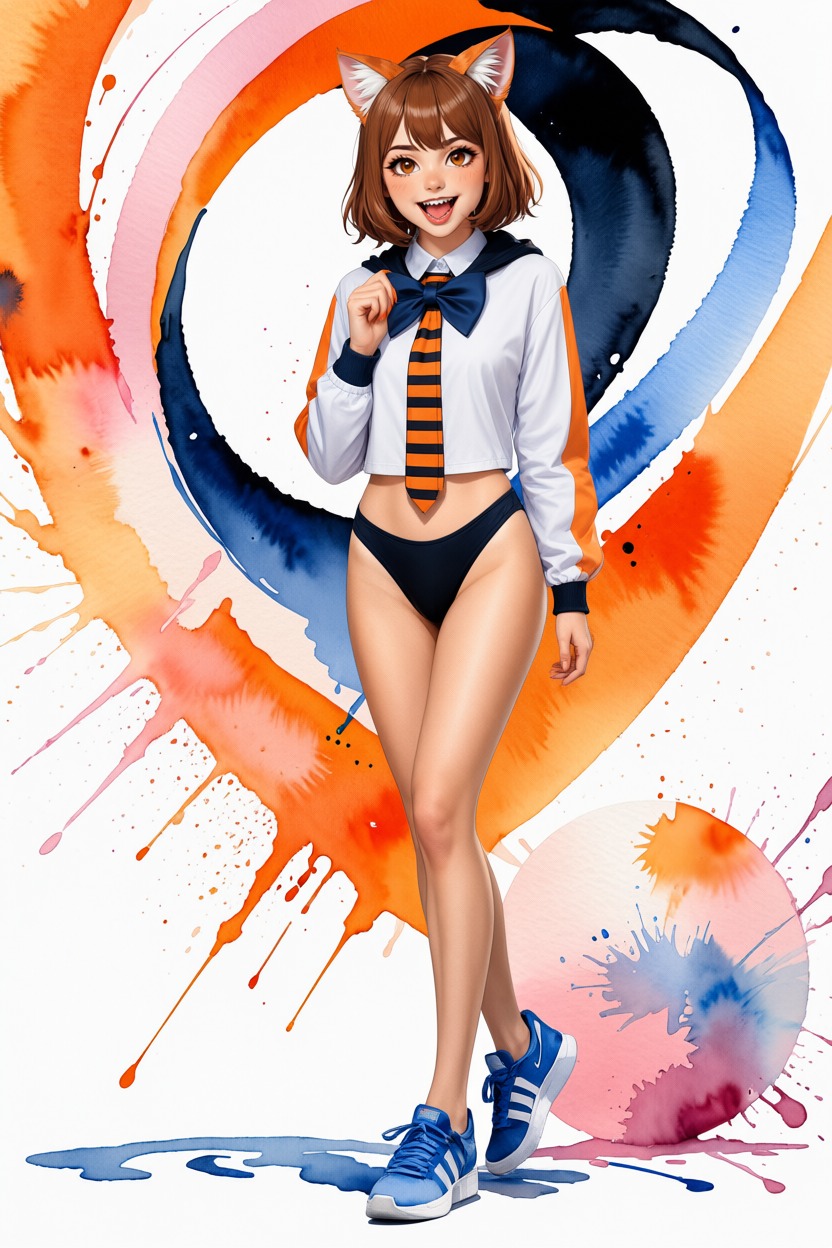
Text-to-image à 1024 px, 30 étapes, généré par le pipeline. Source : AiArtLab/zen-image-edit.
Ce que Zen Image Edit change
La pile de conditionnement de Qwen-Image 2.1 est ce qui la rend coûteuse à garder en mémoire : l'encodeur de texte du modèle de base est Qwen3-VL-8B, à environ 17,5 Go en fp16, et il doit tenir à côté d'un DiT de 14,5 Go. Zen Image Edit le remplace par un petit encodeur multimodal et un adaptateur qui imite ce que produisait le grand, aussi bien à partir de texte seul qu'à partir de texte lu conjointement avec des images de référence.
| Composant | Zen Image Edit |
|---|---|
| Transformateur | DiT Qwen-Image 2.1, 32 calques, 14,5 Go fp16, avec l'adaptateur de fusion de texte de 158M fusionné |
| Encodeur de texte | Qwen3.5-0.8B, 1,7 Go fp16, tokenizer et processeur inchangés |
| Fidélité du conditionnement | cosinus 0,95 sur le texte, 0,97 sur les positions vision des prompts d'édition, face à l'encodeur Qwen3-VL-8B natif |
| VAE | décodeur Qwen-Image 2.1 affiné, 16x spatial, fp32 |
| Échantillonneur | FlowMatchEulerDiscreteScheduler, décalage statique simple 5.0 |
| VRAM de pointe | environ 17,5 Go résidents, moins avec enable_model_cpu_offload() |
L'adaptateur réside à l'intérieur du DiT en tant que bloc de fusion de texte, de sorte que le modèle entier est un seul dossier Diffusers autonome et qu'aucun encodeur séparé de 17,5 Go n'est nécessaire. L'échantillonneur utilise un décalage statique simple de 5.0 au lieu du décalage dynamique du modèle de base.
L'adaptateur fourni est la révision v12. Sa table de positions de branche d'attention couvre 2 304 emplacements et il a été affiné à la géométrie d'édition réelle de 1024 px, de sorte que les longues séquences de référence conservent leurs positions au lieu de tomber dans une queue remplie de zéros. Cela a fait passer le cosinus vision face à l'encodeur natif de 0,93 à 0,97, tandis que le texte est resté à 0,95.
Un VAE affiné
Le décodeur fourni n'est pas celui d'origine de Qwen-Image 2.1. C'est un affinage du décodeur uniquement, construit sur madebyollin/texture-fix-vae-for-qwen-image-2.1, entraîné à supprimer le treillis de 2 px que le suréchantillonnage nearest-exact fixe dans le pas de sortie. Seul le décodeur a été entraîné, sur 5 300 étapes, avec un terme de perte supplémentaire : la différence crête à crête entre les moyennes des sous-treillis 2x2 de la reconstruction et de la cible. Le contenu fidèlement reproduit contribue pour zéro à ce terme, donc seul le treillis ajouté est pénalisé. L'encodeur est identique bit à bit à l'original, ce qui laisse l'espace latent inchangé.
| Décodeur | PSNR | LPIPS | Treillis (/255) |
|---|---|---|---|
| Qwen-Image 2.1 d'origine | 33.073 | 0.05316 | 2.631 |
| texture-fix | 32.840 | 0.05388 | 0.125 |
| ce VAE | 33.397 | 0.05291 | 0.000 |
Reconstruction sur 32 images retenues à 512 px. La carte du modèle note que le treillis n'est pas visible à 100 % de zoom, c'est pourquoi il est mesuré plutôt que jugé à l'œil.
Exemples
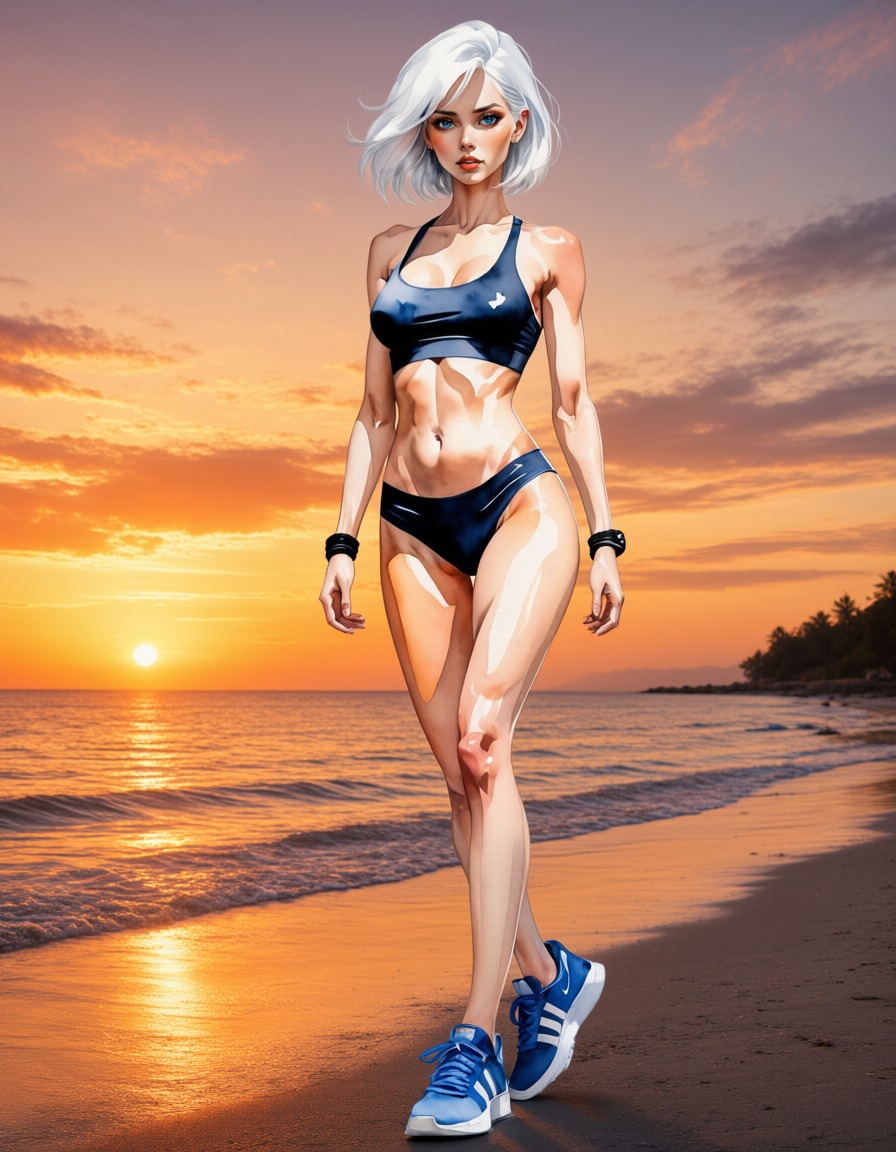
Édition avec une image de condition : l'arrière-plan change, le sujet est conservé.
 |  |
|---|---|
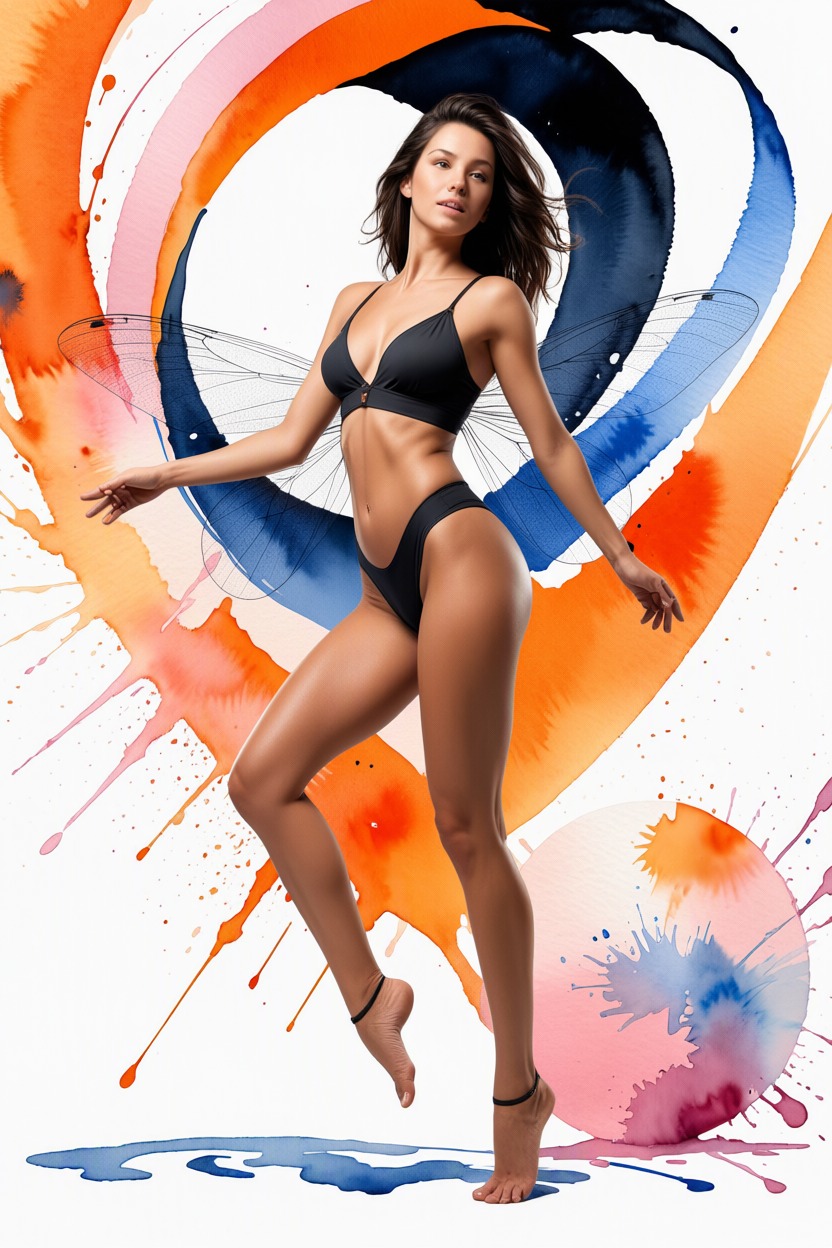
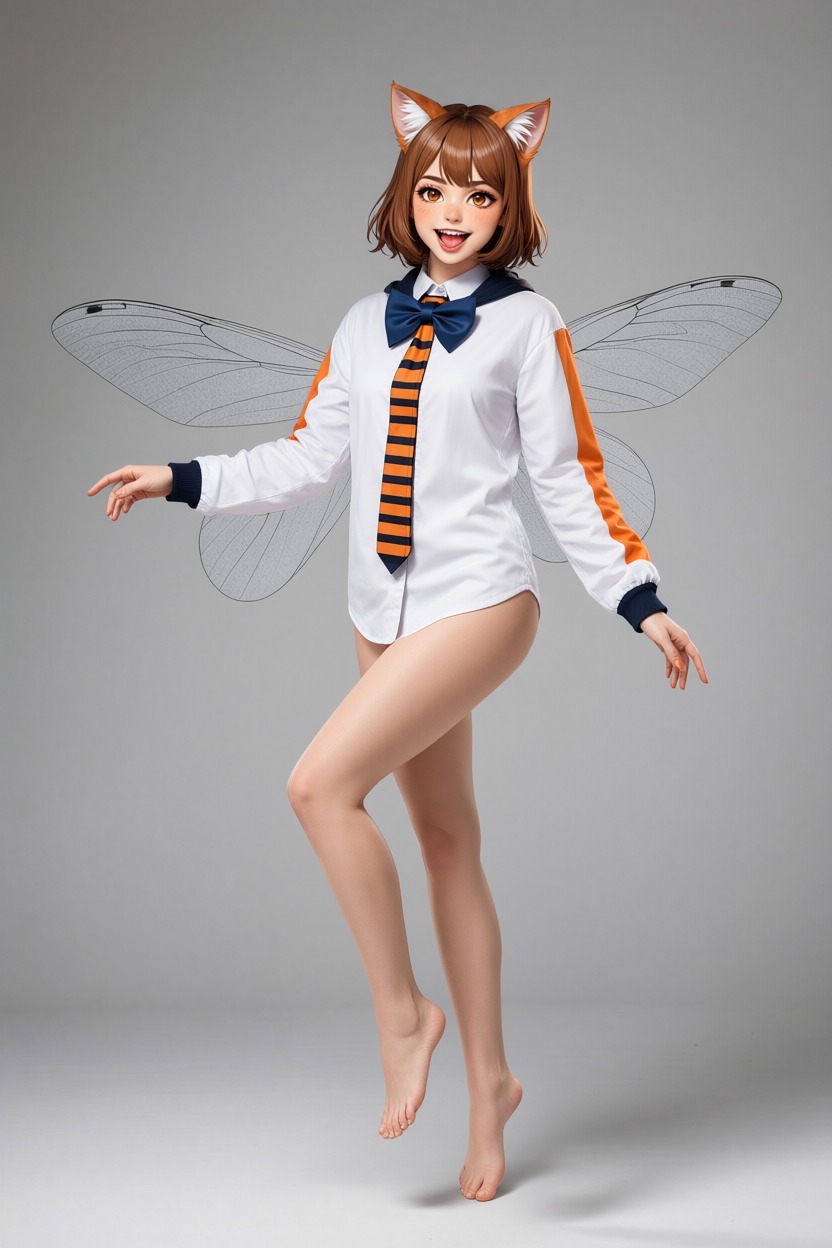
Deux images de condition : <image1> conserve sa pose, ses vêtements et sa scène | L'identité est copiée depuis <image2> |
L'édition suit la convention du modèle de base : la première image est celle qui est éditée (<image1>) et tout ce qui suit est une référence. La carte du modèle souligne que placer la référence en premier est la raison habituelle pour laquelle un échange « ne se produit pas », car le modèle édite alors la référence.
Trois images de condition : cible et composition depuis <image1>, la personne depuis <image2>, couleur et éclairage depuis <image3>.
La génération transparente (RGBA) passe par le même pipeline.
L'exécuter dans ComfyUI
Il existe deux méthodes ComfyUI indépendantes, et aucune n'a besoin de l'encodeur de 17,5 Go.
Pack de Nœuds : recoilme/zen-image-edit-comfyui. Le DiT, le VAE, l'échantillonneur et le cache KV de préfixe restent le ComfyUI standard (une version avec prise en charge de Qwen-Image 2.1 est requise), et le nœud ne fournit que le petit encodeur et l'adaptateur :
- Télécharger
adapter_v12.safetensors(0,64 Go) dansComfyUI/models/. - Placez
qwen_image_2.1_bf16.safetensorsdansmodels/diffusion_models/etqwen_image_2.1_vae_bf16.safetensorsdansmodels/vae/, les deux provenant de Comfy-Org/Qwen-Image-2.1. - Récupérez l'encodeur de texte :
hf download Qwen/Qwen3.5-0.8B --local-dir ComfyUI/models/text_encoders/qwen3.5_0.8b. - Redémarrer ComfyUI. Il nécessite
transformers >= 5.17.
L'auteur rapporte un cosinus de 1.0000 face à la version Diffusers du même dossier, et les deux graphes d'exemple sont vérifiés de bout en bout.
Checkpoint en fichier unique : T8mars/comfyui-Zen-Image-Edit-T8. Installable depuis le Gestionnaire ComfyUI, cette méthode regroupe le DiT, le VAE, l'encodeur Zen, l'adaptateur de fusion et les ressources du tokenizer dans un seul checkpoint zen_image_edit_qwen21_single.safetensors, publié sous t8star/Zen-Image-Edit-Comfy. Son chargeur renvoie MODEL, CLIP et VAE, donc aucun téléchargement séparé n'est nécessaire, et un chargeur CLIP seul fonctionne avec les chargeurs de diffusion et de VAE natifs. La conversion a été validée sur ComfyUI 0.37.0 avec un RTX 5090 Laptop à 24 Go, sur les graphes de text-to-image et d'édition d'image. Le même référentiel republie également les adaptateurs Viggle turbo sous forme de LoRA qui se chargent dans les nœuds intégrés de ComfyUI, avec les flux de travail.
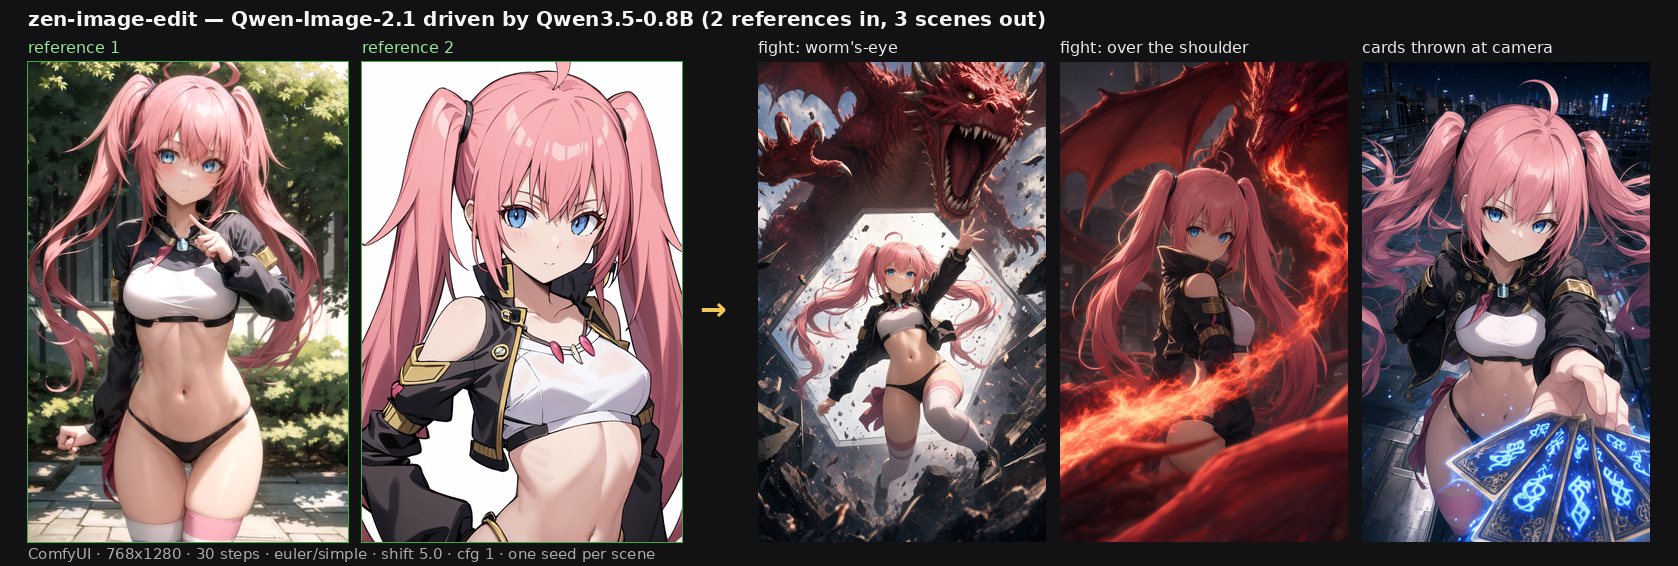
Deux références de personnage en entrée, trois scènes en sortie, via le nœud ComfyUI à 768x1280. Source : recoilme/zen-image-edit-comfyui.
Limitations documentées
La carte du modèle liste les lacunes plutôt que de laisser les utilisateurs les découvrir :
- Anglais uniquement. C'est tout ce sur quoi l'adaptateur a été entraîné et testé, et les autres langues dérivent.
- Chiffres sur la signalétique. « OPEN 24 HOURS » s'affiche comme « OPEN 26 HOURS » sur toutes les graines essayées. Les mots, eux, sont corrects.
- Les références non photographiques se transfèrent moins fidèlement que les photographiques, puisque l'adaptateur imite l'encodeur natif et hérite de son plafond.
- Une taille de lot supérieure à 1 à 1024 px atteint près de 28 Go en pointe, donc un prompt par appel est le mode sûr.
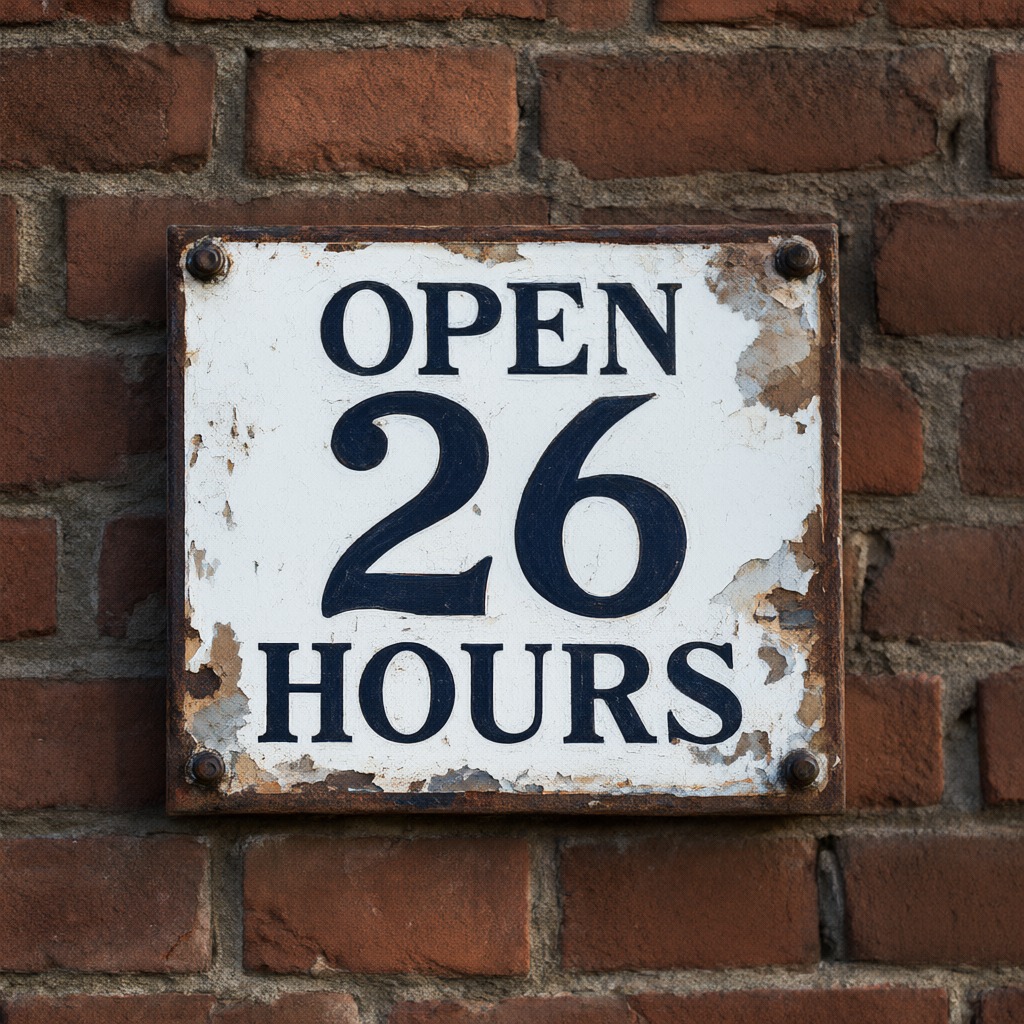
Les mots s'affichent correctement, les chiffres sur la signalétique non. Source : AiArtLab/zen-image-edit.
Disponibilité
Les poids sont publiés sous AiArtLab/zen-image-edit. Pour les cartes 16 Go, il existe une version GGUF Q5_K sur recoilme/zen-image-edit-gguf qui fait passer le transformateur de 13,55 GiB à 4,52 GiB pendant une exécution. Exécuter le pipeline Diffusers nécessite une version de diffusers construite avec la prise en charge de Qwen-Image-2.1 et trust_remote_code=True.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.