Prism : vidéo et audio conjoints en 2K, entraînement 2,5x plus rapide
Prism, de Fudan, Tencent Hunyuan et ZJU, entraîne des modèles conjoints vidéo-audio en 2K avec une attention dynamique creuse, 2,5x plus rapide que l'attention complète.
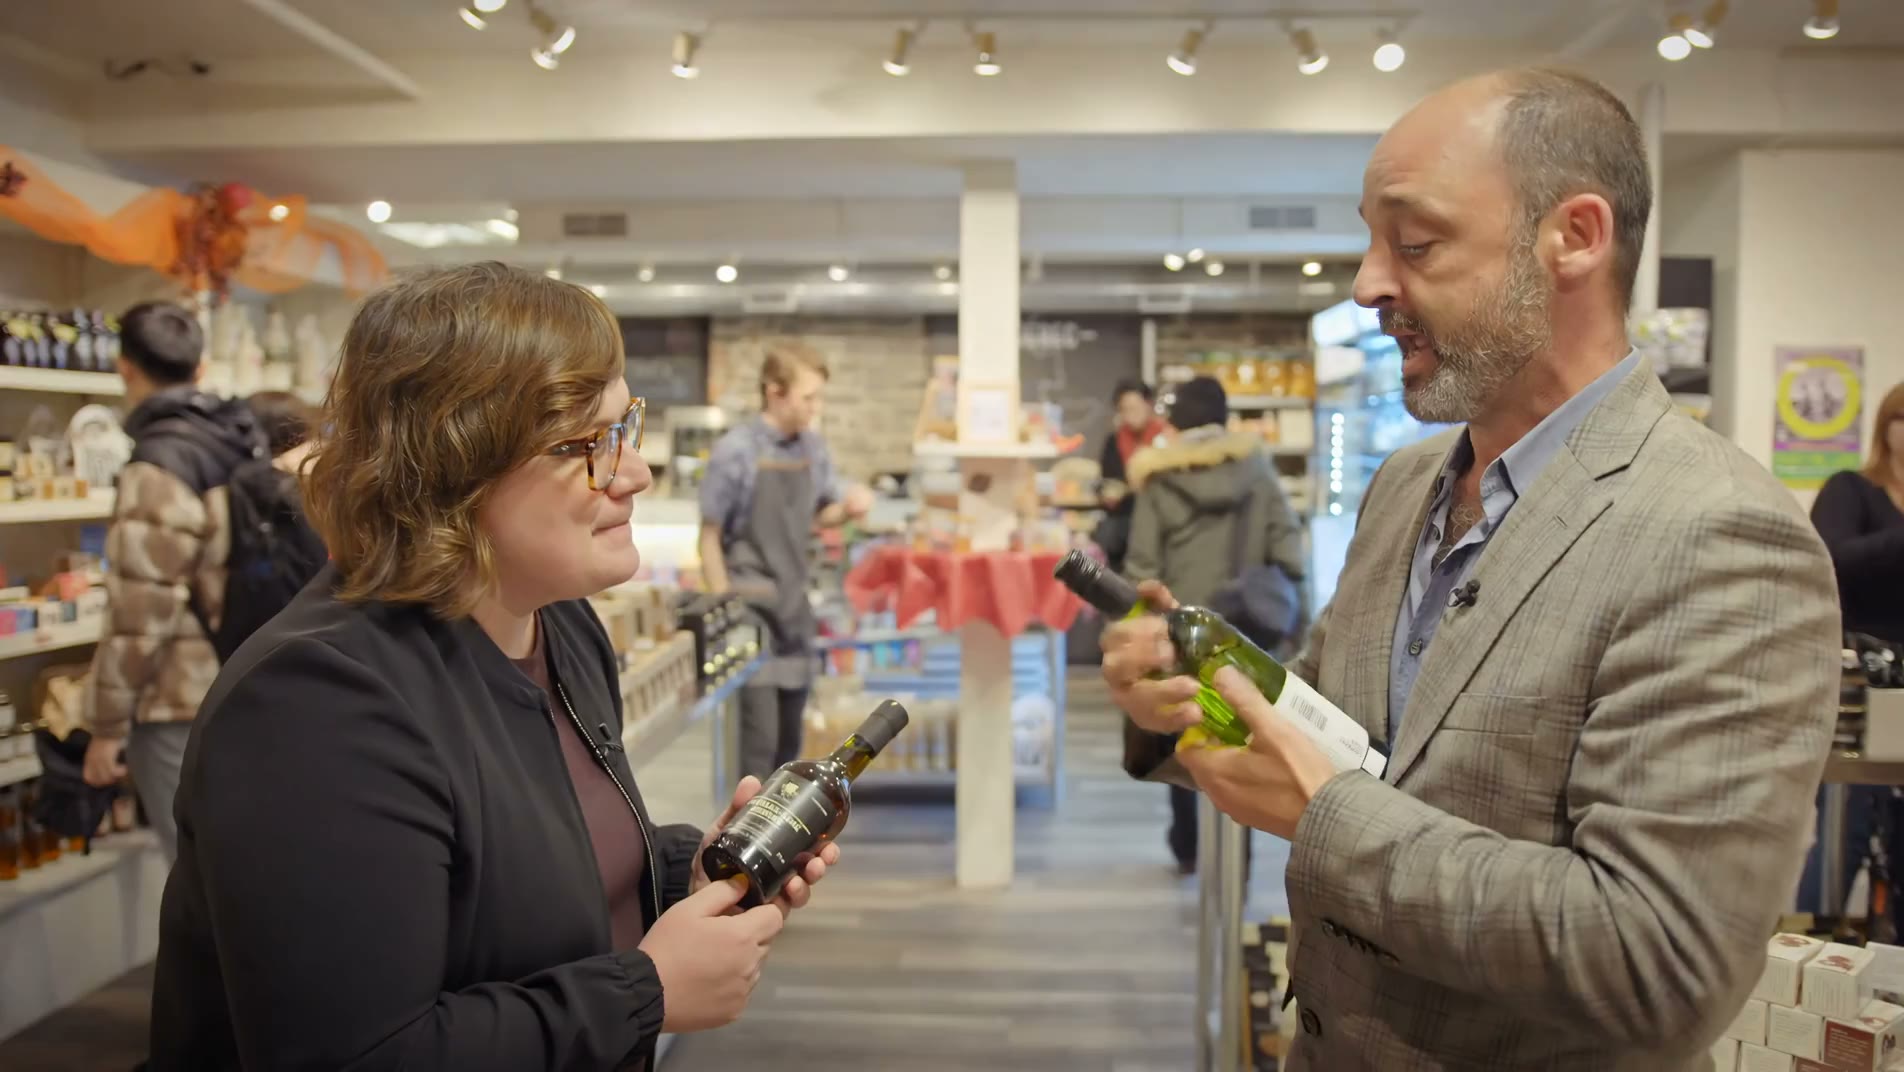
Un exemple de génération issu du checkpoint d'aperçu publié.
Ce que fait Prism
L'entraînement natif en haute résolution est ce qui permet aux modèles conjoints vidéo-audio d'apprendre des détails visuels plus fins et un mouvement plus net, mais l'attention complète croît de façon quadratique avec la longueur de séquence et, en 2K, elle disperse l'attention sur une masse de tokens redondants. Prism conserve la résolution et modifie plutôt l'attention.
La méthode organise la séquence de tokens en macro-zones spatiotemporelles. Pour chaque zone, elle estime la structure d'information locale à partir de deux signaux :
- La variance des caractéristiques vidéo le long de la dimension des canaux, qui indique la vitesse à laquelle le contenu visuel varie dans chaque direction.
- Les normes des caractéristiques issues de l'attention croisée audio-vers-vidéo, qui indiquent l'intensité de l'influence de l'audio sur chaque région visuelle.
Ces signaux déterminent une forme de bloc par zone : un partitionnement plus fin le long des axes où le contenu visuel varie rapidement ou où le couplage audio-visuel est fort, un partitionnement plus grossier ailleurs. L'objectif est que les tokens à l'intérieur d'un bloc restent sémantiquement cohérents, afin que les caractéristiques au niveau du bloc portent à la fois le contenu visuel et l'interaction conjointe audio-vidéo. Une stratégie hybride de sélection de blocs (top-k combiné à un seuil top-p sur la CDF) définit ensuite la parcimonie pour chaque requête.
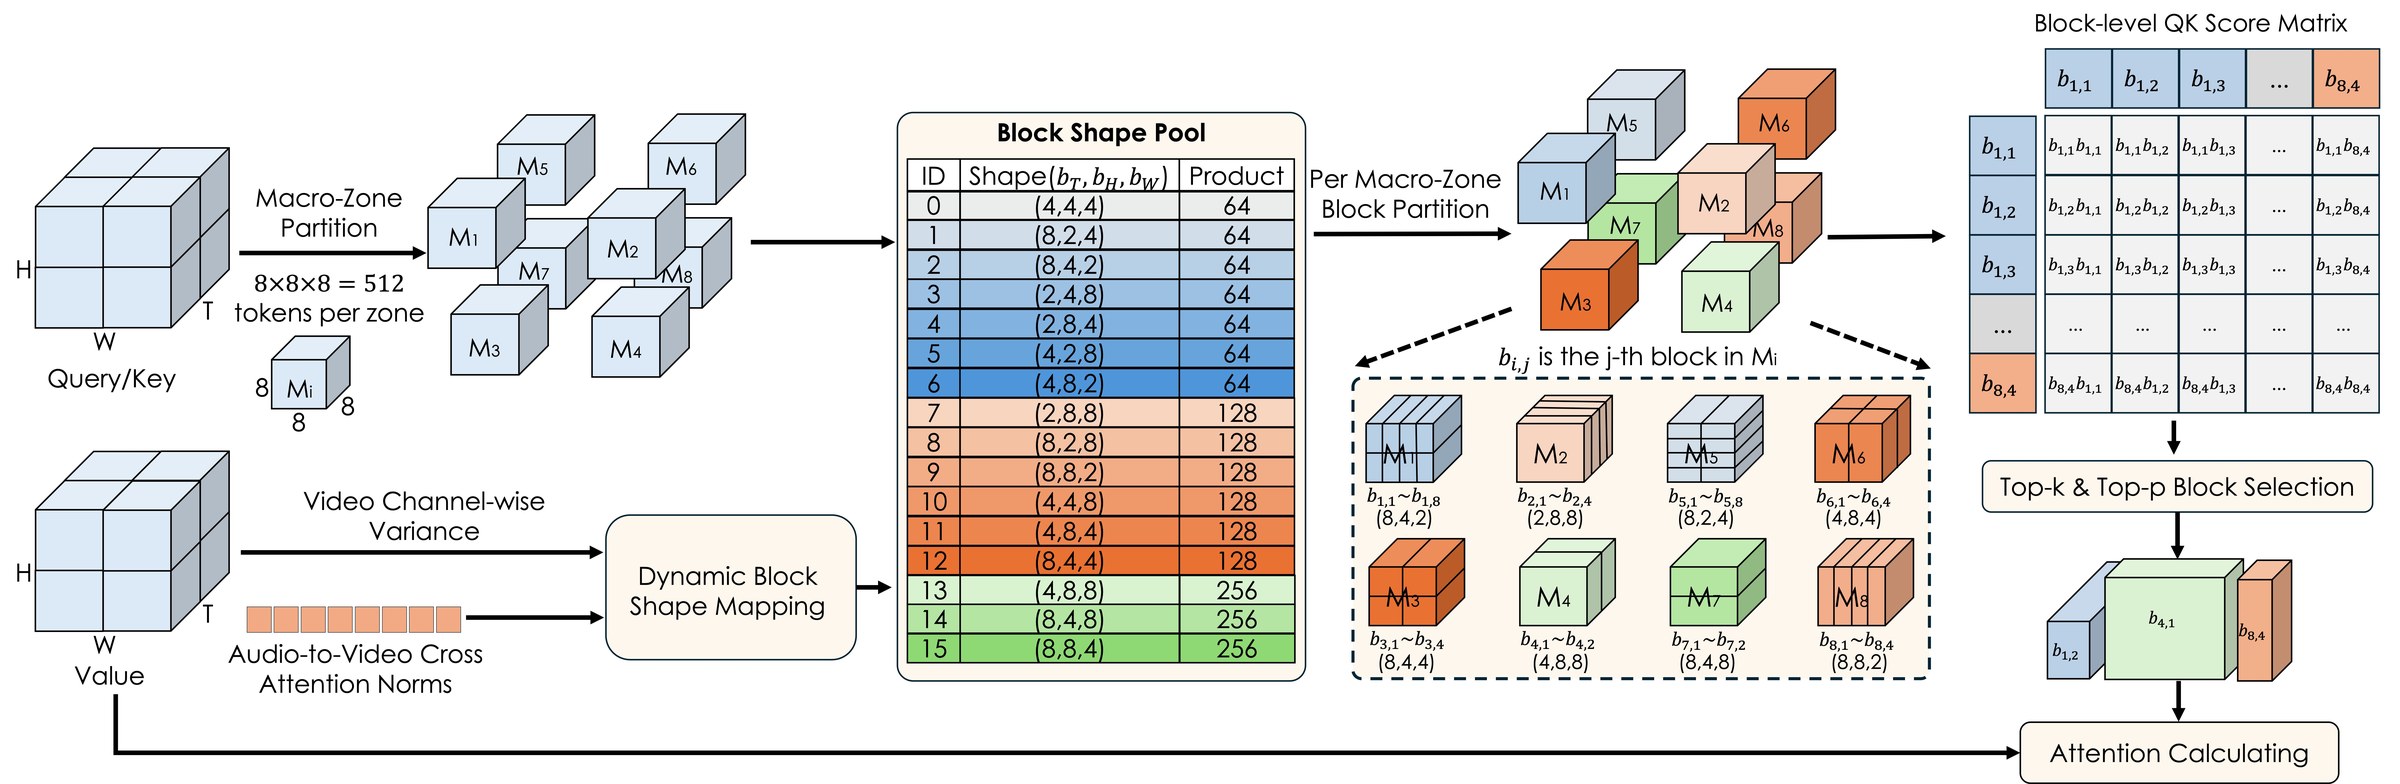
Le framework Prism, issu de la carte du modèle officielle.
Ce qui a été publié
Le projet est livré sous la forme d'une pile complète d'entraînement et d'inférence plutôt que d'un seul checkpoint :
- Checkpoints d'aperçu.
Prism-preview-alpha(stable) etPrism-preview-beta(mouvement), construits sur l'architecture MOVA, avec une génération conjointe vidéo-audio native en 720p, 1080p et 2K. - Code. Prétraitement des données avec extraction et décodage des latents, entraînement, fine-tuning complet et inférence, ainsi que des scripts de lancement distribués pour des exécutions multi-nœuds.
- Rapport. Le rapport technique est disponible sur arXiv, avec des liens depuis la carte du modèle et le référentiel.
Générations issues du checkpoint d'aperçu publié.
Les checkpoints publiés se conditionnent également sur une image de référence pour la génération image-vers-audio-vidéo :
 |  |
|---|---|
| Entrée du cas officiel image-vers-audio-vidéo | Entrée du cas officiel image-vers-audio-vidéo |
Un checkpoint Prism-pro figure comme l'élément restant sur la feuille de route du projet et n'a pas encore été publié.
Disponibilité
Les poids d'aperçu sont sur Hugging Face, avec le code et les scripts dans Tencent-Hunyuan/Prism et le rapport sur arXiv. L'inférence passe actuellement par les scripts PyTorch du projet ; il n'existe encore aucun nœud ComfyUI ni checkpoint ComfyUI empaqueté, donc l'exécuter localement implique d'utiliser directement le référentiel officiel.
Commentaires
Connectez-vous avec GitHub pour rejoindre la discussion.